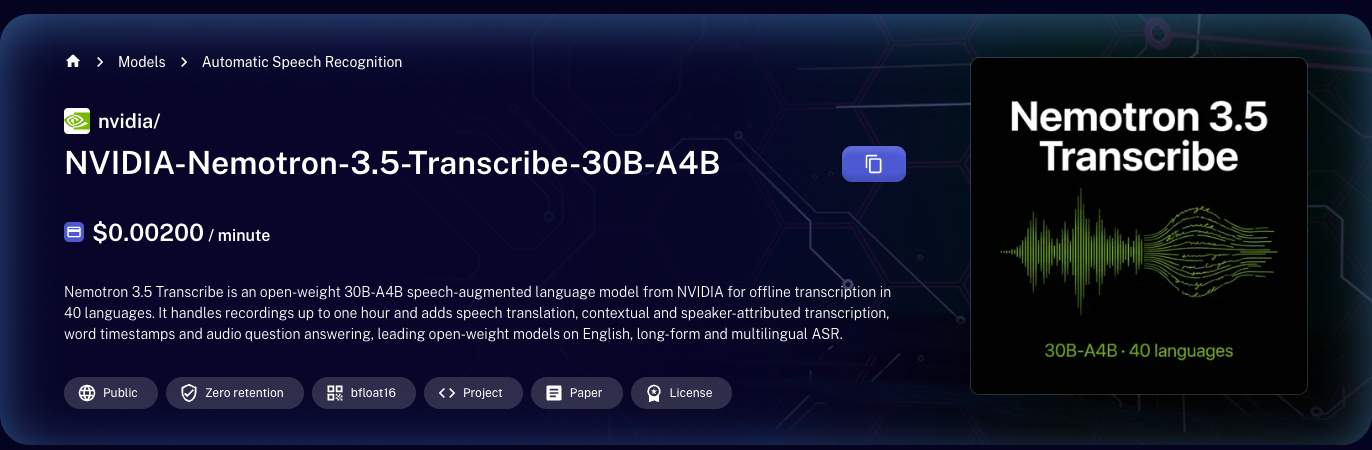
NVIDIA의 새로운 Nemotron 3.5 Transcribe API로 한 시간짜리 녹음을 전사하는 데 12센트가 듭니다. 이는 Hugging Face Open ASR Leaderboard에서 최고 오픈 웨이트 모델에 대해 DeepInfra가 책정한 분당 $0.002의 가격이며, 이 모델은 같은 호출에서 단어 타임스탬프, 화자 레이블, 감지된 언어도 반환합니다.
이 가이드는 API 키를 발급받고, 첫 요청을 보내고, 응답을 읽고, 화자 레이블과 전문 용어를 위한 프롬프트를 작성하고, 비용을 예측 가능하게 유지하는 방법을 보여줍니다. 아래의 모든 내용은 2026년 10월 29일 기준으로 DeepInfra 모델 페이지, OpenRouter 목록, 공식 모델 카드와 대조하여 확인했습니다.
대신 $0 경로를 찾고 계신가요? Nemotron 3.5 Transcribe를 무료로 사용하는 방법을 읽어보세요.
Nemotron 3.5 Transcribe API가 제공하는 것
NVIDIA는 2026년 10월 28일에 Nemotron 3.5 Transcribe(NVIDIA-Nemotron-3.5-Transcribe-30B-A4B)를 출시했습니다. 이는 총 34B 파라미터와 약 4.3B 활성 파라미터를 갖춘 오픈 웨이트 음성 모델로, ASR 인코더와 화자 인코더를 덧붙인 하이브리드 Mamba-2 및 Transformer 전문가 혼합(mixture-of-experts) 언어 모델을 기반으로 합니다.
하나의 엔드포인트에서 다음을 얻을 수 있습니다:
- 40개 언어로 전사
- 최대 1시간 길이의 파일
- 단어 타임스탬프와 세그먼트 타임스탬프
- 최대 8명의 화자를 화자별로 구분한 전사
- 영어로/부터 31개 언어 간 음성 번역
- 이름, 제품, 전문 용어를 위한 컨텍스트 프롬프트
- 언어 식별
Open ASR Leaderboard(2026년 10월 28일 업데이트)에서 이 모델은 평균 5.33% WER을 기록해 61개 모델 중 9위이며, 공개 가중치를 가진 모델 중에서는 1위입니다. 그 위의 8개 모델은 비공개 상용 API입니다.
이 모델은 오프라인 모델입니다. 실시간 스트림이 아니라 녹음된 파일을 보내세요.
어디에서 호출하고, 비용은 얼마인가
이 요금이면 1,000시간의 오디오 비용은 약 $120입니다. 비교하자면 OpenAI Whisper API는 역사적으로 분당 $0.006, 즉 DeepInfra 가격의 세 배를 청구했으며, whisper-large-v3는 같은 리더보드에서 7.16% WER로 41위입니다.
1단계: DeepInfra API 키 발급받기
- deepinfra.com에서 계정을 만드세요.
- 대시보드를 열고 API 키를 만드세요.
- 결제 수단이나 크레딧을 추가하세요. 모델 페이지는 브라우저 데모에도 로그인이 필요합니다.
- 셸에서 키를 내보내세요:
export DEEPINFRA_API_KEY="your_key_here"
키를 소스 관리에 넣지 마세요. 코딩 에이전트를 통해 작업한다면 프롬프트가 아니라 에이전트의 환경에 넣으세요.
2단계: 첫 파일 전사하기
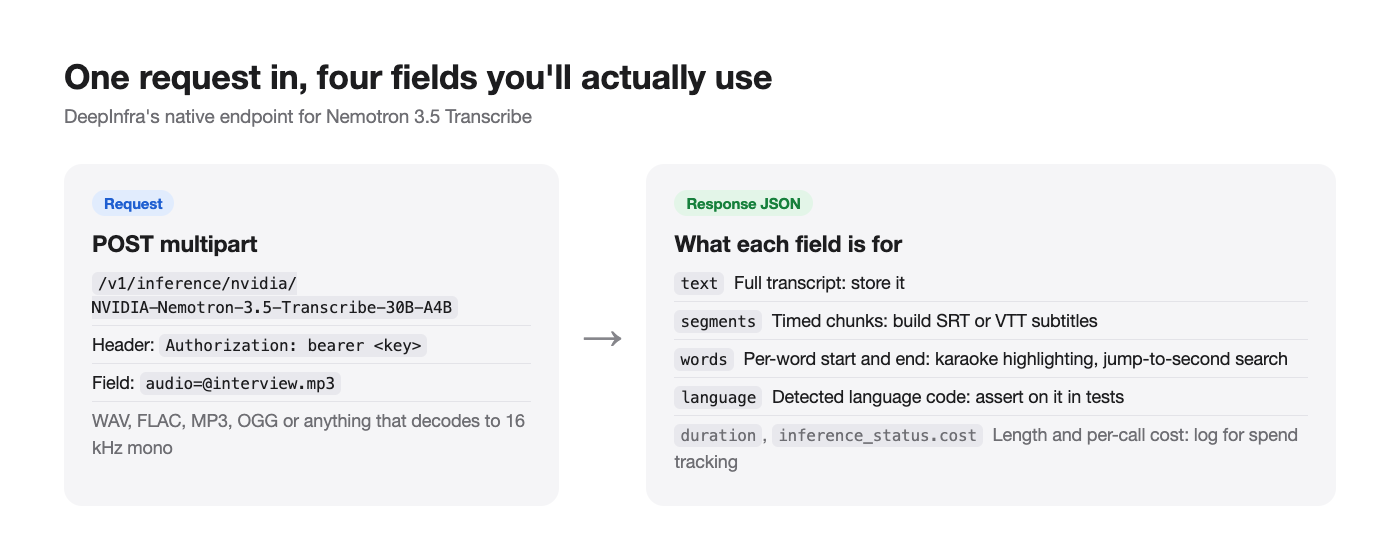
DeepInfra의 네이티브 추론 엔드포인트는 audio 필드를 포함한 멀티파트 업로드를 받습니다. 다음은 해당 API 페이지의 정확한 요청 형식입니다:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@interview.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
이 모델은 WAV, FLAC, MP3, OGG 또는 16kHz 모노 PCM으로 디코딩되는 모든 형식을 받습니다. M4A나 비디오 파일이 있다면 먼저 FFmpeg로 변환하세요:
ffmpeg -i call.m4a -ar 16000 -ac 1 call.wav
3단계: 응답 읽기
DeepInfra는 다음과 같은 응답 형태를 문서화합니다(아래 값은 예시입니다):
{
  "text": "Hello World",
  "segments": [
    { "id": 0, "start": 0.0, "end": 1.0, "text": "Hello" },
    { "id": 1, "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "language": "en",
  "words": [
    { "start": 0.0, "end": 1.0, "text": "Hello" },
    { "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "duration": 5.0,
  "inference_status": { "status": "succeeded", "runtime_ms": 0, "cost": 0.0 }
}
각 필드의 용도는 다음과 같습니다:
text는 전체 전사본입니다. 이것을 저장하세요.segments는 시간 정보가 있는 청크를 제공합니다. 자막(SRT 또는 VTT)에 사용하세요.words는 단어별 타이밍을 제공합니다. 노래방 스타일 하이라이트나 정확한 초로 이동하는 검색에 사용하세요.language는 감지된 언어 코드입니다. 테스트에서 이를 검증하세요. 짧은 클립에서 잘못된 언어가 흔한 실패입니다.inference_status.cost는 호출 비용을 보고합니다. 파일별 지출을 추적하려면 로깅하세요.
4단계: Python에서 호출하기
import os
import requests

URL = "https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"

def transcribe(path: str) -> dict:
    with open(path, "rb") as f:
        r = requests.post(
            URL,
            headers={"Authorization": f"bearer {os.environ['DEEPINFRA_API_KEY']}"},
            files={"audio": f},
            timeout=600,
        )
    r.raise_for_status()
    return r.json()

result = transcribe("interview.mp3")
print(result["language"], len(result["words"]), "words")
print(result["text"][:500])
긴 타임아웃을 설정하세요. 꽉 찬 한 시간 분량의 음성은 약 20,000개의 출력 토큰을 생성할 수 있으며, 모델 카드는 긴 작업에 시간이 걸린다고 경고합니다.
DeepInfra는 또한 이 모델에 대해 "OpenAI Speech-to-Text" 탭을 제공하므로, audio.transcriptions를 호출하는 OpenAI SDK 코드는 아마도 DeepInfra의 OpenAI 호환 베이스 URL을 가리킬 수 있습니다. 프로덕션 코드를 전환하기 전에 정확한 베이스 URL을 해당 탭에서 확인하세요.
프롬프트: 축어적, 정제, 화자, 전문 용어
Nemotron 3.5 Transcribe가 기존 ASR API와 다른 점은 지시를 받는다는 것입니다. DeepInfra 페이지에 나열된 NVIDIA의 권장 프롬프트는 다음과 같습니다:
| 원하는 것 | 지시 |
|---|---|
| 축어적 단어 | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| 읽기 쉬운 텍스트 | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| 도메인 어휘 | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| 누가 무엇을 말했는지 | Transcribe verbatim, including fillers. ... Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. |
| 번역 | Please translate the given speech to <target language>. |
전사, 번역, 언어 ID에는 추론을 끄고 temperature 0을 사용하며, 시스템 프롬프트는 비워 두세요.
컨텍스트 용어는 효과가 있습니다. NVIDIA는 ContextASR-Bench WER이 컨텍스트 없을 때 3.33%에서 세밀한 컨텍스트를 제공하면 1.71%로 떨어지고, 컨텍스트가 있는 Earnings22는 12.54%에서 9.58%로 낮아진다고 보고합니다. 실적 발표 통화라면 회사 이름, 티커, 임원 이름을 전달하세요.
네이티브 엔드포인트에서 지시를 전달하는 필드는 DeepInfra의 입력 스키마 탭에서 확인하세요. 자체 호스팅 서버에서는 로컬 설정 가이드에 나온 것처럼 지시가 오디오 옆의 채팅 메시지에 들어갑니다.
대신 OpenRouter 사용하기
이미 LLM에 OpenRouter를 사용하고 있다면 하나의 키와 하나의 청구서를 유지할 수 있습니다. 모델 ID는 nvidia/nemotron-3.5-transcribe이고 가격은 초당 $0.000033이며, 2026년 10월 29일 기준으로 나열된 유일한 제공자는 DeepInfra입니다(당시 100% 가동 시간, 약 1초 지연). 오디오 엔드포인트는 채팅 완료와 다르므로 OpenRouter의 모델 API 탭에서 요청 형식을 복사하세요.
단점은 OpenRouter가 네트워크 홉을 하나 추가하며, 현재 이 모델을 제공하는 제공자가 하나뿐이라 공급자 장애 조치가 없다는 것입니다.
비용을 예측 가능하게 유지하기
- 먼저 무음을 잘라내세요. 비용은 발화 시간이 아니라 오디오 분당으로 지불합니다. 녹음에서 무음을 잘라내면 청구서가 줄어듭니다.
- 다운믹스하고 리샘플링하세요. 16kHz 모노는 어차피 모델이 사용하는 형식입니다. 스테레오 48kHz를 보내면 업로드 시간만 늘어납니다.
- 청크가 아니라 파일 단위로 일괄 처리하세요. 모델은 한 요청으로 한 시간을 처리합니다. 파일을 30초 조각으로 나누면 화자 레이블과 컨텍스트가 깨집니다.
inference_status.cost를 로깅하세요. 고객별 또는 작업별로 합산하세요.- 지속적인 사용량이 많으면 자체 호스팅하세요. NVIDIA의 최적화된 NIM은 RTX PRO 6000 Blackwell 한 장에서 초당 최대 2,238초의 오디오를 처리합니다. 한 달에 수천 시간을 전사한다면 임대한 GPU 한 장이 분당 가격보다 낫습니다. 오픈 소스 vLLM 경로는 해당 NIM 수치보다 약 두 배 느릴 것으로 예상됩니다.
코딩 에이전트가 Apidog CLI로 테스트하게 하기
전사 API는 조용히 실패합니다. text가 비어 있는 200 응답, 스페인어 클립이 포르투갈어로 감지되는 경우, 또는 제공자 업데이트 후 words가 누락되는 경우입니다. JSON을 수동으로 확인하는 대신 코딩 에이전트가 Apidog CLI로 검사를 작성하고 실행하게 하세요.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 에이전트에 프롬프트 하나를 주세요:
In Apidog project <id>, add the DeepInfra endpoint POST
https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
with a multipart "audio" field and a bearer token from {{DEEPINFRA_API_KEY}}.
Create a test case per file in samples/ (en.mp3, es.mp3, two-speakers.wav) asserting
status 200, non-empty "text", the expected "language", and "words" length > 0.
Run them against the prod environment and report failures with the response body.
에이전트는 스키마를 읽고, 페이로드를 검증하고, 케이스를 작성하고 실행합니다:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
-r junit을 추가하면 같은 명령이 CI 게이트가 됩니다. 전체 설정은 CI/CD 파이프라인에서의 Apidog CLI와 Claude Code에서의 Apidog CLI를 참고하세요.
FAQ
Nemotron 3.5 Transcribe API 가격은 얼마인가요? 2026년 10월 29일 기준 DeepInfra에서 분당 $0.002, OpenRouter에서 초당 $0.000033입니다. 어느 쪽이든 오디오 한 시간당 약 $0.12입니다.
무료 API 키가 있나요? 찾지 못했습니다. 이 모델은 아직 build.nvidia.com에 없습니다. 무료 경로는 NVIDIA의 데모 Space와 자체 호스팅이며, 무료 가이드를 참고하세요.
최대 파일 길이는 얼마인가요? 요청당 한 시간이며, 컨텍스트는 65,536 토큰입니다.
API가 결과를 스트리밍하나요? 아닙니다. 파일이 완료되면 전사본을 반환하는 오프라인 모델입니다.
어떤 언어가 지원되나요? 40개이며 세 등급으로 평가됩니다. 13개의 "선도" 언어에는 영어, 스페인어, 프랑스어, 독일어, 이탈리아어, 포르투갈어, 힌디어, 한국어, 러시아어, 폴란드어가 포함됩니다. 일본어, 터키어, 우크라이나어는 "프로덕션 준비 완료"입니다. 중국어 만다린과 아랍어는 "지원됨"입니다.
다른 음성 API와 비교하면 어떤가요? 최고의 오픈 소스 음성-텍스트 모델 순위와 이전의 최고의 텍스트-음성 및 음성-텍스트 API 정리 글을 참고하세요.
전사 시작하기
DeepInfra 키를 받고 MP3로 curl 하나를 보내면 분당 $0.002로 시간 정보와 언어 태그가 붙은 텍스트를 돌려받습니다. 도메인에 맞는 컨텍스트 용어를 추가하고, 회의에는 화자 프롬프트를 사용하고, 에이전트가 모든 릴리스에서 Apidog 검사를 실행하게 하여 조용한 회귀가 배포되지 않도록 하세요.