
Moonshot AI는 2026년 7월 16일 Kimi K3를 출시했으며, 출시 보도는 이를 Anthropic에 대한 직접적인 도전으로 보도했습니다. TechCrunch는 K3가 Claude Opus 4.8과 동등하거나 심지어 능가할 수 있다고 말한 소식통을 인용하며, 폐쇄형 모델과의 격차를 좁힐 것으로 예상된다고 보도했습니다. 이 글은 검증할 수 있는 숫자와 명확히 표시할 수 없는 숫자를 명확히 구분하여 항목별로 일대일 비교를 진행합니다.
요약하자면, K3는 가격, 컨텍스트 창, 개방성에서 우위를 점하며, Opus 4.8은 성숙한 관리형 벤더의 보증을 제공합니다. 두 모델 모두 OpenAI SDK 형식을 지원하므로, Apidog와 같은 도구에서 동일한 요청을 실행하여 출력, 지연 시간, 비용을 비교할 수 있습니다.
요약 및 한눈에 보는 결론
Kimi K3는 2.8조 파라미터 규모의 전문가 혼합 모델로, 100만 토큰 컨텍스트 창, 저렴한 입력 가격, 그리고 2026년 7월 27일경에 출시될 오픈 웨이트를 특징으로 합니다. Claude Opus 4.8은 Anthropic의 Opus 라인에 속하는 폐쇄형 독점 모델로, 가격이 더 높고 강력한 추론 및 에이전트 역량으로 명성을 얻고 있습니다. Artificial Analysis의 독립적인 평가에 따르면 K3는 지능 지수(Intelligence Index) 57점으로 189개 모델 중 4위를 차지했으며, 오픈 웨이트 모델 중 최고 등급입니다.
간단히 요약하면 다음과 같습니다:
- Kimi K3 선택: 매우 큰 컨텍스트 창, 대용량에서의 저렴한 비용, 또는 오픈 웨이트를 자체 호스팅하고 미세 조정할 수 있는 기능이 필요할 때.
- Claude Opus 4.8 선택: 성숙한 벤더 관계, 관리형 지원 및 SLA, 그리고 어려운 에이전트 작업에 대한 오랜 프로덕션 실적을 중요하게 생각하며 프리미엄을 지불할 의향이 있을 때.
- 막상막하, 아직 결론 나지 않음. 아직 독립적인 K3 대 Opus 4.8의 직접적인 벤치마크 표는 존재하지 않으므로, "어느 한쪽이 전반적으로 우세하다"는 헤드라인은 신중하게 받아들여야 합니다.
하나의 관점을 덧붙이자면, Anthropic의 현재 가장 널리 사용되는 최고 모델은 Claude Fable 5입니다. Opus 4.8은 이 최전선 모델보다 한 단계 낮은 강력한 티어이며, 주력 모델은 아닙니다. Moonshot의 출시 블로그는 K3가 "여전히 가장 강력한 독점 모델인 Claude Fable 5와 GPT 5.6 Sol에 뒤처진다"고 말하며, Fable 5와 Sol을 언급했지 Opus를 언급하지 않았습니다. 따라서 솔직한 이야기는 "오픈 모델이 Anthropic을 왕좌에서 끌어내렸다"가 아닙니다. "오픈 모델이 격차를 좁히고 가격, 컨텍스트, 개방성에서 승리했으며, 품질 면에서는 최상위권에만 뒤처진다"입니다.
출시 및 이 비교가 존재하는 이유
K3는 Moonshot이 오픈 웨이트 사다리에서 가장 크게 도약한 모델이며, 총 2.8조 개의 파라미터로 현재까지 중국에서 출시된 오픈 웨이트 모델 중 가장 큽니다. 이 아키텍처는 Kimi Delta Attention, Attention Residuals, 그리고 Moonshot이 Stable LatentMoE라고 부르는 디자인을 기반으로 하며, 토큰당 896개의 전문가 중 16개를 활성화합니다. Moonshot은 활성 파라미터 수를 공개하지 않았으므로, 우리는 이를 추정하지 않을 것입니다. Kimi K3는 무엇인가에 대한 핵심 설명글은 아키텍처와 접근 방식에 대해 자세히 다루고 있습니다.
이 비교가 존재하는 이유는 오픈 웨이트 모델이 품질 면에서 근접하고 자체 하드웨어에서 실행될 수 있을 때, 값비싼 폐쇄형 모델이 과연 가치가 있는지 기업들이 계속해서 질문하기 때문입니다. 비교 대상이 "K3 대 Fable 5"가 아닌 "K3 대 Opus 4.8"이 된 것은 Opus 4.8이 오픈 경쟁자가 그럴듯한 승산이 있는 티어이기 때문입니다. 테크크런치 보고서에서 시장 상황을 확인할 수 있습니다.
Kimi K3 및 Claude Opus 4.8 한눈에 보기
구매 결정에 영향을 미치는 요소들을 나란히 비교했습니다. 수치가 공개적으로 확인되지 않은 경우, 해당 셀에 그렇게 명시되어 있습니다.
| 항목 | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| 벤더 | Moonshot AI | Anthropic |
| 출시일 | 2026년 7월 16일 | Claude Opus 4 라인의 일부 |
| 모델 유형 | 2.8조 파라미터 MoE (Stable LatentMoE, 896 전문가 중 16개 활성) | 독점, 아키텍처 비공개 |
| 모델 ID / 접근 | kimi-k3, OpenAI SDK 호환 |
Claude API (claude-opus-4-8 계열) |
| 컨텍스트 창 | 1,048,576 토큰 (1M) | 큼, 하지만 K3의 1M 창보다 작음 |
| 입력 가격 | 캐시 히트 시 M당 $0.30, 캐시 미스 시 M당 $3.00 | M당 $5.00 |
| 출력 가격 | M당 $15.00 | M당 $25.00 |
| 출력 속도 | ~62 토큰/초 (Artificial Analysis) | 여기서는 언급 안 됨; Artificial Analysis 참조 |
| 독립 점수 | 지능 지수 57, 189개 중 4위 (Artificial Analysis) | 최고 독점 티어 (Artificial Analysis 참조) |
| 가중치 | 오픈 웨이트, 2026년 7월 27일경 | 폐쇄형 |
| 품질 위치 | 오픈 모델 중 최고; Fable 5 및 GPT 5.6 Sol에 뒤처짐 (Moonshot) | Anthropic의 Fable 5 최전선 모델보다 낮은 강력한 독점 티어 |
대부분의 셀에서 K3가 경제성과 접근성 면에서 유리합니다. 품질은 논쟁의 여지가 있는 부분이며, 다음으로 자세히 살펴보겠습니다.
지능 및 품질: 최상위 티어가 여전히 우세한 부분
품질은 가장 파악하기 어려운 요소인데, 아직 K3와 Opus 4.8을 직접 비교하는 공통된 독립 벤치마크가 없기 때문입니다. 가장 명확한 독립적인 신호는 Artificial Analysis인데, 이들의 지능 지수(Intelligence Index)는 K3를 추론, 코딩, 지식 평가의 조합에서 최전선에 가깝거나 최전선에 놓으며, 오픈 웨이트 모델 중 최고로 평가합니다. 또한 K3가 평균보다 느리게 실행되고 장황하다는 점도 지적합니다.
반론은 Moonshot 자체에서 나옵니다. 그들의 출시 블로그는 솔직하게 밝히고 있습니다: K3의 전반적인 성능은 "여전히 가장 강력한 독점 모델인 Claude Fable 5와 GPT 5.6 Sol에 뒤처진다"고 말합니다. 이 문장은 Fable 5와 Sol을 언급했으며, Opus 4.8은 언급하지 않았습니다. 따라서 Moonshot 자체의 인정은 K3가 Fable 5와 Sol에 뒤처진다고 말하고 있으며, K3가 Opus 4.8에 진다는 언급은 없습니다.
벤더 벤치마크 표가 이를 뒷받침합니다. Moonshot의 출시 자료에 따르면, 최대 추론 설정에서 K3는 나열된 모든 벤치마크에서 Opus 4.8보다 높은 점수를 기록했습니다:
| 벤치마크 | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Terminal-Bench 2.1 | 88.3 | 84.6 |
| DeepSWE | 67.5 | 59.0 |
| BrowseComp | 91.2 | 84.3 |
| Automation Bench | 30.8 | 27.2 |
| SpreadsheetBench 2 | 34.8 | 31.6 |
이 수치들은 벤더가 자체적으로 실행한 것이며, 독립적인 직접 비교 결과는 아닙니다. 각 연구소는 자신들이 좋게 보이는 벤치마크 스위트를 공개합니다. 하지만 이들은 Moonshot이 실제로 공개한 수치이며, DeepSWE(가장 어려운 에이전트 코딩 지표)를 포함하여 전반적으로 K3가 Opus 4.8보다 앞선다는 것을 보여줍니다. 출처가 태그된 보기를 원하시면 Kimi K3 벤치마크 분석을, K3를 진정으로 앞서는 최전선 모델에 대해서는 Kimi K3 vs GPT-5.6 Sol을 참조하세요. 솔직한 결론은 다음과 같습니다: 우리가 가진 수치로는 K3가 Opus 4.8과 최소한 동등하거나 Moonshot 자체 스위트에서는 앞서고 있습니다. Opus 4.8의 진정한 강점은 벤치마크 점수가 아니라, Anthropic의 도구 성숙도, 신뢰성 실적, 그리고 관리형 벤더의 보증입니다.
가격: 가장 큰 격차
비용은 두 모델이 가장 크게 차이 나는 부분이며, 수치는 공개되어 있습니다. Kimi K3는 캐시 히트 입력 시 백만 토큰당 $0.30, 캐시 미스 입력 시 $3.00, 출력 시 $15.00를 청구합니다. Claude Opus 4.8은 입력에 $5.00, 출력에 $25.00를 청구합니다. 따라서 K3는 캐시된 입력에서 극적으로 저렴하고 ($0.30 대 $5.00), 캐시 미스 시에도 절반 이하의 가격이며 ($3.00 대 $5.00), 출력에서도 40% 저렴합니다 ($15.00 대 $25.00).
챗봇이 동일한 시스템 프롬프트와 문서를 반복적으로 전송하는 것과 같이 반복적인 컨텍스트가 많은 워크로드의 경우, K3의 캐시 히트 가격은 큰 절감 효과를 가져오며, 대용량 생성의 경우 출력 가격 차이만으로도 월별 청구서의 양상이 달라질 수 있습니다. 자체 트래픽을 모델링하려면, Kimi K3 가격 가이드에서 각 티어를 설명하고 있으며, Claude Opus 4.8 가격 게시물도 Anthropic 측면에서 동일한 내용을 다룹니다.
한 가지 주의할 점: 토큰당 가격이 저렴하다고 해서 항상 작업당 가격이 저렴한 것은 아닙니다. 장황한 모델은 더 많은 토큰을 생성하여 토큰당 이점의 일부를 상쇄할 수 있으며, Artificial Analysis는 K3를 장황하다고 지적합니다. 따라서 요금표가 아닌 실제 프롬프트로 총 비용을 측정해야 합니다.
컨텍스트 창: 작업 공간
컨텍스트는 서류상 K3의 확실한 승리입니다. Kimi K3는 1,048,576 토큰 창을 제공하여, 공격적인 청킹 없이도 매우 큰 코드베이스, 긴 문서 세트 또는 확장된 다중 턴 기록을 한 번의 요청으로 처리하기에 충분합니다. Claude Opus 4.8도 큰 창을 제공하지만, K3의 1M 한도보다는 작습니다.
워크로드가 진정으로 긴 컨텍스트(전체 저장소, 책 한 권 분량의 계약서 세트, 하나의 프롬프트에 담긴 긴 연구 자료)라면, K3는 검색 메커니즘을 구축하기 전에 더 많은 여유 공간을 제공합니다. 그러나 더 큰 창은 기능이지 전체 범위에 걸쳐 품질을 보장하는 것은 아니므로, 백만 토큰 프롬프트 깊숙이까지 답변이 정확하게 유지되는지 확인한 후에 신뢰해야 합니다.
개방성: 오픈 웨이트 대 폐쇄형
개방성은 모델로 무엇을 할 수 있는지 변경하며, 어떠한 가격 책정이나 벤치마킹도 이를 대체할 수 없습니다. Kimi K3의 가중치는 2026년 7월 27일경에 공개되어, 폐쇄형 모델이 할 수 없는 선택지를 열어줍니다: 데이터 상주 또는 에어갭 환경을 위한 자체 호스팅, 자체 데이터로 미세 조정, 그리고 단일 벤더의 속도 제한이나 로드맵으로부터의 자유. 규제 산업의 경우, "가중치가 우리 하드웨어에서 실행된다"는 것은 벤치마크 점수와 관계없이 결정적인 요인이 될 수 있습니다.
Claude Opus 4.8은 폐쇄형입니다. Anthropic의 API를 통해 접근하며, 일관된 호스팅, 지원 관계, 공개된 정책, 그리고 실행할 인프라가 없는 관리형 서비스를 제공받습니다. Anthropic의 API 문서는 모델 제품군을 다룹니다. K3는 제어권과 책임감을 제공하며, Opus는 편리함과 의지할 수 있는 벤더를 제공합니다.
속도 및 지연 시간
속도는 단일 숫자보다 미묘합니다. Artificial Analysis는 K3의 출력 속도를 초당 약 62토큰으로 측정했는데, 이는 해당 가격대의 중간값인 약 73토큰보다 낮습니다. 하지만 첫 토큰까지의 시간은 약 1.99초로 빠릅니다. 따라서 K3는 답변 시작 시 반응성이 좋게 느껴지지만, 본문 생성은 느리며, 장황한 출력은 긴 완성 작업이 더욱 느리게 느껴지게 합니다. Opus 4.8에 대한 일치하는 독립적인 수치는 없으므로, 긴 출력에 대한 처리량이 중요하다면 자체 프롬프트로 두 모델을 모두 벤치마크해야 합니다.
워크로드별 의사 결정 매트릭스
하나의 승자를 가리기보다는, 작업에 맞는 모델을 선택해야 합니다.
| 워크로드 | 적합 모델 | 이유 |
|---|---|---|
| 매우 긴 컨텍스트 작업 (전체 저장소, 대규모 문서 세트) | Kimi K3 | 1M 토큰 창으로 청킹 및 검색 작업 감소 |
| 대용량, 비용 민감형 생성 | Kimi K3 | 낮은 입출력 요금, 강력한 캐시 히트 가격 책정 |
| 자체 호스팅, 데이터 상주, 또는 미세 조정 | Kimi K3 | 2026년 7월 27일경 오픈 웨이트 공개 |
| 가장 어려운 추론 및 에이전트 품질 상한 | 둘 다 테스트 | 논쟁의 여지: Moonshot 자체 출시 벤치마크에서는 K3가 Opus 4.8보다 앞서지만, 이는 벤더 자체 실행이며 Opus는 복잡한 에이전트 작업에 대한 더 긴 프로덕션 실적을 보유 |
| 미션 크리티컬 신뢰성 및 지원 | Claude Opus 4.8 | SLA, 지원, 공개된 정책을 갖춘 관리형 상업 서비스 |
| 지연 시간에 민감한 대화형 앱 | 둘 다 테스트 | K3는 첫 토큰까지의 시간이 빠르지만, 생성 속도가 느리고 더 장황함 |
| 예산 제약이 있는 프로토타입 및 사이드 프로젝트 | Kimi K3 | 최전선에 가까운 품질에 도달하는 가장 저렴한 경로 |
K3는 경제성, 컨텍스트, 제어권을 소유하며, Moonshot 자체 벤치마크에 따르면 품질 면에서도 Opus 4.8과 동등하거나 능가합니다. Opus 4.8이 소유한 것은 관리형 벤더의 안락함입니다. 대부분의 팀은 어떤 워크로드는 한쪽 방향을, 다른 워크로드는 다른 방향을 가리킨다는 것을 알게 될 것이므로, 하나로 표준화하기보다는 둘 다 활용할 수 있도록 준비해야 합니다.
실제 사용 사례
- 문서 분석 제품을 개발하는 스타트업. 긴 계약서, 높은 쿼리 볼륨, 낮은 마진. K3의 1M 컨텍스트와 저렴한 가격은 거의 완벽하게 들어맞으며, 데이터 상주가 나중에 요구 사항이 되면 오픈 웨이트는 자체 호스팅 경로를 제공합니다.
- 다단계 에이전트 워크플로우를 자동화하는 기업. 신뢰성이 중요하고 실수는 값비쌉니다. Moonshot의 벤치마크는 K3가 앞선다고 하지만, Opus 4.8의 더 긴 프로덕션 실적은 이러한 수치가 재현될 때까지 일부 팀이 프리미엄을 지불하는 이유입니다.
- 제3자 API로 데이터를 보낼 수 없는 규제 대상 은행. 벤치마크 논쟁은 핵심이 아닙니다. K3의 오픈 웨이트는 은행 자체 환경 내에서 실행되는 반면, 폐쇄형 API 서비스인 Opus 4.8은 완전히 배제될 수 있습니다.
Apidog에서 동일한 요청으로 두 모델 모두 테스트하기
서류상의 비교만으로는 한계가 있습니다. Kimi K3는 OpenAI SDK와 호환되고 Claude Opus 4.8은 자체 API를 통해 접근할 수 있으므로, Apidog에서 둘 다 요청으로 설정하고 동일한 페이로드를 각각에 보낼 수 있습니다.
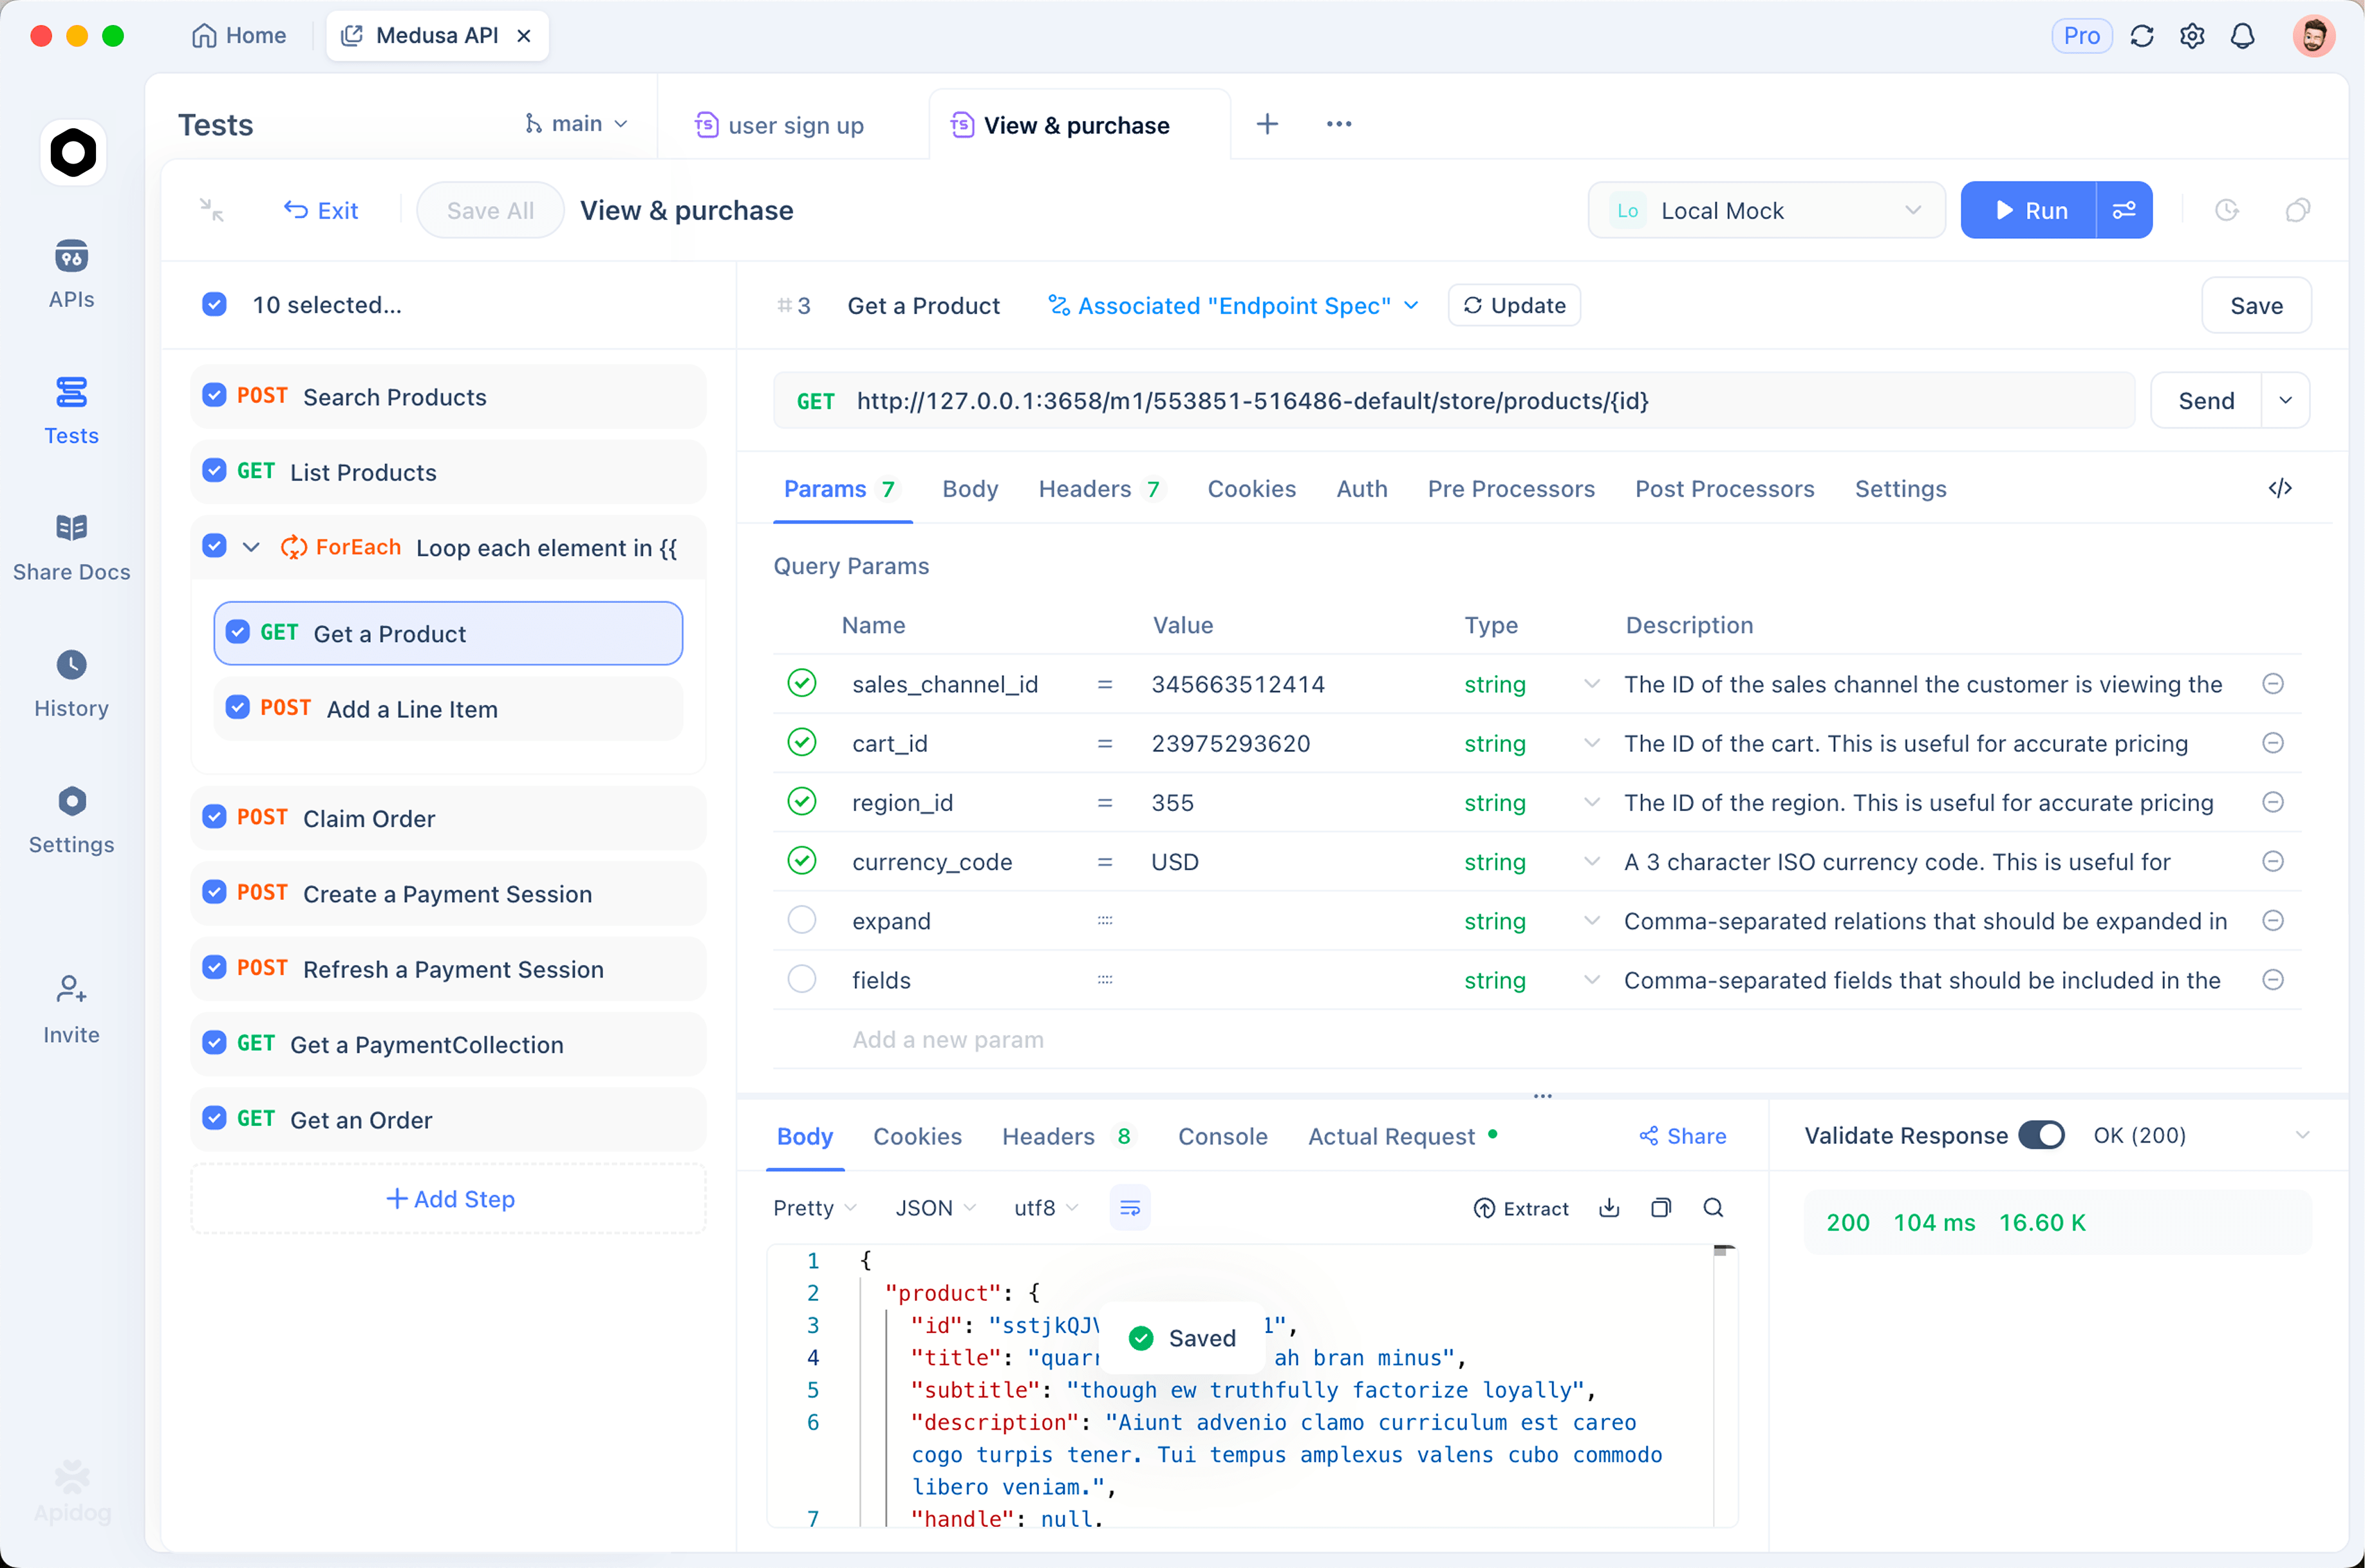
K3 엔드포인트용 요청 하나와 Opus용 요청 하나를 생성하고, 키와 기본 URL을 환경 변수로 저장한 다음, 동일한 프롬프트를 두 모델에 모두 보냅니다. Apidog는 각 호출에 대한 응답 본문, 상태, 타이밍을 표시하므로, 동일한 입력에 대해 답변 품질, 지연 시간, 토큰 비용을 비교할 수 있으며, 이를 컬렉션으로 저장하면 모델이 업데이트될 때마다 반복적으로 재실행할 수 있는 반복 가능한 테스트 도구를 얻을 수 있습니다. VS Code 내의 Apidog를 사용하여 이러한 검사를 수행할 수 있으며, 이 접근 방식은 Postman 없는 API 테스트로도 활용될 수 있습니다. 직접 설정하려면 Apidog를 다운로드하세요. 목표: "어떤 모델이 전반적으로 더 좋은가"를 "이 프롬프트에 대해 이 비용, 이 지연 시간에서 어떤 모델이 더 좋은가"로 대체하는 것입니다.
결론
Kimi K3는 가격, 컨텍스트 창, 개방성 면에서 Claude Opus 4.8을 결정적으로 능가하며, Moonshot 자체 출시 벤치마크에서는 품질 면에서도 Opus 4.8보다 높은 점수를 기록했습니다. 하지만 이 수치들은 벤더 자체 실행이며 아직 독립적으로 재현되지 않았습니다. Opus 4.8이 유지하는 것은 보증 측면입니다: 관리형 벤더, 공개된 정책, 그리고 어려운 에이전트 작업에 대한 입증된 신뢰성 실적. 워크로드가 긴 컨텍스트, 비용에 민감하거나 자체 호스팅이 필요한 경우 K3가 실용적인 선택이며, 상업적 관계와 입증된 실적을 원한다면 Opus 4.8이 프리미엄을 정당화합니다. 아직 독립적인 직접 비교가 없으므로, 결정하기 전에 자체 프롬프트로 두 모델을 모두 테스트해보세요.
자주 묻는 질문
- Kimi K3가 Claude Opus 4.8보다 더 나은가요? 막상막하이며, 우리가 가진 수치로는 K3가 최소한 동등해 보입니다. 가격, 컨텍스트, 개방성에서 우위를 점하고, Moonshot 자체 출시 벤치마크에서는 나열된 모든 작업에서 Opus 4.8보다 높은 점수를 기록했지만, 이 수치들은 벤더 자체 실행이며 아직 독립적으로 재현되지 않았습니다. Moonshot은 K3가 최고 독점 모델에 뒤처진다고 말하지만, Fable 5와 GPT-5.6 Sol을 언급했지 Opus 4.8은 언급하지 않았으므로, Opus 4.8의 진정한 강점은 벤치마크 우위가 아니라 실적과 관리형 지원입니다.
- Kimi K3는 얼마나 더 저렴한가요? K3는 캐시 히트 입력 시 백만 토큰당 $0.30, 캐시 미스 입력 시 $3.00, 출력 시 $15.00를 책정합니다. Opus 4.8은 입력에 $5.00, 출력에 $25.00를 책정합니다. 따라서 K3는 캐시된 입력에서 훨씬 저렴하고, 캐시 미스 시 절반 이하의 가격이며, 출력에서 약 40% 저렴합니다. 실제 절감액은 입력의 캐시 가능성에 따라 달라집니다.
- Kimi K3와 Opus 4.8을 직접 비교하는 독립적인 벤치마크가 있나요? 아직 없습니다. Artificial Analysis는 개별 모델에 대한 독립적인 지능 지수(Intelligence Index) 점수를 제공하고, Moonshot은 자체 벤치마크 수치를 공개하지만, K3 대 Opus 4.8의 공통되고 직접적인 비교 표는 없습니다. "8개 자동화 벤치마크 중 4개에서 1위"와 같은 벤더 보고 승리는 독립적으로 재현될 때까지 자체 보고로 간주해야 합니다.
- Kimi K3는 Opus 4.8의 경쟁자인가요 아니면 Claude Fable 5의 경쟁자인가요? K3는 전반적인 분야에서 경쟁합니다. 출시 보도는 K3를 Opus 4.8과 비교했는데, 이는 오픈 경쟁자가 그럴듯하게 도달할 수 있는 티어이기 때문입니다. Anthropic의 현재 최전선 모델은 Claude Fable 5이며, Moonshot은 K3가 여전히 이에 뒤처진다는 것을 인정하므로, K3는 독점 분야를 능가하기보다는 따라잡는 모델로 이해하는 것이 가장 좋습니다.