
Moonshot의 Kimi K2.7 Code는 대부분의 개발자가 실제로 비용을 지불하는 두 모델인 Claude Opus 및 GPT-5.5와 비교하여 벤치마크를 기록했습니다. 요약하자면, 폐쇄형 프론티어 모델은 대부분의 코딩 작업에서 여전히 더 높은 점수를 얻지만, 가격이 시사하는 만큼 큰 차이는 아닙니다. Kimi는 다운로드하여 자체 호스팅할 수 있는 오픈 웨이트 모델이며, 대여만 가능한 모델들과 몇 점 차이로 비슷합니다.
이 비교는 수치를 나란히 놓고, 비용 및 개방성과 비교하여 어떤 작업에 어떤 모델을 선택해야 하는지 알려줍니다.
핵심 요약
- 원시 코딩 품질: GPT-5.5와 Claude Opus가 대부분의 스위트에서 선두를 달립니다. Kimi K2.7 Code는 몇 점 뒤처집니다.
- 비용: Kimi는 훨씬 저렴하며(100만 토큰당 $0.95/$4.00) 자체 호스팅이 무료입니다. 폐쇄형 모델은 비용이 더 많이 들고 자체 하드웨어에 호스팅할 수 없습니다.
- 개방성: Kimi는 수정된 MIT 라이선스 하에 오픈 웨이트를 제공합니다. Opus와 GPT-5.5는 폐쇄형입니다.
- 결론: 최고의 단일 샷 품질을 원한다면 프론티어 모델을 선택하세요. 마지막 몇 점보다 비용, 볼륨 또는 데이터 제어가 더 중요하다면 Kimi를 선택하세요.
경쟁 모델 한눈에 보기
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| 유형 | 오픈 웨이트 (수정된 MIT) | 폐쇄형 | 폐쇄형 |
| 아키텍처 | MoE, 총 1T / 활성 32B | 미공개 | 미공개 |
| 컨텍스트 창 | 256K 토큰 | 대형 | 대형 |
| 자체 호스팅 | 예 | 아니오 | 아니오 |
| 가격 (100만 토큰당) | 입력 $0.95 / 출력 $4.00 | 더 높음, 대여 전용 | 더 높음, 대여 전용 |
구조적 차이가 핵심입니다. Kimi는 정확히 무엇이며 직접 실행할 수 있도록 해줍니다. 다른 두 모델은 호출하는 서비스입니다.
코딩 벤치마크
이 수치들은 Moonshot이 보고한 점수입니다. 여러 스위트가 Moonshot 자체의 것이므로 공급업체의 관점에서 해석해야 하지만, 패턴은 일관성이 있고 읽어볼 가치가 있습니다.
| 벤치마크 | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5는 처음 두 벤치마크에서 1위를 차지했으며, Claude Opus는 MLS Bench Lite에서 선두를 달리고 모든 곳에서 근접한 점수를 유지합니다. Kimi는 각 벤치마크에서 한 단계 아래에 있습니다. Kimi Code Bench v2에서는 격차가 작지만, Program Bench에서는 더 넓습니다. 귀하의 작업이 두 번째 벤치마크와 유사하다면, 프론티어 모델은 그 가치를 증명할 것입니다.
에이전틱 및 도구 사용 벤치마크
코딩 에이전트는 코드 생성뿐만 아니라 도구 호출에 따라 성패가 갈립니다. 여기서는 격차가 좁아집니다.
| 벤치마크 | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
MCP Mark Verified에서 Kimi는 GPT-5.5가 훨씬 앞서지만 Claude Opus를 실제로 앞섭니다. MCP Atlas에서는 세 모델이 약 5점 이내에 있습니다. 에이전틱 작업 부하의 경우, Kimi는 원시 코딩 점수가 시사하는 것보다 다른 모델들과 더 가깝습니다. 이는 토큰 비용이 정확히 여기서 많이 발생하기 때문에 중요합니다.
비용 측면에서 Kimi의 승리
벤치마크는 품질을 측정합니다. 비용을 측정하지는 않습니다. Kimi K2.7 Code는 입력 토큰 100만 개당 $0.95, 출력 100만 개당 $4.00이며, 캐시 히트는 100만 개당 $0.19입니다. 폐쇄형 프론티어 모델은 토큰당 훨씬 더 많은 비용이 들며, 이를 호스팅하여 피할 수는 없습니다. 다운로드할 수 없기 때문입니다.
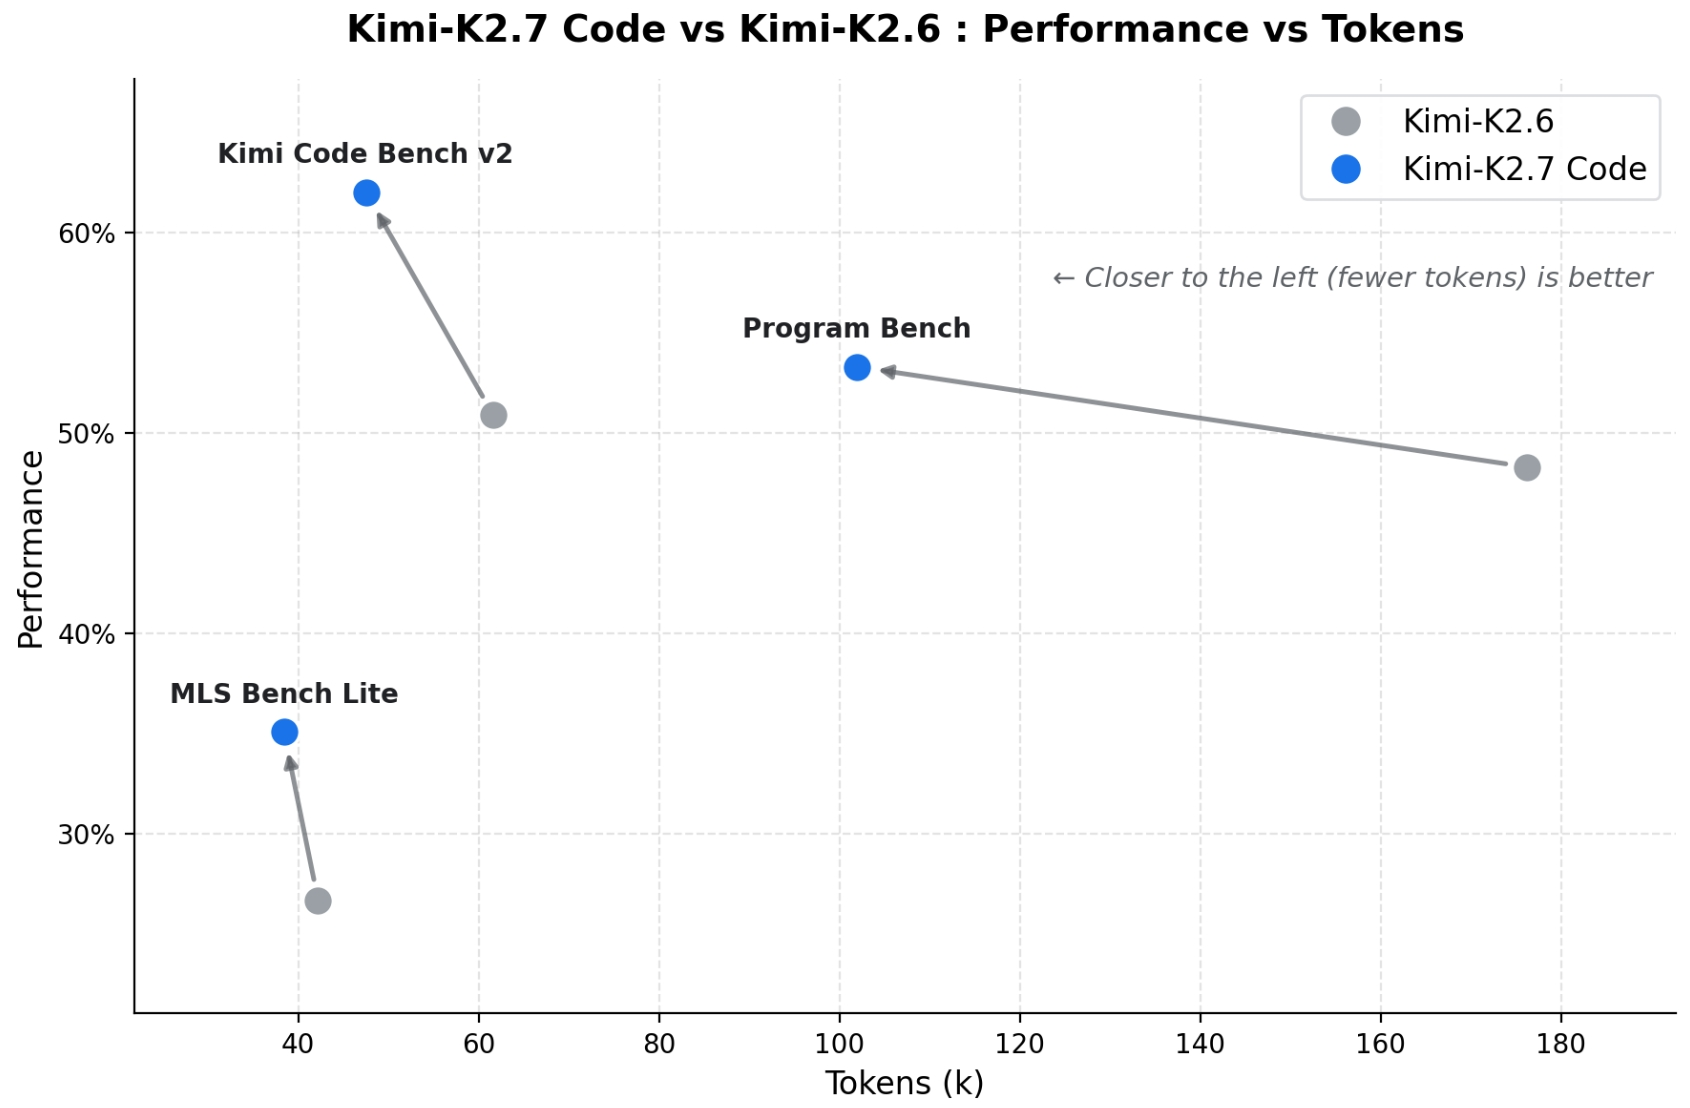
두 가지 요인이 절감 효과를 증폭시킵니다:
- 오픈 웨이트는 제로 토큰 옵션을 의미합니다. 자체 하드웨어에 자체 호스팅하면 토큰당 비용이 완전히 사라집니다. GPU 시간과 맞바꾸는 셈입니다.
- 더 효율적인 추론. K2.7 Code는 동일한 작업을 위해 K2.6보다 약 30% 적은 추론 토큰을 사용하므로, 각 에이전트 단계의 비용이 줄어듭니다. 에이전트 토큰 비용 절감 가이드에서 이러한 절감 효과가 합산되는 이유에 대해 자세히 설명합니다.
작업당 수백 개의 도구 호출을 수행하는 에이전트의 경우, 가격의 일부로 90%만큼 좋은 모델이 총 가치 면에서 종종 승리합니다.
컨텍스트 및 개방성
세 모델 모두 긴 컨텍스트를 잘 처리합니다. Kimi의 컨텍스트 창은 256K 토큰으로, 단일 프롬프트에서 전체 서비스와 테스트를 처리하기에 충분합니다. 더 큰 차별점은 라이선스입니다. Kimi의 수정된 MIT 웨이트를 통해 모델을 미세 조정하고, 감사하며, 에어갭 상태로 실행할 수 있습니다. 규정 준수 또는 데이터 상주 규칙이 있는 팀에게 이는 선택 사항이 아니라 결정적인 요인이며, 폐쇄형 모델은 단순히 고려 대상이 아닙니다.
각 모델을 선택해야 할 때
다음 경우 GPT-5.5 또는 Claude Opus를 선택하세요:
- 최고의 단일 샷 코딩 품질이 필요하고 몇 점의 벤치마크 점수가 비용을 정당화할 수 있는 경우.
- 관리형 SLA가 있는 폐쇄형 서비스를 대여하는 것이 괜찮은 경우.
- 가장 어려운 작업이 Program Bench와 유사하여 격차가 가장 큰 경우.
다음 경우 Kimi K2.7 Code를 선택하세요:
- 토큰 비용이 실행 가능성을 결정하는 대규모 에이전트 작업 부하를 실행하는 경우.
- 데이터가 자체 인프라에 남아 있어야 하는 경우.
- 모델을 미세 조정하거나 감사하려는 경우.
- 리더보드의 최상위가 아니라 총 가치를 최적화하는 경우.
더 넓은 분야에서는 저희의 MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 비교가 다른 오픈 웨이트 경쟁 모델을 다루고, 코딩을 위한 DeepSeek V4 vs Claude Opus는 또 다른 오픈 대 폐쇄형 대결을 심층적으로 다룹니다. 모델이 아닌 에이전트를 비교한다면 Claude Code vs OpenAI Codex를 참조하세요.
직접 비교해 보기
벤치마크는 시작점일 뿐, 귀하의 코드베이스에 대한 최종 판결은 아닙니다. 솔직한 테스트는 귀하의 작업에서 세 모델 모두를 실행하고 결과를 읽는 것입니다. Kimi Code CLI는 에이전트를 무료로 제공하며, 각 모델의 API를 직접 호출하여 원시 출력을 비교할 수 있습니다.
그렇게 할 때, Apidog에서 엔드포인트를 테스트하세요: 각 모델에 동일한 프롬프트를 보내고, 호출을 나란히 저장하고, 응답 품질, 지연 시간 및 토큰 사용량을 한곳에서 비교하세요. Apidog를 다운로드하여 경쟁 테스트를 실행해 보세요.
자주 묻는 질문
Kimi K2.7 Code가 Claude Opus 또는 GPT-5.5보다 우수한가요? Moonshot이 보고한 코딩 벤치마크에서는 그렇지 않습니다. 폐쇄형 모델이 대부분의 스위트에서 더 높은 점수를 얻습니다. Kimi의 장점은 오픈 웨이트와 훨씬 낮은 비용이며, 점수 차이는 몇 점에 불과합니다.
Kimi는 얼마나 저렴한가요? 입력 토큰 100만 개당 $0.95, 출력 100만 개당 $4.00이며, 자체 호스팅은 무료입니다. 폐쇄형 프론티어 모델은 토큰당 비용이 더 많이 들고 자체 호스팅할 수 없습니다.
Kimi K2.7 Code를 직접 실행할 수 있나요? 예. 웨이트는 수정된 MIT 라이선스 하에 공개되어 있으며, vLLM, SGLang 또는 KTransformers로 서비스할 수 있습니다.
코딩 에이전트에게 가장 좋은 모델은 무엇인가요? 원시 품질 측면에서는 GPT-5.5가 선두를 달립니다. 비용 효율적인 대규모 에이전트의 경우 Kimi가 더 나은 가치를 제공하며, 에이전틱 벤치마크에서도 근접합니다.
이러한 벤치마크는 중립적인가요? 여러 스위트가 Moonshot 자체의 것이므로 공급업체의 관점에서 해석해야 합니다. 프론티어 모델과의 일관된 격차가 유용한 신호이며, 정확한 수치 자체가 아닙니다.
요약
Kimi K2.7 Code는 대부분의 코딩 벤치마크에서 Claude Opus나 GPT-5.5를 능가하지 않으며, Moonshot도 그렇게 주장하지 않습니다. 몇 점 더 낮은 점수를 기록하지만 비용이 훨씬 적게 들고 직접 실행할 수 있는 오픈 웨이트를 제공합니다. 가능한 최고의 품질을 위해서는 여전히 폐쇄형 프론티어 모델이 승리합니다. 대규모 에이전트, 프라이빗 배포 또는 차트 상위권보다 총 가치를 중요하게 여기는 사람에게는 Kimi가 더 현명한 선택입니다. 귀하의 코드에서 세 모델 모두를 실행하고 Apidog에서 출력을 비교한 다음, 귀하의 작업 부하에 따라 결정하세요.