
Muse Wonder API는 https://api.meta.ai/v1에서 muse-wonder-1.0을 제공하는 Meta의 Model API이며, Responses API, Chat Completions, Anthropic 호환 Messages 엔드포인트라는 세 가지 요청 형식을 지원합니다. dev.meta.ai에서 발급한 bearer 키로 인증하고, 입력 100만 토큰당 $4, 출력 100만 토큰당 $20을 지불합니다. 컨텍스트 창은 100만 토큰이며, minimal부터 max까지의 추론 노력을 사용할 수 있습니다. 베이스 URL만 변경하면 모든 OpenAI SDK를 사용할 수 있습니다.
이 가이드는 키 발급부터 동작하는 에이전트 루프까지 안내합니다. 첫 요청, 엔드포인트 선택, 추론 제어, 멀티턴 상태, 도구, 스트리밍, 백그라운드 실행, 호출 비용을 알려주는 사용량 필드를 다룹니다. 모든 요청은 Apidog에도 설정되어 있어, 팀이 키를 공유하지 않고 모델을 테스트할 수 있습니다. 모델 자체와 점수는 먼저 Muse Wonder 설명 글을 참고하세요.
Muse Wonder API 한눈에 보기
| 값 | |
|---|---|
| 베이스 URL | https://api.meta.ai/v1 |
| 모델 ID | muse-wonder-1.0 |
| 인증 | Authorization: Bearer $MODEL_API_KEY |
| 엔드포인트 | POST /v1/responses, POST /v1/chat/completions, POST /v1/messages |
| 100만 토큰당 가격 | 입력 $4, 출력 $20, 캐시 입력 $0.20 |
| 컨텍스트 창 | 1,048,576 토큰, 롱 컨텍스트 추가 요금 없음 |
| 추론 노력 | minimal, low, medium, high, xhigh, max |
| 속도 제한 | 팀당 모델당 분당 3,000 요청 및 400만 토큰 |
| 웹 검색 도구 | 토큰 외에 1,000 쿼리당 $2.50 |
더 큰 모델인 Muse Wonder Full은 API에 제공되지 않습니다. Muse Code의 Power 및 Maximum 요금제에서만 사용할 수 있습니다. Wonder에서 노력을 max로 설정해도 Full로 바뀌지 않습니다.
1단계: 키 발급받고 첫 호출 만들기
Model API 대시보드의 API keys에서 키를 만들고 MODEL_API_KEY로 저장하세요. 그다음:
curl https://api.meta.ai/v1/responses \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "muse-wonder-1.0",
    "input": "List three risks in a lease clause that lets the landlord enter without notice.",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 2048
  }'
OpenAI SDK에서는 두 줄만 변경하면 됩니다.
from openai import OpenAI
import os

client = OpenAI(base_url="https://api.meta.ai/v1", [REDACTED CREDENTIAL] = client.responses.create(
    model="muse-wonder-1.0",
    input="List three risks in a lease clause that lets the landlord enter without notice.",
    reasoning={"effort": "medium"},
    max_output_tokens=2048,
)
print(resp.output_text)
print(resp.usage)
응답에는 텍스트와 usage 블록이 포함됩니다. 모든 호출에서 확인하세요. output_tokens_details.reasoning_tokens는 출력 예산 중 얼마나 생각에 사용되었는지 알려주고, input_tokens_details.cached_tokens는 얼마나 많은 입력이 캐시 요율로 과금되었는지 보여줍니다.
2단계: 엔드포인트 선택하기
Meta 퀵스타트는 Responses API를 사용하며, 여러 단계 작업에는 이것이 올바른 기본값입니다. Responses는 턴 간 추론을 유지하고 대화 기록을 관리할 수 있습니다. Chat Completions은 이미 OpenAI SDK 기반으로 작성된 코드를 위해 존재합니다. https://api.meta.ai/v1/messages의 Messages 엔드포인트는 Anthropic 형식 요청을 받으며, 이를 통해 Claude Code가 Muse Wonder에서 실행됩니다.
| 필요 사항 | 사용할 API |
|---|---|
| 새 에이전트, 도구 루프, 긴 세션 | Responses |
| 기존 OpenAI 형식 코드, 단일 턴 | Chat Completions |
| Claude Code 또는 다른 Anthropic 형식 하네스 | Messages |
| 추론 요약 | Responses 전용 |
세 형식은 매개변수 이름이 다릅니다. 추론 노력은 Responses에서 reasoning.effort이고 Chat Completions에서는 최상위 reasoning_effort입니다. 출력 상한은 각각 max_output_tokens와 max_tokens입니다. Responses의 구조화 출력은 response_format이 아니라 text.format을 사용합니다.
3단계: 추론 노력 설정하기
Muse Wonder는 항상 추론합니다. none은 HTTP 400을 반환합니다. 허용되는 수준은 minimal, low, medium, high, xhigh, max이며, 매개변수를 생략하면 모델이 직접 수준을 선택합니다. Meta의 조언은 일반적입니다. 추론 토큰은 $20 출력 요율로 과금되고 출력 상한에 포함되므로, 허용 가능한 결과를 주는 가장 낮은 수준을 사용하세요.
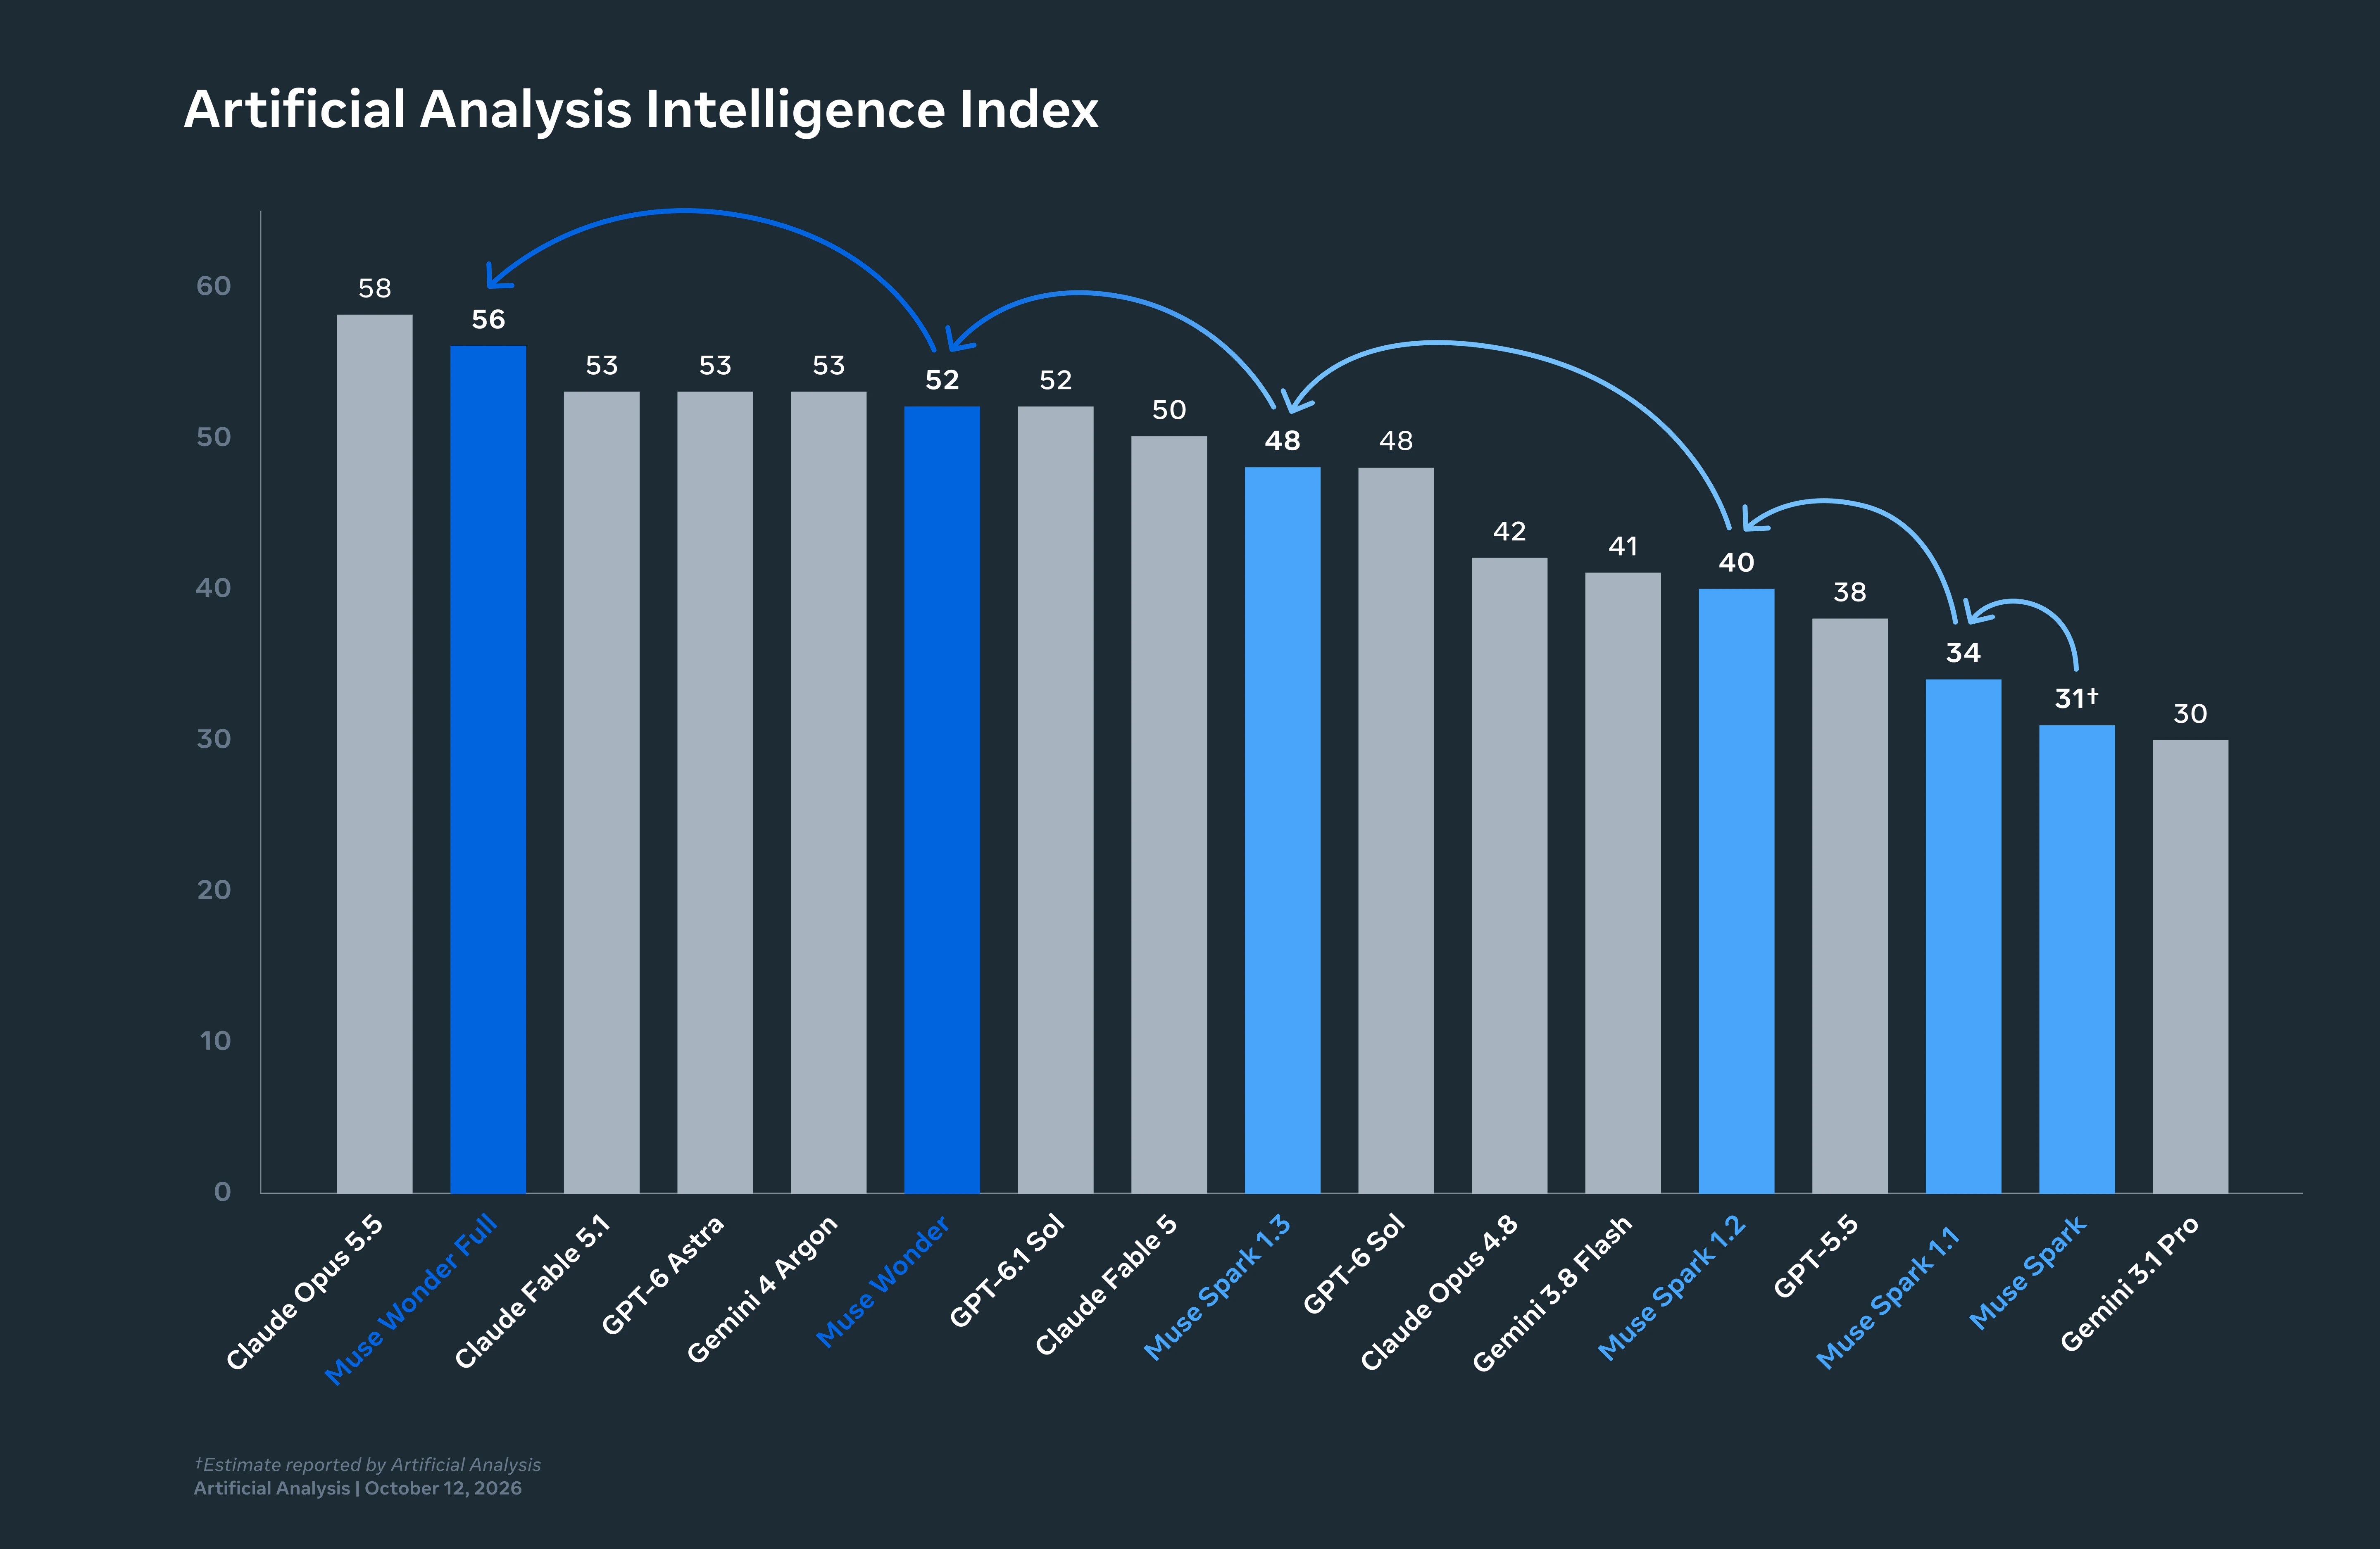
두 가지 실용적 규칙이 따릅니다. 첫째, 높은 노력에서는 max_output_tokens를 넉넉하게 설정하세요. max에서는 추론이 출력의 큰 부분을 차지하므로, 너무 낮은 상한은 답변을 자릅니다. 둘째, 요청 유형별로 reasoning_tokens를 기록해 벤치마크가 아니라 실제 트래픽에서 각 노력 수준의 비용을 확인하세요. 이 모델을 52점으로 평가한 Artificial Analysis 실행은 max 노력과 작업당 약 54,000 출력 토큰을 사용했습니다.
Responses API에서는 reasoning.summary를 auto, concise, detailed로 설정해 추론 요약을 요청할 수 있습니다. 요약은 보장되지 않으며 배열이 비어 반환될 수 있습니다. 원시 추론은 절대 반환되지 않습니다.
4단계: 턴 간 상태 유지하기
Responses API는 두 가지 모드를 제공하며, 이들은 결합할 수 없습니다.
상태 비저장 암호화 재생은 Meta의 권장 방식입니다. store: false와 include: ["reasoning.encrypted_content"]를 보내고, 응답이 반환하는 reasoning 항목을 유지한 뒤, 다음 턴에서 그 encrypted_content와 summary 필드와 함께 다시 전달하세요(빈 배열도 괜찮습니다). Meta가 아무것도 저장하지 않아도 모델의 추론은 턴을 넘어 살아남습니다.
서버 관리 기록은 더 간단합니다. previous_response_id를 전달하고 새 입력만 보내세요. instructions는 유지되지 않으므로 매 요청마다 시스템 지시를 다시 보내야 합니다.
first = client.responses.create(model="muse-wonder-1.0", input="Summarize this API's auth flow: ...", instructions="You are an API reviewer.")
second = client.responses.create(model="muse-wonder-1.0", previous_response_id=first.id, instructions="You are an API reviewer.", input="Now list the endpoints that need an OAuth scope.")
5단계: 도구, 구조화 출력, 웹 검색
함수 도구는 Responses와 Chat Completions에서 OpenAI 형식을 따릅니다. Muse Wonder는 도구를 병렬로 호출하고, 실패한 도구 호출에서 회복하도록 학습되었습니다. 이것이 Meta 출시 글에서 Active Focus라고 하는 특징 중 하나입니다. JSON 스키마로 도구를 정의하고, 모델이 반환한 function_call 항목을 실행한 뒤, function_call_output 항목을 다시 보내세요.
코드가 파싱할 수 있는 답변을 원하면 Responses에서 text.format을 JSON 스키마로 설정하세요. 최신 정보를 위해 tools=[{"type": "web_search"}]로 Meta의 호스팅 검색을 추가하면, 토큰 외에 1,000 쿼리당 $2.50이 과금됩니다. 다른 모델의 도구 호출을 이미 테스트 중이라면, Apidog의 에이전트 도구 호출 하네스를 여기 그대로 사용할 수 있습니다. 요청 형식은 OpenAI와 같습니다.
6단계: 스트리밍 또는 백그라운드 실행
stream: true를 설정하고 이벤트 스트림을 소비하세요. response.created, response.output_item.added, response.output_text.delta, response.function_call_arguments.delta, response.completed입니다. 실패는 response.failed로 끝납니다. 요청한 경우 추론 요약은 response.reasoning_summary_text.delta로 도착합니다.
긴 작업에는 background: true를 보내세요. API는 "status": "queued"로 응답하고, GET /v1/responses/{id}?stream=true에서 수명 주기 이벤트를 폴링하거나 스트리밍합니다. Background는 POST의 stream: true와 결합할 수 없고, 요청 본문은 1 MiB로 제한되며, 팀당 분당 600건의 새 백그라운드 제출이라는 별도 한도가 있습니다. POST /v1/responses/{id}/cancel로 취소하세요.
7단계: 반복되는 내용 캐시하기
캐시 입력은 100만 토큰당 $0.20으로, $4 요율에서 95% 할인입니다. Meta는 이를 usage.input_tokens_details.cached_tokens로 보고합니다. 이 혜택을 얻는 패턴은 다른 공급자와 같습니다. 안정적인 자료(시스템 지시, 도구 정의, 참조 문서)를 앞에 두고 요청별 콘텐츠를 뒤에 두세요. 프롬프트 캐싱 가이드가 접두사 설계를 다룹니다. 캐시 쓰기도 주의하세요. Artificial Analysis 실행에서는 작업당 $4.52 중 $1.92가 캐시 쓰기였고, 캐시 히트 $1.44보다 많았습니다.
Apidog에서 Muse Wonder API 테스트하기
공유 Apidog 프로젝트는 키를 채팅 스레드 밖에 두고, 모두에게 같은 요청을 제공합니다.
- 환경을 만드세요. 이름은 Meta Model API로 하고,
base_url은https://api.meta.ai/v1,MODEL_API_KEY는 비밀 변수로 설정하세요. 비밀 값은 UI에서 마스킹되고 절대 내보내지지 않습니다. - 세 개의 요청을 추가하세요. 엔드포인트마다 하나씩 만들고, 각각
Authorization: Bearer {{MODEL_API_KEY}}를 설정하세요. Responses 요청을low,medium,max노력용으로 복제해 비용을 나란히 비교할 수 있게 하세요. - 사용량을 검증하세요.
$.usage.output_tokens_details.reasoning_tokens와$.usage.input_tokens_details.cached_tokens에 JSONPath 어서션을 추가하세요. 캐시 히트를 기대한 요청에서 cached-tokens 값이 0이면 접두사 버그이며, 프로덕션 전에 발견됩니다. - 429를 목업하세요. Meta 문서는 약 500 ms에서 지터를 포함한 지수 백오프를 사용하고
Retry-After를 존중하라고 안내합니다. 해당 헤더와 함께 429를 반환하는 Apidog 목업에 클라이언트를 연결해, 팀원들과 분당 3,000 요청 한도를 공유하기 전에 재시도 로직을 증명하세요. - CI에서 실행하세요. Apidog CLI를 사용하면 모델이나 가격 변경이 고객이 아니라 파이프라인에서 실패합니다.
Apidog를 다운로드하고 위 요청 예제에서 세 엔드포인트를 가져오세요.
자주 묻는 질문
Muse Wonder API에 무료 사용권이 있나요? 없습니다. 최소 금액 없이 토큰별로 과금되므로 몇 번의 테스트 호출은 몇 센트지만, 무료 크레딧은 없습니다. 무료 접근 가이드가 가장 저렴한 방법을 다룹니다.
내 API 데이터가 학습에 사용되나요? API의 Standard 모드에서는 사용되지 않습니다. Muse Code 구독은 기본적으로 데이터를 사용하는 Contributor 모드입니다. 이 설정은 API가 아니라 Muse Code에 있습니다.
API로 Muse Wonder Full을 사용할 수 있나요? 불가능합니다. 호출할 모델 ID도 토큰별 가격도 없습니다. Muse Code Power 및 Maximum 구독자만 선택할 수 있습니다.
속도 제한은 무엇이며 늘릴 수 있나요? 모델당 분당 3,000 요청과 400만 토큰이며, 팀의 모든 키를 합산해 계산됩니다. Meta 가격 페이지에는 등급이나 증액 절차가 없습니다. 속도 제한 글이 한도 내에 유지되는 방법을 다룹니다.
다음 단계
제품의 실제 작업 하나에 위 세 호출을 low, medium, max 노력으로 실행하고, 기본값을 고르기 전에 reasoning_tokens를 비교하세요. 청구서는 $4라는 표제가 아니라 이 숫자를 따릅니다.