
Firecrawl Local을 사용하려면 cargo install firecrawl-local로 설치한 뒤, firecrawl-local init를 실행해 Claude Code와 Cursor에 MCP 서버로 등록하고 두 도구를 재시작하세요. 이제 에이전트가 여러분의 컴퓨터에서 사이트를 스크래핑, 크롤링, 매핑할 수 있습니다. 코드에서 사용하려면 firecrawl-local serve를 실행하고 아무 Firecrawl SDK나 http://localhost:3002로 연결하면 됩니다.
이 가이드는 Firecrawl Local을 단계별로 사용하는 방법을 보여줍니다. 2026년 11월 19일(arm64 Mac에서 Firecrawl Local 0.1.0) 실제 테스트 실행에서 나온 출력과 함께, 에이전트에 전달할 프롬프트, 그리고 에이전트가 Apidog CLI로 로컬 API를 테스트하는 방법을 다룹니다.
시작하기 전에 필요한 것
Firecrawl Local은 Firecrawl 저장소에서 제공하는 단일 Rust 바이너리입니다. 설치하기 전에 다음을 확인하세요.
- Rust와 C 컴파일러. Rust는 rustup.rs에서 받으세요. macOS에서는
xcode-select --install을 실행하고, Debian이나 Ubuntu에서는build-essential을 설치합니다. - Node.js 22 이상(MCP 서버를 사용하려는 경우).
npx로firecrawl-mcpnpm 패키지를 실행합니다. - Chrome 또는 Chromium(선택 사항). Firecrawl Local은 JavaScript가 필요한 페이지에 대해 여러분이 이미 설치한 브라우저를 사용합니다. 정적 페이지는 브라우저 없이도 작동합니다.
- Claude Code, Cursor 또는 기타 MCP 클라이언트.
init는 Claude Desktop, Windsurf, Gemini CLI, Codex도 인식합니다.
Firecrawl 자체가 처음이라면, Firecrawl 웹 스크래핑 가이드를 먼저 읽고 돌아오세요.
1단계: Firecrawl Local 설치
crates.io에서 크레이트를 설치하고 버전을 확인하세요.
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Cargo가 소스에서 컴파일합니다. 테스트한 Mac에서는 릴리스 빌드가 6분 54초 만에 끝났고 바이너리는 ~/.cargo/bin/firecrawl-local에 생성되었습니다. 해당 폴더가 PATH에 있는지 확인하거나, 전체 경로를 기억해 두세요. 수동 MCP 설정에 필요합니다.
2단계: 터미널에서 첫 스크래핑 실행
무엇이든 에이전트에 연결하기 전에 먼저 가져오기가 작동하는지 확인하세요.
FIRECRAWL_CLOUD=off firecrawl-local scrape https://example.com --markdown
1.2초 만에 페이지의 본문 텍스트를 마크다운으로 출력했습니다. --markdown을 빼면 Firecrawl API가 반환하는 것과 동일한 JSON을 얻습니다. --format markdown,links로 형식을 선택할 수 있으며, 로컬에서 지원하는 형식은 markdown, html, rawHtml, links입니다.
다음은 페이지마다 마크다운 파일 하나를 생성하는 크롤링입니다.
FIRECRAWL_CLOUD=off firecrawl-local crawl https://docs.firecrawl.dev --limit 20 --out ./pages
이 명령은 Firecrawl 문서 20개 페이지를 4.4초 만에 가져왔고, 0005-docs.firecrawl.dev_advanced-scraping-guide.md 같은 이름의 파일로 저장했습니다. firecrawl-local crawl --help에서 확인한 유용한 크롤링 플래그는 다음과 같습니다.
| 플래그 | 설명 |
|---|---|
-l, --limit |
최대 페이지 수(기본값 100) |
--max-depth |
링크를 몇 단계까지 따라갈지 |
--include, --exclude |
유지하거나 건너뛸 경로 정규식, 반복 지정 가능 |
--entire-domain |
시작 경로 외부의 링크도 따라가기 |
-c, --concurrency |
동시에 가져올 페이지 수 |
--ignore-robots |
robots.txt 무시(기본적으로는 읽음) |
firecrawl-local map https://firecrawl.dev는 사이트맵과 시작 페이지에서 발견한 모든 URL을 하나의 JSON 줄로 반환합니다.
3단계: init으로 Claude Code와 Cursor에 Firecrawl Local 추가
init은 컴퓨터에 있는 AI 도구를 찾아 각 도구의 MCP 설정에 Firecrawl Local을 추가합니다. 먼저 미리 보기로 확인하세요.
firecrawl-local init --dry-run
테스트한 Mac에서는 변경될 모든 도구가 나열되었습니다.
Firecrawl MCP server:
  Claude Code: would be added in ~/.claude.json
  Claude desktop: would be added in ~/Library/Application Support/Claude/claude_desktop_config.json
  Cursor: would be added in ~/.cursor/mcp.json
  Gemini CLI: would be added in ~/.gemini/settings.json
  Codex: would be added in ~/.codex/config.toml
드라이 런은 Firecrawl 클라우드로 전송되는 항목도 출력합니다. 검색 쿼리, 여러분의 컴퓨터를 차단한 페이지의 URL, 로그인 후의 Alexandria 호출, 그리고 무작위 설치 ID와 AI 도구의 이름입니다. 로컬에서 정상적으로 로드되는 페이지는 절대 전송되지 않습니다.
이 가이드에서 다루는 두 도구만 설정하려면 --agent를 반복하세요.
firecrawl-local init --agent claude-code --agent cursor
유효한 이름은 claude-code, claude-desktop, cursor, windsurf, gemini, codex입니다. init은 각 설정 파일을 쓰기 전에 백업합니다. 이후 Claude Code와 Cursor를 재시작해야 새 서버가 로드됩니다.
Claude Code에 Firecrawl Local 직접 추가하기
도구가 설정 파일을 수정하게 두고 싶지 않다면, Claude Code MCP 명령으로 stdio 서버를 직접 추가하세요.
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- ~/.cargo/bin/firecrawl-local mcp --public-only
Claude Code에서 /mcp를 실행해 서버가 연결되었는지 확인하세요.
Cursor에 Firecrawl Local 직접 추가하기
Cursor는 ~/.cursor/mcp.json(전역) 또는 .cursor/mcp.json(단일 프로젝트)에서 MCP 서버를 읽습니다. 바이너리의 전체 경로를 사용하세요.
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}
--public-only는 서버가 localhost와 사설 네트워크 주소를 거부하도록 합니다. 신뢰할 수 없는 페이지를 에이전트가 읽을 때는 이 옵션을 켜 두세요. 그렇지 않으면 페이지에 숨겨진 지시문이 에이전트를 내부 URL로 유도할 수 있습니다.
4단계: 에이전트에 전달할 프롬프트
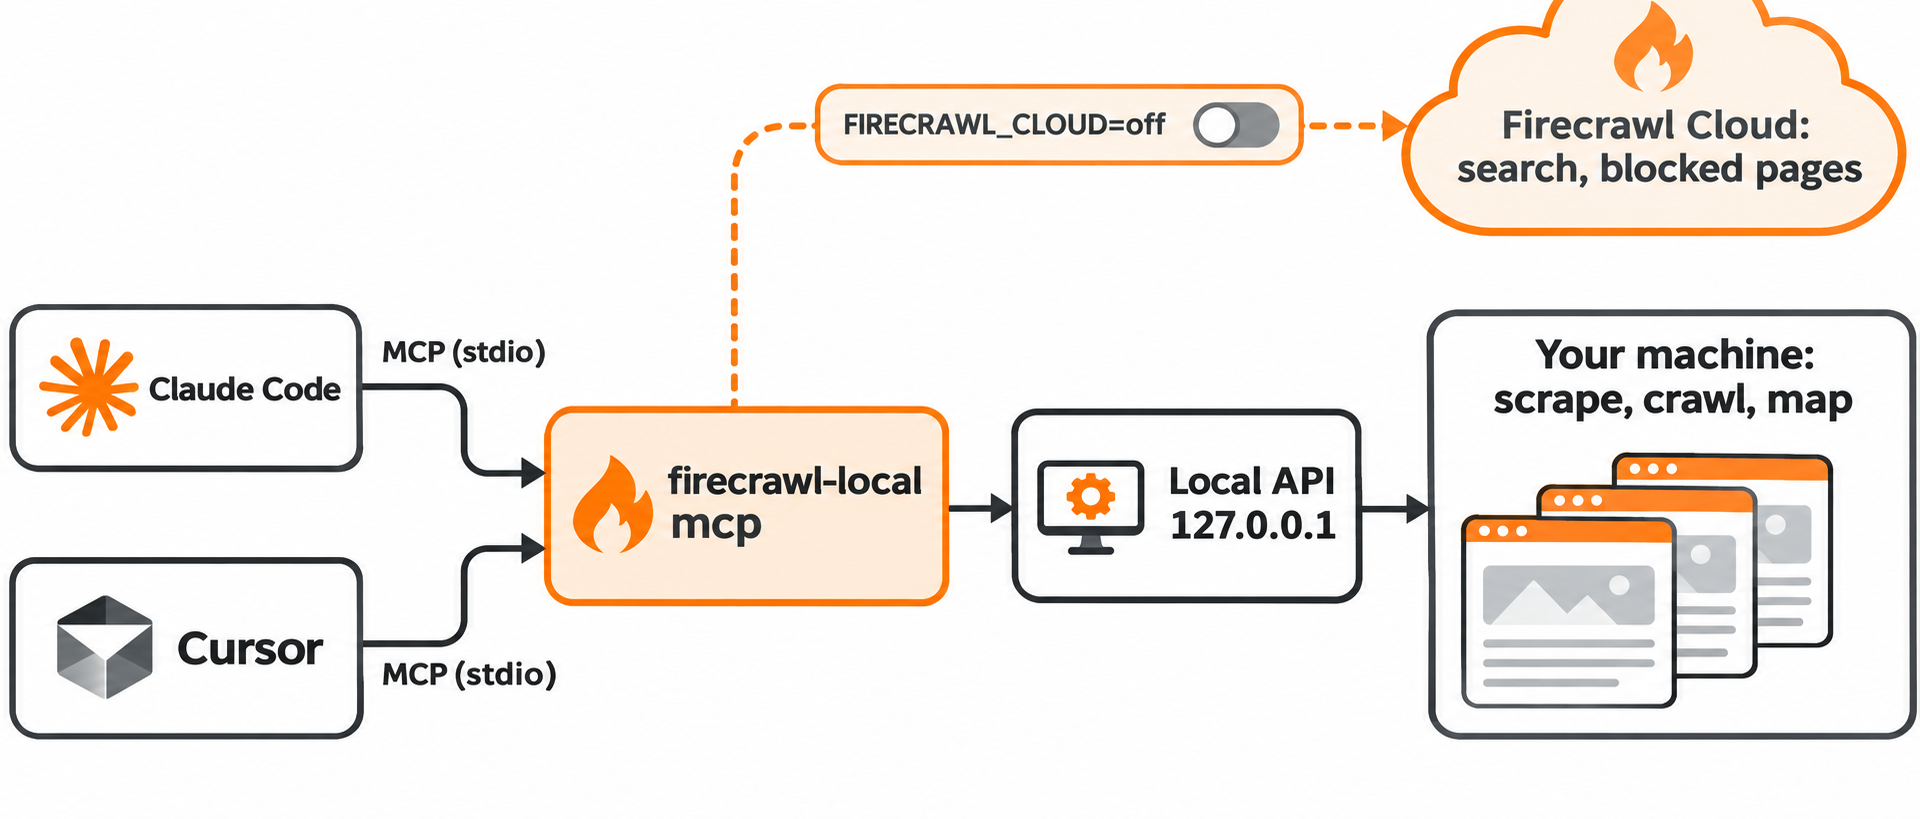
firecrawl-local mcp는 루프백 포트에서 로컬 API를 시작하고 firecrawl-mcp 패키지를 그것에 연결해 실행합니다. 에이전트는 표준 Firecrawl MCP 도구를 보게 되며, 스크래핑, 크롤링, 매핑, 배치 스크래핑이 여러분의 컴퓨터에서 실행됩니다. 호스팅된 Firecrawl MCP 서버를 사용해 봤다면 도구 이름은 동일합니다.
로컬 도구에 잘 맞는 프롬프트입니다.
Map https://docs.example.com, then crawl only the /api/ pages (limit 40)
and write a summary of every endpoint into docs/vendor-api.md.
Scrape the changelog at https://example.com/changelog as markdown and list
every breaking change from the last three releases.
Batch scrape these five pricing pages and build a comparison table of
plan names and limits. Quote only what the pages say.
검색이 필요한 프롬프트는 피하세요. FIRECRAWL_CLOUD=off에서는 해당 도구가 어디에도 연결되지 않습니다. 완전히 로컬인 검색 환경을 구성하려면 Claude용 오픈소스 웹 검색 가이드를 참고하세요.
5단계: Firecrawl Local API 실행하고 SDK 연결하기
스크립트와 파이프라인용으로 API 서버를 실행하세요.
FIRECRAWL_CLOUD=off firecrawl-local serve
127.0.0.1:3002에서 대기합니다. 상태 확인은 즉시 응답합니다.
curl -s localhost:3002/health
# {"status":"ok","engine":"firecrawl-local","version":"0.1.0"}
스크래핑 결과는 익숙한 v2 형태로 반환되며, 두 가지 로컬 표시가 포함됩니다. "engine": "local-fetch"와 "source": "local", 그리고 creditsUsed: 0입니다.
curl -s localhost:3002/v2/scrape -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown","links"]}'
API 키 없이 Firecrawl SDK를 이 서버에 연결하세요. Python:
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Node:
import { Firecrawl } from "firecrawl";

const app = new Firecrawl({ apiUrl: "http://localhost:3002" });
const doc = await app.scrape("https://example.com");
console.log(doc.markdown);
init는 간단한 방법도 제안합니다. FIRECRAWL_API_URL=http://127.0.0.1:3002를 설정하면 기존 Firecrawl 코드가 로컬에서 실행됩니다. Firecrawl CLI는 저장된 로그인 정보를 Firecrawl Local과 공유하므로, 어느 도구에서 login을 해도 둘 다 사용할 수 있습니다.
크롤링은 비동기로 진행됩니다. POST /v2/crawl은 즉시 작업 ID를 반환했고, 몇 초 후 GET /v2/crawl/{id}는 status: completed, total: 10, creditsUsed: 0, expiresInSeconds: 3587을 보고했습니다. 작업은 메모리에 존재하며 시작 후 한 시간 뒤 만료되고 serve가 중지되면 사라지므로, 크롤링이 완료되면 즉시 결과를 저장하세요.
ps로 측정한 결과 서버 프로세스는 유휴 상태에서 약 10 MB, 10페이지 크롤링 직후 약 43 MB의 상주 메모리를 사용했습니다. Firecrawl의 출시 게시물은 자체 호스팅 Firecrawl보다 37배 빠르고 메모리는 230배 적다고 주장합니다. README에는 방법론이 공개되어 있지 않으므로 Firecrawl 측 수치로 받아들이세요.
FIRECRAWL_CLOUD로 Firecrawl Local을 완전히 로컬로 유지하기
기본값(auto)에서는 세 가지가 Firecrawl 클라우드로 전송됩니다. 검색, 여러분의 컴퓨터를 차단한 페이지, 그리고 Alexandria 데이터 제공자(firecrawl-local login으로 무료 계정 필요)입니다. FIRECRAWL_CLOUD는 이 전환을 제어합니다.
| 값 | 효과 |
|---|---|
auto(기본값) |
검색, 차단 페이지 폴백, Alexandria 모두 작동 |
search |
검색만 Firecrawl 클라우드로 전송 |
off |
Firecrawl 클라우드로 아무것도 전송하지 않음 |
인식되지 않는 값은 off로 처리됩니다. 클라우드가 꺼져 있으면 POST /v2/search는 "code":"CLOUD_ONLY"와 함께 FIRECRAWL_API_KEY 또는 FIRECRAWL_CLOUD=auto를 설정하라는 메시지를 반환합니다. 클라우드가 대신 가져온 페이지에는 "source": "firecrawl-cloud"가 붙으므로, 결과의 출처를 항상 알 수 있습니다.
serve는 --allow-private를 전달하지 않는 한 localhost와 사설 대상 주소를 거부하며, 루프백이 아닌 --host에 바인딩하려면 --token이 필요합니다. 클라우드 메타데이터와 링크 로컬 주소는 모든 모드에서 차단됩니다.
Apidog CLI로 코딩 에이전트가 Firecrawl Local API를 테스트하게 하기
크롤링 엔드포인트는 파이프라인을 망가뜨리기 가장 쉬운 부분입니다. 비동기이고, 작업이 만료되며, 서버가 중지되면 사라지기 때문입니다. 직접 반복 조회하는 대신 코딩 에이전트가 Apidog CLI로 테스트를 작성하고 실행하도록 하세요.
한 번만 설정하면 됩니다.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
그런 다음 Claude Code나 Cursor에 프롬프트 하나를 전달하세요.
firecrawl-local serve is running on http://localhost:3002. In Apidog project <id>,
import an OpenAPI file for POST /v2/scrape, POST /v2/crawl and GET /v2/crawl/{id},
create an environment for that base URL, and build a test scenario that starts a
crawl of https://docs.firecrawl.dev with limit 10, saves the returned id, polls
GET /v2/crawl/{id} until status is "completed", and asserts total equals completed
and every page has non-empty markdown. Run it and summarize any failures.
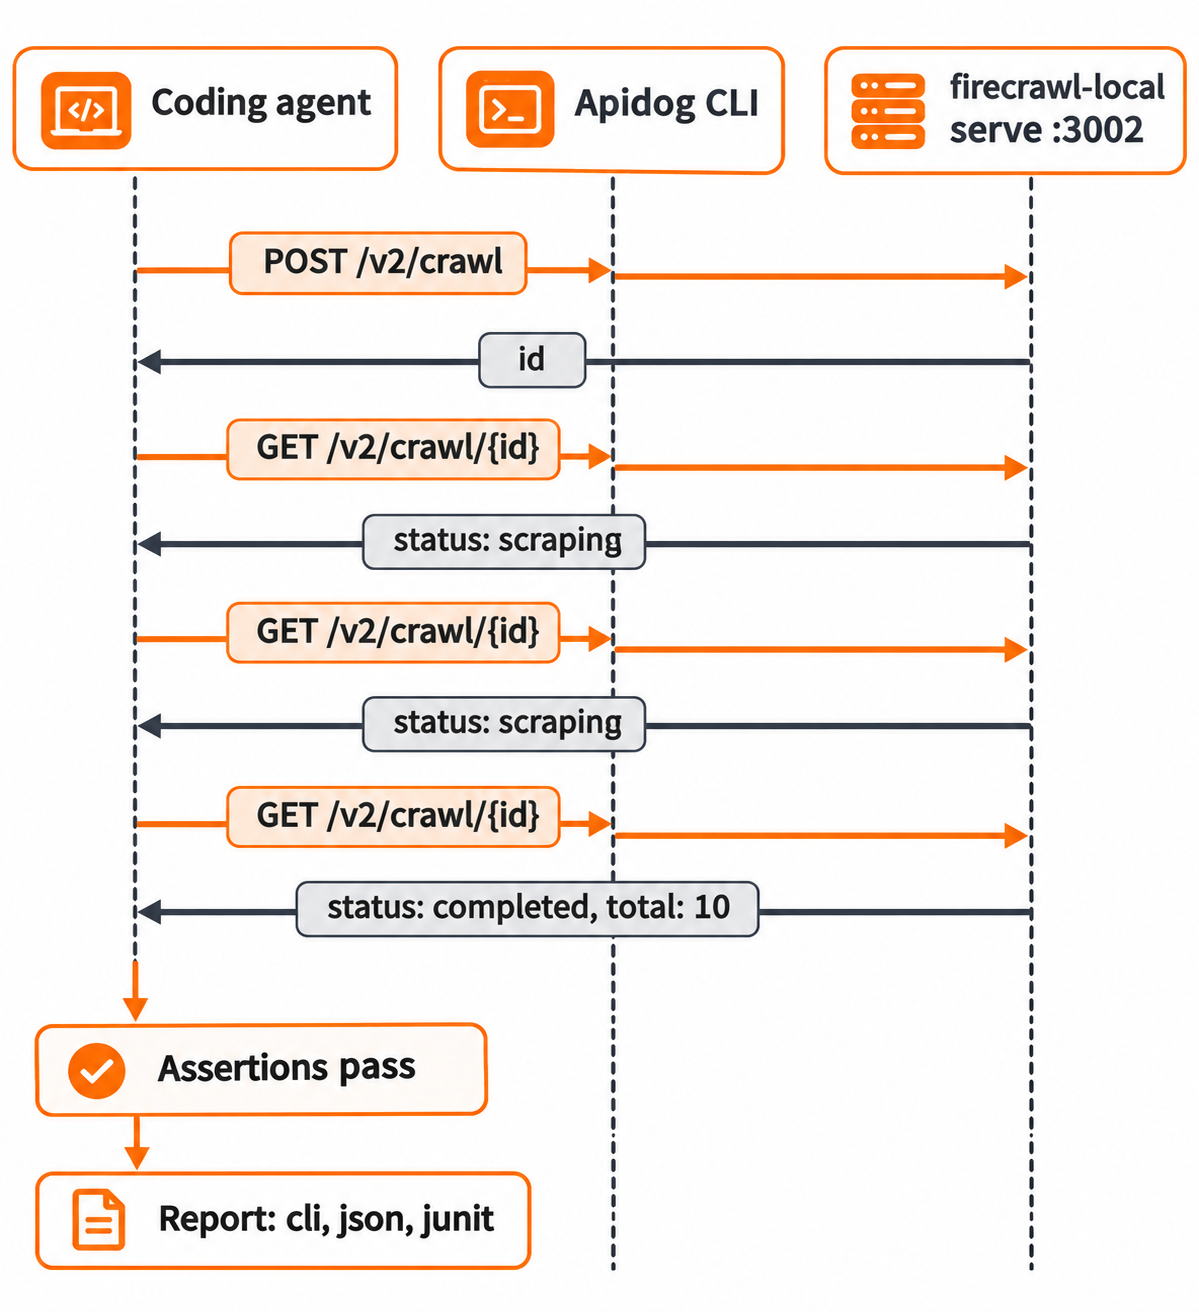
에이전트는 각 페이로드 스키마를 읽고 검증한 뒤 다음과 같은 명령을 실행합니다. 모두 CLI 2.2.12의 apidog <cmd> --help에서 가져온 것입니다.
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file ./scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Apidog CLI는 여러분의 컴퓨터에서 요청을 보내므로 localhost:3002에 접근할 수 있습니다. -r junit으로 전환하면 같은 실행을 CI에 넣을 수 있습니다. 에이전트 측면은 Claude Code에서의 Apidog CLI와 Cursor에서의 Apidog CLI 가이드에서 다룹니다. Apidog의 Free 플랜은 최대 4명 팀까지 지원합니다.
Firecrawl Local 문제 해결
| 증상 | 해결 |
|---|---|
/v1/scrape에서 NOT_FOUND와 함께 404 |
v2만 제공됩니다. 클라이언트를 /v2/...로 변경하세요 |
/v2/search에서 CLOUD_ONLY |
FIRECRAWL_CLOUD=off에서는 예상된 동작입니다. auto 또는 search를 사용하세요 |
| 에이전트에 Firecrawl 도구가 나타나지 않음 | init 후 도구를 재시작하세요. Node.js 22 이상을 확인하세요 |
| JavaScript 페이지가 빈약하게 반환됨 | Chrome을 설치하거나 --browser always를 설정하세요 |
json 또는 summary 형식이 없음 |
로컬에서는 지원되지 않으며 경고가 표시됩니다 |
| 크롤 ID를 찾을 수 없음 | 작업이 한 시간 후 만료되었거나 serve가 재시작됨 |
자주 묻는 질문
Firecrawl Local은 무료인가요? 로컬 스크래핑, 크롤링, 매핑은 Firecrawl에 아무것도 전송하지 않으며 테스트에서 크레딧을 0으로 사용했습니다. 코드는 AGPL-3.0, SDK는 MIT 라이선스입니다. 검색과 Alexandria는 Firecrawl 클라우드를 거칩니다.
Firecrawl Local을 사용하려면 API 키가 필요한가요? 로컬 경로에는 필요 없습니다. Alexandria 데이터 제공자에만 firecrawl-local login 또는 FIRECRAWL_API_KEY를 통한 키가 필요합니다.
Firecrawl Local은 Windsurf, Codex, Gemini CLI와 작동하나요? 네. init는 Claude Code, Claude Desktop, Cursor뿐 아니라 windsurf, codex, gemini도 인식합니다.
기존 Firecrawl 코드를 변경 없이 실행할 수 있나요? v2 스크래핑, 매핑, 크롤링, 배치 스크래핑에는 가능합니다. API URL을 http://localhost:3002로 변경하세요. v0와 v1 경로는 제공되지 않으며 브라우저 actions는 무시됩니다.
Firecrawl Local은 robots.txt를 준수하나요? 네. 크롤링 시 robots.txt를 읽고 User-Agent에 자신을 명시하므로, 사이트 소유자는 FirecrawlLocal로 이를 다룰 수 있습니다. --ignore-robots는 이 기능을 끄며, 소유한 사이트에서만 사용하세요.