
DeepSeek V4 Pro는 2026년 8월 12일에 미리보기 단계를 종료했습니다. 0813으로 표기된 GA 빌드는 이제 deepseek-v4-pro API 엔드포인트를 제공하며, 오타처럼 보이는 숫자를 자랑합니다: 1M 토큰 컨텍스트 창, 최대 384K 토큰 출력, 그리고 캐시 적중 시 백만 토큰당 $0.003625로 떨어지는 입력 가격입니다. Unite.AI가 보도한 바와 같이, 4개월간 미리보기로 제공되었던 이 모델은 이제 DeepSeek의 주력 모델이 되었습니다.
출시 보도 자료는 무엇이 출시되었는지 알려주지만, 어떻게 호출해야 하는지는 알려주지 않습니다. 이 가이드에서는 OpenAI SDK를 사용한 첫 번째 요청, 사고 모드 및 reasoning_content 필드, 스트리밍, 도구 호출, 그리고 1M 컨텍스트가 경제적인지 아니면 엄청난 비용을 초래할지 결정하는 프롬프트 캐싱 계산과 같은 실질적인 부분을 다룹니다. 아키텍처 배경 이야기가 먼저 궁금하시다면, DeepSeek V4란 무엇인가를 읽고 돌아오세요.
핵심 요약
- DeepSeek-V4-Pro-0813은 2026년 8월 12일 현재
deepseek-v4-pro엔드포인트의 GA 스냅샷이며, 프로덕션에서 목표로 삼아야 할 빌드입니다. - API는 OpenAI와 호환됩니다:
openaiSDK를https://api.deepseek.com으로 지정하고model="deepseek-v4-pro"를 설정하면 됩니다. Anthropic Messages 형식과 DeepSeek 자체 Responses API도 작동합니다. - 1M 토큰 컨텍스트, 최대 384K 출력, 답변과 함께
reasoning_content필드를 반환하는 세 가지 사고 모드(non-think,think high,think max). - 가격: $0.435/M 입력 (캐시 미스), $0.003625/M 입력 (캐시 적중, 120배 저렴), $0.87/M 출력. 캐싱은 반복되는 프롬프트 접두사에 대해 자동으로 적용됩니다.
- DeepSeek은 8월 6일에 '상당한' API 가격 인상이 있을 것이라고 경고했습니다. 아직 구체적인 수치나 날짜는 없으므로 여유를 두고 예산을 책정하십시오.
- 실제 시스템에 연결하기 전에 Apidog에서 엔드포인트를 테스트하고, SSE 스트림을 검사하며, pro/flash 환경을 나란히 유지하십시오.
GA 빌드 0813이 개발자에게 제공하는 변화
미리보기는 2026년 4월에 시작되었고, 작은 모델인 V4 Flash는 7월에 출시되었습니다. 8월 12일에는 DeepSeek의 일반적인 날짜 스탬프 규칙(v3-0324가 V3 스냅샷을 나타냈던 것과 같은 방식)에 따라 Pro 모델이 빌드 0813으로 일반 가용성(GA) 단계로 전환되었습니다.
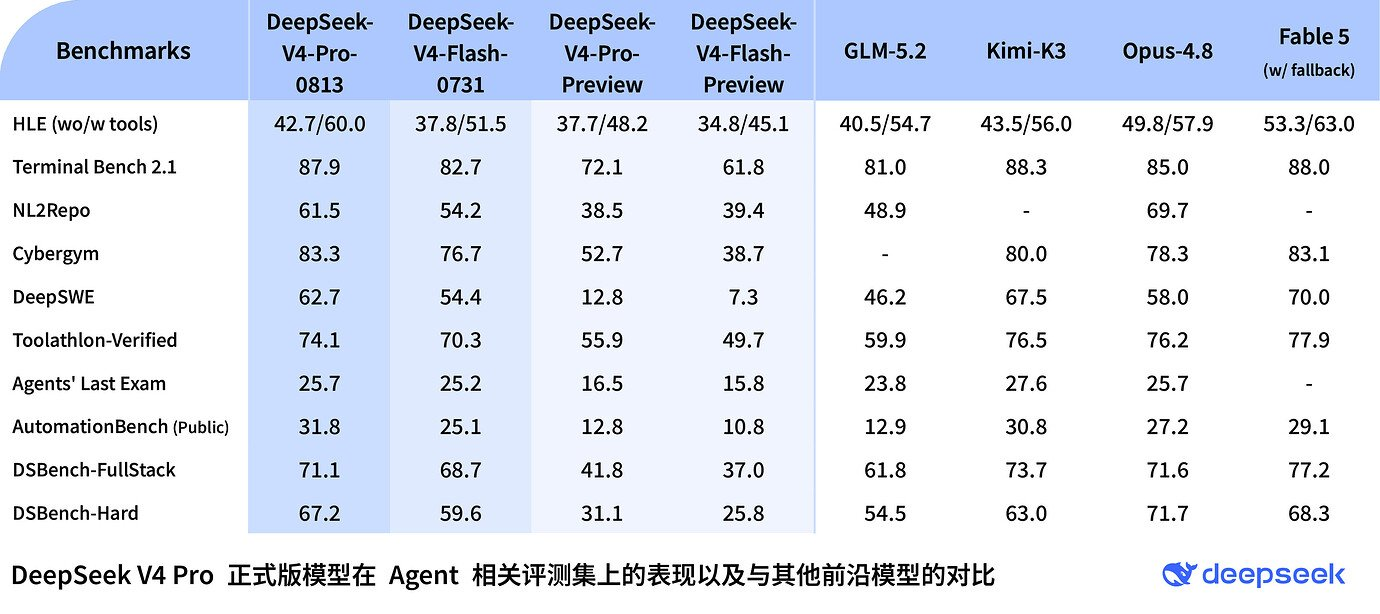
GA와 함께 세 가지가 변경됩니다:
- 스냅샷이 안정적입니다. 미리보기 모델은 예측할 수 없이 변경될 수 있어 평가 및 프롬프트 튜닝을 조용히 무효화할 수 있습니다. 빌드 0813은 DeepSeek이 새로운 스냅샷을 발표할 때까지 고정된 목표입니다.
- 엔드포인트는 프로덕션 별칭입니다. 공식 API에서는
deepseek-v4-pro를 호출하여 0813 빌드를 얻습니다. 스냅샷을 명시적으로 고정하려면, OpenRouter에서는deepseek/deepseek-v4-pro-0813으로 나열합니다. - 모든 기능이 활성화되었습니다. 사고 모드, 함수 호출, 구조화된 출력, 프롬프트 캐싱 및 다중 형식 API (OpenAI, Anthropic, Responses)가 모두 GA 엔드포인트에서 활성화됩니다.
내부적으로 V4 Pro는 총 1.6조 개의 매개변수와 토큰당 490억 개의 활성 매개변수를 가진 전문가 혼합(mixture-of-experts) 모델입니다. 주요 공학적 특징은 효율성입니다: Compressed Sparse Attention과 Heavily Compressed Attention이라는 두 가지 어텐션(attention) 스키마를 통해 단일 토큰 추론 연산 비용을 V3.2 대비 27%로, KV 캐시를 10%로 줄였습니다. 이러한 KV 캐시 감소 덕분에 1M 토큰 컨텍스트를 시연 기능이 아닌 이러한 가격으로 제공할 수 있게 되었습니다.
DeepSeek V4 Pro 0813: 한눈에 보는 사양
| 사양 | DeepSeek V4 Pro 0813 |
|---|---|
| 출시 | 2026년 8월 12일 GA (`0813` 스냅샷) |
| 아키텍처 | 전문가 혼합(Mixture-of-experts), 총 1.6조 개 매개변수, 토큰당 490억 개 활성 |
| 어텐션 | Compressed Sparse Attention + Heavily Compressed Attention |
| V3.2 대비 추론 비용 | 단일 토큰 연산의 27%, KV 캐시의 10% |
| 컨텍스트 창 | 1,000,000 토큰 |
| 최대 출력 | 384K 토큰 |
| 사고 모드 | 비사고(non-think), 고사고(think high), 최대사고(think max) |
| 입력 가격 | $0.435/M 토큰 (캐시 미스), $0.003625/M (캐시 적중) |
| 출력 가격 | $0.87/M 토큰 |
| API 형식 | OpenAI Chat Completions, Anthropic Messages, DeepSeek Responses |
| 모델 ID | deepseek-v4-pro |
| 하위 모델 | deepseek-v4-flash (총 2840억 / 활성 130억), 입력 $0.14/M, 출력 $0.28/M |
기능 면에서 DeepSeek 자체 모델 카드에는 최대 사고 구성인 V4-Pro-Max의 SWE-bench Verified가 80.6%, Terminal Bench 2.0이 67.9%, GPQA Diamond가 90.1%, LiveCodeBench가 93.5%로 나열되어 있습니다. 이들은 아직 제3자가 검증하지 않은 자체 보고된 공급업체 수치이므로, 중요한 것을 마이그레이션하기 전에 자체적인 작업별 평가를 수행하십시오.
API 키를 얻고 첫 번째 요청 만들기
설정은 약 5분 정도 소요됩니다:
- DeepSeek 플랫폼(platform.deepseek.com)에서 계정을 생성하고 크레딧을 충전하십시오. API는 선불입니다.
- API 키를 열고 키를 생성한 다음 즉시 복사하십시오 (한 번만 표시됩니다).
- 코드에 붙여넣기 대신 환경 변수로 내보내십시오:
export DEEPSEEK_API_KEY="sk-..."
API는 OpenAI Chat Completions 프로토콜을 사용하므로 표준 openai 패키지가 클라이언트입니다. https://api.deepseek.com과 https://api.deepseek.com/v1 모두 기본 URL로 작동하며, /v1은 프로토콜 호환성을 위한 것이지 모델 버전이 아닙니다.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a concise technical assistant."},
        {"role": "user", "content": "Explain idempotency in REST APIs in two sentences."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
처음부터 response.usage를 출력하십시오. 캐시 적중 시에는 저렴하고 1M 토큰 캐시 미스 시에는 비싼 이 모델에서 토큰 계산은 반올림 오차와 실제 요금 청구의 차이를 만듭니다.
원시 HTTP를 통한 동일한 요청, 스모크 테스트 및 API 도구로 가져오는 데 유용합니다:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-pro",
    "messages": [
      {"role": "user", "content": "List three ways to version a REST API."}
    ]
  }'
전체 매개변수 참조는 Anthropic 호환 엔드포인트(Anthropic SDK 및 Claude Code에서 아무것도 다시 작성할 필요 없이 사용 가능)와 DeepSeek 자체 Responses API를 포함하여 공식 DeepSeek 문서에 있습니다.
세 가지 사고 모드 사용하기
V4 Pro는 추론을 별도의 모델이 아닌 다이얼처럼 노출합니다. 하나의 엔드포인트, 세 가지 모드:
- 비사고(non-think): 모델이 직접 답변합니다. 가장 빠르고 저렴하며, 추출, 분류, 형식 지정 및 요약에 적합합니다.
- 고사고(think high): 모델이 답변하기 전에 추론하고 그 추론을
reasoning_content필드에 반환합니다. 코딩, 디버깅 및 다단계 분석의 기본값입니다. - 최대사고(think max): V4-Pro-Max 벤치마크 수치의 기반이 되는 최대 추론 예산. 정말 어려운 문제에 사용하십시오.
이 모드들은 표준 reasoning_effort 매개변수에 매핑되므로, 공급업체별 특정 설정이 필요하지 않습니다:
response = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high", # "none" | "high" | "max"
    messages=[
        {"role": "user", "content": "Our API returns 502s under load but only behind the CDN. Walk through likely causes in order of probability."},
    ],
)

message = response.choices[0].message
print("--- Reasoning ---")
print(message.reasoning_content)
print("--- Answer ---")
print(message.content)
```
두 가지 실용적인 참고 사항. 첫째, reasoning_content를 대화 기록에 다시 넣지 마십시오. 이전 턴의 content만 보내십시오. 둘째, 추론 토큰은 $0.87/M로 출력 토큰으로 청구되므로, 최대 사고(think max)는 실제 비용과 실제 지연 시간을 발생시킵니다. 기본적으로 최대로 설정하는 대신 작업에 맞는 모드를 사용하십시오.
스트리밍 응답
최대 384K 출력과 길게 추론할 수 있는 사고 모드를 고려할 때, 스트리밍이 아닌 요청은 사용자 경험을 저해합니다. stream=True로 설정하고 두 가지 델타 유형을 모두 처리하십시오. 사고 모드에서는 reasoning_content 청크가 먼저 도착한 다음 답변이 도착합니다:
stream = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high",
    stream=True,
    messages=[
        {"role": "user", "content": "Design a rate limiter for a public API. Compare token bucket and sliding window."},
    ],
)

for chunk in stream:
    if not chunk.choices:
        continue # final chunk may carry usage data only
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True) # thinking phase
    elif delta.content:
        print(delta.content, end="", flush=True) # answer phase
```
합리적인 UI 패턴: 추론 단계를 '생각 중' 표시로 접어서 렌더링한 다음, content 델타가 시작되면 일반 렌더링으로 전환합니다. 내부적으로 이것은 표준 서버 전송 이벤트(SSE)입니다. SSE로 API 응답 스트리밍하기에 대한 저희 가이드가 작동 방식을 다룹니다.
도구 호출 및 구조화된 출력
V4 Pro는 OpenAI 스타일의 함수 호출을 지원합니다. 즉, 기존 에이전트 루프는 수정 없이 이식될 수 있습니다. 도구를 정의하고, tool_calls를 읽고, 실행하고, 결과를 추가하고, 반복합니다:
tools = [{
    "type": "function",
    "function": {
        "name": "get_endpoint_status",
        "description": "Check the health of an internal API endpoint",
        "parameters": {
            "type": "object",
            "properties": {
                "endpoint": {"type": "string", "description": "Path, e.g. /v1/orders"}
            },
            "required": ["endpoint"],
        },
    },
}]

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "Is /v1/orders healthy right now?"}],
    tools=tools,
)

print(response.choices[0].message.tool_calls)
```
구조화된 출력은 파싱 가능한 JSON이 필요할 때 표준 response_format 매개변수를 통해 작동합니다. 다단계 도구 루프에 대한 전체 설명은 별도의 기사로 다룰 가치가 있습니다. 공식 문서에는 메시지 형식 세부 정보가 나와 있습니다.
프롬프트 캐싱 경제성: 아키텍처를 바꾸는 숫자
벤치마크보다 더 주목해야 할 사양입니다. DeepSeek은 프롬프트 접두사를 자동으로 캐시하며, 캐시 제어 헤더나 TTL 구성이 필요 없습니다. 반복되는 접두사는 $0.435/M 대신 $0.003625/M로 청구됩니다. 이는 API가 이미 본 입력에 대해 120배 할인된 가격입니다.
실제 작업 부하에 대한 숫자를 계산해봅시다. 200K 토큰 저장소 컨텍스트를 유지하고 세션에서 50번의 호출을 하는 코딩 에이전트를 구축한다고 가정해봅시다:
캐싱 없이: 50회 호출 × 200K 토큰 × $0.435/M ≈ 입력 비용 $4.35.자동 캐싱 적용 시: 캐시 미스 1회 ($0.087) + 캐시 적중 49회 (≈ 각 $0.0007) ≈ $0.12.
동일한 세션에서 약 35배 저렴하며, 필요한 것은 프롬프트 구조뿐입니다: 안정적인 콘텐츠를 먼저 (시스템 프롬프트, 문서, 저장소 컨텍스트), 변동적인 콘텐츠를 나중에 (사용자의 최신 메시지, 타임스탬프, 요청 ID) 배치합니다. 프롬프트 초반의 어떤 변경이라도 해당 지점부터 캐시된 접두사를 무효화하므로, 시스템 프롬프트에 타임스탬프가 있으면 모든 호출이 전체 가격의 캐시 미스로 조용히 전환됩니다.
이는 1M 컨텍스트 창을 다시 정의하기도 합니다: 미스 시 $0.435의 비용이 들지만, 안정적인 세션 접두사로 사용될 경우 호출당 약 0.33센트가 청구됩니다. 일반적인 이론에 대해서는 프롬프트 캐싱이란 무엇인가를 참조하십시오.
Apidog에서 deepseek-v4-pro 테스트하기
V4 Pro를 프로덕션 코드에 적용하기 전에, 적절한 디버거로 엔드포인트를 검사하십시오. DeepSeek의 API는 OpenAI와 호환되므로, Apidog는 특별한 처리 없이 이를 감지합니다:
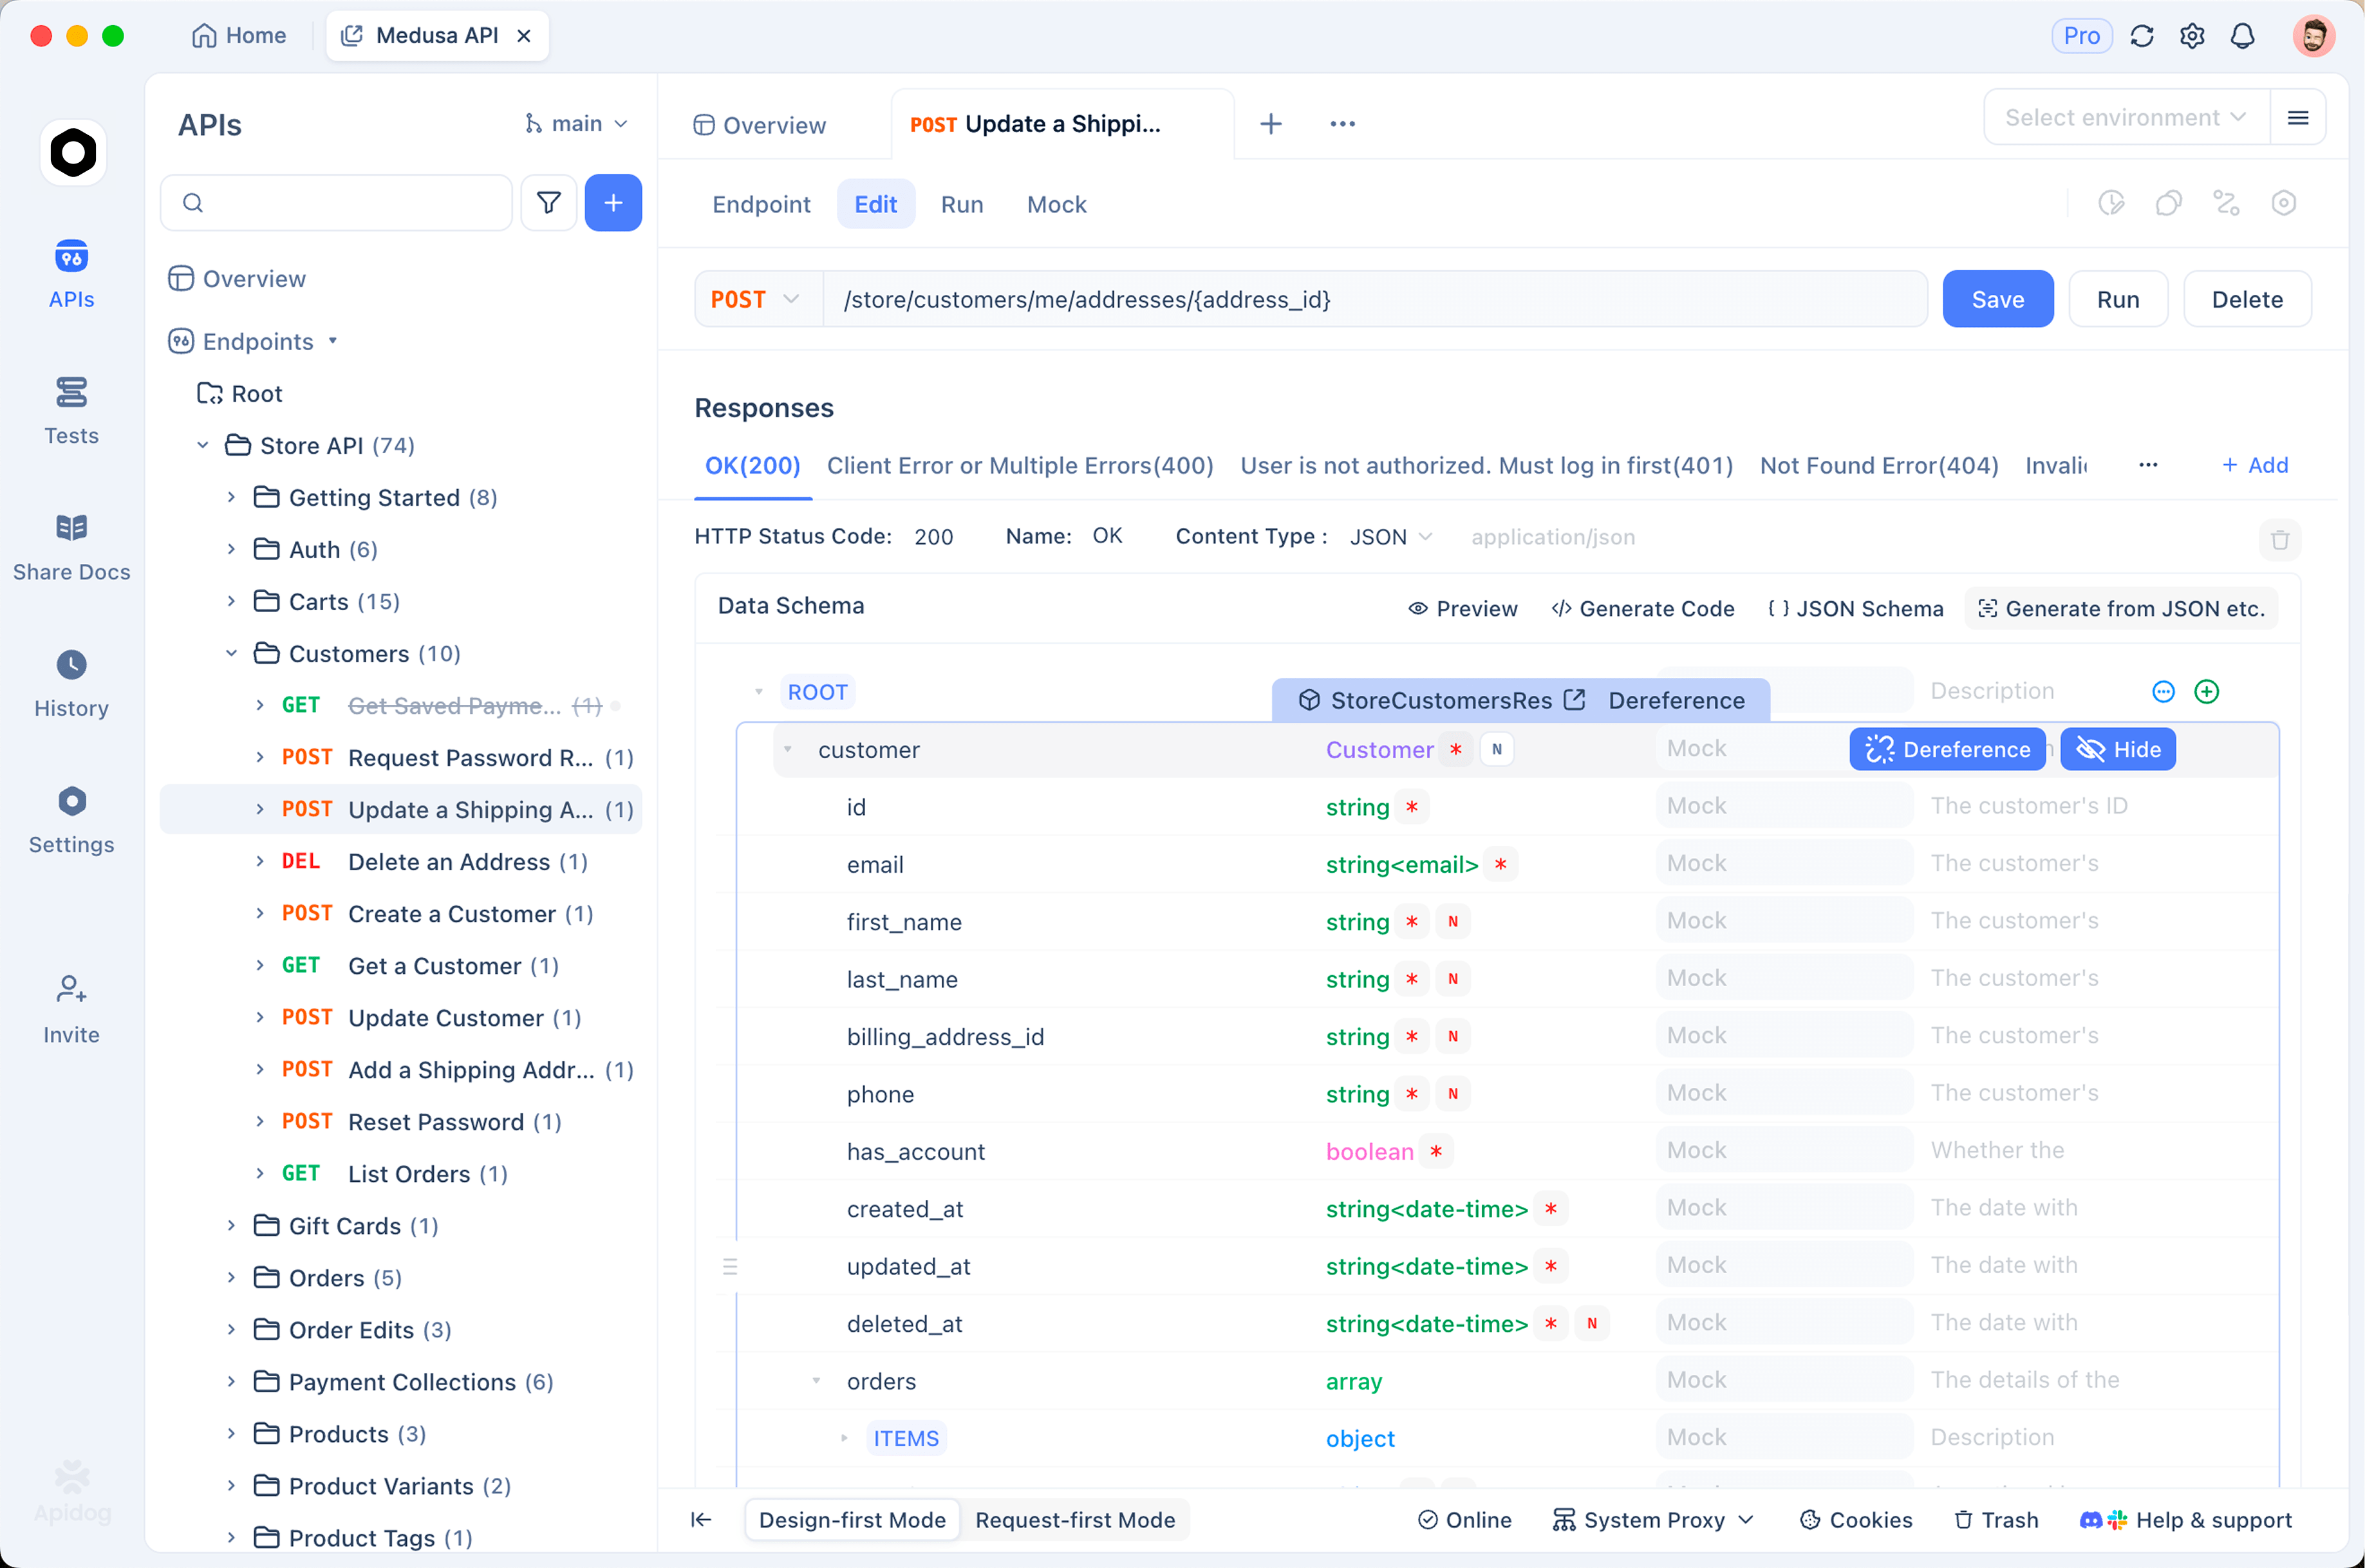
엔드포인트를 가져옵니다. 이전에 사용한 curl 명령어를 Apidog에 붙여넣으면 편집 가능한 요청이 되며, 헤더, 인증, 본문이 자동으로 파싱됩니다.Pro 및 Flash 환경을 설정합니다. base_url과 API 키를 환경 변수로 저장하고, 모델 이름도 변수로 만드십시오. deepseek-v4-pro와 deepseek-v4-flash 간 전환은 한 번의 클릭으로 환경을 변경할 수 있게 하여, '이 프롬프트에서 Pro가 Flash 가격의 3배 가치가 있는가?'라는 질문을 논쟁 대신 실증적인 질문으로 만듭니다.SSE 스트림을 검사합니다. "stream": true로 요청을 보내면 Apidog는 원시 data: 줄의 벽 대신 이벤트 스트림을 라이브 타임라인으로 렌더링하며, 델타를 병합하여 답변보다 먼저 reasoning_content가 도착하는 것을 볼 수 있습니다. 최대 사고(think-max) 호출이 느리다고 느껴질 때, 이 보기는 시간이 어디에 소비되었는지 정확히 보여줍니다.세션을 컬렉션으로 저장합니다. DeepSeek이 다음 스냅샷을 출시할 때, 업그레이드하기 전에 동일한 요청을 다시 실행하고 동작을 비교하십시오. 이는 일반적으로 OpenAI 호환 엔드포인트에 대해 팀이 사용하는 동일한 워크플로입니다.
응답 뷰어는 또한 모든 요청에 대해 usage 블록을 표시하며, 이는 프롬프트 구조를 조정하는 동안 캐시 적중률을 확인하는 가장 빠른 방법입니다.
현재 가격 및 다가올 인상
두 V4 엔드포인트의 현재 정가:
| 모델 | 입력 (미스) | 입력 (캐시 적중) | 출력 |
|---|---|---|---|
deepseek-v4-pro |
$0.435/M | $0.003625/M | $0.87/M |
deepseek-v4-flash |
$0.14/M | $0.28/M |
Pro 가격으로도 서구의 선도 모델보다 훨씬 저렴합니다. 하지만 한 가지 주의할 점이 있습니다: 2026년 8월 6일, GA 출시 6일 전에 DeepSeek은 '상당한' API 가격 인상이 있을 것이라고 경고했습니다. 구체적인 수치나 발효 날짜는 발표되지 않았습니다.
수치를 알 수 없을 때의 실질적인 헤지(대비책):
실제 작업 부하의 usage 데이터를 사용하여 현재 작업당 실제 비용을 측정하여, 발표된 인상분을 추측하는 대신 몇 분 안에 모델링할 수 있도록 하십시오.캐시 적중률을 극대화하십시오. 인상이 비례적으로 적용되더라도 접두사 위주의 아키텍처는 대부분의 이점을 유지합니다.V4 Flash를 라우팅 대체 모델로 유지하십시오. 활성 매개변수 130억 개로 $0.14/$0.28의 가격으로 대량의 간단한 작업을 처리하므로, Pro는 이를 필요로 하는 요청에만 사용될 수 있습니다.
V4 가격 구조 및 공급업체 간 비교에 대한 자세한 내용은 DeepSeek V4 API 가격 가이드를 참조하십시오.
FAQ
기존 OpenAI SDK 코드가 변경 없이 작동할까요?
거의 그렇습니다. base_url을 https://api.deepseek.com으로 변경하고, API 키를 교체하며, model="deepseek-v4-pro"로 설정하십시오. Chat Completions, 스트리밍, 도구 및 구조화된 출력은 OpenAI 형식을 따릅니다. Anthropic SDK를 사용하는 팀은 대신 DeepSeek의 Anthropic Messages 엔드포인트를 사용할 수 있습니다.
V4 Pro 대신 V4 Flash는 언제 사용해야 할까요?
Flash (총 2840억, 활성 130억)는 대량 처리 모델입니다: 분류, 추출, 간단한 채팅, 깊은 추론이 필요 없는 모든 지연 시간에 민감한 작업. Pro는 에이전트 코딩, 긴 컨텍스트 분석 및 사고 모드 작업에서 3배의 출력 가격을 정당화합니다. 충성도가 아닌 작업에 따라 라우팅하십시오.
Cursor에서 V4 Pro 0813을 사용할 수 있나요?
예, Cursor는 사용자 지정 OpenAI 호환 엔드포인트를 허용하므로, GA 빌드를 사용자 지정 모델로 사용할 수 있습니다. 정확한 설정 방법은 Cursor에서 DeepSeek V4 Pro를 사용하는 방법에서 설명합니다.
마무리
GA 모델 출시 첫날은 핵심, 첫 번째 요청, 사고 모드, 스트리밍, 캐시를 고려한 프롬프트 레이아웃과 같은 습관을 기르기에 적절한 시기입니다. V4 Pro는 이전 어떤 모델보다 마지막 습관에 더 큰 보상을 제공하며, 120배 캐시 할인으로 프롬프트 구조가 아키텍처 결정 사항이 됩니다. 위 예시를 연결하고, usage 숫자를 확인하며, Apidog 컬렉션을 저장해두면 다음 스냅샷이나 발표된 가격 변경이 있을 때 동작을 다시 확인할 수 있습니다.