DeepSeek은 2026년 9월 10일, 모델이 API에서 GA(일반 공개)된 날과 같은 날, MIT 라이선스 하에 DeepSeek-V4.1-Flash 가중치를 Hugging Face에 공개했습니다. 이는 이례적인 타이밍입니다. 대부분의 연구소는 호스팅된 엔드포인트를 먼저 출시하고, 가중치는 몇 주 후에, 또는 전혀 공개하지 않는 경우가 많습니다.
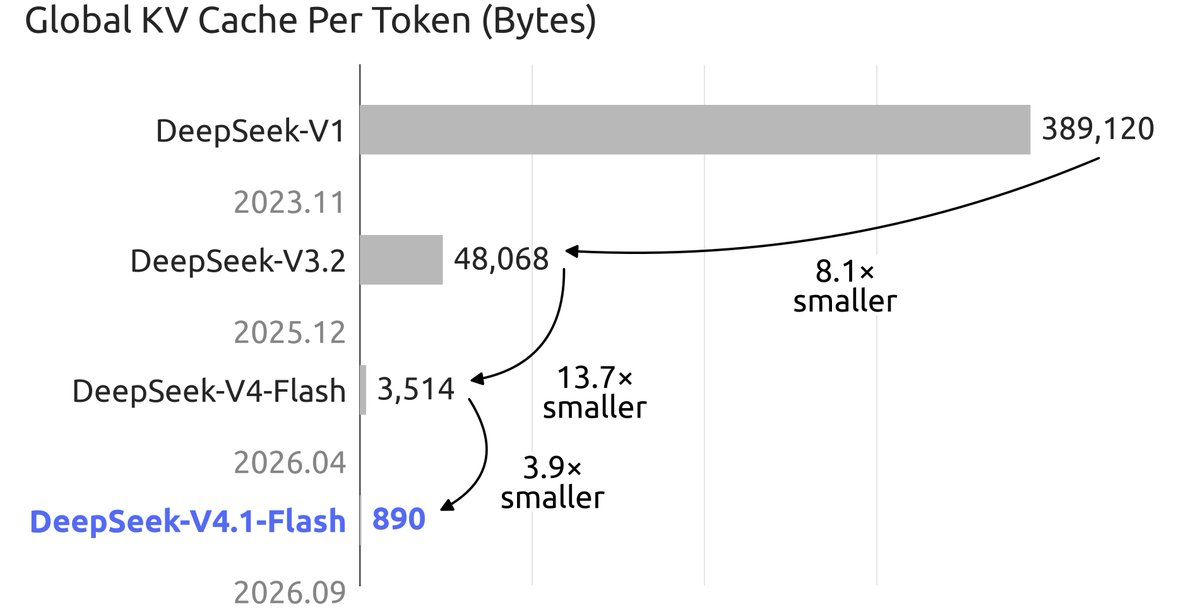
헤드라인 숫자는 대부분의 독자를 겁먹게 할 것입니다: 백본에 5520억 개의 매개변수, 비전 인코더를 포함하면 7630억 개. 하지만 그 내부의 설계는 크기가 시사하는 것보다 자체 호스팅에 더 친화적입니다. 사전 채우기(prefill) 중에는 80억 개의 매개변수만 활성화되고, 디코딩(decode) 중에는 160억 개의 매개변수만 활성화됩니다. 또한, 새로운 FP4 KV 캐시는 토큰당 890바이트를 차지하며, 이는 V4-Flash가 필요했던 것의 약 1/4에 불과합니다. 연산은 저렴하지만, 메모리가 문제입니다.
사람들은 어쨌든 시도할 것입니다. 이 가이드는 메모리 계산, 각 하드웨어 계층별 현실적인 경로, 일반적인 설정 명령, 그리고 Apidog에서 로컬 OpenAI 호환 엔드포인트를 호스팅된 API에 대해 테스트하는 방법을 제공합니다. 모델 개요를 먼저 원하시면 DeepSeek-V4.1-Flash란 무엇인가?를 읽고 돌아오세요.
버튼
요약 (TL;DR)
- 가중치: 5520억 개의 MoE 백본, MIT 라이선스. 8비트의 경우 약 552GB, 4비트의 경우 약 280GB (백본만 해당).
- KV 캐시: 토큰당 890바이트. 100만 토큰의 전체 컨텍스트에는 약 0.9GB가 필요합니다. 이 부분은 해결되었습니다.
- 현실적인 4비트 서빙에는 80GB 클래스의 GPU 4~8개가 필요합니다. 그 미만은 CPU 또는 SSD 오프로드이며 느립니다.
- 호스팅된 API는 비수기 캐시 미스 입력 토큰 100만 개당 $0.15를 청구합니다. 대부분의 팀에게는 전기 요금만으로도 이 비용보다 훨씬 많습니다.
다운로드하는 내용
모델 카드는 5520억 개의 매개변수를 가진 MoE 백본과 새로운 인과 인코더-디코더(Causal Encoder-Decoder) 레이아웃(40개 레이어, 20개 인코더, 20개 디코더로 분할)을 설명합니다. 각 레이어는 384개의 전문가와 1개의 공유 전문가를 통해 라우팅됩니다. DeepSeek-ViT 비전 인코더는 전체 체크포인트를 7630억 개의 매개변수로 늘리며, 텍스트만 필요하더라도 전체를 다운로드해야 합니다.
로컬 추론에 중요한 세 가지 세부 사항:
- 활성 매개변수는 작습니다. 사전 채우기(prefill) 중에는 80억 개, 디코딩(decode) 중에는 160억 개가 활성화됩니다. 토큰당 FLOPs는 중간 크기의 밀집 모델처럼 보입니다. 문제는 5520억 개의 매개변수 각각이 순방향 전달(forward pass)이 도달할 수 있는 어딘가에 존재해야 한다는 것입니다.
- KV 캐시는 FP4입니다. 릴리스 노트에 따르면 캐시는 이전 세대의 HBM(고대역폭 메모리)의 1/4, SSD 저장 공간의 1/8을 사용합니다. 토큰당 890바이트로, 긴 컨텍스트는 더 이상 과거의 메모리 문제가 아닙니다.
- 어텐션은 설계상 희소합니다. 세 가지 정적 모드를 가진 압축 희소 어텐션 2(Compressed Sparse Attention 2)는 64K 컨텍스트에서 훈련되었으며, 45T-토큰 실행의 후반에 1M으로 확장되었습니다. 이것이 1M에서 KV 숫자가 작게 유지되는 이유입니다.
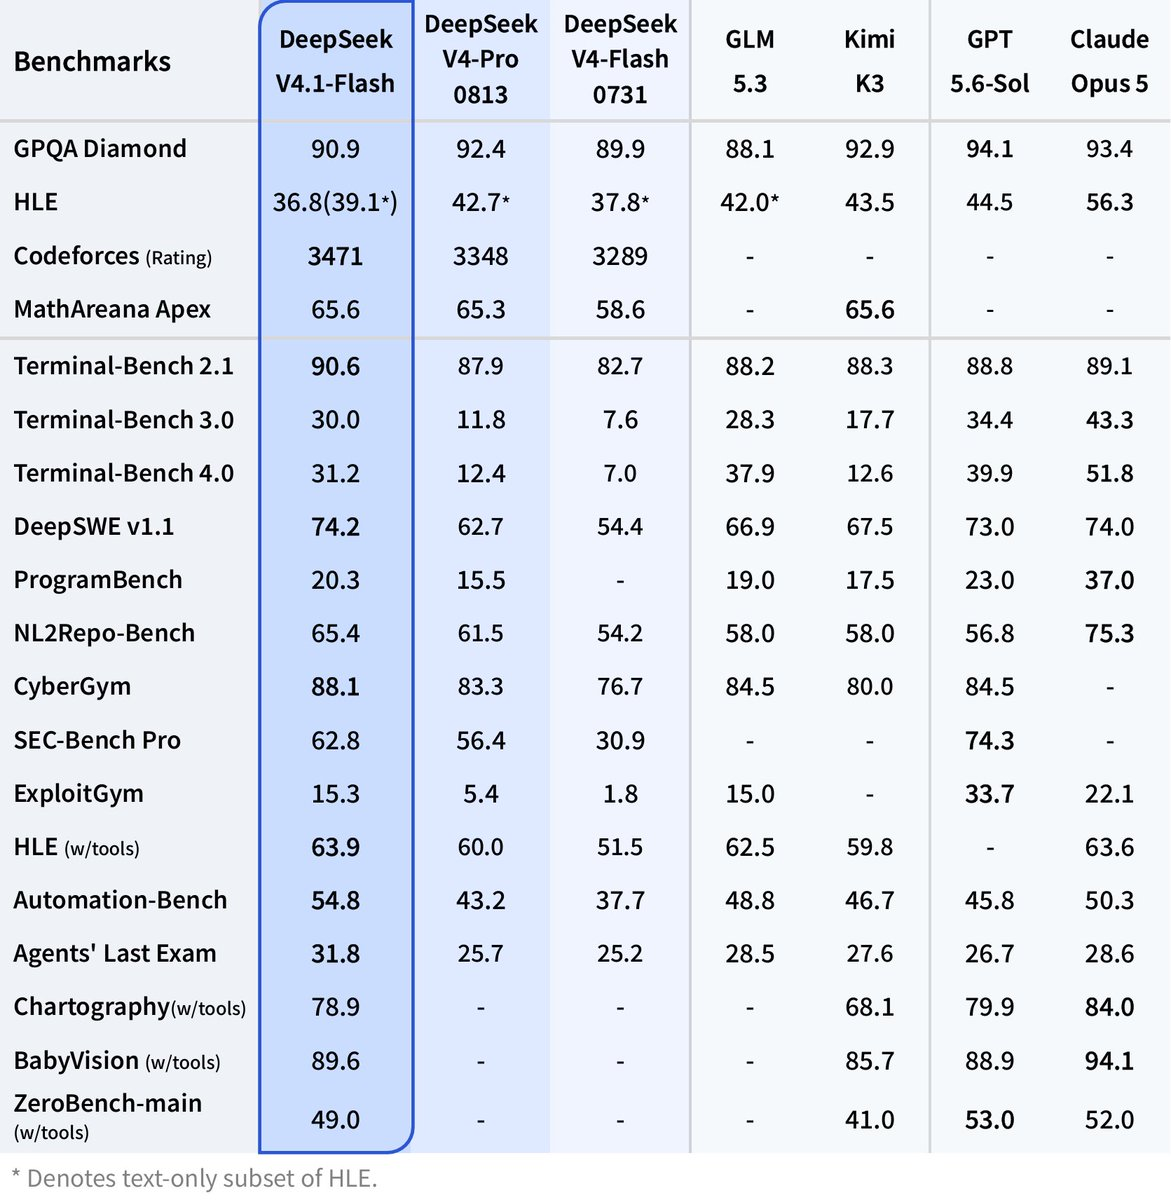
기술 보고서는 아키텍처 전체를 다룹니다. 카드에 있는 모든 벤치마크 수치는 DeepSeek이 보고한 것이므로, 주장으로 취급하십시오.
메모리 계산
아래 숫자는 측정값이 아닌 단순 곱셈이며, 엔진 오버헤드, 활성화 및 비전 인코더는 제외됩니다.
| 구성 요소 | 크기 | 계산 방식 |
|---|---|---|
| 백본 가중치, 8비트 | ~552 GB | 5520억 매개변수 x 1바이트 |
| 백본 가중치, 4비트 | ~280 GB | 5520억 매개변수 x 0.5바이트 |
| KV 캐시, 토큰당 | 890바이트 | 모델 카드에서 가져옴 |
| 128K 컨텍스트에서의 KV 캐시 | ~0.11 GB | 890 x 128,000 |
| 1M 컨텍스트에서의 KV 캐시 | ~0.89 GB | 890 x 1,000,000 |
두 가지 사실이 눈에 뜁니다. 첫째, KV 캐시는 반올림 오차 수준입니다. 1M 토큰 세션은 1기가바이트 미만에 적합하므로, 가중치 예산을 건드리지 않고 수십 개의 긴 세션을 상주시킬 수 있습니다. 둘째, 가중치가 전체 문제입니다. 어떤 양자화 트릭도 5520억 개의 매개변수를 단일 소비자 GPU에 맞출 수 없으며, 80억 개의 활성 매개변수 설계도 도움이 되지 않습니다. MoE 라우팅은 여전히 모든 전문가를 로드하고 주소 지정할 수 있어야 하기 때문입니다.
이것이 또한 오프로드된 설정이 불균형하게 느껴지는 이유입니다. 사전 채우기(Prefill)는 전체 프롬프트를 일괄 처리하고 연산에 바운드(compute-bound)됩니다. 디코딩(Decode)은 모든 토큰에 대해 RAM 또는 SSD에서 160억 개의 활성 매개변수를 페이지 로드합니다. FLOPs가 아니라 대역폭이 초당 토큰 수를 결정합니다.
현실적인 하드웨어 계층
여기에는 처리량 숫자가 없습니다. DeepSeek 외부에서는 아무도 신뢰할 수 있는 벤치마크를 게시할 만큼 가중치를 오래 사용하지 못했습니다.
1단계: 멀티 GPU 서버, 80GB 클래스의 카드 4~8개. 80GB 카드 4개는 320GB를 제공하며, KV 캐시 및 엔진 오버헤드를 위한 약간의 여유를 두고 4비트 가중치에 충분합니다. 카드 8개는 640GB를 제공하며, 8비트 체크포인트 또는 대규모 배치와 함께 편안한 4비트 배포에 충분합니다. 이 계층은 "로컬에서 실행"이 텐서 병렬 처리를 통한 프로덕션 등급 서빙을 의미하는 유일한 계층이며, 5자리 또는 6자리 구매 또는 시간당 수 달러의 클라우드 렌탈 비용이 듭니다.
2단계: CPU 오프로드가 있는 단일 고용량 메모리 워크스테이션. 512GB 이상의 시스템 RAM과 1~2개의 GPU를 갖춘 컴퓨터는 4비트 가중치를 RAM에 보관하고 필요에 따라 전문가 레이어를 GPU로 스트리밍할 수 있습니다. 작동은 하지만 느립니다. 디코딩 대역폭이 HBM 대신 DDR5 버스이기 때문입니다. 대량 작업 및 야간 평가에 사용하고, 대화형 채팅에는 사용하지 마십시오.
3단계: SSD 스트리밍을 사용하는 Apple Silicon. 아마추어의 경로입니다. 512GB Mac Studio는 통합 메모리에 4비트 가중치를 보관하며, 이미 소유하고 있다면 실제 선택지가 될 수 있습니다. 그 미만은 Kimi K3 HN 스레드 영역입니다: 외부 SSD에 분할된 가중치, 무거운 작업을 처리하는 mmap, 대략 초당 1토큰. 모델이 실행된다는 것을 증명할 뿐, 해당 기기에서 유용하다는 것을 의미하지는 않습니다. Kimi K3를 로컬에서 실행하는 가이드는 더 큰 모델에서 동일한 절충안을 다루고, DeepSeek V4를 로컬에서 실행하는 방법은 이전 세대를 다룹니다.
설치 경로
하드웨어가 준비되면, 흐름은 다음과 같습니다: 다운로드, OpenAI 호환 엔드포인트 뒤에서 서빙, 테스트.
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
1Gbps 라인에서는 100GB당 최대 속도로 약 15분이 소요됩니다. 1시간 이상 예산을 잡으세요.
서빙에 주의할 점이 있습니다. vLLM, SGLang, llama.cpp, Ollama에서 CED 아키텍처 및 CSA2 어텐션에 대한 Day-0 지원은 [확인 필요]입니다. 일반적으로 새 레이어 유형은 가중치가 로드되기 전에 엔진 패치가 필요하며, 릴리스 노트에는 특정 엔진 이름이 명시되어 있지 않습니다. 다운로드를 확정하기 전에 각 프로젝트의 변경 로그에서 "DeepSeek-V4.1"을 검색하십시오. 지원이 되면 8개의 GPU를 사용하는 vLLM으로 서빙하는 모습은 다음과 같습니다:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
GGUF 변환이 완료되면 llama.cpp `llama-server` 또는 Ollama 모델은 동일한 `http://localhost:8000/v1` 스타일 엔드포인트를 노출하므로, 한 줄만 변경하여 모든 OpenAI SDK 클라이언트가 작동합니다:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
`temperature=1.0`과 `top_p=0.95` 값은 모델 카드에서 권장하는 설정과 일치합니다. Ollama의 경우, Ollama 가이드는 Modelfile 흐름을 다루며, vLLM 가이드는 멀티 GPU 플래그를 자세히 다룹니다.
실용적인 대안: 호스팅된 API
비수기에 가격 페이지는 `deepseek-flash`를 캐시 미스 입력 토큰 100만 개당 $0.15, 캐시 히트 입력 토큰 100만 개당 $0.003, 출력 토큰 100만 개당 $0.60으로 책정하고 있습니다. 피크 시간대에는 이 가격이 두 배가 됩니다. 따라서 월 10억 개의 입력 토큰과 2억 개의 출력 토큰은 비수기에는 약 $270, 피크 시간대에는 $540가 소요되며, 캐시 히트가 발생하면 입력 측 비용은 더 낮아집니다. 80GB 클래스의 8 GPU 서버는 지속적인 부하 상태에서 하드웨어 감가상각이나 관리 인건비 없이도 전기료와 냉각 비용만으로도 매월 그보다 더 많은 비용이 듭니다. 데이터 상주 규칙이 있거나 이미 유휴 상태인 하드웨어가 있지 않는 한, API가 비용 측면에서 유리합니다. 전환은 `base_url` 한 줄 변경에 불과합니다. DeepSeek-V4.1-Flash API 가이드가 이 과정을 안내합니다.
로컬 배포는 비용이 아닌 제약 조건이 있을 때 유리합니다: 에어갭 환경, 외부로 전송할 수 없는 프롬프트 데이터, 또는 가중치를 수정해야 하는 연구 등입니다.
Apidog에서 호스팅된 API에 대해 로컬 엔드포인트 테스트하기
어떤 경로를 선택하든, 트래픽을 보내기 전에 로컬 서버가 레퍼런스와 동일하게 작동하는지 확인하십시오. 양자화 드리프트, 잘못된 채팅 템플릿, 또는 누락된 중지 토큰 등 미묘한 출력 차이로 나타날 수 있습니다. Apidog의 워크플로우는 다음과 같습니다:
- 두 개의 환경을 생성합니다. 하나는 `base_url`을 `http://localhost:8000/v1`로 설정한 `local`이라는 이름으로, 다른 하나는 `base_url`을 `https://api.deepseek.com`으로 설정하고 실제 키를 넣은 `hosted`라는 이름으로 만듭니다. 모든 요청은 `{{base_url}}/chat/completions`와 `Bearer {{api_key}}`를 사용합니다.
- 작은 프롬프트 세트를 요청으로 저장합니다. JSON 추출, 코드 수정, 장문 요약 등 워크로드를 대표하는 5~10개의 프롬프트입니다. 모든 프롬프트에서 `model`을 `deepseek-flash`로 설정합니다. 두 서버 모두에서 작동합니다.
- 어설션을 추가합니다. JSON 작업의 경우, 응답이 파싱되고 필수 키가 존재하는지 어설션합니다. 모든 요청에 대해 `finish_reason`이 `stop`과 같은지 어설션합니다. 이는 잘못된 컨텍스트 설정으로 인한 잘림을 포착합니다.
- 두 환경 모두에서 세트를 실행합니다. 환경 드롭다운을 `hosted`에서 `local`로 전환하고 동일한 테스트 시나리오를 다시 실행합니다. `local`에서만 나타나는 실패는 양자화 또는 템플릿 문제이며, 한 번의 클릭으로 격리됩니다.
- 스트리밍을 확인합니다. `stream: true`로 설정하고 SSE 보기를 사용하여 이벤트가 하나씩 도착하는지 확인합니다. 전체 응답을 보내기 전에 버퍼링하는 로컬 서버는 비스트리밍 호출에서는 괜찮아 보이지만 여기서는 잘못되었습니다.
- CI에 통합합니다. 모든 엔진 업그레이드 시 `apidog-cli`로 시나리오를 실행하여, 손상된 채팅 템플릿이 사용자 대신 파이프라인을 실패하게 만듭니다.
Apidog를 다운로드하면 전체 흐름이 하나의 프로젝트에서 실행됩니다.
자주 묻는 질문 (FAQ)
DeepSeek-V4.1-Flash를 노트북에서 실행할 수 있나요? 유용하게는 불가능합니다. 4비트 백본은 약 280GB입니다. 노트북은 Kimi K3 실험에서처럼 SSD에서 스트리밍할 수 있지만, 초당 약 1토큰으로 이는 시연이지 작업 흐름이 아닙니다. API를 사용하거나 DeepSeek-V4.1-Flash를 무료로 사용하는 방법의 옵션 중 하나를 사용하십시오.
활성 매개변수가 80억 개라는 것은 VRAM이 8GB만 필요하다는 의미인가요? 아닙니다. 활성 매개변수는 토큰당 연산량을 설정하는 것이지 메모리가 아닙니다. MoE 라우팅은 각 토큰에 대해 레이어당 384개의 전문가 중 하나를 선택할 수 있으므로, 5520억 개의 모든 매개변수가 로드되고 접근 가능해야 합니다.
1M 컨텍스트는 얼마의 메모리를 필요로 하나요? 토큰당 890바이트로 약 0.89GB의 KV 캐시가 필요합니다. 이는 이 모델에서 저렴한 부분입니다. 가중치가 비싼 부분입니다.
라이선스가 상업적 용도로 안전한가요? 네. Hugging Face 모델 카드에 따르면 가중치는 MIT 라이선스입니다.
결론
DeepSeek-V4.1-Flash는 법적, 기술적으로 중요한 방식으로 공개되었습니다: MIT 가중치, 공개 기술 보고서, 그리고 1M 토큰 세션을 메모리 상에서 거의 무료로 만드는 KV 캐시 설계. 그러나 책상 아래 기기에서 실행할 수 있는 방식으로는 공개되지 않았습니다. 대부분의 팀에게는 비수기 시 100만 입력 토큰당 $0.15의 호스팅된 API를 사용하는 것이 올바른 선택이며, 건물 외부로 나갈 수 없는 데이터에 대해서는 로컬 배포를 예약합니다.
어떤 방법을 택하든, 신뢰하기 전에 테스트하십시오. Apidog를 사용하여 두 엔드포인트를 모두 가리키고, 동일하게 저장된 요청을 실행하며, 어설션이 로컬 빌드가 레퍼런스와 일치하는지 알려주도록 하십시오.