
Opus 5.5로 무엇이든 리버스 엔지니어링하려면, REA를 통해 모델을 디스어셈블리 엔진에 연결한 다음 단계적으로 진행하세요. 대상을 분류하고, 지도를 만들고, 호출이 가장 많은 함수를 디컴파일하고, Opus가 이름을 붙이고 설명하게 하고, 동작만 기술한 스펙을 작성하고, 별도의 컨텍스트에서 그 스펙으로 다시 구현합니다. 각 단계에 맞는 effort 레벨을 지정하고, 동등성 테스트로 재구현을 입증하세요.
이것이 X에서 바이럴이 된 가이드의 요약본입니다. 2026년 10월 12일, 빌더 Movez는 Claude Opus 5.5를 이용한 리버스 엔지니어링에 관한 11단계 강좌를 공개했습니다. 이 글은 100만 조회수와 2,800개의 북마크를 기록했습니다. 이 아티클은 그 주장을 출처와 대조해 검증하고, 벤치마크 세부 내용 두 가지를 바로잡으며, 대부분의 가이드가 건너뛰는 단계를 추가합니다. 바로 대상이 통신하는 API를 테스트하는 것입니다.
이 내용은 본인이 소유하거나 분석 권한을 가진 소프트웨어에만 사용하세요. REA의 README는 이 도구를 "합법적인 연구, 교육, 상호운용성, 소프트웨어 보존, 그리고 본인이 소유하거나 분석 권한을 가진 소프트웨어의 분석"으로 제한합니다.
Opus 5.5에 바이너리를 읽어줄 도구가 필요한 이유
Opus 5.5는 텍스트를 읽고 쓰지만, Mach-O나 ELF 파일 자체를 로드할 수는 없습니다. REA는 여러분의 에이전트와 분석 엔진(네이티브 코드라면 Hopper, Ghidra, IDA) 사이에 위치하는 MCP 서버로, 분석을 로컬에서 실행하고 근거와 함께 결과를 반환합니다. 여기에는 주소, 의사코드, 문자열, 호출 지점이 포함됩니다. 모델은 그 결과를 읽고 다음 질문을 던집니다.
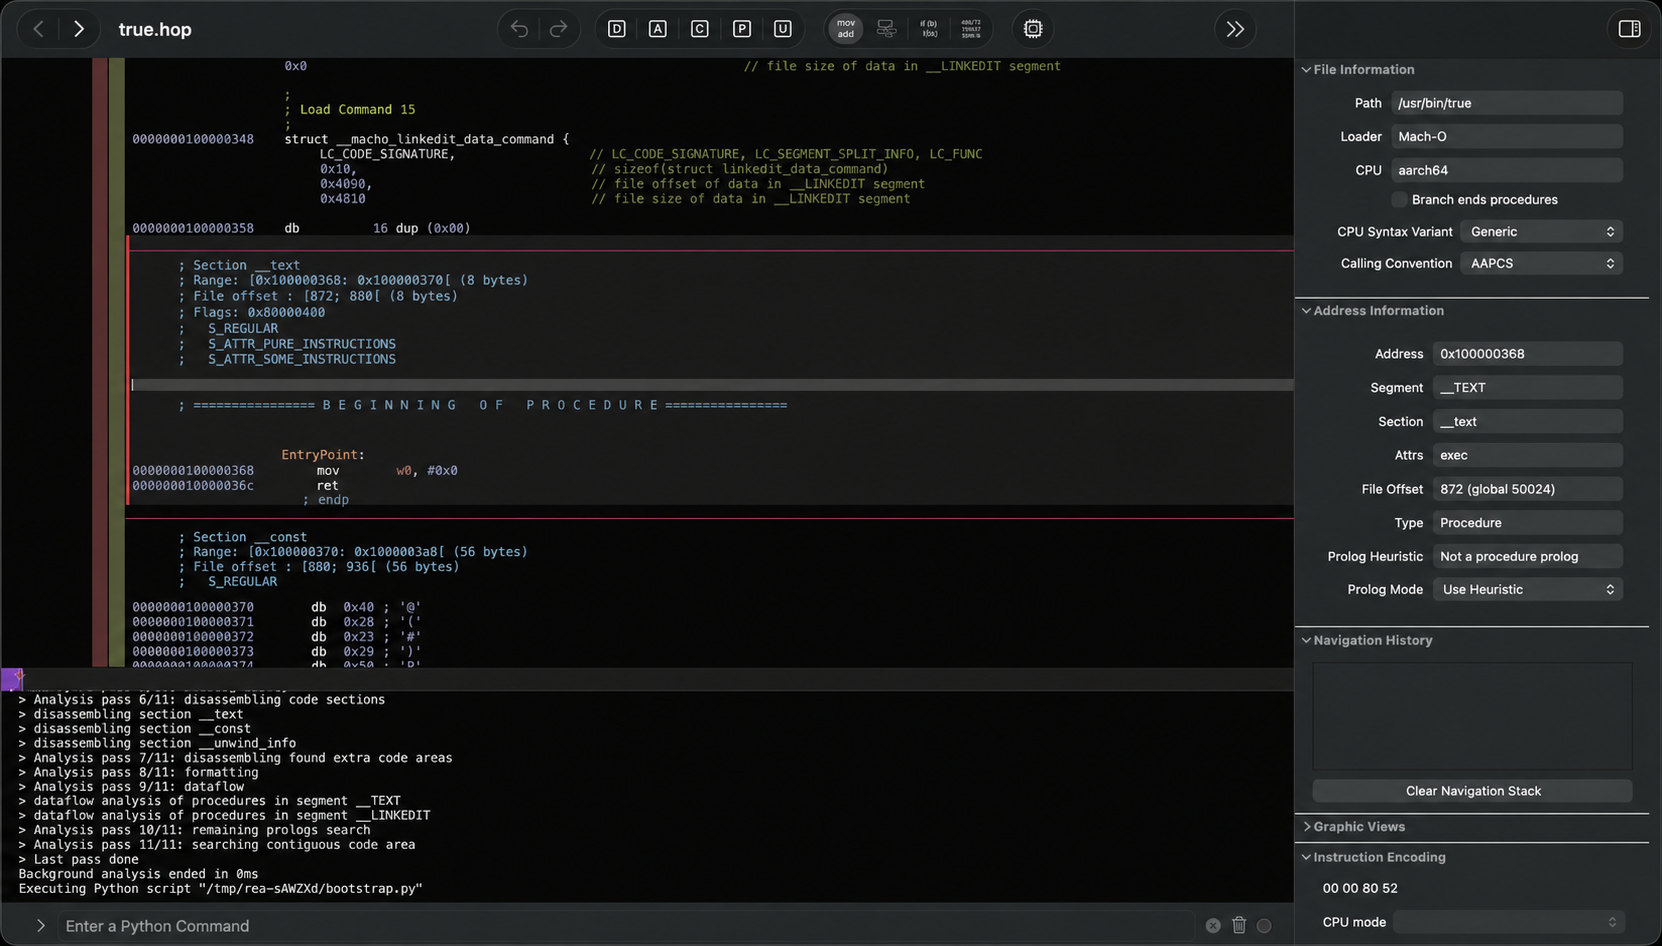
REA는 2026년 10월 27일 GitHub 스타 393,000개를 돌파했으며, 10월 12일의 약 115,000개에서 증가한 수치입니다. 처음 화제가 되었을 때 우리는 REA가 무엇이고 어떻게 동작하는지와 앱 기능 하나를 재구현하는 6단계 루프를 다뤘습니다. 이 가이드는 모델 쪽에 초점을 맞춥니다. 프롬프트, effort 설정, 그리고 한계입니다.
1단계: REA 설치하고 하우스 규칙 작성하기
REA는 22 계열의 Node.js 22.23.4 이상(24.22.1+ 또는 26.12.1+도 동작)과 npm이 필요합니다. 현재 npm 릴리스는 6.8.0입니다. 에이전트에 등록하세요:
npx rea-agents setup
npm install --global rea-agents
rea --help
Setup은 변경될 설정을 미리 보여주고, 건드리는 항목을 백업하며, Claude Code, Codex, Cursor, Gemini CLI, Grok Build를 지원합니다. 네이티브 분석에는 Hopper, Ghidra 또는 IDA가 필요하고, JavaScript, Electron, .NET 검사에는 엔진이 필요 없습니다.
그다음 에이전트에 하우스 규칙을 주세요. 강좌의 CLAUDE.md 블록은 이 스레드에서 가장 뛰어난 부분입니다:
# Reverse-engineering house rules
- Only analyze targets I own or am authorized to examine. State the basis once.
- Tag every claim: observation, inference, or unknown.
- Cite the evidence: address, bytes, pseudocode or call site.
- Start with the smallest overview. Expand only on a concrete gap.
- Separate static facts from runtime facts.
- Build from behavior and public specs, never from copied code or assets.
- Every recovered behavior needs a passing test before "done".
2단계: 단계별로 effort 레벨 선택하기
Opus 5.5는 다섯 가지 effort 레벨을 지원합니다: low, medium, high, xhigh, max. Anthropic의 effort 문서에 따르면 Opus 5.5의 기본값은 medium이며, xhigh는 장시간 에이전트 실행을 겨냥하고 max는 토큰 사용에 대한 모든 제한을 제거합니다. API에서는 output_config.effort로, 또는 에이전트의 effort 설정으로 지정합니다.
강좌의 구분은 합리적인 출발점이지, 측정된 규칙은 아닙니다:
| 단계 | 권장 effort | 이유 |
|---|---|---|
| 라우팅, 정찰, 탐색 | medium |
대부분 도구 호출과 목록화 |
| 일반 함수 주석 달기 | high |
이름을 붙이려면 데이터 흐름 추론이 필요 |
| 장시간 다중 함수 세션 | xhigh |
30분 이상 실행에 적합 |
| 난독화되었거나 포인터가 많은 코드 | max |
가장 깊은 추론, 가장 높은 비용 |
effort는 세션 단위가 아니라 함수 단위로 올리세요.
3단계: 무엇이든 열기 전에 대상 먼저 분류하기
초보자가 가장 흔히 하는 실수는 JavaScript가 그대로 노출된 Electron 앱을 디스어셈블러로 여는 것입니다. REA는 데스크톱 설치본, 네이티브 바이너리, JavaScript 및 Electron 앱, .NET 어셈블리, Android APK, WASM, 웹사이트, 저장된 네트워크 캡처를 다루며, 각각 고유한 진입 도구가 있습니다. 첫 프롬프트는 대상을 식별하는 데에만 집중해야 합니다:
I want to understand how [FEATURE] works in [APP] at [ABSOLUTE PATH].
First tell me what kind of target this is (native, Electron/JS, .NET, APK, WASM)
and which REA tool opens it. Don't start deep analysis yet.
Then give me a one-paragraph map and where you'd look first for [FEATURE].
Keep observations, inferences and unknowns separate.
Electron 대상은 analyze-javascript-application(모듈, 임포트, IPC 경계, 엔진 불필요)로 갑니다. 네이티브 대상은 open_binary로 갑니다.
4단계: 문자열을 매핑하고 교차 참조로 함수 순위 매기기
아직 코드를 읽지 마세요. 네이티브 대상이라면 인벤토리부터 시작합니다:
rea inspect /absolute/path/to/program --provider ghidra --json
rea search /absolute/path/to/program entry --kind procedures --provider ghidra --json
문자열은 가장 빠른 단서입니다. URL, 오류 메시지, 기능 이름 등입니다. 베이스 URL이나 Authorization: Bearer 문자열은 바이너리가 API와 통신한다는 것도 알려주며, 이는 9단계에서 중요합니다.
다음으로 교차 참조(얼마나 많은 곳에서 호출하는지)를 기준으로 함수의 순위를 매기세요. 호출자가 147개인 함수는 설정 로더 같은 핵심 인프라일 가능성이 높고, 호출자가 2개인 함수는 나중에 봐도 됩니다. 위에서부터 아래로 읽으세요.
5단계: 함수 하나를 디컴파일하고 Opus가 이름을 붙이게 하기
핵심 함수 하나를 디컴파일합니다:
rea function /absolute/path/to/program parseConfig --provider ghidra --json
rea decompile /absolute/path/to/program --procedure=parseConfig --provider ghidra --json
출력은 거칠습니다(var_28, 곳곳에 캐스트). 이를 Opus 5.5에 high effort로 넘기고 고정된 체크리스트를 제시하세요:
Here is decompiled pseudocode for a function with 147 cross-references.
1. Rename every variable based on how it is used.
2. State the function's purpose in one sentence.
3. List the data structures it reads and writes.
4. Name the pattern (singleton, factory, state machine, observer).
5. Flag missing error handling, validation or security checks.
Mark anything you're unsure of instead of guessing.
디컴파일러는 세부 사항을 틀립니다. REA의 DX-Ball 쇼케이스에서 첫 의사코드는 입력을 받지 않는 사운드 팬 함수로 나타났습니다. 매개변수는 명령어 뷰에서만 드러났습니다. 최종 C 재구성은 원본 x86 테스트 케이스 3,205개를 통과하고 컴파일된 함수 바이트 63개를 모두 재현합니다. 에이전트가 의사코드를 어셈블리 및 호출자와 교차 검증했기 때문입니다. 시그니처가 이상해 보이면 rea instructions를 요청하세요.
6단계: 난독화된 코드는 예산을 정하고, 갈아 넣지 말기
여기서 바이럴 강좌를 바로잡아야 합니다. 이 강좌는 Elastic Security Labs의 난독화 벤치마크를 "Claude Opus"에 대한 테스트라고 인용합니다. 2026년 4월 21일 발표된 Elastic의 연구는 Opus 5.5가 아니라 Claude Opus 4.6을 테스트했습니다. 수치는 다음과 같습니다:
| Tigress 단계 | 해결 |
|---|---|
| 변환 없음 | 1 / 1 |
| 단일 변환 | 4 / 6 |
| 쌍 변환 | 3 / 6 |
| 고난도, 다중 레이어 | 0 / 6 |
총계로 Opus 4.6은 평가 가능한 대상 20개 중 8개(40%)를 해결했습니다. 성공은 평균 $2.39, 실패는 $4.83이었으므로, 실패 비용이 성공의 약 두 배입니다. 이는 Opus 5.5에 대한 측정값이 아니라 하한선으로 보세요. 5.5에 대해 발표된 동등한 자료는 찾지 못했습니다.
둘째, 강좌는 Caveman이라는 도구가 디컴파일된 불필요한 내용의 "약 75%를 제거"한다고 말합니다. Elastic은 Caveman을 디컴파일된 코드 필터가 아니라, 모델 자체의 장황함을 최대 75% 줄여주는 플러그인으로 설명합니다.
교훈은 여전히 유효합니다. 난독화된 함수당 지출을 제한하고, 1~10 신뢰도 점수를 요구하며, 6 미만인 항목은 주변 함수가 해결될 때까지 보류하세요.
7단계: 큰 대상을 컨트롤러와 워커로 나누기
채팅 하나로 함수 500개를 감당할 수 없습니다. 이름을 잊어버리고 스스로 모순됩니다. 강좌의 해법은 코드를 절대 분석하지 않는 컨트롤러와, 각각 함수 하나를 담당하는 워커입니다:
Controller: The function map is in functions.json (address, name, size, xrefs).
Cluster functions by call-graph proximity, order clusters by xref count,
send each cluster to a worker, inject already-resolved struct names into every
brief, and queue a second pass for any result with confidence below 6.
Report token spend after each cluster.
각 워커는 주소, 목적, 1~10 신뢰도 점수, 사용하거나 발견한 구조체, 그리고 컨트롤러의 구조체 이름을 재사용한 깔끔한 소스를 반환합니다. Elastic의 벤치마크도 동일한 컨트롤러-워커 구조로 실행했습니다.
8단계: 깨끗한 컨텍스트에서 동작만 기술한 스펙 작성하기
클린룸 재구현은 소프트웨어가 하는 일을 복사하는 것이지, 코드를 복사하는 것이 결코 아닙니다. Opus에게 동작만 기술한 스펙을 요청하세요. 공개 인터페이스, 데이터 모델, 각 기능을 테스트 가능한 요구사항으로, 공개 표준에 기반한 파일 형식, 그리고 오류 처리입니다. 주소, 디컴파일된 이름, 복사된 모든 것은 금지하세요.
그런 다음 분석을 전혀 보지 못하는 다른 컨텍스트에서 그 스펙을 구현하세요. 이 분리가 바로 클린룸 경계입니다. 이는 엔지니어링 관행이며 법률 자문이 아닙니다.
9단계: API 계약을 복원하고 Apidog CLI로 테스트하기
4단계의 문자열은 종종 베이스 URL과 인증 헤더를 드러내므로, 동작의 일부는 API 뒤에 존재합니다. 여러분의 재구현은 그 계약까지 지킬 때에만 일치하며, 트래픽이 어셈블리보다 이를 더 빠르게 보여줍니다.
본인이 소유한 테스트 계정에서 HAR을 기록하고, REA가 이를 요약하게 하세요:
rea inspect-web-network-capture /absolute/session.har har --json
그런 다음 에이전트가 Apidog CLI로 그 캡처를 테스트 가능한 계약으로 바꾸게 하세요. 한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
에이전트에게 프롬프트 하나를 주세요:
Import session.har into Apidog project <id>. List the endpoints it created,
remove anything that isn't part of [FEATURE], and write one test case per
endpoint that asserts status code, required fields and response schema.
Run them against the original-service environment, then against my rebuild's
environment, and report every endpoint where the two disagree.
에이전트는 임포트를 실행하고, 작성 전에 페이로드 형태를 확인하고, 두 환경을 모두 실행합니다:
apidog import --project <id> --format har --file ./session.har
apidog endpoint list --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog test-case run --project <id> --endpoint <endpointId> -e <originalEnvId> -r cli,json
apidog test-case run --project <id> --endpoint <endpointId> -e <rebuildEnvId> -r cli,json
같은 케이스, 두 개의 환경, 하나의 diff이며, -r junit으로 모든 커밋마다 재실행할 수 있습니다(Apidog CLI CI/CD 가이드 참고). Claude Code에서 실행하고 싶다면 Claude Code에서의 Apidog CLI를 참고하세요. Apidog의 무료 플랜은 최대 4명의 사용자까지 지원합니다. 수동 방식을 원한다면 API 리버스 엔지니어링을 참고하세요.
10단계: 출시 전에 동등성 입증하기
"일치하는 것 같다"는 증거가 아닙니다. 로컬 동작의 경우, Opus에게 원본과 재구현에 동일한 입력을 넣는 하네스를 만들게 하세요:
Generate 50 inputs: 30 normal, 10 edge (empty, max size, unicode), 10 error
(malformed, missing fields, corrupt). Run each through both programs. Compare
byte-for-byte where possible, semantically otherwise. Report the match rate and
every divergence as cosmetic, behavioral or critical.
9단계의 API 실행과 함께라면, 누구에게든 보여줄 수 있는 두 개의 숫자를 얻게 됩니다. 로컬 일치율과 API 일치율입니다. 마지막이 아니라 만들면서 테스트하세요.
FAQ
Opus 5.5로 하는 리버스 엔지니어링은 합법인가요? 관할 지역, 라이선스, 목적에 따라 다릅니다. REA는 합법적인 연구, 교육, 상호운용성, 보존, 그리고 본인이 소유하거나 분석 권한을 가진 소프트웨어의 분석을 지원합니다. 재구현을 상업적으로 출시하기 전에 법률 자문을 받으세요.
리버스 엔지니어링에는 어떤 effort 레벨을 써야 하나요? 라우팅과 정찰에는 medium, 함수 주석 달기에는 high로 시작하고, max는 함수당 예산을 정한 난독화 코드용으로 아껴 두세요. Opus 5.5의 기본값은 medium입니다.
Claude는 난독화된 바이너리를 얼마나 잘 다루나요? 유일한 공개 벤치마크인 Elastic Security Labs의 자료는 Opus 4.6을 테스트했습니다. Tigress 대상 20개 중 40%를 해결했고, 고난도 다중 레이어는 0%였습니다. Opus 5.5에 대한 동등한 테스트는 발표된 적이 없습니다.
리버스 엔지니어링한 앱이 사용하는 API는 어떻게 테스트하나요? 테스트 계정에서 HAR을 캡처하고, apidog import --format har로 임포트한 다음, Apidog CLI로 테스트 케이스를 만들어 원본 서비스와 재구현 양쪽에 대해 실행하세요.
REA가 제 바이너리를 업로드하나요? REA는 분석을 로컬에서 실행합니다. 에이전트가 모델에 전달하는 결과물(문자열, 의사코드)만 여러분의 모델 제공자에게 도달합니다.