
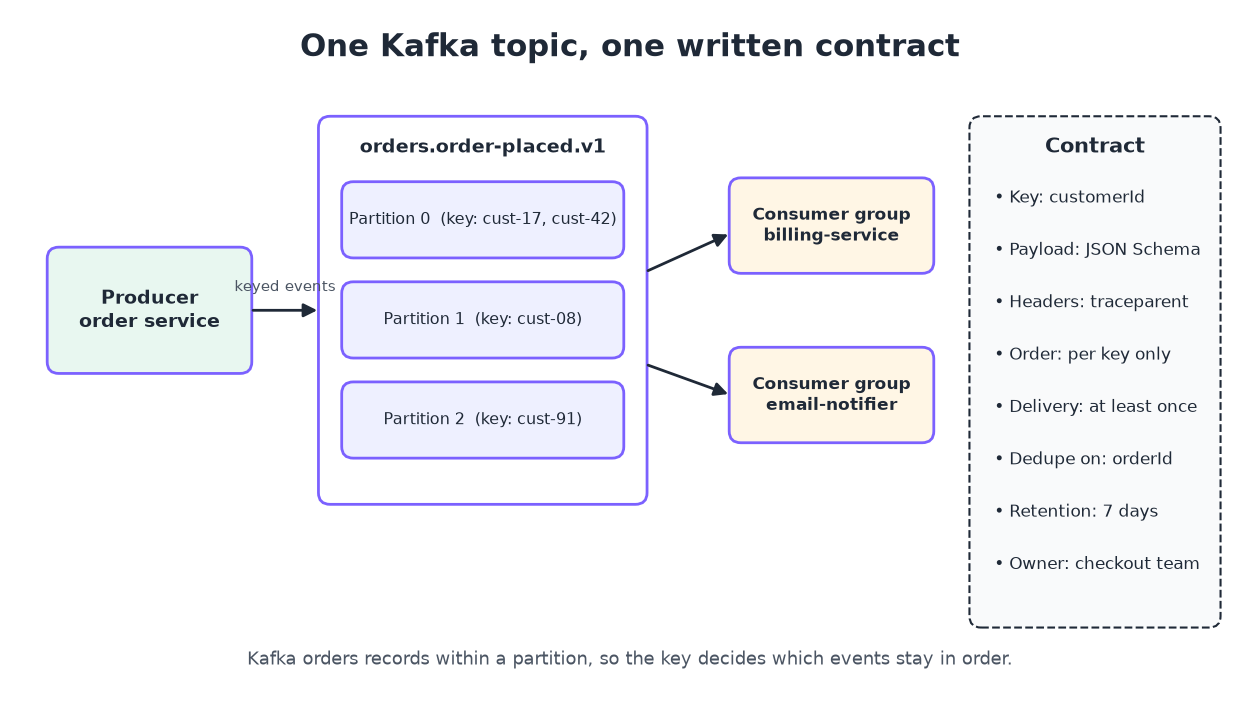
Kafka API를 문서화하려면 토픽마다 계약서(contract)를 작성하세요. 계약서에는 토픽 이름, 이벤트 키, 페이로드 스키마, 헤더, 순서 및 전달 보장, 컨슈머 그룹, 보존 기간, 소유자를 명시해야 합니다. 그런 다음 그 계약서를 HTTP API 문서 옆에 함께 보관하세요. 그러면 프로듀서와 컨슈머가 라이브 클러스터에서 메시지를 역으로 해석하는 대신 하나의 단일 출처(single source of truth)를 참고할 수 있습니다.
이 가이드에서는 계약서의 각 구성 요소, AsyncAPI로 작성하는 방법, 스키마를 안전하게 진화(evolution)시키는 방법, 그리고 Apidog CLI로 코딩 에이전트에게 이 작업을 맡기는 방법을 다룹니다.
이벤트 기반 설계가 처음이라면 이벤트 기반 API 구축 방법과 웹훅 및 이벤트 기반 아키텍처 가이드부터 시작하세요.
Kafka API란 무엇인가?
Kafka API는 서비스들이 Apache Kafka 클러스터를 통해 이벤트를 주고받을 때 사용하는 토픽, 메시지 형식, 전달 규칙의 집합입니다. REST API와 달리 누군가 엔드포인트를 호출하고 응답을 기다리는 방식이 아닙니다. 프로듀서는 토픽에 레코드를 쓰고, 컨슈머는 자신의 속도에 맞춰 읽으며, 계약은 그 레코드들의 구조와 의미 안에 존재합니다.
Kafka 공식 문서는 이를 간단히 설명합니다: “이벤트는 key, value, timestamp, 선택적 메타데이터 헤더를 가진다.” Kafka 자체는 value 내부를 검사하지 않습니다. 프로듀서가 어느 날 JSON을 쓰고 다음 날 다른 형태의 JSON을 써도 브로커는 둘 다 수용합니다. 그렇기 때문에 Kafka API는 HTTP API보다 더욱 명시적인 계약서를 필요로 합니다: 전송 계층에서는 breaking change를 막을 방법이 없기 때문입니다.
문서화되지 않은 토픽은 예측 가능한 방식으로 문제를 일으킵니다. 컨슈머가 샘플 하나로 필드 타입을 추측하다가 null에서 크래시가 나거나, 새 서비스가 자신이 각 메시지를 최소 한 번(at least once) 받게 된다는 사실을 몰라 재시도 시 중복 청구를 하는 식입니다.
Kafka 토픽별로 문서화해야 할 사항
모든 토픽에는 동일한 핵심 정보가 필요합니다. 아래 표를 체크리스트로 활용하세요:
| 계약 필드 | 기록할 내용 | 예시 |
|---|---|---|
| 토픽 이름 | 전체 이름과 네이밍 컨벤션 | orders.order-placed.v1 |
| 목적 | 이벤트의 의미를 설명하는 한 문장 | “주문이 결제를 통과하여 배송 준비가 완료됨” |
| 이벤트 키 | 어떤 필드가 키인지, 그 이유 | customerId — 한 고객의 주문들이 순서를 유지하도록 |
| 페이로드 스키마 | 모든 필드, 타입, 필수 여부, 형식 | JSON Schema, Avro 또는 Protobuf |
| 헤더 | 각 헤더의 이름, 타입, 의미 | traceparent, schema-version |
| 파티션과 순서 | 파티션 수와 순서 보장 범위 | 12개 파티션, customerId 단위로 순서 보장 |
| 전달 방식 | at least once, idempotent producer, 트랜잭션 | At least once; 컨슈머는 orderId로 중복 제거해야 함 |
| 컨슈머 그룹 | 알려진 그룹과 각 그룹의 역할 | billing-service, email-notifier |
| 보존 기간 | 레코드가 읽을 수 있는 상태로 유지되는 기간 | 7일 |
| 소유권 | 소유 팀, 연락처, 버전 정책 | Checkout 팀, #checkout-events |
이 중 순서와 전달 방식 항목이 가장 중요합니다. 샘플 메시지만으로는 이를 추론할 수 없기 때문입니다.
6단계로 Kafka API 문서화하기
- 모든 토픽과 소유자를 목록화합니다. 클러스터에서 토픽 목록을 가져와 각 토픽에 누가 프로듀싱하는지 표시합니다.
- 키를 정의합니다. 어떤 필드가 키인지, 그것이 순서에 어떤 의미를 갖는지 기록합니다.
- 페이로드 스키마를 작성합니다. JSON Schema, Avro 또는 Protobuf로 모든 필드를 기술합니다.
- 헤더와 메타데이터를 설명합니다. 트레이싱, 스키마 버전, 콘텐츠 타입 헤더를 포함합니다.
- 보장 사항을 명시합니다. 전달 방식, 순서 보장 범위, 보존 기간, 컨슈머 그룹을 문서화합니다.
- 사람들이 찾는 곳에 게시합니다. 계약서를 HTTP API 문서 옆에 두고 코드처럼 버전 관리합니다.
1~2단계: 토픽과 키
<domain>.<event>.<version> 같은 네이밍 패턴은 읽는 사람에게 토픽의 소유자와 버전을 알려줍니다. 그다음 키를 문서화하세요. 키가 파티션을 결정하기 때문입니다. Kafka 공식 문서는 “동일한 이벤트 키(예: 고객 또는 차량 ID)를 가진 이벤트는 동일한 파티션에 기록된다”고 명시하며, 컨슈머는 파티션의 이벤트를 “기록된 순서와 정확히 동일한 순서로” 읽는다고 설명합니다.
따라서 계약서에는 “순서 보장”이 아니라 “customerId 단위로 순서 보장”이라고 명시해야 합니다. Kafka는 파티션 내부의 순서만 보장하며, 토픽 전체의 순서는 절대 보장하지 않습니다.
3단계: 페이로드 스키마
페이로드는 컨슈머가 코드를 작성하는 대상이므로 필드별로 상세히 기술해야 합니다. 다음은 order-placed 이벤트의 JSON Schema입니다:
{
  "type": "object",
  "required": ["orderId", "customerId", "totalCents", "currency", "placedAt"],
  "properties": {
    "orderId": { "type": "string", "description": "Unique order ID; use it to deduplicate" },
    "customerId": { "type": "string", "description": "Also the record key" },
    "totalCents": { "type": "integer", "minimum": 0 },
    "currency": { "type": "string", "enum": ["USD", "EUR", "GBP"] },
    "placedAt": { "type": "string", "format": "date-time" },
    "couponCode": { "type": ["string", "null"] }
  }
}
“중복 제거에 사용하세요(use it to deduplicate)”라는 description은 컨슈머에게 필드의 타입뿐 아니라 활용 방법까지 알려줍니다. 이 형식이 처음이라면 JSON Schema란 무엇인가 문서를 참고하세요.
4~5단계: 헤더와 보장 사항
각 헤더(트레이싱 컨텍스트, 스키마 버전, 콘텐츠 타입)를 나열하고 컨슈머가 이에 의존할 수 있는지 명시하세요. 그다음 전달 보장을 Kafka 자체 용어로 기록합니다. Kafka 설계 문서에 따르면 “Kafka는 기본적으로 at-least-once 전달을 보장하며”, 이는 메시지가 “절대 손실되지 않지만 재전송될 수 있다”는 의미입니다. 프로듀서가 idempotent 옵션이나 트랜잭션을 사용한다면 그 사실을 명시하세요. 사용하지 않는다면 컨슈머에게 중복 제거를 지시하고, 어떤 필드로 중복 제거할지 명시하세요.
컨슈머 그룹도 문서화하세요. 각 구독 그룹 내에서 파티션은 한 번에 “정확히 하나의 컨슈머에 의해 소비됩니다.” 이를 통해 그룹이 확장될 수 있는 범위를 알 수 있습니다: 파티션당 활성 컨슈머 하나.
AsyncAPI로 계약서 작성하기
도구는 기계가 읽을 수 있는 형식이 필요하며, Kafka에서는 보통 AsyncAPI, 즉 “메시지 기반 API를 기계가 읽을 수 있는 형식으로 기술하기 위한” 명세를 사용합니다. AsyncAPI는 REST에서의 OpenAPI와 같은 역할을 합니다.
AsyncAPI 3.0 문서는 info, servers, channels, operations, components로 구성됩니다. 채널은 address를 통해 토픽에 매핑되며, 각 operation은 send 또는 receive 중 하나의 action을 가집니다:
asyncapi: 3.0.0
info:
  title: Orders events
  version: 1.0.0
channels:
  orderPlaced:
    address: orders.order-placed.v1
    messages:
      orderPlaced:
        $ref: '#/components/messages/orderPlaced'
operations:
  publishOrderPlaced:
    action: send
    channel:
      $ref: '#/channels/orderPlaced'
components:
  messages:
    orderPlaced:
      payload:
        $ref: './schemas/order-placed.json'
AsyncAPI에는 서버, 채널, operation, 메시지 수준의 Kafka 바인딩도 있습니다. 바인딩은 일반 필드로 표현할 수 없는 Kafka 고유의 세부 사항을 담는 곳입니다. 명세는 프로듀서의 저장소에 두세요. 그러면 이벤트를 변경하는 pull request가 그 계약서도 함께 변경하게 됩니다.
Kafka 스키마 진화: 호환성 규칙을 문서화하기
스키마는 반드시 변경됩니다. 계약서는 어떤 변경이 안전한지 명시해야 합니다. 스키마 레지스트리를 사용한다면 호환성 모드를 문서화하세요. Confluent의 스키마 진화 문서에 아래 모드들이 나열되어 있으며, “Confluent Schema Registry의 기본 호환성 유형은 BACKWARD”라고 명시되어 있습니다:
| 모드 | 누가 무엇을 읽을 수 있는가 |
|---|---|
| BACKWARD | 새 스키마의 컨슈머가 이전 스키마로 기록된 데이터를 읽을 수 있음 |
| BACKWARD_TRANSITIVE | 새 스키마의 컨슈머가 모든 이전 스키마로 기록된 데이터를 읽을 수 있음 |
| FORWARD | 이전 스키마의 컨슈머가 새 스키마로 기록된 데이터를 읽을 수 있음 |
| FORWARD_TRANSITIVE | 모든 이전 스키마의 컨슈머가 새 스키마로 기록된 데이터를 읽을 수 있음 |
| FULL | 이전 스키마에 대해 이전 방향과 이후 방향 모두 호환 |
| FULL_TRANSITIVE | 모든 이전 스키마에 대해 이전 방향과 이후 방향 모두 호환 |
| NONE | 호환성 검사가 비활성화됨 |
실제로 BACKWARD 모드에서는 선택적 필드를 추가하거나 기본값이 있던 필드를 제거할 수 있습니다. 필수 필드의 이름 변경이나 타입 변경은 컨슈머를 깨뜨립니다. breaking change가 필요하다면 새 토픽 버전(orders.order-placed.v2)을 게시하고, 두 버전 모두를 문서화한 뒤, 이전 버전의 폐기 일정을 정하세요.
코딩 에이전트가 Apidog CLI로 Kafka API를 문서화하게 하기
손으로 작성한 계약서는 누군가 프로듀서를 변경하는 순간 어긋나기 시작합니다. 코딩 에이전트는 프로듀서 코드를 읽고, 스키마를 작성하고, 문서를 동기화 상태로 유지하며, 여러분은 검토만 하면 됩니다. Apidog CLI는 Claude Code, Codex, Cursor 등 모든 터미널 에이전트에게 Apidog 프로젝트에서 이 작업을 수행할 명령어를 제공합니다.
CLI를 설치하고 로그인한 뒤 Apidog 스킬을 추가하여 에이전트가 명령어를 알도록 하세요:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
설정 과정을 에이전트에게 맡길 수도 있습니다. Apidog CLI 설치 가이드를 읽고 스스로 설정하라고 지시하면 됩니다.
그다음 에이전트에게 다음 프롬프트를 하나 전달하세요:
Read the Kafka producers in ./services/orders. For every topic they write to,
create an Apidog data schema in project <projectId> for the message payload,
then create one Markdown doc per topic with the key, headers, ordering,
delivery guarantee, consumer groups, retention and owner. Validate every
payload before you write it.
에이전트는 페이로드 구조를 확인하고 파일을 검증한 뒤, 스키마와 계약 문서를 작성합니다:
apidog cli-schema get schema-create
apidog cli-schema validate schema-create --file order-placed.schema.json
apidog schema create --project <projectId> --file order-placed.schema.json
apidog cli-schema get doc-create
apidog doc create --project <projectId> --file order-placed.doc.json
apidog schema list --project <projectId>
apidog schema create는 페이로드를 재사용 가능한 데이터 스키마로 저장합니다. HTTP 엔드포인트도 동일한 모델을 참조할 수 있으므로 한 번 정의한 Order가 REST 응답과 Kafka 이벤트 양쪽 모두를 커버합니다. apidog doc create는 프로젝트 트리에 Markdown 문서를 작성하며, 이 문서가 위 표의 토픽 계약을 담게 됩니다. 프로듀서가 변경되면 프롬프트를 다시 실행하면 되고, 에이전트는 apidog schema update를 사용합니다. 에이전트 기반 문서화 작업에 대한 더 자세한 안내는 CLI에서 API 문서화하기와 Claude Code에서 Apidog CLI 사용하기를 참고하세요.
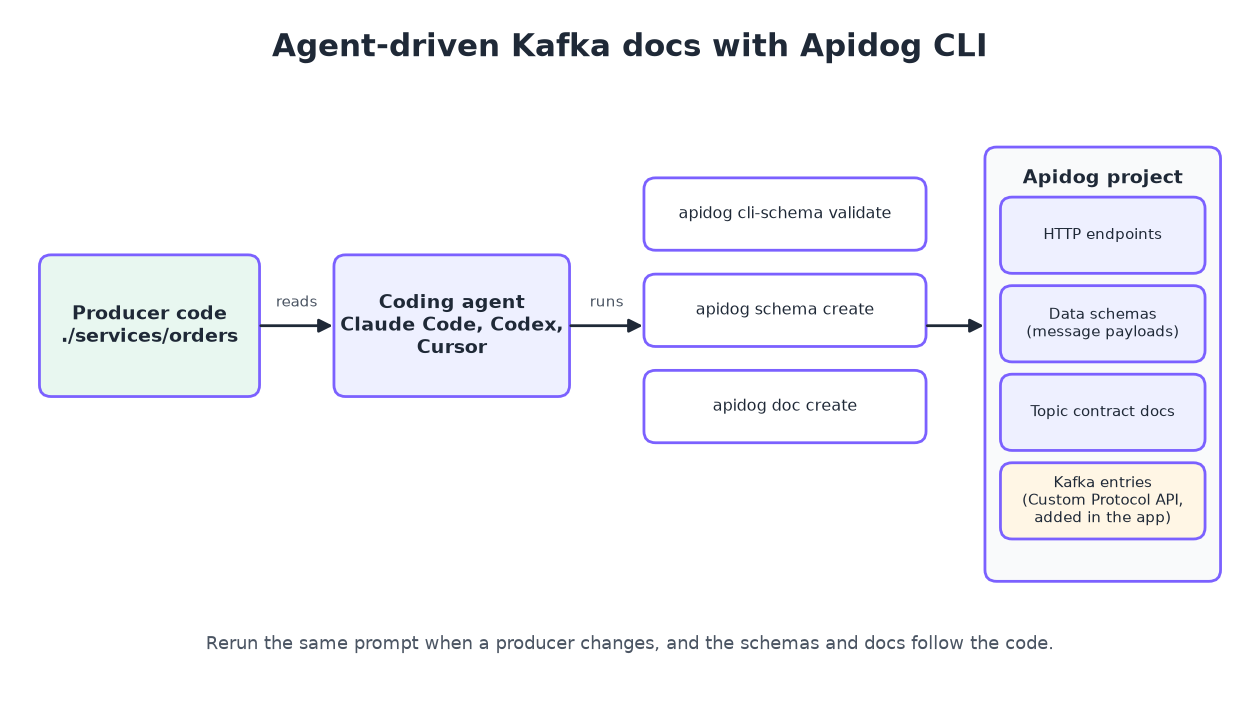
한 단계만 앱에서 진행합니다. Apidog의 Custom Protocol API는 Kafka 엔드포인트를 HTTP 엔드포인트와 함께 문서화합니다: New Other Protocol APIs를 선택하고, Other Custom Protocol API를 클릭한 뒤, 프로토콜로 Kafka를 고르고, URI(토픽), 이름, 상태, 유지보수 담당자, 태그, 설명을 입력하세요. 이 항목들은 HTTP 문서와 동일한 폴더 트리, 검색, Quick Share를 공유합니다. 현재 CLI에는 커스텀 프로토콜 엔드포인트용 명령어가 없으므로, 이 부분만 직접 생성해야 합니다.
Apidog Free는 최대 4명까지 지원하므로 소규모 팀은 비용 없이 REST와 Kafka 문서를 한 프로젝트에서 관리할 수 있습니다.
FAQ
Kafka용 OpenAPI가 있나요?
AsyncAPI가 그 역할을 수행합니다. 서버, 채널(토픽), operation, 메시지 페이로드를 YAML 또는 JSON으로 기술하며, Kafka 전용 바인딩을 제공합니다.
Kafka API 문서화에 스키마 레지스트리가 필요한가요?
필수는 아니지만 있으면 도움이 됩니다. 문서는 규칙을 명시하고, 레지스트리는 쓰기 시점에 그 규칙을 강제합니다. 레지스트리를 운영한다면 호환성 모드를 문서화하세요.
Kafka 토픽 문서화와 REST 엔드포인트 문서화의 차이는 무엇인가요?
REST 문서는 요청과 응답을 기술합니다. Kafka 문서는 여러 컨슈머가 나중에 읽는 하나의 메시지를 기술하므로, 키, 순서 보장 범위, 전달 보장, 보존 기간, 컨슈머 그룹까지 필요합니다. 이 항목들은 일반적인 REST 문서에는 없는 것들입니다.
Apidog로 Kafka 메시지를 테스트할 수 있나요?
Apidog는 Custom Protocol API를 통해 Kafka 엔드포인트를 문서화하지만, Kafka 메시지를 직접 전송하거나 소비하지는 않습니다. 계약서와 페이로드 스키마를 보관하는 데 활용하고, 프로듀서와 컨슈머 코드는 Kafka 클라이언트 라이브러리로 테스트하세요.
Kafka 문서는 얼마나 자주 업데이트해야 하나요?
프로듀서가 메시지를 변경할 때마다입니다. 코드 리뷰와 연결하세요. 이벤트를 변경하는 pull request가 계약서를 함께 업데이트하거나, 에이전트가 Apidog CLI로 계약서를 재생성하도록 하면 됩니다.