
Groq는 모든 계정에 OpenAI 호환 엔드포인트용 Free Plan 키를 제공하며, 이 키는 가입하는 즉시 작동합니다. 사람들이 걸려 넘어지는 부분은 접근 권한을 얻는 것이 아니라, 앱이 실제로 모델을 호출한 뒤 한도 안에 머무는 것입니다. Groq는 문서에 모델별 Free Plan 수치를 공개하지만, 그 숫자는 바뀌고 여러분의 계정은 다를 수 있습니다. 신뢰할 수 있는 습관은 계정 설정을 확인한 다음, 세션 중간에도 한도가 바뀔 수 있으므로 모든 호출에서 응답 헤더를 읽는 것입니다.
이 가이드는 키를 발급받고, 표준 OpenAI 클라이언트를 Groq의 엔드포인트로 향하게 하며, 대부분의 “무료 티어” 글이 건너뛰는 부분, 즉 프로덕션에서 429를 보고 한도를 알게 되는 대신 실시간으로 한도를 지켜보는 방법을 다룹니다. 그런 다음 코딩 에이전트가 그 확인을 Apidog CLI 테스트로 바꿔 주므로, 잊어버리는 일회성 curl 명령이 아니라 반복 가능한 테스트가 됩니다.
요약
Groq는 Free Plan과 Developer Plan 두 가지 티어를 운영합니다. 요청, 토큰 또는 일일 총량 중 먼저 도달하는 한도에 걸리며, 속도 제한은 조직 수준(사용자별 아님)에 적용되고, 캐시된 토큰은 한도에 포함되지 않습니다. Groq는 모델별 Free Plan 수치를 공개하지만, 여러분의 계정에 적용되는 숫자는 콘솔의 한도 페이지에 있으므로, 예고 없이 바뀔 수 있는 표를 믿기보다 모든 호출에서 x-ratelimit-* 응답 헤더에서 읽는 것이 신뢰할 수 있는 방법입니다.
키를 받고 엔드포인트 호출하기
console.groq.com에서 계정을 만들고 키 페이지에서 키를 생성하세요. Groq는 그 키를 OpenAI 호환 API로 노출하므로, 전에 OpenAI SDK를 호출해 봤다면 형태를 이미 알고 있을 것입니다. base URL을 OpenAI 대신 Groq로 지정하고 나머지는 그대로 유지하세요:
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instant",
    "messages": [{"role": "user", "content": "Summarize this ticket in one sentence."}]
  }'
또는 공식 Python OpenAI 클라이언트를 사용할 경우:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GROQ_API_KEY"],
    base_url="https://api.groq.com/openai/v1",
)

response = client.chat.completions.create(
    model="llama-3.3-70b-versatile",
    messages=[{"role": "user", "content": "List three causes of API timeout errors."}],
)

print(response.choices[0].message.content)
Groq의 OpenAI 호환성 문서에는 기존 코드를 그대로 옮기기 전에 알아 둘 몇 가지 차이가 있습니다. logprobs, logit_bias, top_logprobs, messages[].name은 모두 400 오류를 반환하고, n을 설정한다면 1이어야 하며, temperature 0은 진정한 그리디 디코딩 대신 아주 작은 양의 부동소수점으로 변환됩니다.
Free Plan 대 Developer Plan
Groq의 표현은 직설적입니다. “더 높은 한도, Batch 및 Flex 처리 등에 접근하려면 Developer 플랜으로 업그레이드하세요.” Free Plan은 모든 새 키가 시작하는 플랜이며, 테스트와 작은 사이드 프로젝트에 실제로 사용할 수 있습니다.
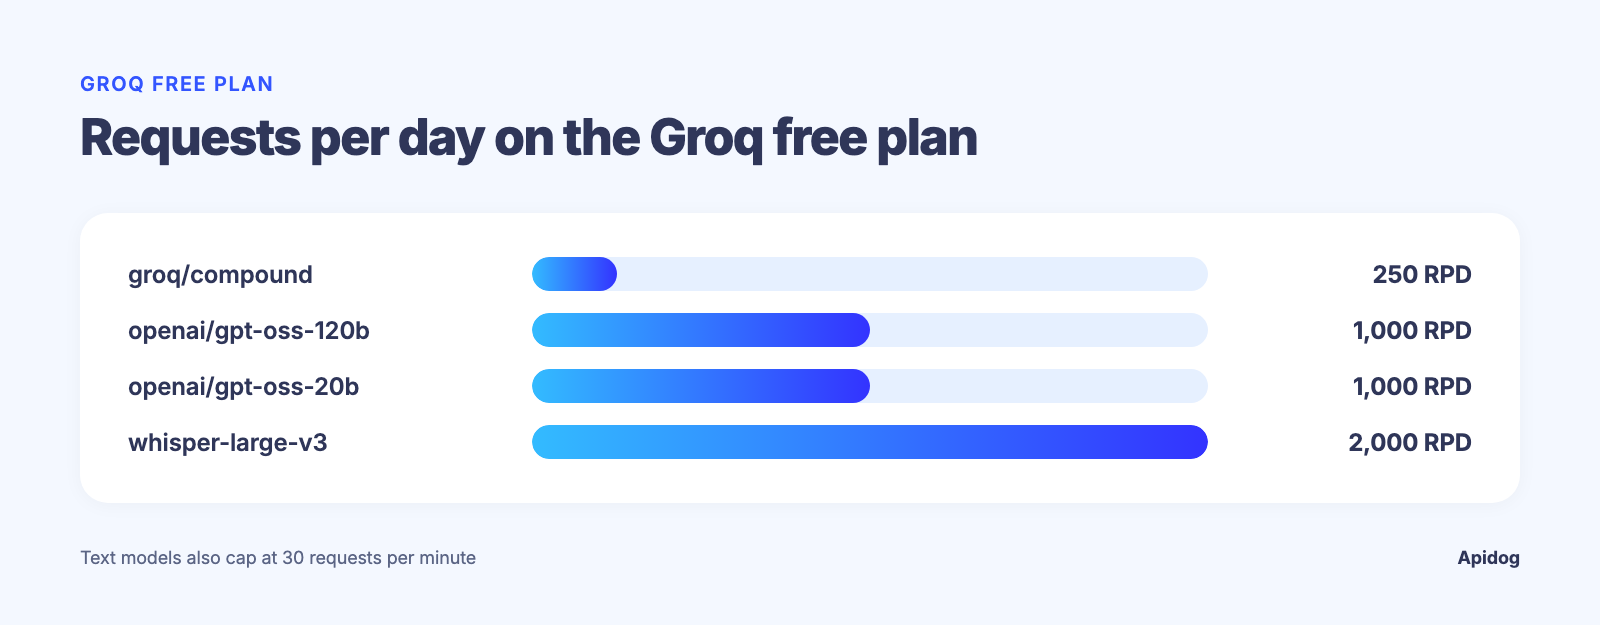
다음은 2026-09-15에 확인한 Groq의 속도 제한 문서에 따른, 몇몇 모델에 대해 Free Plan이 허용하는 내용입니다:
| 모델 | RPM | RPD | TPM | TPD | 오디오 |
|---|---|---|---|---|---|
groq/compound |
30 | 250 | 70K | - | - |
openai/gpt-oss-120b |
30 | 1K | 8K | 200K | - |
openai/gpt-oss-20b |
30 | 1K | 8K | 200K | - |
whisper-large-v3 |
20 | 2K | - | - | 7.2K ASH / 28.8K ASD |
같은 페이지에는 모든 모델에 대해 더 높은 상한과 Batch 및 Flex 처리를 제공하는 Developer Plan 탭이 있습니다. Groq가 예고 없이 이 숫자들을 바꿀 수 있으므로 위 표는 스냅샷으로 취급하세요. 여러분의 실제 수치는 계정 설정의 한도 페이지에 있으므로, 서로 다르다면 이 글보다 그 페이지를 믿으세요.
원시 숫자보다 더 중요한 두 가지 정책 세부 사항이 있습니다. 속도 제한은 “개별 사용자가 아니라 조직 수준”에 적용되므로, 하나의 Groq 조직을 공유하는 다섯 명은 다섯 개의 별도 한도가 아니라 하나의 한도를 공유합니다. 그리고 “캐시된 토큰은 속도 제한에 포함되지 않습니다.” 즉, 캐시를 잘 활용한 프롬프트 구조는 표시된 숫자가 시사하는 것보다 더 많은 실제 처리량을 확보해 줍니다.
한도에 부딪히기 전에 알아 둘 가치가 있는 모델
중요한 한도는 어떤 모델을 호출하느냐에 따라 달라집니다. Groq의 텍스트 모델과 Compound 시스템은 131,072토큰 컨텍스트로 실행됩니다:
| 모델 ID | 유형 |
|---|---|
llama-3.1-8b-instant |
빠른 범용 텍스트 |
llama-3.3-70b-versatile |
더 큰 범용 텍스트 |
openai/gpt-oss-120b |
오픈 웨이트 추론 모델 |
openai/gpt-oss-20b |
더 작은 오픈 웨이트 추론 모델 |
groq/compound |
에이전트 시스템 |
groq/compound-mini |
더 가벼운 에이전트 시스템 |
Whisper 모델인 whisper-large-v3와 whisper-large-v3-turbo는 이 표에 해당하지 않습니다. 이들은 오디오 전사 모델이며, Groq는 이들의 처리량을 토큰이 아니라 자체 RPM 및 RPD 상한과 함께 시간당 및 일당 오디오 초(ASH/ASD)로 측정합니다.
각 모델은 자체 RPM, RPD, 토큰 상한을 가지므로 llama-3.1-8b-instant의 한도가 openai/gpt-oss-120b에도 적용된다고 가정하지 마세요.
추측하지 말고 속도 제한 헤더를 읽기
api.groq.com의 모든 응답에는 콘솔에 방문할 필요 없이 현재 상태를 정확히 알려 주는 헤더 세트가 포함되어 있습니다:
x-ratelimit-limit-requests및x-ratelimit-limit-tokens: 현재 윈도우의 상한x-ratelimit-remaining-requests및x-ratelimit-remaining-tokens: 지금 남아 있는 양x-ratelimit-reset-requests및x-ratelimit-reset-tokens: 윈도우가 갱신되는 시점retry-after: 429에서 전송되며 얼마나 기다려야 하는지 알려 줌
모든 호출 후 x-ratelimit-remaining-tokens를 읽으면 한 번 찾아보고 다시 확인하는 것을 잊어버린 정적인 숫자가 아니라 실시간 게이지를 갖게 됩니다. 다음은 헤더만 출력하는 cURL 빠른 확인입니다:
curl -sD - https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "llama-3.1-8b-instant", "messages": [{"role": "user", "content": "hi"}]}' \
  -o /dev/null | grep -i ratelimit
말 많은 테스트 스크립트에 대해 루프로 몇 번 실행하면 x-ratelimit-remaining-tokens가 줄어드는 것을 볼 수 있습니다. 앱에 백오프 로직이 필요하다면, 지연 시간을 추측하는 대신 retry-after 헤더를 존중하는 패턴을 다룬 API 속도 제한 구현 방법 가이드를 참고하세요.
코딩 에이전트가 Apidog CLI로 확인을 실행하게 하기
curl과 grep 춤을 손으로 추는 것은 한 번의 디버깅 세션에는 통합니다. 팀 규모로 확장되지 않고, 배포 전마다 일회성 셸 명령을 다시 실행하는 사람은 없습니다. 대신 그 확인을 코딩 에이전트에게 맡기세요. Apidog CLI를 사용하면 테스트를 한 번 작성하고 요청할 때마다 실행합니다. 한 번 설정하세요:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
토큰은 Apidog의 계정 설정, API 액세스 토큰에서 가져옵니다. 그런 다음 에이전트에게 프롬프트 하나를 주세요:
Use Apidog CLI on project <id>. Create a Groq environment with base URL
https://api.groq.com/openai/v1 and add POST /chat/completions with Bearer auth
from {{GROQ_API_KEY}}. Create one test case per model we run in production
(llama-3.1-8b-instant, openai/gpt-oss-120b) that asserts status 200 and fails
when x-ratelimit-remaining-tokens drops below 10% of x-ratelimit-limit-tokens.
Put both cases in a "Groq limits" test suite, run it, and report the headers.
실행하는 명령은 Apidog CLI 2.2.7 기준으로 확인했습니다:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog endpoint create --project <id> --file groq-chat.json
apidog cli-schema validate test-case-create --file groq-8b-case.json
apidog test-case create --project <id> --file groq-8b-case.json
apidog test-suite create --project <id> --name "Groq limits"
apidog run --test-suite <suiteId> --project <id> -e <envId> \
  --env-var "GROQ_API_KEY=$GROQ_API_KEY" -r cli,junit
이제 줄어드는 예산은 데모 중 예상치 못한 429가 아니라 실패한 테스트로 드러납니다. 마지막 줄을 배포 전 CI 작업에 넣거나, Apidog CLI CI/CD 파이프라인 가이드처럼 하거나, 에이전트에게 apidog scheduled-task create를 요청하세요. 이는 cron으로 러너에서 스위트를 실행합니다. 이는 Groq의 조직 수준 풀링을 고려하면 더 중요합니다. 한 팀원이 배치 작업을 실행하면 한 시간 뒤 프로덕션 엔드포인트에 필요한 공유 예산을 잡아먹을 수 있습니다. 이는 GPT 속도 제한을 위해 API 테스트하기에 관한 글과 같은 아이디어입니다.
실제로 한도에 도달했을 때 해야 할 일
429가 반환되면 즉시 재시도하지 말고 retry-after를 존중하세요. 요청 수준 한도에 대해 촘촘한 재시도 루프를 돌리면 남은 예산을 더 빨리 소진하고 리셋 윈도우를 더 뒤로 밀어낼 뿐입니다. 이것을 테스트 스크립트가 아니라 프로덕션 서비스에 넣고 있다면, 속도 제한 초과 오류 완전 가이드에서 Groq뿐 아니라 여러 제공자에서 작동하는 백오프 전략을 설명합니다.
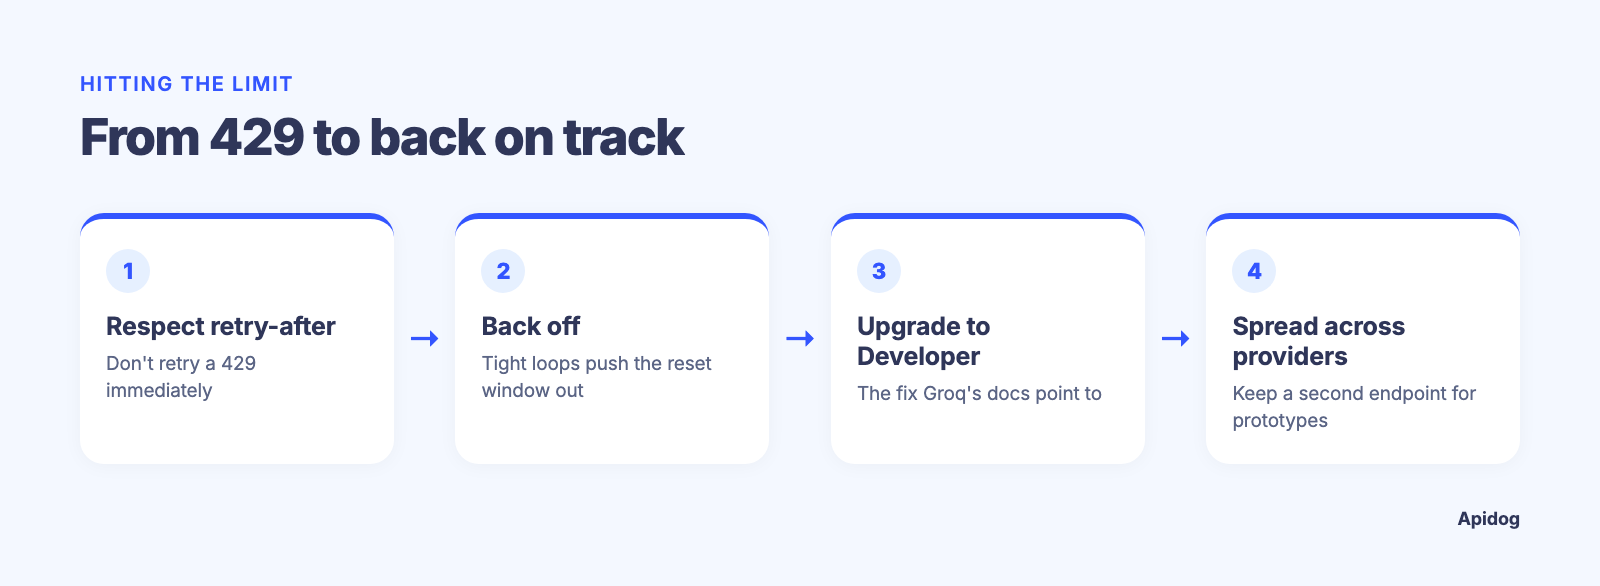
Free Plan의 상한에 계속 부딪힌다면 가장 빠른 해결책은 Groq가 문서에서 직접 안내하는 Developer Plan 업그레이드입니다. 두 번째로 빠른 해결책, 특히 프로토타입의 경우는 트래픽을 둘 이상의 제공자에 분산하는 것입니다. OpenRouter 대안 모음에서는 바로 이런 상황을 위해 알아 두면 좋은 다른 엔드포인트를 다룹니다.
자주 묻는 질문
Groq API에 무료 티어가 있나요? 예. 모든 새 계정은 OpenAI 호환 엔드포인트에 접근할 수 있는 Free Plan으로 시작합니다. Groq는 여러 모델에 대한 예시 Free Plan 한도를 공개하지만, 실제로 계정에 적용되는 상한은 콘솔 설정의 한도 페이지에 있습니다.
현재 Groq 속도 제한을 어떻게 확인하나요? 두 가지 방법이 있습니다. 계정 설정의 한도 페이지를 열거나, 모든 API 응답에서 x-ratelimit-limit-requests 및 x-ratelimit-limit-tokens 헤더를 읽는 것입니다. 헤더는 호출한 순간의 계정 실제 한도를 반영하므로, 한 번 보고 기억한 숫자보다 더 신뢰할 수 있습니다.
Groq 속도 제한을 초과하면 어떻게 되나요? 얼마나 기다려야 하는지 초 단위로 알려 주는 retry-after 헤더와 함께 429 응답을 받습니다. 지연 시간을 추측하는 대신 코드에서 이를 처리하는 방법은 속도 제한 초과 가이드를 참고하세요.
캐시된 토큰이 Groq 속도 제한에 포함되나요? 아니요. Groq는 캐시된 토큰이 속도 제한에 포함되지 않는다고 직접 밝히므로, 캐시된 시스템 메시지를 재사용하는 프롬프트 구조는 원시 토큰 한도가 시사하는 것보다 더 많은 실제 처리량을 얻습니다.
Groq 속도 제한은 사용자별인가요, 조직별인가요? 조직별입니다. 같은 Groq 조직 아래의 모든 키는 하나의 요청 및 토큰 풀을 공유하므로, 팀원의 스크립트가 프로덕션 앱에 필요한 예산을 잡아먹을 수 있습니다.
어떤 Groq 모델이 가장 큰 컨텍스트 윈도우를 갖나요? llama-3.1-8b-instant, llama-3.3-70b-versatile, openai/gpt-oss-120b, openai/gpt-oss-20b, 그리고 Compound 시스템은 모두 131,072토큰 컨텍스트로 실행됩니다. Whisper 모델은 텍스트가 아니라 오디오 전사이므로, Groq는 그 한도를 대신 오디오 길이로 측정합니다. 같은 컨텍스트 윈도우 안에서도 모델마다 속도 제한이 다르므로 각각 따로 확인하세요.
이 글을 마치며
Groq API를 무료로 사용하는 방법은 비밀 숫자가 아니라 습관입니다. 키를 받고, OpenAI 호환 엔드포인트를 그 키로 향하게 하고, 이 글을 포함해 블로그 글에서 찾은 숫자를 믿는 대신 모든 호출에서 응답 헤더를 읽으세요.
코딩 에이전트가 Apidog CLI로 각 모델의 남은 토큰에 대한 어서션을 포함해 그 확인을 한 번 구축하게 하면, 그때부터 모든 배포에서 실행됩니다. 설정은 Groq 문서의 나머지를 읽는 것보다 시간이 덜 걸립니다. 부하 상태에서 AI API 계층을 테스트하는 더 깊은 내용은 AI 에이전트를 위한 최고의 API 테스트 도구 가이드가 좋은 다음 단계입니다.