
Grok 4.6이 8월 12일에 출시되었으며, 최첨단 모델 결정의 판도를 뒤바꿀 주장을 내세웠습니다: Artificial Analysis Index에서 GPT-5.6 Sol과 동등한 지능을 보여주며, 출력 토큰 백만 개당 30달러가 아닌 6달러입니다. 대부분의 비교 기사들은 여전히 Grok 4.5를 기준으로 삼고 있으며, Grok 4.5는 당시 최첨단 모델에 한참 뒤처져 가격이 중요하지 않았습니다. 더 이상 그렇지 않으므로, 이 비교는 4.6 버전의 수치로 새롭게 시작합니다.
간단히 말해서: GPT-5.6 Sol은 저장소 규모의 코딩 에이전트에게 가장 강력한 선택지로 남아있고, Claude Fable 5는 장기 자율 작업에서 근소한 차이로 앞서며, Grok 4.6은 이제 다른 두 모델이 그들의 가격을 정당화하게 만들 만큼 충분히 근접한 성능을 가진 가성비 모델입니다. 올바른 선택은 귀하의 작업량에 따라 달라지므로, 아래에는 수치, API 고려 사항, 그리고 귀하의 스택에서 세 가지를 모두 테스트할 수 있는 재현 가능한 방법이 나와 있습니다. 오늘 바로 테스트를 실행하고 싶다면, Apidog를 통해 하나의 워크스페이스에서 세 가지 API를 나란히 무료로 사용할 수 있습니다.
요약
- 지능 지수: Claude Fable 5가 62로 선두; Grok 4.6과 GPT-5.6 Sol은 61로 동점.
- 가격 (출력, 백만 토큰당): Grok 4.6 $6, Claude Opus 4.8 $25, GPT-5.6 Sol $30, 5배 차이.
- 컨텍스트: GPT-5.6 Sol 1.05M 토큰, Claude Fable 5 1M, Grok 4.6 500K.
- 코딩: Sol Max는 DeepSWE에서 선두 (73.0% 대 Grok 65.9%); Fable 5 Max는 FrontierCode에서 선두 (63.6% 대 61.3%).
- 에이전트: Fable 5 Max는 APEX-Agents에서 59.2%로 선두; Grok 4.6 (57.5%)이 Sol Max (56.7%)를 근소하게 앞섭니다.
- 완료된 작업당 비용: Artificial Analysis 측정 결과 Grok 4.6은 $0.84로, 최첨단 모델 중 가장 낮습니다.
- 벤치마크만으로 결정하지 마세요: 귀하의 작업량에 대해 20가지 프롬프트로 경쟁 테스트를 실행해 보세요 (아래 방법 참조).
사양 및 가격 비교
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| 개발사 | xAI | OpenAI | Anthropic |
| 지능 지수 | 61 | 61 | 62 |
| 컨텍스트 창 | 500K | 1.05M | 1M |
| 입력 가격 / 100만 | $2 | $12 | $10 |
| 출력 가격 / 100만 | $6 | $30 | $25* |
| 고속/프리미엄 변형 | 2배 가격 | Sol Max 티어 | Fable 5 Max 티어 |
| API 스타일 | OpenAI 호환 | OpenAI 네이티브 | Anthropic Messages |
| 지식 차단 시점 | 2026년 2월 |
*Claude 가격은 Opus 4.8 기준입니다; Fable 5 계층 가격은 노력 설정에 따라 다릅니다. 전체 매트릭스는 당사의 GPT-5.6 가격 가이드 및 Claude 비용 절감 분석을 참조하십시오.
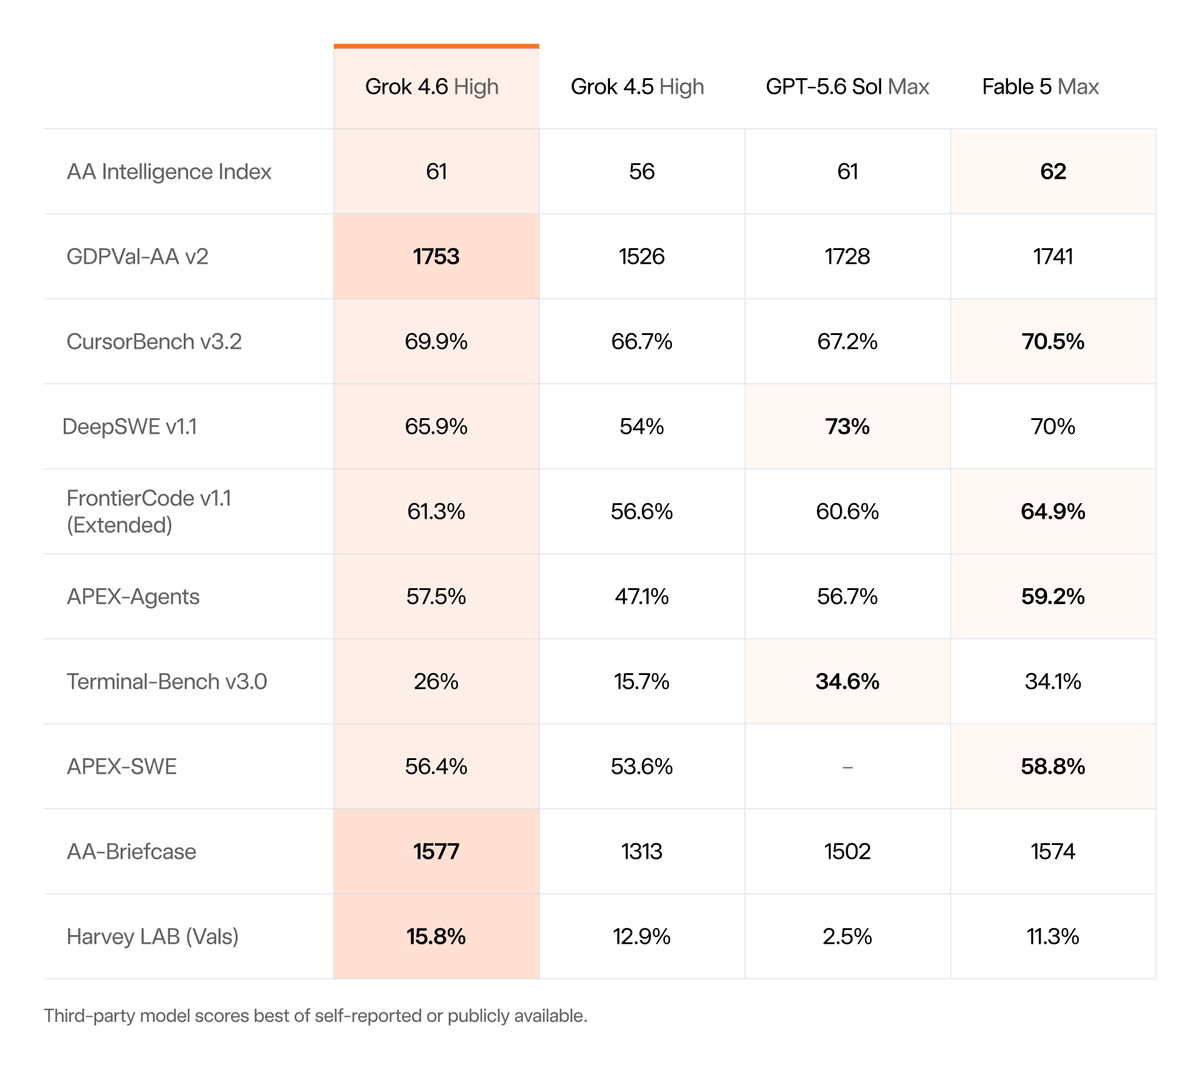
가격 비대칭성이 핵심입니다. 입력 측면에서 Grok은 OpenAI가 부과하는 비용의 6분의 1을 청구하며, 출력 측면에서는 5분의 1을 청구합니다. 채팅 작업량에는 좋지만, 단일 작업이 수십 번의 모델 호출과 긴 도구 사용 기록을 생성할 수 있는 에이전트 작업량의 경우, 이는 하루 50달러 에이전트와 하루 250달러 에이전트 사이의 차이로 증폭됩니다.
코딩 벤치마크: 깊이를 위한 Sol, 가치를 위한 Grok
출시 수치에 따르면, 각 모델은 특정 영역에서 강점을 보입니다:
| 벤치마크 | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (저장소 규모 수정) | 65.9% | 73.0% | |
| FrontierCode v1.1 확장판 | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
다음과 같이 해석할 수 있습니다:
- GPT-5.6 Sol Max의 DeepSWE 7점 우위는 실질적이며 중요합니다. 저장소 규모의 버그 수정은 가장 어렵고 경제적으로 가치 있는 코딩 벤치마크입니다. 귀하의 에이전트가 최소한의 감독으로 대규모 기존 코드베이스에서 작동한다면, Sol은 여전히 가장 안전한 선택입니다. 당사의 GPT-5.6 Sol 대 Claude Fable 5 비교는 이 대결을 심층적으로 다룹니다.
- Claude Fable 5는 일관성에서 승리합니다. 이는 종합 지수, FrontierCode 및 APEX-Agents에서 선두를 달립니다. 특이한 점 없이, 단순히 2위보다 나쁜 경우가 거의 없습니다. 이러한 특성은 한 번의 잘못된 단계로 한 시간의 진행이 무산될 수 있는 장기 자율 작업에 적합합니다.
- Grok 4.6은 결코 뒤처지지 않으며, 때로는 앞서기도 합니다. CursorBench와 Terminal-Bench에서 선두를 달리면서 다른 곳에서는 근접한 성능을 보이고, 비용은 훨씬 저렴하다는 점은 대부분의 트래픽을 라우팅하고 어려운 경우에만 다른 모델로 전환할 모델의 특징과 정확히 일치합니다.
솔직히 말씀드리자면: 이 수치들은 출시 주에 발표된 것으로, 주로 공급업체가 보고한 것입니다. Grok 4.5의 출시 벤치마크는 신중한 검토가 필요했으며, 여기 언급된 모든 공급업체에도 동일한 주의가 적용됩니다.
토큰당 비용이 아닌 작업당 비용
모델의 장황함과 재시도율이 다를 경우 토큰 가격은 오해를 불러일으킬 수 있습니다. 터미널 실행에 실패하는 저렴한 모델은 절약된 토큰보다 더 많은 검토 및 수정 작업을 발생시킵니다. 더 나은 측정 기준은 완료된 작업당 비용이며, 여기서 Artificial Analysis의 독립적인 측정 결과는 놀랍습니다: Grok 4.6은 에이전트 평가 전반에 걸쳐 작업당 평균 $0.84를 기록하여, 단순히 낮은 가격뿐만 아니라 상대적으로 절제된 토큰 사용 덕분에 최첨단 모델 중 가장 낮았습니다.
예시. 귀하의 코딩 에이전트가 완료된 작업당 평균 50만 입력 토큰과 10만 출력 토큰을 사용한다고 가정해 봅시다:
| 모델 | 입력 비용 | 출력 비용 | 작업당 |
|---|---|---|---|
| Grok 4.6 | $1.00 | $0.60 | $1.60 |
| Claude Opus 4.8 | $5.00 | $2.50 | $7.50 |
| GPT-5.6 Sol | $6.00 | $3.00 | $9.00 |
귀하의 작업량에서 Grok의 성공률이 유지된다면, 한 달에 1,000가지 작업을 수행할 경우 Grok은 다른 대안 모델에 비해 대략 6,000~7,400달러를 절약할 수 있습니다. 이 조건이 모든 것의 핵심이며, 그렇기 때문에 확정하기 전에 테스트해야 합니다.
API 사용 편의성: 통합에 실제로 드는 비용
- Grok 4.6은 OpenAI와 호환됩니다. OpenAI 스타일 클라이언트가 있다면,
base_url을https://api.x.ai/v1로 지정하기만 하면 실행됩니다. 게이트웨이 사용자를 위해 OpenRouter, Vercel, Cloudflare에서도 사용할 수 있습니다. - GPT-5.6 Sol은 가장 깊은 생태계를 가지고 있습니다: 응답 API, 프로그래밍 방식 도구 호출, 그리고 어디에서나 제공되는 자체 SDK. 계층 구조에 대한 자세한 내용은 GPT-5.6 API 사용 방법을 참조하십시오.
- Claude Fable 5는 Anthropic의 Messages API를 사용하며, 다른 요청 형태, 뛰어난 도구 사용 신뢰성, 그리고 단일 모델 내에서 비용과 성능을 교환하는 노력 매개변수를 특징으로 합니다.
Grok과 OpenAI (공유 형식) 간의 마이그레이션 마찰은 가장 낮고, Anthropic으로 또는 Anthropic에서 이동할 때 가장 높습니다. 모델 간 전환 또는 라우팅을 예상한다면, 이러한 비대칭성을 아키텍처 결정에 포함해야 합니다.
컨텍스트 창: 50만 토큰으로 충분할 때
이론적으로 GPT-5.6 Sol의 1.05M 토큰 창은 Grok 4.6의 50만 토큰 창의 두 배이며, Claude Fable 5의 1M 토큰 창이 그 뒤를 바짝 쫓고 있습니다. 실제로는 귀하의 작업량이 컨텍스트에 실제로 무엇을 담고 있는지가 중요합니다.
50만 토큰 창은 대략 35만 단어에 해당합니다: 중간 규모 서비스의 전체 코드베이스, 1년치 지원 기록, 또는 수백 페이지의 법률 문서에 해당합니다. 대부분의 에이전트 작업은 이 정도에 근접하지 않습니다. 진정으로 백만 토큰 계층이 필요한 작업량은 제한적입니다: 전체 모노레포 분석, 요약하기를 거부하는 매우 긴 다중 세션 에이전트 기록, 그리고 방대한 문서 세트의 단일 처리 등이 있습니다.
두 가지 실제적인 고려 사항은 창 크기만으로 선택하는 것에 반대합니다. 첫째, 컨텍스트가 채워질수록 모든 모델의 성능이 저하됩니다; 세 모델 모두 80% 용량에서의 검색 품질은 20% 용량에서보다 나쁩니다. 따라서 창을 채워 넣는 아키텍처는 선택적으로 검색하는 아키텍처를 거의 이기지 못합니다. 둘째, 예산이 소진되는 지점은 입력 토큰입니다: Sol의 전체 창을 채우는 데는 정가 기준으로 요청당 약 $12.60가 소요되는 반면, Grok의 창을 채우는 데는 $1가 소요됩니다. 프롬프트가 일상적으로 40만 토큰을 초과한다면, 더 큰 창만 필요한 것이 아니라 캐싱 및 검색 전략이 필요합니다(어떤 공급업체를 선택하든).
지식 차단 시점 및 생태계 성숙도
Grok 4.6은 2026년 2월 1일의 지식 차단 시점을 가지고 출시되었는데, 이는 세 모델 중 가장 최신이며 빠르게 변화하는 프레임워크를 참조하는 코딩 에이전트에게 중요합니다. 이는 실제적이지만 사소한 이점입니다: 어떤 진지한 에이전트 스택이든 매개변수적 지식에 의존하기보다는 검색 및 문서화 도구를 사용하여 기반을 다집니다.
생태계는 반대 상황입니다. OpenAI는 가장 깊은 타사 통합 영역을 가지고 있으며, Anthropic은 에이전트 프레임워크 분야에서 가장 강력한 시장 점유율을 가지고 있고, xAI는 OpenAI 호환성에 의존하여 둘 모두를 빌리는 신규 진입자입니다. 이 전략은 대체로 성공적입니다: 오늘날 채팅 완성 형식을 사용하는 모든 것은 Grok에 대해 작동하며, OpenRouter, Vercel, Cloudflare를 통한 게이트웨이 가용성은 인프라에 손대지 않고도 Grok을 채택할 수 있음을 의미합니다. 포기해야 할 것은 자체 개발의 완성도, 배치 API, 캐싱 계층, 그리고 세분화된 사용 제어로, 이는 기존 업체들의 것보다 덜 성숙합니다.
어떤 작업에 어떤 모델을 사용할 것인가
- 자율 저장소 규모 코딩 에이전트, 품질 우선: GPT-5.6 Sol. DeepSWE에서의 선두는 대규모 코드베이스에서 실패하는 실행이 더 적음을 의미합니다.
- 장기 지식 작업 및 여러 시간 지속되는 에이전트 세션: Claude Fable 5. 최고의 종합 점수, 최고의 에이전트 벤치마크, 안정적인 운영에 대한 가장 강력한 기록.
- 고볼륨 에이전트 트래픽, 비용에 민감한 제품, 또는 라우터의 기본 모델: Grok 4.6. 상품 수준 가격으로 최첨단 수준의 출력; 가장 어려운 10%의 작업은 Sol 또는 Fable로 에스컬레이션.
- IDE에서의 인터랙티브 코딩: Grok 4.6의 CursorBench 선두 및 2배 빠른 변형은 이를 강력한 경쟁자로 만듭니다; 이는 실제 Cursor 세션을 통한 학습 후에 효과적으로 이를 위해 구축되었습니다.
오후에 귀하의 스택에서 세 가지 모두 테스트하기
벤치마크는 평균을 예측할 뿐, 귀하의 작업량을 예측하지는 않습니다. 다음은 Apidog를 사용한 재현 가능한 경쟁 테스트입니다:
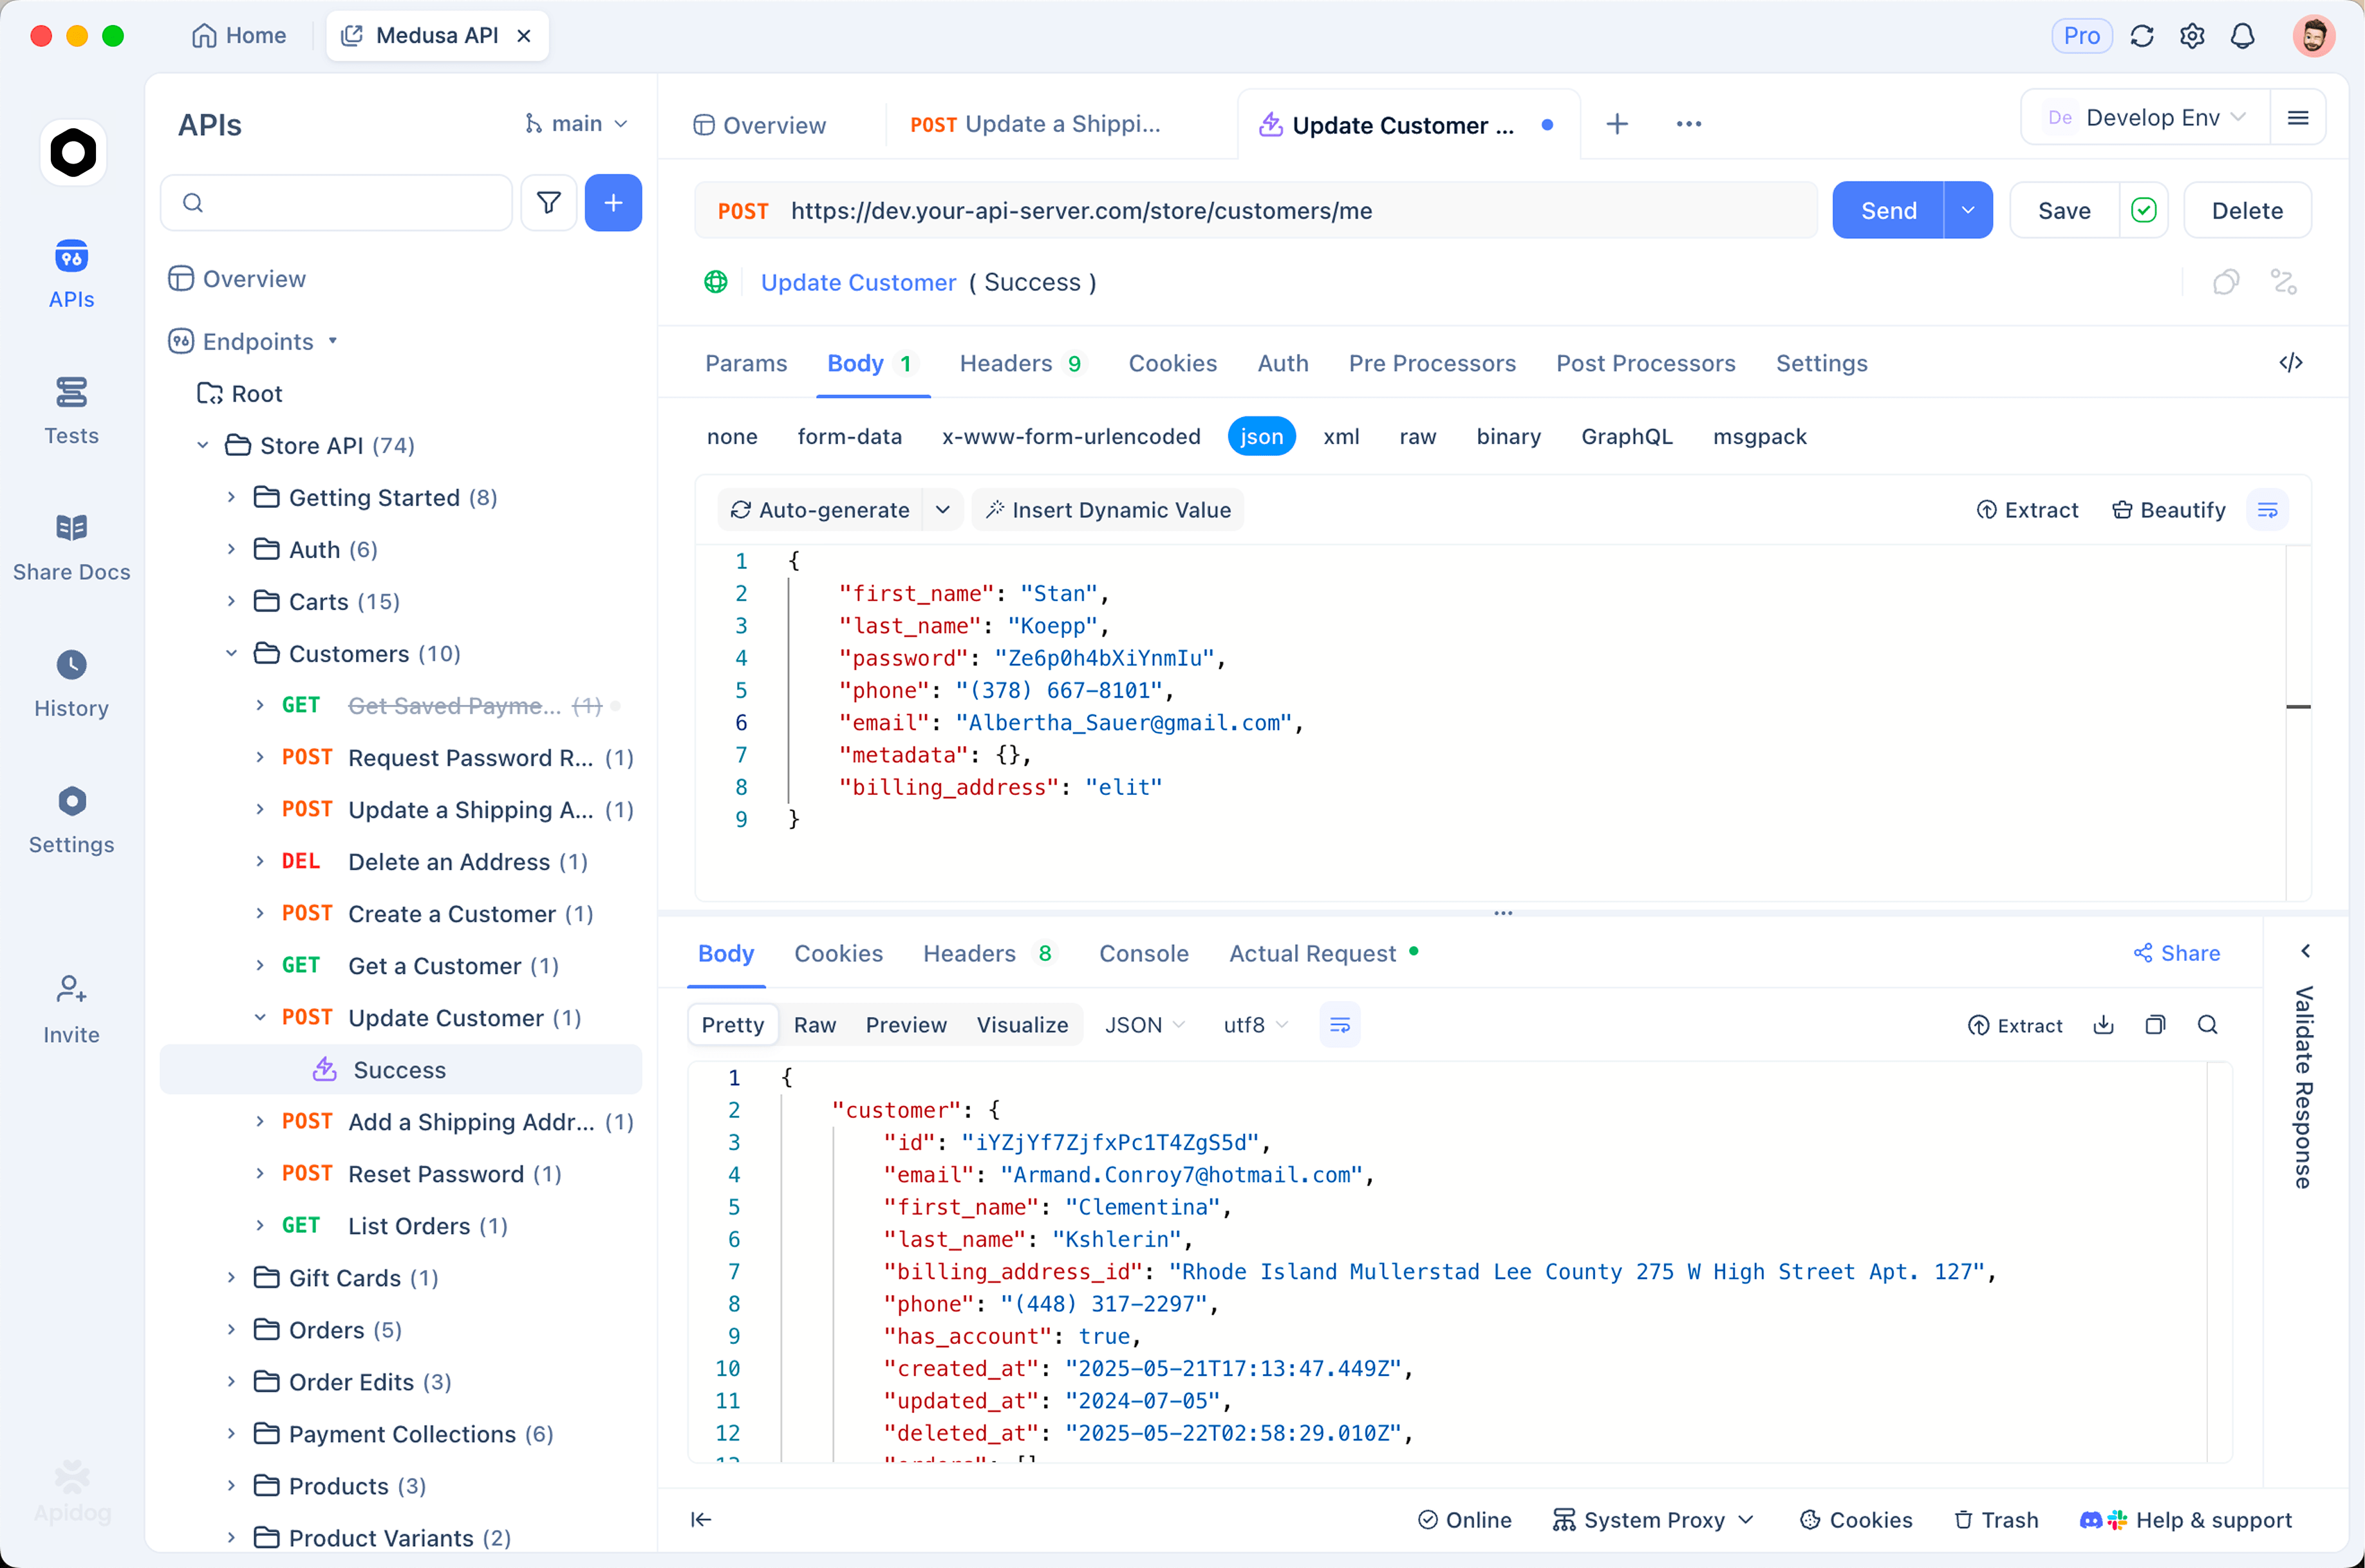
- 하나의 프로젝트, 세 가지 환경. xAI (
api.x.ai/v1), OpenAI, Anthropic을 위한 환경을 생성하고, 각 환경에 자체 인증을 설정합니다. 동일한 요청으로 드롭다운 하나로 제공업체를 전환할 수 있습니다. - 실제 프롬프트 20개를 수집합니다. 장난감 같은 질문이 아니라, 귀하의 제품에서 실제 작업을 가져옵니다. 시스템 프롬프트, 함수 호출을 사용하는 경우 도구 정의, 그리고 최소 5가지 알려진 어려운 사례를 포함합니다.
- 중요하게 생각하는 것을 단언합니다. 응답 유효성,
usage객체에서 토큰 사용량, 지연 시간 임계값에 대한 Apidog 단언을 추가합니다. 도구 호출 작업량의 경우, 도구 호출 JSON이 구문 분석되고 스키마와 일치하는지 단언합니다. 모델은 산문보다 여기에서 훨씬 더 자주 실패합니다. - 각 모델별로 세 번씩 테스트 시나리오로 실행합니다. LLM 출력은 다양합니다; 세 번의 실행은 단일 데모가 숨기는 편차를 드러냅니다. 결과를 내보내고 토큰당 비용이 아닌 성공률과 성공당 비용을 비교합니다.
- 스위트를 유지합니다. 다음 모델 버전이 출시되면 (현재 주기로는 몇 달 내), 다시 실행합니다. 모델 선택은 이제 분기별 결정이며, 상시 평가 체계를 갖춘 팀은 일화로 다시 결정하는 팀보다 몇 주 더 빠르게 전환합니다.
자주 묻는 질문
Grok 4.6이 GPT-5.6 Sol보다 더 좋습니까? 종합 지수에서 61점으로 동점입니다. Sol은 저장소 규모 코딩에서 확실히 앞서고 (DeepSWE 73.0% 대 65.9%); Grok은 CursorBench와 Terminal-Bench에서 선두를 달리며 출력 측면에서 5배 저렴합니다. ‘더 좋다’는 것은 귀하의 작업량이 DeepSWE와 더 유사한지 아니면 IDE 세션과 더 유사한지에 따라 달라집니다.
Grok 4.6이 Claude Fable 5보다 더 좋습니까? Fable 5는 지수 (62 대 61), FrontierCode, APEX-Agents에서 모두 근소하게 앞섭니다. Grok의 장점은 가격입니다. 정확성이 중요한 자율 작업에는 Fable 5; 비용에 민감한 대량 작업에는 Grok.
2026년 최첨단 AI 모델 중 가장 저렴한 것은 무엇입니까? Grok 4.6은 백만 토큰당 입력 $2/출력 $6이며, 독립적으로 측정된 에이전트 작업당 $0.84입니다. 가장 가까운 최첨단 경쟁 모델의 출력 토큰 비용은 약 4배 더 비쌉니다.
제 프로덕션 에이전트를 Grok 4.6으로 전환해야 할까요? 벤치마크만으로는 안 됩니다. 먼저 실제 작업량으로 위에서 설명한 경쟁 테스트를 실행하세요. 5배의 가격 차이는 귀하의 작업에서 성공률이 유지될 때만 효과를 발휘합니다.
세 가지 모델을 하나의 API 형식 뒤에서 사용할 수 있습니까? 대부분 그렇습니다. Grok 4.6은 OpenAI 채팅 완성 형식을 기본적으로 지원하므로 GPT-5.6과 클라이언트 코드를 공유합니다. Claude는 Anthropic의 Messages API를 필요로 하거나, OpenRouter와 같이 세 가지 모두를 하나의 인터페이스 뒤에서 약간의 마크업으로 정규화하는 게이트웨이를 사용해야 합니다.
Grok 4.6의 더 작은 컨텍스트 창이 중요합니까? 대부분의 에이전트 및 채팅 작업량에서는 그렇지 않습니다; 50만 토큰은 일반적인 사용량을 훨씬 초과하며, 세 모델 모두 한계에 가까워지면 성능이 저하됩니다. 단일 호출로 전체 모노레포 또는 방대한 문서 세트를 일상적으로 처리하는 경우에는 중요합니다. 이 경우 Sol의 1.05M 창이 실제 여유 공간을 제공합니다.