
GPT-Live-1.1과 GPT-Realtime의 차이는 결국 아키텍처에 있습니다. GPT-Live-1.1은 추론과 도구 호출을 별도 백엔드 모델에 맡기고 활성 분당 $0.05를 청구하는 전이중(full-duplex) 음성 프런트엔드입니다. GPT-Realtime-2.1은 듣고, 추론하고, 도구를 호출하고, 말하는 하나의 음성-대-음성 모델이며 토큰 단위로 과금됩니다. 이미 텍스트 에이전트가 있다면 GPT-Live-1.1을, 하나의 모델이 모든 것을 처리하길 원한다면 Realtime을 선택하세요.
OpenAI는 2026년 11월 20일 GPT-Live-1.1을 API에 출시했습니다. 이제 엔드포인트, 과금 방식, 도구 모델이 각각 다른 두 가지 음성 스택을 사용할 수 있습니다. 지난 7월 GPT-Live vs GPT-Realtime 글에서는 ChatGPT 기능과 API를 비교했다면, 이번 글은 API 대 API 비교입니다.
한눈에 보는 GPT-Live-1.1 vs GPT-Realtime
2026년 11월 20일 기준 GPT-Live-1.1 모델 페이지, gpt-realtime-2.1 모델 페이지, OpenAI 가격 페이지에서 가져온 두 스택의 비교는 다음과 같습니다:
| GPT-Live-1.1 | gpt-realtime-2.1 | |
|---|---|---|
| 엔드포인트 | v1/live/sessions |
v1/realtime |
| 설계 | 전이중 음성 + 위임된 백엔드 | 하나의 음성-대-음성 추론 모델 |
| 입력 | 오디오, 텍스트 | 오디오, 텍스트, 이미지 |
| 출력 | 오디오, 텍스트 | 오디오, 텍스트 |
| 과금 | 활성 분당 $0.05, 대기 분당 $0.02 | 100만 오디오 토큰당 입력 $32, 출력 $64 |
| 추론 및 도구 | 백엔드 모델, 별도 과금 | 동일 모델 및 가격에 포함 |
| 함수 호출 | 위임을 통해 | session.tools |
| 전송 방식 | WebRTC, WebSocket, SIP(인바운드 및 아웃바운드) | WebRTC, WebSocket, SIP(인바운드) |
| 속도 제한 | 동시 세션 수 | 분당 요청 및 토큰 수 |
OpenAI의 음성 에이전트 가이드는 아키텍처 표에서 이 구분을 요약합니다. GPT-Live는 “별도 백엔드와의 전이중 대화”를 위한 것이고, Realtime API는 “하나의 세션에서 음성, 추론, 도구 사용”을 위한 것입니다.
아키텍처: 위임 vs 단일 모델
GPT-Live-1.1은 말하기와 사고를 분리합니다. 음성 모델은 실시간으로 대화를 처리하며 말하는 동안에도 듣습니다. 요청에 추론, 검색 또는 도구가 필요하면 작업을 백엔드 모델에 위임하고, 그 작업이 실행되는 동안에도 대화를 계속 이어갑니다.
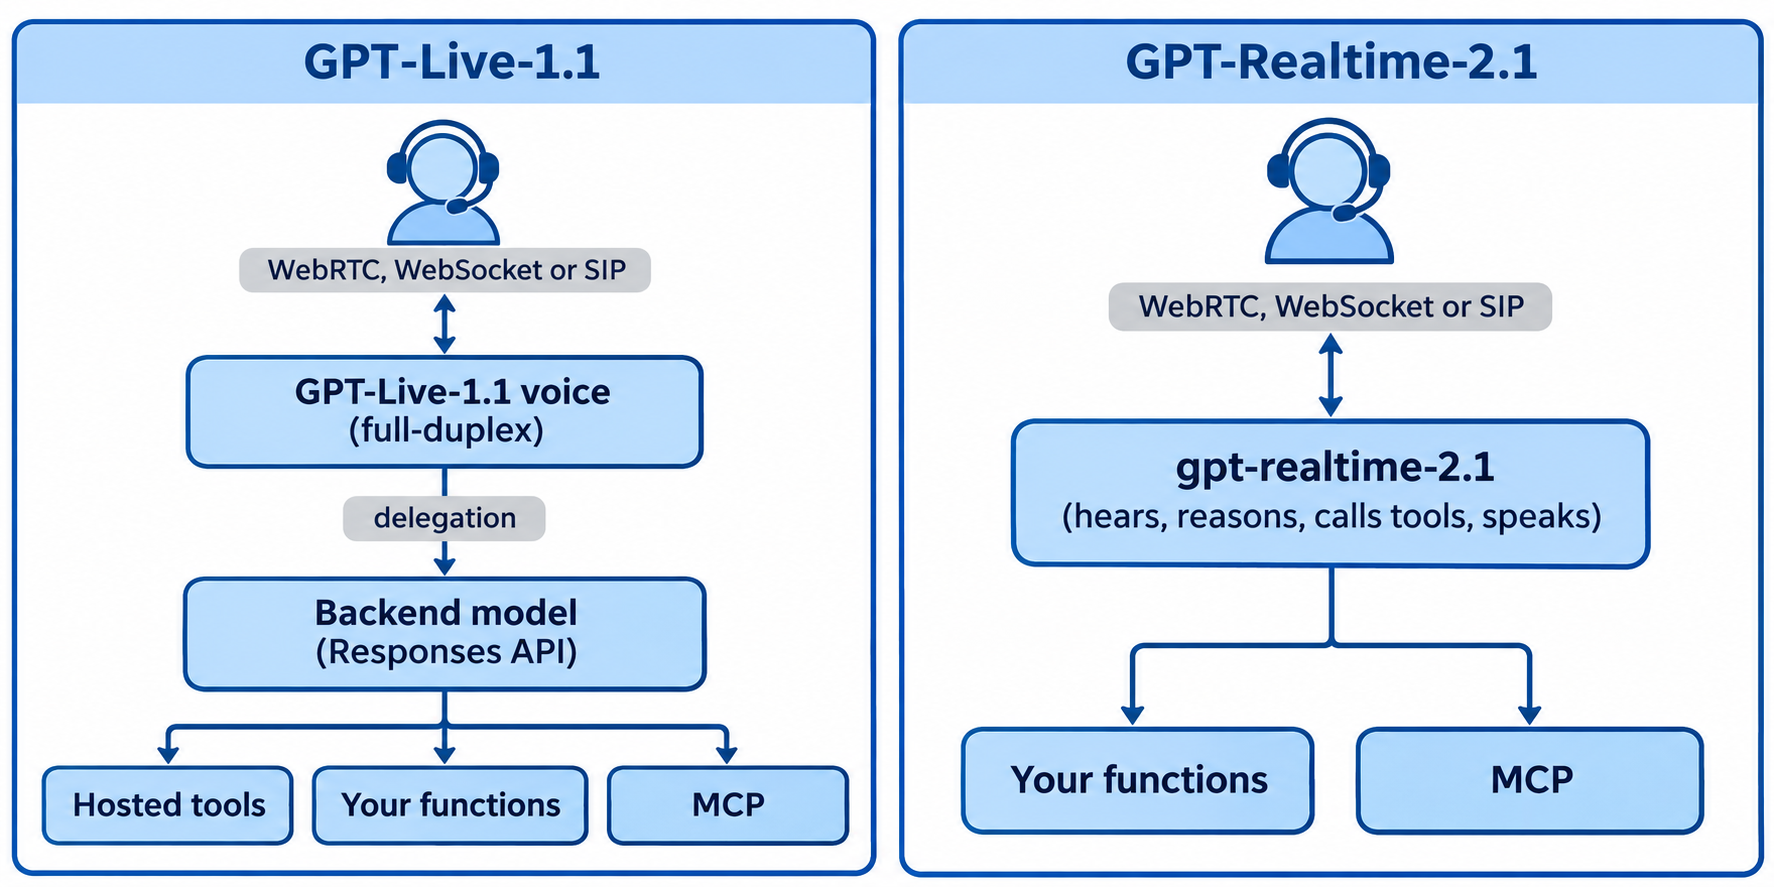
라이브 대화 가이드에 따르면 위임은 세션을 만들 때 한 번만 설정합니다. 두 가지 모드가 있습니다:
responses: OpenAI가 Responses API를 통해 백엔드를 실행합니다.delegation.responses.model에서 모델을 선택하고instructions,tools,tool_choice,reasoning,service_tier를 추가합니다. 문서에서는gpt-6-luna로 시작하고 더 어려운 작업에는gpt-6-sol로 이동할 것을 권장합니다.client: 앱이 백엔드를 실행합니다. GPT-Live가session.delegation.created이벤트를 보내면session.instructions.append같은 이벤트로 결과를 반환합니다.
모드는 세션 도중 변경할 수 없으며, 전환하려면 새 세션이 필요합니다. 모드 내부의 백엔드 설정은 session.update로 변경할 수 있습니다.
gpt-realtime-2.1은 반대 접근 방식을 취합니다. 하나의 추론 모델이 오디오를 해석하고 도구를 호출하며 음성으로 답합니다. 두 번째 모델도, 핸드오프도 없고 모든 컨텍스트가 한곳에 있습니다.
GPT-Live-1.1을 사용하면 음성 계층을 건드리지 않고 백엔드를 교체하거나 기존 텍스트 에이전트를 유지할 수 있습니다. Realtime에서는 음성 모델 자체가 에이전트입니다.
가격: 분당 vs 토큰당
GPT-Live-1.1은 시간 기준으로, Realtime은 토큰 기준으로 과금합니다. 그래서 발신자가 멈추거나, 장황하게 말하거나, 통화를 유지하기 시작하면 두 서비스의 비용 양상이 크게 달라집니다.
| 비용 항목 | GPT-Live-1.1 | gpt-realtime-2.1 | gpt-realtime-2.1-mini |
|---|---|---|---|
| 오디오 | 활성 분당 $0.05, 대기 분당 $0.02 | 100만 토큰당 입력 $32, 출력 $64 | 100만 토큰당 입력 $10, 출력 $20 |
| 텍스트 | 세션 지속 시간 기준 과금 | 100만 토큰당 입력 $4, 출력 $24 | 100만 토큰당 입력 $0.60, 출력 $2.40 |
| 캐시된 입력 | 해당 없음 | 100만 토큰당 $0.40 | 100만 토큰당 오디오 $0.30, 텍스트 $0.06 |
| 추론 및 도구 | 백엔드 모델의 자체 요율 적용 | 토큰 가격에 포함 | 토큰 가격에 포함 |
GPT-Live는 초 단위로 과금하므로 90초 통화의 음성 시간 비용은 $0.10이 아니라 $0.075입니다. WebRTC 세션은 초기화하는 동안 15초가 과금되지만, 실행이 시작되면 이 시간은 크레딧으로 돌려받습니다.
대기(standby) 과금은 Realtime에는 없는 비용 조절 수단입니다. WebRTC에서는 wake_policy.type을 "speech"로, idle_timeout_s를 5에서 60 사이의 정수로 설정하세요. 설정한 시간 동안 음성이 없으면 세션 요금이 분당 $0.02로 떨어지고, 다시 누군가 말할 때까지 유지됩니다. 대기 과금은 WebRTC에만 문서화되어 있으므로 WebSocket 및 SIP 세션은 연결된 모든 초에 활성 요율로 과금됩니다.
자체 트래픽으로 두 서비스를 비교하려면 추측 대신 손익분기 수치를 사용하세요. $0.05로 gpt-realtime-2.1에서는 약 1,560개의 오디오 입력 토큰 또는 780개의 오디오 출력 토큰을, 2.1-mini에서는 약 5,000개의 입력 토큰 또는 2,500개의 출력 토큰을 처리할 수 있습니다. Realtime 사용 이벤트에서 분당 오디오 토큰 수를 가져오세요. 평균 활성 1분이 그보다 많은 토큰을 사용한다면 GPT-Live의 음성 시간 요금이 더 저렴합니다. 여기에 백엔드 모델의 토큰 청구액을 더하면 전체 비용을 볼 수 있습니다.
Realtime은 추론을 토큰 가격에 포함하지만, GPT-Live는 위임된 작업마다 백엔드 청구액이 추가되는 대신 대기 과금으로 침묵 구간의 비용을 줄입니다. 토큰 비용 쪽은 gpt-realtime-2.1-mini 가이드를 참고하세요.
함수 호출 및 도구
두 스택 모두 함수를 호출하지만 호출 위치가 다릅니다.
Realtime에서는 도구가 세션에 속합니다. Realtime 도구 가이드는 session.tools에 "type": "function" 도구를 넣고 session.update로 보내는 방법을 보여줍니다. 클라이언트가 함수를 실행하고 function_call_output 항목을 반환합니다. 원격 MCP 서버도 사용할 수 있습니다. "type": "mcp", server_label, server_url을 사용해 도구를 추가하면 Realtime API가 대신 서버를 호출합니다. response.tools로 도구를 한 턴에만 적용할 수도 있습니다.
GPT-Live-1.1에서는 도구가 백엔드에 속합니다. 함수 도구, MCP 서버, 그리고 웹 검색, 파일 검색, Code Interpreter 같은 호스팅 도구를 delegation.responses.tools에 넣습니다. 백엔드 이벤트는 response.event 봉투로 감싸져 도착하며, 함수 결과는 function_call_output 항목과 그 뒤의 response.create로 반환됩니다.
장점은 느린 도구가 백엔드에서 실행되는 동안에도 음성 응답성이 유지된다는 것입니다. 비용은 모델 두 개, 이벤트 스트림 두 개, 청구서 두 개라는 점입니다.
턴 테이킹, 인터럽트, 전송 방식
발신자가 가장 다르게 느끼는 부분입니다.
턴 테이킹. GPT-Live-1.1은 전이중 방식입니다. 출력을 생성하는 동시에 들어오는 오디오를 처리하므로, 듣고, 맞장구치고, 문장 중간에 조정할 수 있습니다. Realtime은 음성 활동으로 감지된 턴 단위로 동작합니다. Realtime VAD 가이드에는 session.audio.input.turn_detection.type의 두 가지 모드가 나옵니다:
server_vad: 기본값이며threshold,prefix_padding_ms,silence_duration_ms로 조정합니다.semantic_vad:eagerness(low,medium,high,auto—auto는medium과 동일)로 조정합니다.
Realtime은 interrupt_response로 끼어들기(barge-in)를 처리합니다. GPT-Live는 말하는 동안 이미 듣고 있으므로 이 설정이 필요 없습니다.
전송 방식. 둘 다 브라우저의 WebRTC와 서버의 WebSocket을 지원합니다. 전화 통화는 다릅니다. SIP 가이드에 따르면 GPT-Live는 인바운드 및 아웃바운드 SIP를 지원하며, 아웃바운드 통화는 “Realtime API의 통화 생성 엔드포인트가 아닌 Live API를 통해 모든 조직에서 사용할 수 있습니다.” 연결된 GPT-Live SIP 통화는 2시간으로 제한됩니다. Realtime의 SIP 가이드는 realtime.call.incoming 웹훅을 통한 인바운드 통화를 다룹니다.
제한 및 컨텍스트
| 제한 | GPT-Live-1.1 | gpt-realtime-2.1 |
|---|---|---|
| 컨텍스트 | 세션당 128,000토큰, 자동 관리 | 128,000토큰 |
| 최대 출력 토큰 | 공개되지 않음 | 32,000 |
| 지침 | 최대 16,384토큰 | 공개되지 않음 |
| 속도 제한 | 모델별 동시 세션 수 | Build 티어에서 400 RPM 및 200,000 TPM |
GPT-Live는 토큰이 아니라 동시성을 기준으로 계산합니다. GPT-Live-1 페이지에는 Build에서 동시 세션 50개, Launch에서 300개, Grow에서 500개가 나열되어 있으며 Free 티어에서는 사용할 수 없습니다. GPT-Live-1.1은 별도의 제한이 있고 아직 페이지에 수치가 공개되지 않았으므로, 출시 전에 조직의 제한 페이지를 확인하세요.
Realtime의 제한은 Launch에서 10,000 RPM, Grow에서 20,000 RPM까지 확장됩니다.
어떤 OpenAI 음성 API를 사용해야 할까요?
음성이 이미 신뢰하는 에이전트 위에 얹는 계층이라면 GPT-Live-1.1을, 음성 모델 자체가 에이전트가 되어야 한다면 Realtime을 사용하세요.
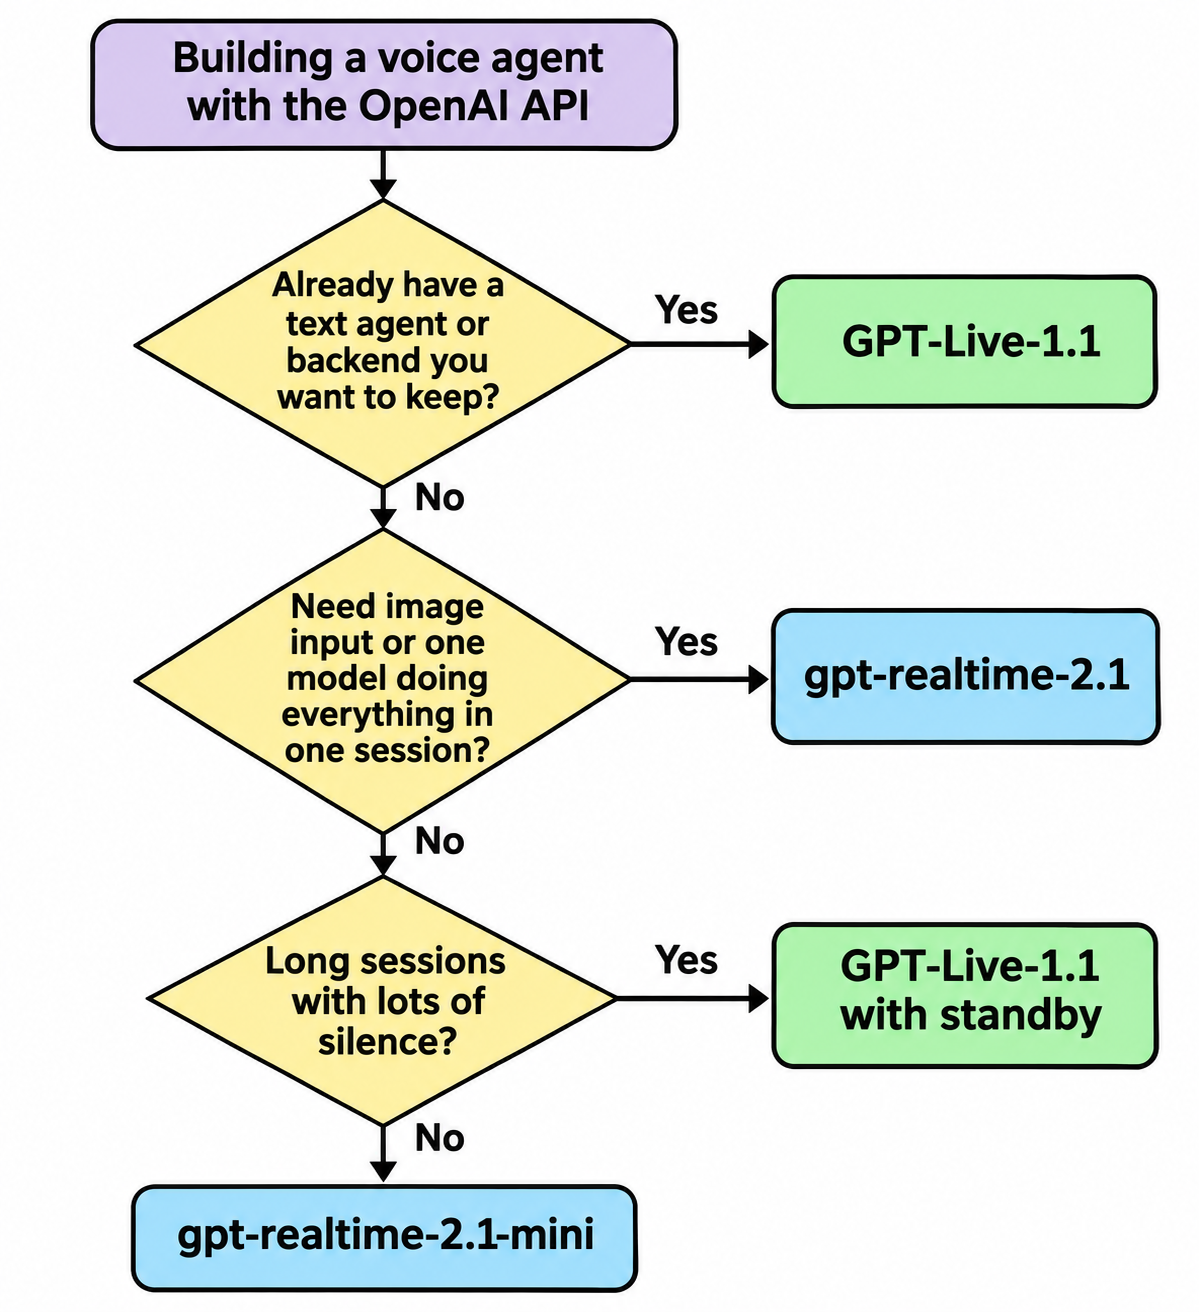
GPT-Live-1.1을 선택하세요:
- 기존 텍스트 에이전트, 지원 봇, 워크플로를 다시 구축하지 않고 음성을 추가할 때.
- 튜터링, 코칭, 컴패니언처럼 중간 공백이 많은 긴 세션에서 대기 과금이 효과를 볼 때.
- Live API에서만 제공하는 아웃바운드 전화 통화.
- 자연스러운 말 겹침과 맞장구가 필요한 대화.
gpt-realtime-2.1을 선택하세요:
- 하나의 모델이 추론하고 행동해야 하는 독립형 음성 에이전트.
- 음성과 함께 이미지를 전송하는 앱.
- 하나의 이벤트 스트림과 하나의 청구서를 원하는 팀.
gpt-realtime-2.1-mini를 선택하세요 짧고 처리량이 많으며 비용이 낮은 음성 작업에서 토큰당 가격이 분당 가격보다 유리할 때 적합합니다. Realtime 설정은 GPT-Realtime-2 API 가이드에서 자세히 다룹니다.
코딩 에이전트가 Apidog CLI로 도구 API를 테스트하게 하세요
어느 스택을 선택하든 두 서비스 모두 같은 대상, 즉 도구 API를 호출합니다. 조회가 느리면 어느 쪽이든 통화에 침묵이 생기므로, 발신자가 듣기 전에 지연 시간과 계약을 테스트해야 합니다. Claude Code, Codex, Cursor가 Apidog CLI로 이를 수행하게 하세요.
한 번 설정하세요:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
그다음 에이전트에 프롬프트 하나를 주세요:
Import ./voice-tools-openapi.yaml into Apidog project <projectId>. Build a test scenario
that calls GET /orders/{order_id} and GET /customers/{id} in sequence, asserts 200 and
the fields my voice agent reads aloud, and fails any request slower than 800 ms.
Run it 20 times against staging and tell me which step is slowest.
에이전트가 명세를 가져오고, 페이로드 형태를 확인하고, 시나리오를 만든 뒤 실행합니다:
apidog import --project <projectId> --format openapi --file ./voice-tools-openapi.yaml
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointIds> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <envId> -n 20 --timeout-request 800 -r cli,json
-n 20은 실행을 반복하므로 운 좋은 응답 하나가 느린 꼬리 지연을 숨기지 못합니다. --timeout-request 800은 발신자를 기다리게 할 만큼 느린 모든 호출을 실패 처리합니다. CI에서는 -r cli,json을 -r junit로 바꿔 회귀가 배포를 차단하도록 하세요. Apidog CLI CI/CD 가이드에서 확인할 수 있습니다. 에이전트 워크플로가 처음이라면 Claude Code에서 Apidog CLI 사용하기부터 시작하세요. Apidog의 Free 플랜은 최대 4명의 사용자까지 지원합니다.
자주 묻는 질문
GPT-Live-1.1과 GPT-Realtime 중 어느 쪽이 더 저렴한가요? 분당 오디오 토큰 수와 백엔드에 따라 다릅니다. GPT-Live 음성 비용은 활성 분당 $0.05에 백엔드 모델의 토큰 비용이 더해집니다. gpt-realtime-2.1에서는 $0.05로 약 1,560개의 오디오 입력 토큰 또는 780개의 오디오 출력 토큰을 처리할 수 있습니다. 자체 사용 로그와 비교해 보세요.
GPT-Live-1.1에서 함수 호출을 사용할 수 있나요? 네, 위임을 통해 가능합니다. 함수 도구를 delegation.responses.tools에 넣거나 클라이언트 위임 모드에서 백엔드를 직접 실행하세요. 음성 모델은 Realtime의 session.tools처럼 직접 도구 목록을 받지는 않습니다.
GPT-Realtime은 대기 과금을 지원하나요? 아니요. 분당 $0.02의 대기 과금은 GPT-Live 기능이며, wake_policy와 idle_timeout_s로 구성된 WebRTC 세션에만 적용됩니다. Realtime은 각 세션이 사용한 토큰을 과금합니다.
GPT-Live-1.1로 아웃바운드 전화를 걸 수 있나요? 네. POST /v1/live/sessions에서 transport.type: "sip"와 SIP 트렁크 세부 정보를 사용해 세션을 만드세요. OpenAI 문서에 따르면 아웃바운드 SIP는 Realtime API의 통화 생성 엔드포인트가 아닌 Live API를 통해 실행됩니다.
GPT-Live-1.1은 이미지 입력을 받나요? 아니요. 모델 페이지에는 입력과 출력이 오디오 및 텍스트로 나와 있습니다. 음성 에이전트가 이미지를 봐야 한다면 gpt-realtime-2.1이 100만 토큰당 $5로 이미지 입력을 받습니다.