
GPT-Live-1.1의 과금은 토큰 기반이 아닌 시간 기반입니다. OpenAI는 음성 세션에 대해 활성 상태 분당 $0.05, 대기 상태 분당 $0.02를 청구하며, 초 단위로 계산하고 분 단위로 올림하지 않습니다. 백엔드 모델 호출과 도구 호출은 별도로 일반 요율로 청구됩니다. 1시간 내내 대화를 이어가면 음성 요금이 $3.00이고, 1시간 동안 대기 상태로 놓아두면 $1.20입니다.
요율표는 간단합니다. 하지만 실제 앱에서는 사용자가 말을 멈추고, 백엔드가 처리 시간을 필요로 하며, 세션이 필요 이상으로 열려 있는 경우가 많기 때문에 실제 요금은 이런 동작 방식에 달려 있습니다. 아래에서 세 가지 실제 계산 예시와 요금을 예측 가능하게 유지하는 설정을 살펴봅니다.
GPT-Live-1.1 요금 한눈에 보기
GPT-Live-1.1은 두 가지 음성 요율이 있고, 백엔드 요금은 별도로 청구됩니다. 2026년 11월 20일 기준 GPT-Live-1.1 모델 페이지와 OpenAI 요금 페이지에 명시된 내용은 다음과 같습니다:
| 요금 항목 | 요율 | 시간당 | 비고 |
|---|---|---|---|
| 활성 세션 시간 | 분당 $0.05 | $3.00 | 음성 출력, 유휴 타임아웃 전의 침묵, 백엔드 처리 대기 시간 |
| 대기 세션 시간 | 분당 $0.02 | $1.20 | WebRTC 전용, 추론이 일시 중지된 상태 |
| 백엔드 Responses 모델 | 일반 토큰 요율 | 가변 | 위임에 사용하는 모델에 따라 다름 |
| 호스티드 도구 | 일반 도구 요율 | 가변 | 웹 검색, 파일 검색, Code Interpreter 등 |
표면적인 요율보다 더 중요한 세 가지 세부 사항이 있습니다:
- 초 단위 과금. 90초 통화 비용은 $0.10이 아니라 $0.075입니다. 통화 시간이 분 단위로 올림되지 않습니다.
- GPT-Live-1과 동일한 가격. 두 모델의 요율이 동일하므로 업그레이드해도 음성 요금은 변하지 않습니다.
- 15초 시작 요금. WebRTC 세션 생성 시 초기화하는 동안 15초가 청구되며, 세션이 정상 실행되면 크레딧으로 돌려받습니다. 생성만 하고 사용하지 않고 버린 세션에서만 추가 비용이 발생합니다.
음성 스택에 대한 배경 설명은 GPT-Live vs GPT-Realtime을 참고하세요.
활성 시간과 대기 시간의 구분 기준
활성 시간은 추론이 실행 중인 모든 시간입니다. 대기 시간은 WebRTC 세션이 연결된 상태에서 추론이 일시 중지되고 음성 입력을 기다리는 시간입니다. 두 요율 사이의 분당 $0.03 차이가 음성 요금의 대부분을 좌우합니다.
OpenAI의 비용 가이드는 활성 시간에 포함되는 항목을 다음과 같이 설명합니다:
- 사용자 또는 모델이 말하고 있는 시간.
- 유휴 타임아웃이 만료되기 전까지의 침묵 시간.
- 추론이 실행 중인 상태에서 백엔드 처리를 기다리는 시간.
마이크를 음소거해도 대기 상태가 되지는 않으며, 세션은 분당 $0.05의 활성 요율로 계속 청구됩니다.
대기 상태를 사용하려면 세션 생성 시 두 가지 설정이 필요하며, 라이브 대화 가이드에 문서화되어 있습니다:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech"는 추론을 시작하기 전에 음성 입력을 기다리도록 세션에 지시합니다. idle_timeout_s는 5에서 60 사이의 정수를 받으며, 입력 또는 출력 전사가 없는 상태가 해당 시간(초)만큼 지속되면 세션을 대기 상태로 전환합니다. 타임아웃을 생략하면 세션이 끝날 때까지 추론이 활성 상태로 유지되므로 대기 요율은 적용되지 않습니다.
주의할 점 두 가지: 대기 상태는 WebRTC 전용이므로 WebSocket과 SIP 세션은 연결된 모든 시간에 활성 요율이 청구되며, 대기 상태 이후의 첫 응답은 더 오래 걸릴 수 있습니다.
실제 비용 계산 예시
음성 요율은 공개된 수치이며, 백엔드 토큰 수는 예시를 위한 가정입니다. 백엔드 가격은 OpenAI 요금 페이지 기준으로, gpt-6-luna는 1M 토큰당 입력 $0.10, 출력 $0.50이고, gpt-6-sol은 1M 토큰당 입력 $2.00, 출력 $10.00입니다(표준 티어, 짧은 컨텍스트). OpenAI의 위임 가이드는 gpt-6-luna로 시작해서 더 어려운 백엔드 작업에는 gpt-6-sol을 시도해 볼 것을 권장합니다.
예시 1: 고객 지원 전화
전화 또는 WebSocket 지원 통화가 6분간 진행됩니다. 대기 상태가 적용되지 않으므로 6분 전체가 활성 요율로 청구됩니다. GPT-Live는 4건의 조회를 gpt-6-luna에 위임하며, 각 건당 약 6,000 입력 토큰과 400 출력 토큰을 사용합니다.
| 항목 | 계산 | 비용 |
|---|---|---|
| 음성 | 6분 x $0.05 | $0.30 |
| 백엔드 입력 | 24,000 토큰 x $0.10 / 1M | $0.0024 |
| 백엔드 출력 | 1,600 토큰 x $0.50 / 1M | $0.0008 |
| 통화당 | $0.3032 |
월 10,000건의 통화라면 약 $3,032이며, 그중 $3,000이 음성 시간 요금입니다. 평균 통화 시간을 30초만 줄여도 백엔드 요금 전체보다 더 많이 절약할 수 있습니다.
예시 2: 브라우저 기반 언어 학습 튜터
idle_timeout_s를 15로 설정한 30분짜리 WebRTC 튜터링 세션입니다. 학생이 긴 시간 동안 읽고 생각하는 데 시간을 쓰기 때문에 세션은 활성 18분, 대기 12분으로 진행됩니다. 튜터는 10건의 설명을 gpt-6-sol에 위임하며, 각 건당 약 8,000 입력 토큰과 600 출력 토큰을 사용합니다.
| 항목 | 계산 | 비용 |
|---|---|---|
| 활성 음성 | 18분 x $0.05 | $0.90 |
| 대기 음성 | 12분 x $0.02 | $0.24 |
| 백엔드 입력 | 80,000 토큰 x $2.00 / 1M | $0.16 |
| 백엔드 출력 | 6,000 토큰 x $10.00 / 1M | $0.06 |
| 세션당 | $1.36 |
대기 상태가 없다면 동일한 30분 음성 요금은 $1.14 대신 $1.50이 됩니다. 즉, 대기 상태 덕분에 음성 요금이 24% 절감됩니다.
예시 3: 상시 실행 데스크톱 어시스턴트
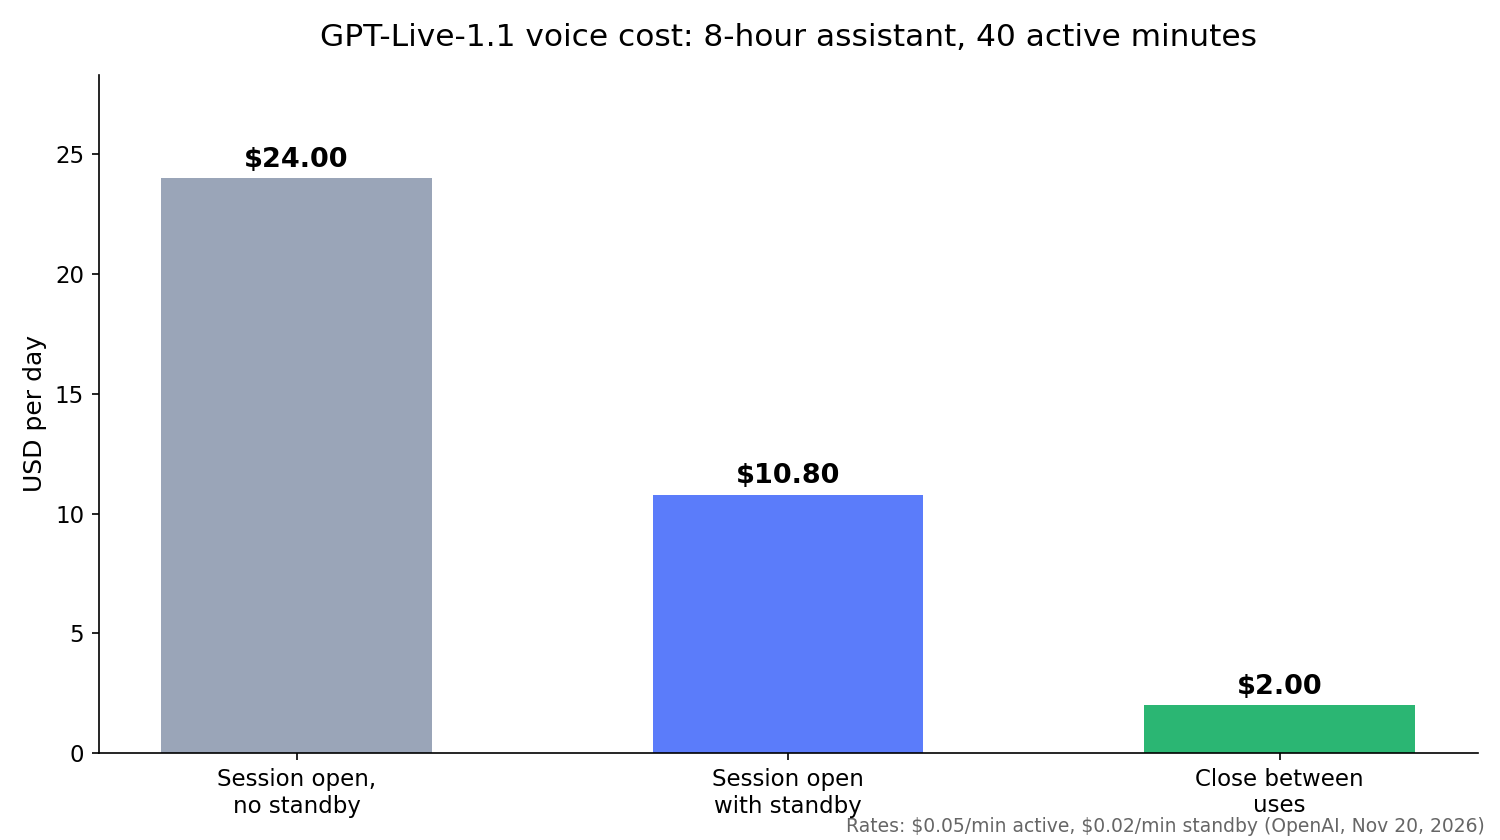
어시스턴트가 8시간 근무일 내내 열려 있지만, 사용자는 짧게 나눠서 총 40분만 대화합니다. 이 경우 어떤 전략을 선택하느냐에 따라 요금이 10배 이상 달라집니다:
| 전략 | 계산 | 일당 | 22일 근무 월 기준 |
|---|---|---|---|
| 세션 유지, 대기 없음 | 480분 x $0.05 | $24.00 | $528.00 |
| 세션 유지 + 대기 | 40 x $0.05 + 440 x $0.02 | $10.80 | $237.60 |
| 사용 사이에 종료 | 40분 x $0.05 | $2.00 | $44.00 |
대기 상태여도 유휴 시간 1시간당 $1.20이 듭니다. OpenAI의 가이드는 긴 공백 구간에는 세션을 닫고, 사용자가 돌아오면 저장해 둔 히스토리를 시드로 넣어 새 세션을 시작할 것을 권장합니다. 15초 시작 요금은 새 세션이 정상 실행되면 크레딧으로 돌려받으므로, 음성 요금만 놓고 보면 종료하는 쪽이 유리합니다. 다만 즉각적인 응답 가능성은 포기해야 합니다. 닫힌 세션은 사용자의 말을 들을 수 없으므로 푸시투토크(push-to-talk)나 자체 웨이크 트리거가 필요합니다.
유휴 타임아웃이 요금에 미치는 영향
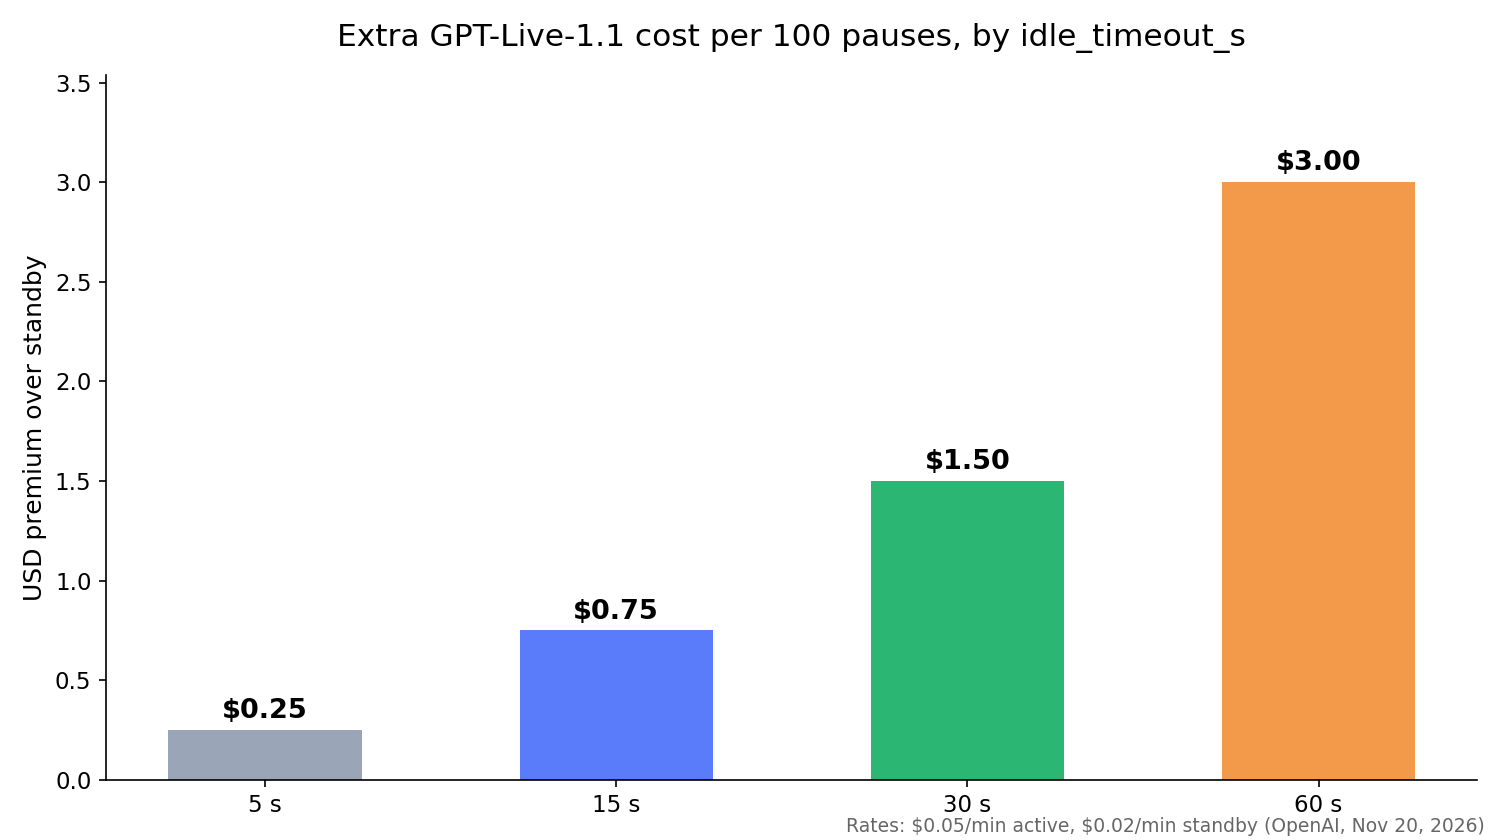
유휴 타임아웃이 작동하기 전까지는 모든 침묵 구간이 활성 시간으로 청구됩니다. 타임아웃을 짧게 설정하면 더 저렴한 대기 요율에 더 빨리 도달하지만, 일시 중지 후 재개 주기가 늘어나고 매번 재개 후 첫 응답이 더 느려진다는 대가가 있습니다.
침묵 구간 하나당 추가 비용은 타임아웃 길이에 두 요율 사이의 $0.03 차이를 적용한 금액입니다. 세션 또는 하루에 100번의 침묵 구간이 있을 때:
idle_timeout_s |
침묵당 활성 초 | 대기 대비 추가 비용, 100회 기준 |
|---|---|---|
| 5 | 5 | $0.25 |
| 15 | 15 | $0.75 |
| 30 | 30 | $1.50 |
| 60 | 60 | $3.00 |
금액은 작습니다. 그게 핵심입니다. 타임아웃은 대부분 사용자 경험 설정으로 보면 됩니다. 사용자가 생각하는 도중에 끊기지 않는 값을 고르고, 긴 공백은 대기 상태가, 아주 긴 공백은 세션 종료가 처리하도록 하세요.
GPT-Live-1.1 요금과 GPT-Realtime 비교
GPT-Live-1.1은 분 단위로 청구되지만, GPT-Realtime 모델은 토큰 단위로 청구됩니다. OpenAI 요금 페이지에 따르면 gpt-realtime-2.1 오디오는 1M 입력 토큰당 $32.00, 1M 출력 토큰당 $64.00이며, gpt-realtime-2.1-mini 오디오는 각각 $10.00, $20.00입니다.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| 과금 단위 | 세션 초 | 입력 및 출력 토큰 |
| 음성 요율 | 활성 분당 $0.05, 대기 분당 $0.02 | 오디오 토큰 1M당 $32 / $64 |
| 추론 및 도구 | 별도의 백엔드 모델 | 동일한 모델 내부에 포함 |
| 비용 곡선 | 분당 고정 | 컨텍스트가 커질수록 턴당 비용 증가 |
OpenAI의 비용 가이드는 Realtime 세션이 응답할 때마다 전체 대화 내용을 모델에 전송하므로 후반부 턴일수록 비용이 더 든다고 설명합니다. GPT-Live는 2분째든 40분째든 분당 비용이 동일해 비용 예측이 간단합니다. 토큰 기반 설정 방법은 GPT-Realtime-2 API 가이드를 참고하세요.
사용량 추적과 예상 밖 청구서 방지
GPT-Live는 session.usage.updated 이벤트를 통해 누적 음성 사용량을 초 단위로 보고합니다:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
각 업데이트는 이전 총합을 대체하므로 절대 합산하면 안 됩니다. session.close를 보내고 session.closed를 기다린 뒤 최종 usage.seconds를 기록하세요. 활성 시간과 대기 시간을 나누려면 session.paused와 session.resumed 이벤트 사이의 간격을 측정하면 됩니다.
비용을 낮게 유지하는 습관:
- 끝난 세션은 닫기. 열려 있는 방치된 세션은 계속 청구됩니다.
- 백엔드 속도 높이기. 위임된 작업을 기다리는 시간도 활성 시간이며, 1분이라도 빨리 끝내면 $0.05를 절약합니다.
- 긴 작업 중에는 세션 닫기. 백엔드가 처리하는 동안 음성 세션을 닫고, 결과가 준비되면 다시 엽니다.
- 동시성 계획 세우기. 제한은 동시 세션 수에 적용되며, GPT-Live-1.1은 GPT-Live-1과 별도의 제한을 가집니다. GPT-Live-1의 공개된 제한은 50(Build), 300(Launch), 500(Grow)입니다. Free 티어는 지원되지 않습니다.
Apidog CLI로 Codex에게 비용 계산 로직 검증 맡기기
사용량 계산 로직은 여러분이 소유한 코드이며, 여기에 버그가 있으면 모든 통화 요금이 잘못 계산됩니다. 음성 세션을 열지 않고, 음성 시간 비용 $0으로 커밋할 때마다 테스트를 실행하세요. 그리고 코딩 에이전트가 Apidog CLI로 테스트를 실행하도록 하면 됩니다.
CLI를 설치하고, 로그인한 뒤, Apidog 스킬을 에이전트에 추가하세요:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 Codex에 프롬프트 하나만 주면 됩니다:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
에이전트가 스키마를 읽고, 페이로드를 검증하고, 테스트 케이스를 생성해 실행합니다:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
-r cli,json을 -r junit으로 바꾸면 동일한 실행 결과를 CI에 바로 넣을 수 있습니다. 자세한 내용은 CI/CD 파이프라인에서 Apidog CLI 실행하기를 참고하세요. 에이전트 설정 방법은 Apidog CLI in Codex 가이드에 정리되어 있습니다. Apidog의 Free 플랜은 최대 4명의 팀까지 무료로 사용할 수 있습니다.
FAQ
GPT-Live-1.1의 분당 비용은 얼마인가요? 활성 상태 분당 $0.05, 대기 상태 분당 $0.02이며 초 단위로 청구됩니다. 백엔드 사용량은 별도입니다.
GPT-Live-1.1이 GPT-Live-1보다 비싼가요? 아닙니다. OpenAI는 두 모델 모두 동일한 활성 및 대기 요율로 안내하고 있습니다.
전화 통화에서도 대기 요율이 적용되나요? 아니요. 낮은 대기 요율은 추론이 일시 중지된 WebRTC 세션에만 적용됩니다. WebSocket과 SIP 세션은 연결된 시간에 활성 요율이 청구됩니다.
백엔드 모델 호출이 분당 가격에 포함되나요? 아니요. 위임된 Responses 호출은 선택한 모델의 토큰 요율로 청구되며, 도구 사용 요금도 별도로 추가됩니다.
7월의 GPT-Live API 관련 질문은 어떻게 됐나요? 그 당시 GPT-Live는 API가 없는 ChatGPT 음성 기능이었으며, GPT-Live API 설명 기사에서도 그 점을 짚었었습니다. GPT-Live-1.1이 API 모델이며, v1/live/sessions에서 서비스됩니다.