
GPT-Live-1.1 API는 OpenAI의 전이중(full-duplex) 음성 모델로, v1/live/sessions에서 제공됩니다. WebRTC, WebSocket 또는 SIP로 세션을 열고, 모델·지침·음성이 담긴 session 설정을 전송한 뒤, 위임(delegation)을 통해 추론과 도구 호출을 백엔드 Responses 모델에 넘기면 됩니다. 비용은 활성 분당 $0.05, 대기 분당 $0.02입니다.
OpenAI는 2026년 11월 20일 OpenAI Developers 발표를 통해 GPT-Live-1.1을 API에서 사용할 수 있게 했습니다. 지난 7월 저희의 보도인 GPT-Live API가 있나요?에서는 "아직 없다"고 답했었죠. 이제 상황이 달라졌습니다. 이 가이드에서는 실제로 동작하는 세션, 위임 설정, 함수 도구, 그리고 음성 에이전트가 호출하는 백엔드의 테스트 환경 구축 방법까지 안내합니다.
GPT-Live-1.1 API란?
GPT-Live-1.1은 말하는 동안에도 듣고 있는, 음성 입력·음성 출력 모델입니다. v1/realtime이나 v1/responses가 아닌 v1/live/sessions 엔드포인트에서 실행됩니다. 이 모델 자체의 역할은 대화입니다. 더 무거운 추론과 도구 사용은 여러분이 설정한 백엔드 모델로 넘어가기 때문에, 실제 작업이 진행되는 동안에도 음성은 빠르게 반응합니다.
현재 GPT-Live-1.1 모델 페이지에 나와 있는 내용은 다음과 같습니다:
| 항목 | GPT-Live-1.1 |
|---|---|
| 모델 ID | gpt-live-1.1 (단일 스냅샷) |
| 입력 / 출력 | 오디오·텍스트 입력, 오디오·텍스트 출력 |
| 엔드포인트 | v1/live/sessions 전용 |
| 전송 방식 | WebRTC (권장), WebSocket, SIP |
| 활성 가격 | 분당 $0.05 |
| 대기 가격 | 분당 $0.02 (WebRTC, 추론 일시 중지) |
| 백엔드 모델 및 도구 | 해당 모델의 정상 요금으로 별도 청구 |
| 동시성 | GPT-Live-1과 별도의 제한, 조직 단위 적용 |
제품 배경이 궁금하다면 GPT-Live란 무엇인가와 GPT Realtime과의 차이점을 다룬 글을 참고하세요.
GPT-Live-1.1 vs GPT-Live-1: 무엇이 달라졌나
모델 페이지와 프롬프팅 가이드에 따르면 실질적인 차이는 네 가지입니다:
- 전사(Transcription): 1.1은 "음성을 더 정확하게 전사"합니다.
- 음성: 1.1은 "여러 언어에서도 더 일관된 억양과 목소리"를 유지합니다.
- 위임 프롬프트: 1.1은 일상 언어로 지시할 수 있습니다("다음 경우에는 백엔드에 위임하세요:"). GPT-Live-1은 정책에
<|SpawnThinking|>마커가 필요합니다. - 과금 표현: GPT-Live-1은 초 단위로 청구되며 절대 1분 단위로 올림하지 않습니다. 1.1 페이지에는 "사용 시간 기준 청구"라고만 되어 있습니다.
두 모델은 같은 엔드포인트, 가격, 세션 구조를 공유하므로 1.1로의 전환은 대부분 모델 문자열 변경과 더 깔끔한 프롬프트 정도로 끝납니다.
GPT-Live-1.1 세션 열기
GPT-Live 시작 가이드는 브라우저, 모바일, 서버 오디오에 WebRTC를 권장합니다. 하지만 서버 사이드 프로토타입에는 WebSocket이 더 간단한 방법이므로, 여기서부터 시작해 보겠습니다:
- 쿼리 파라미터 없이
Authorization: Bearer $OPENAI_API_KEY헤더로wss://api.openai.com/v1/live/sessions에 연결합니다. session설정과 함께 첫 메시지로session.start를 전송합니다.- 오디오를 보내기 전에
session.started를 기다립니다. - 선택한 형식으로 오디오를 스트리밍합니다. 기본값은 24 kHz PCM입니다.
import WebSocket from "ws";

const ws = new WebSocket("wss://api.openai.com/v1/live/sessions", {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  ws.send(JSON.stringify({
    type: "session.start",
    event_id: "start_1",
    session: {
      model: "gpt-live-1.1",
      instructions: "You are the voice agent for Acme order support. Keep answers short.",
      audio: {
        format: { type: "audio/pcm", rate: 24000 },
        output: { voice: "marin" },
      },
    },
  }));
});

ws.on("message", (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type === "session.started") console.log("Session ready");
});
대화 가이드에서 몇 가지 설정 규칙을 짚어 보면:
instructions는 최대 16,384 토큰까지 사용할 수 있습니다. 세션 중간에는session.instructions.append로 추가합니다(한 번에 500 토큰).audio.output.voice의 기본값은marin입니다. 그 외 API 이름으로quartz,stone,meridian,willow가 있습니다.- WebSocket 형식은 24,000 또는 16,000 Hz의
audio/pcm, 그리고 전화 통신용으로 8,000 Hz의audio/pcmu또는audio/pcma입니다. store의 기본값은false입니다.model을 변경하려면 새 세션이 필요합니다.
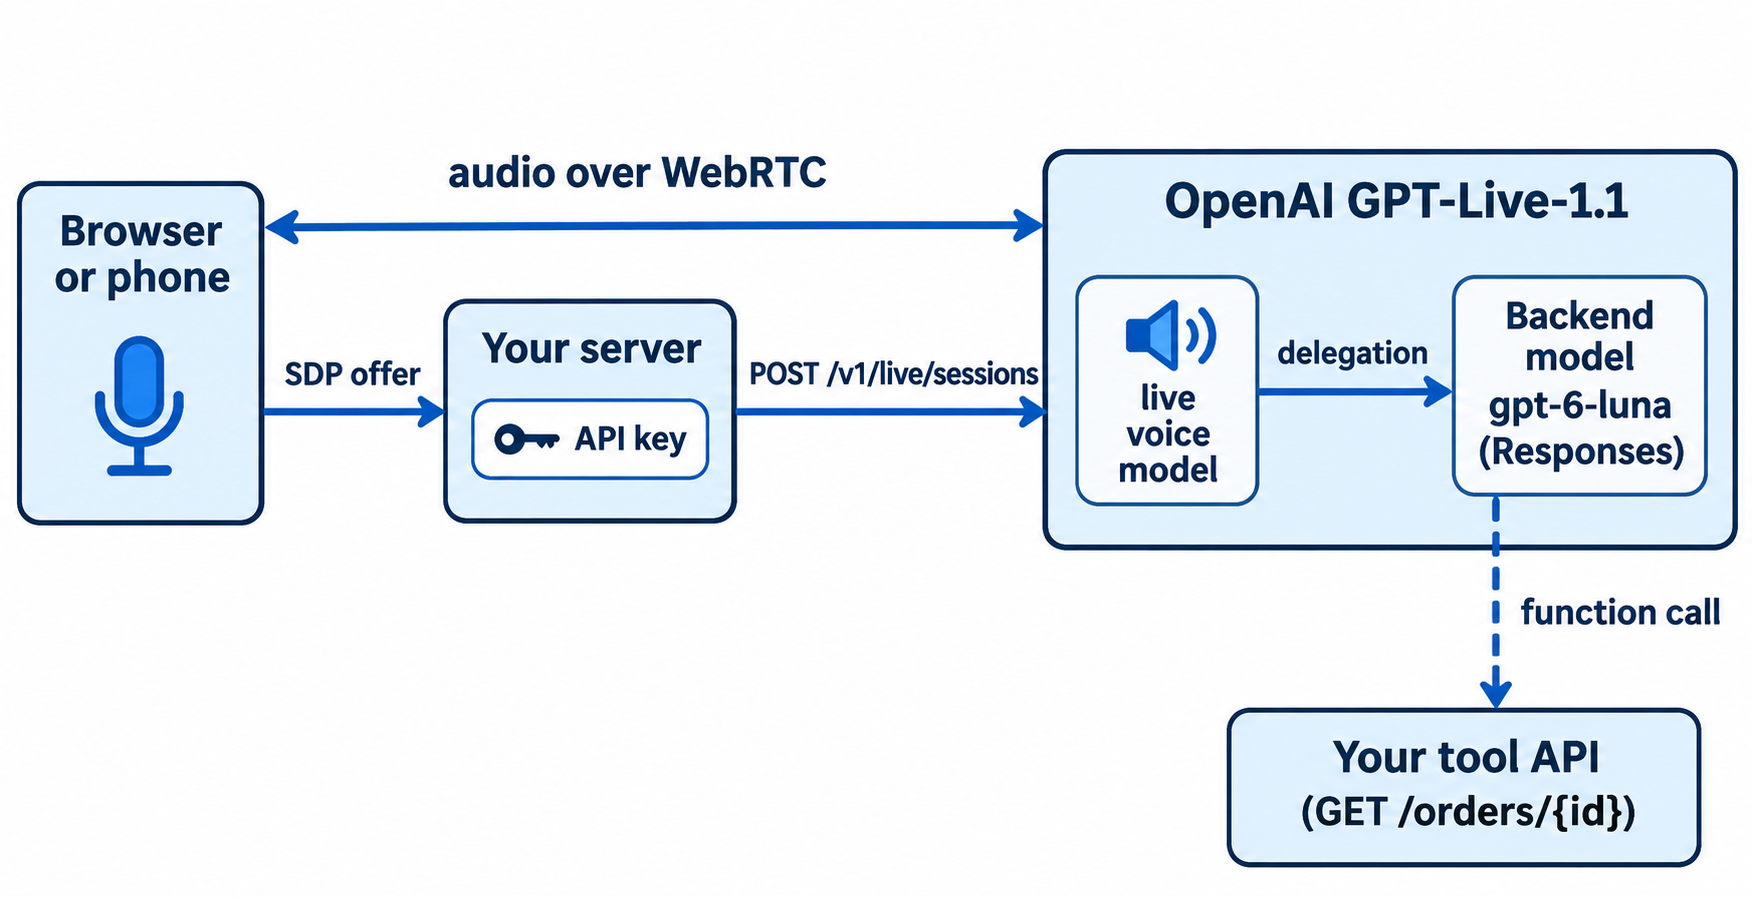
브라우저에서 프로덕션 환경으로 운영하려면 WebRTC로 전환하세요. 서버가 API 키를 보관하고 브라우저의 SDP offer를 중계합니다:
const res = await fetch("https://api.openai.com/v1/live/sessions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { model: "gpt-live-1.1", instructions: "..." },
    transport: { type: "webrtc", sdp: offerSdp },
  }),
});
const { session, transport } = await res.json(); // HTTP 201
// session.id looks like "live_123"; return transport.sdp to the browser
WebRTC 요청에서는 audio.format을 빼고, 데이터 채널에서 session.start를 보내지 마세요. 과금 관련 한 가지 세부 사항: WebRTC 세션 생성 시 초기화 동안 15초가 청구되며, 세션이 실행되면 크레딧으로 돌려받습니다.
GPT-Live-1.1 위임: 백엔드 모델에게 추론을 맡기기
위임(delegation)은 이 API가 존재하는 이유입니다. 음성 모델이 계속 대화하는 동안 백엔드 모델이 추론하고, 검색하고, 도구를 호출합니다. 세션 생성 시 두 가지 모드 중 하나를 선택하며, 세션 도중에는 모드를 바꿀 수 없습니다.
| 모드 | delegation.type |
백엔드 실행 주체 | 적합한 용도 |
|---|---|---|---|
| Responses | "responses" |
OpenAI, 여러분이 설정한 모델과 도구 사용 | 대부분의 앱, 호스티드 도구, 함수 호출 |
| Client | "client" (기본값이기도 함) |
여러분의 앱 | 자체 에이전트 루프 또는 비(非)OpenAI 백엔드 |
위임 가이드는 gpt-6-luna로 시작해서 더 어려운 백엔드 작업에는 gpt-6-sol을 시도해 볼 것을 권합니다. 아직 모델을 정하지 못했다면 저희의 GPT-6 Luna 개요에서 트레이드오프를 확인하세요.
"delegation": {
  "type": "responses",
  "responses": {
    "model": "gpt-6-luna",
    "instructions": "Look up orders with get_order. Answer in one sentence.",
    "tools": [{ "type": "web_search" }],
    "tool_choice": "auto",
    "parallel_tool_calls": false
  }
}
responses 블록에는 max_output_tokens(16 이상), service_tier(auto, default, flex 또는 priority — priority는 고속 모드), 그리고 백엔드 모델이 지원하는 reasoning과 text 설정도 지정할 수 있습니다. 세션 도중 session.update로 이 필드들을 변경할 수 있습니다. 검증은 비동기적으로 이루어지며, 잘못된 설정은 코드 responses_validation_failed와 함께 error로 도착하고 세션은 열린 상태로 유지됩니다.
그런 다음 음성 모델에게 언제 위임할지 알려줘야 합니다. 1.1에서는 instructions에 일상 언어로 작성하면 됩니다:
Delegate to the backend when: the caller asks about an order, a refund or anything you must look up.
Do not delegate when: the caller greets you, asks you to repeat, or says goodbye.
While the backend works, briefly say what you are checking.
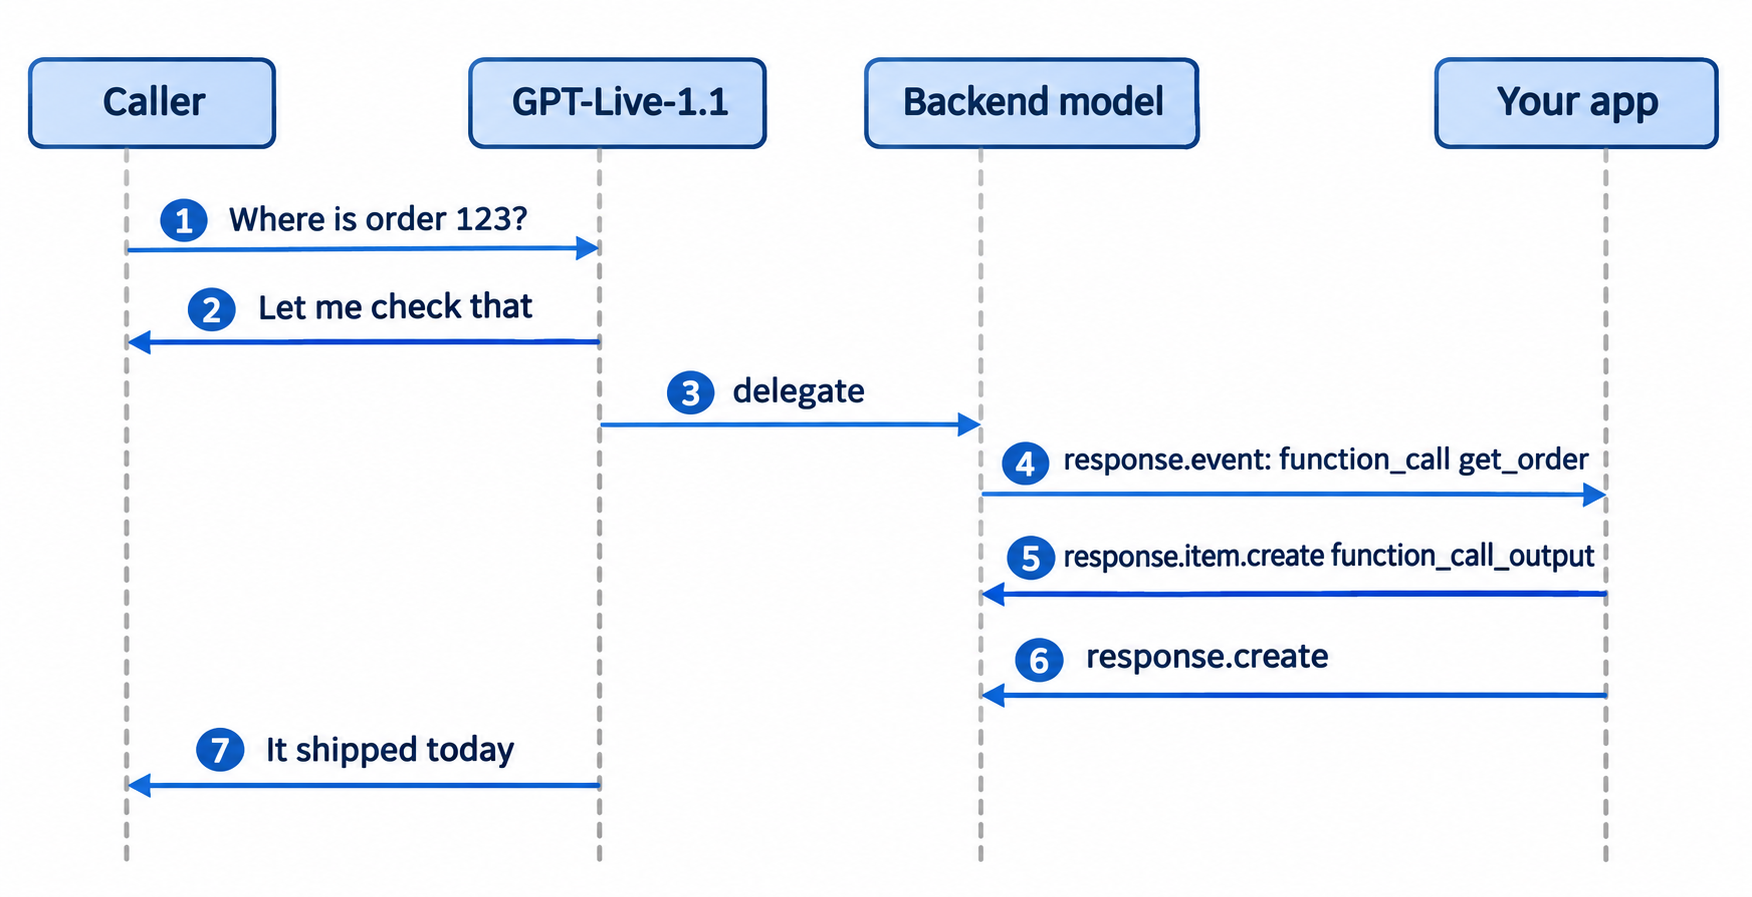
프롬프팅 가이드는 "확인해 보겠습니다"라고 말했다고 해서 백엔드 작업이 시작된 것은 아니라고 경고합니다. 대신 로그에서 session.delegation.created를 확인하세요.
GPT-Live-1.1 세션에 함수 호출 추가하기
웹 검색 같은 호스티드 도구는 OpenAI 내부에서 실행됩니다. 여러분의 함수는 여러분의 앱에서 실행됩니다. 표준 Responses 함수 도구를 delegation.responses.tools에 넣으세요:
{
  "type": "function",
  "name": "get_order",
  "description": "Get the shipping status of an order by its ID.",
  "parameters": {
    "type": "object",
    "properties": { "order_id": { "type": "string" } },
    "required": ["order_id"],
    "additionalProperties": false
  },
  "strict": true
}
백엔드의 이벤트는 delegation_id와 중첩된 event를 담고 있는 response.event 봉투(envelope)에 감싸져 도착합니다. 완료된 함수 호출은 call_id, name, arguments를 가진 항목을 포함하는 중첩된 response.output_item.done으로 도착합니다. 함수를 실행하고, 결과와 함께 response.item.create를 보낸 다음, response.create를 전송하세요:
ws.on("message", async (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type !== "response.event") return;
  const ev = msg.event;
  if (ev.type !== "response.output_item.done" || ev.item?.type !== "function_call") return;

  const { order_id } = JSON.parse(ev.item.arguments);
  const order = await fetch(`${ORDERS_API}/orders/${order_id}`).then((r) => r.json());

  ws.send(JSON.stringify({
    type: "response.item.create",
    item: { type: "function_call_output", call_id: ev.item.call_id, output: JSON.stringify(order) },
  }));
  ws.send(JSON.stringify({ type: "response.create" }));
});
사람들이 자주 실수하는 세 가지 세부 사항:
- 출력만 추가하는 것으로는 백엔드가 재개되지 않습니다.
response.create가 필요합니다. - 대기 중인 결과를 건너뛰면
function_call_outputs_required가 발생합니다. 중복되거나 일치하지 않는call_id값은 거부됩니다. - 전달된
response.completed이벤트는 비어 있는response.output을 담고 있습니다. 개별 output-item 이벤트를 읽으세요.
GPT-Live-1.1 가격과 제한
음성 시간 비용은 계산하기 간단합니다. 전체 시간 동안 활성 상태를 유지하는 5분짜리 고객 지원 통화는 음성 시간으로 5 × $0.05 = $0.25입니다. 이런 통화 천 건이면 $250이고, 여기에 백엔드 모델과 도구가 정상 요금으로 청구하는 비용이 추가됩니다.
| 비용 항목 | 요금 |
|---|---|
| 활성 음성 | 분당 $0.05 |
| 대기 음성 (WebRTC, 추론 일시 중지) | 분당 $0.02 |
| WebRTC 초기화 | 15초, 세션이 실행되면 크레딧으로 반환 |
| 백엔드 모델 및 도구 | 해당 모델과 도구의 정상 요금 |
속도 제한은 토큰이 아닌 동시 세션 수 기준입니다. GPT-Live-1.1과 GPT-Live-1은 별도의 제한을 가지며, 추론 지역 전체에 적용됩니다. GPT-Live-1 페이지에는 Build, Launch, Grow 티어에서 각각 50, 300, 500개의 동시 세션이 가능하다고 나와 있으며, Free 티어에서는 이용할 수 없습니다. 1.1 페이지에는 숫자가 없으므로, 출시 전에 조직의 제한 페이지를 확인하세요.
Apidog CLI로 코딩 에이전트가 도구 백엔드를 테스트하게 하기
음성 에이전트의 신뢰성은 get_order 뒤에 있는 API에 달려 있습니다. 느리거나 형식이 잘못된 응답은 침묵이나, 소리 내어 말하는 잘못된 답변으로 이어집니다. 따라서 발신자가 듣기 전에 그 백엔드를 테스트하세요. 그리고 그 작업을 Apidog CLI로 코딩 에이전트에게 맡길 수 있습니다.
한 번만 설정하세요:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
그런 다음 Claude Code, Codex 또는 Cursor에 프롬프트 하나를 주세요:
Import ./orders-openapi.yaml into Apidog project <projectId>. Create test cases for
GET /orders/{order_id}: a known ID returns 200 with a status field in under 800 ms,
and an unknown ID returns 404 with a JSON error. Run them against the staging
environment and tell me what failed.
에이전트가 스키마를 읽고, 페이로드를 검증하고, 케이스를 만들어 실행합니다:
apidog import --project <projectId> --format openapi --file ./orders-openapi.yaml
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
음성에서는 800 ms 예산이 중요합니다. 도구가 소요하는 모든 밀리초를 발신자가 그대로 들으니까요. 저희의 Apidog CLI CI/CD 가이드에서 보여주듯, -r junit 옵션과 함께 동일한 apidog run을 CI에 넣어 회귀가 발생하면 빌드가 실패하도록 하세요. 에이전트 워크플로가 처음이라면 Claude Code에서의 Apidog CLI부터 시작하세요. Apidog의 Free 플랜은 최대 4명의 사용자까지 지원합니다.
FAQ
GPT-Live-1.1은 API에서 사용할 수 있나요? 네. 2026년 11월 20일부터 WebRTC, WebSocket 또는 SIP로 v1/live/sessions에서 gpt-live-1.1을 호출할 수 있습니다. v1/realtime, v1/responses 또는 Chat Completions에서는 제공되지 않습니다.
GPT-Live-1.1 API는 얼마인가요? 활성 분당 $0.05, 대기 분당 $0.02입니다. 백엔드 모델 호출과 도구는 각자의 요금으로 별도 청구됩니다.
GPT-Live-1.1과 GPT Realtime의 차이는 무엇인가요? GPT-Live는 자체 엔드포인트에서 실행되고, 음성 사용 시간 기준으로 청구되며, 위임을 통해 추론을 백엔드 모델에 넘깁니다. GPT Realtime은 v1/realtime에서 실행됩니다. 저희의 GPT-Live vs GPT Realtime 비교를 참고하세요.
위임에는 어떤 백엔드 모델을 사용해야 하나요? OpenAI의 가이드는 gpt-6-luna로 시작하고 더 복잡한 백엔드 작업에는 gpt-6-sol을 사용하라고 권합니다. 지연 시간이 비용보다 중요하다면 service_tier를 priority로 설정하세요.
Responses 모델 대신 자체 에이전트를 사용할 수 있나요? 네. delegation.type을 client로 설정하세요. 여러분의 앱이 백엔드 작업을 실행하고 session.commentary.append로 결과를 다시 보냅니다. 전사(transcript)도 직접 관리해야 합니다.
GPT-Live-1.1은 함수 호출을 지원하나요? 네, Responses 위임을 통해 지원합니다. delegation.responses.tools에 함수를 정의하고, response.event에서 호출을 읽고, response.item.create와 response.create로 결과를 반환하세요.