
GPT-6.2 Astra와 Claude Fable 5.2의 비교는 결국 이렇게 요약됩니다. 두 모델 모두 입력 토큰 100만 개당 $8, 출력 토큰 100만 개당 $40의 비용이 들고, 약 100만 토큰의 컨텍스트와 128K 출력을 제공하며, 모두 긴 에이전트 코딩 작업을 겨냥하고 있습니다. 선택을 좌우하는 차이점은 캐시 가격, 긴 컨텍스트 과금 방식, 에이전트 하니스가 처리해야 하는 API의 특이 사항, 그리고 각 모델이 실제 여러분의 작업에서 보여주는 동작입니다.
OpenAI는 2026년 11월 17일 GPT-6.2 Astra를 출시했으며, 이는 Anthropic이 Claude Fable 5.2를 출시한 지 8일 후였습니다. 이 가이드에서는 두 모델의 사양, 실제 에이전트 세션의 비용, 반대쪽 모델용으로 만들어진 하니스를 깨뜨릴 수 있는 요청 오류, 그리고 Apidog CLI로 두 모델을 테스트하는 방법을 다룹니다.
GPT-6.2 Astra vs Claude Fable 5.2: 한눈에 보는 결론
에이전트가 긴 프롬프트를 보내고 큰 캐시된 컨텍스트를 반복해서 읽는다면 Claude Fable 5.2를 선택하세요. 캐시 읽기 비용이 절반이고 전체 1M 윈도우가 표준 요금으로 과금되기 때문입니다. 스택이 이미 OpenAI Responses API 기반이고 apply_patch, 호스티드 셸, 멀티 에이전트 서브에이전트 같은 호스티드 도구를 활용하고 싶다면 GPT-6.2 Astra를 선택하세요. 그 외의 경우에는 커밋하기 전에 실제 여러분의 작업으로 두 모델을 모두 테스트해 보세요.
초기 리뷰들은 순수 성능 면에서 Fable 쪽으로 기울고 있습니다. Simon Willison은 출시 당일 Astra가 “여러 벤치마크에서 Fable 5.2만큼 높은 점수를 내지 못한다”고 언급했고, 일부 테스터들은 Astra의 커뮤니케이션 스타일이 혼란스럽다고 느꼈습니다. 이를 최종 판단이 아니라 테스트해 볼 이정표로 삼으세요.
GPT-6.2 Astra와 Claude Fable 5.2의 사양과 가격은 어떻게 다를까?
두 모델의 기본 가격은 동일하므로 비교의 초점은 세부 사항에 있습니다. 아래의 모든 수치는 2026년 11월 18일 기준으로 GPT-6.2 Astra 모델 페이지와 Claude Fable 5.2 개요에서 확인한 것입니다.
| 사양 | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| API 모델 ID | gpt-6.2-astra |
claude-fable-5-2 |
| 출시일 | 2026년 11월 17일 | 2026년 11월 9일 |
| 입력 / 출력 (100만 토큰당) | $8 / $40 | $8 / $40 |
| 캐시된 입력 (캐시 읽기) | $0.40 | $0.20 |
| 캐시 쓰기 | $10 (30분), $20 (12시간) | $10 (5분), $16 (1시간) |
| 컨텍스트 윈도우 | 1,050,000 (최대 입력 922,000) | 1M |
| 최대 출력 | 128,000 | 128K |
| 긴 프롬프트 | 입력 272K 초과 시: 입력 2배, 출력 1.5배 | 전체 1M을 표준 가격으로 |
| 배치 | 50% 할인 | 50% 할인 |
| 지식 기준 시점 | 2026년 5월 18일 | 2026년 6월 |
| 추론 제어 | reasoning.effort (none은 거부됨) |
effort, 기본값 high, thinking 항상 켜짐 |
두 모델 모두 이전 세대 대비 20% 가격이 인하되었습니다. Willison이 언급했듯이 GPT-6 Astra와 Claude Fable 5는 모두 $10 / $50이었습니다. 아직 이전 모델을 사용 중이라면 GPT-6 Astra API 가이드와 Claude Fable 5.2 가격 분석에서 무엇이 달라졌는지 확인할 수 있습니다.
코딩 에이전트 세션의 실제 비용은 얼마일까?
코딩 에이전트는 짧은 프롬프트 하나만 보내는 경우가 드뭅니다. 매 턴마다 저장소 컨텍스트, 도구 정의, 대화 기록을 다시 불러오기 때문에 표면적인 가격보다 캐시 읽기와 긴 프롬프트 규칙이 비용에 더 큰 영향을 미칩니다.
다음은 공식 요금표를 기준으로 Standard 처리 방식에서 산출한 두 가지 샘플 워크로드의 비용입니다.
| 워크로드 | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| 에이전트 세션: 캐시에 150K 토큰 쓰기, 캐시 읽기 1.35M, 출력 150K (모든 요청이 272K 미만) | $1.50 + $0.54 + $6.00 = $8.04 | $1.50 + $0.27 + $6.00 = $7.77 |
| 단일 긴 요청: 입력 400K, 출력 8K, 캐시 없음 | $6.40 + $0.48 = $6.88 | $3.20 + $0.32 = $3.52 |
세션 비용이 비슷한 이유는 출력이 비용의 대부분을 차지하기 때문입니다. 두 모델 모두 출력 150K 토큰에 $6.00이 듭니다. 캐시 읽기 격차가 여기서는 27센트를 아끼지만, 세션이 길어질수록 그 차이는 커집니다.
단일 긴 요청에서야 비용이 크게 벌어집니다. Astra 요청이 입력 272K 토큰을 넘어서면 OpenAI는 해당 요청 전체에 대해 입력 요금을 $16로 두 배로 올리고 출력 요금을 $60로 인상합니다. 반면 Fable 5.2는 400K 프롬프트를 4K 프롬프트와 동일한 $8 요금으로 청구합니다.
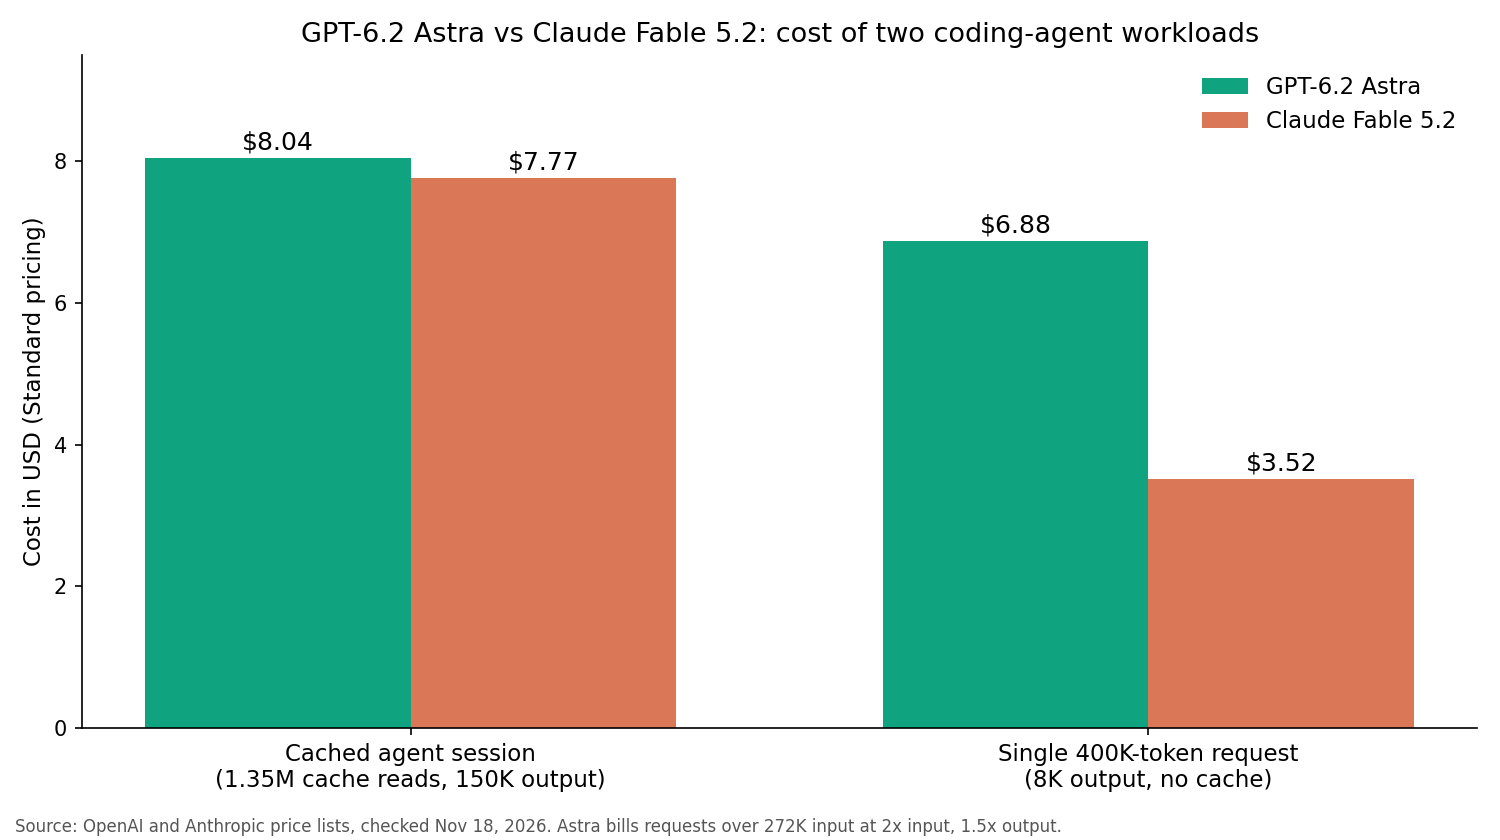
에이전트가 대규모 모노레포나 긴 로그를 하나의 요청에 담는다면, Astra에서는 272K 미만으로 유지하거나 거의 두 배의 비용을 지불할 각오를 해야 합니다.
어떤 API 특이 사항이 반대쪽 모델용으로 만들어진 하니스를 깨뜨릴까?
모델을 바꾸는 일은 모델 문자열만 바꾸는 것 이상입니다. 각 API는 상대방이 받아들이는 설정을 거부하며, 두 경우 모두 HTTP 400 오류로 돌아옵니다.
Claude Fable 5.2가 거부하는 것:
- 강제 도구 사용.
tool_choice를any또는tool로 설정하면 Anthropic의 Fable 5.2 노트에 따라 400 오류가 반환됩니다. - 샘플링 파라미터.
temperature,top_p,top_k는 생략해야 합니다. Anthropic이 나열한 값들을 보내면 400 오류가 반환됩니다. - thinking 끄기. 적응형 thinking은 항상 켜져 있으므로 effort 파라미터만이 깊이, 지연 시간, 비용을 조절하는 유일한 수단입니다.
GPT-6.2 Astra가 거부하는 것:
reasoning.effort를none으로 설정 (Responses API) 또는reasoning_effort: "none"(Chat Completions). OpenAI의 추론 가이드에 따름.- Realtime, Assistants, fine-tuning 엔드포인트. 모델 페이지에서 지원되지 않는 것으로 표시됨.
하니스가 구조화된 출력을 얻기 위해 도구 호출을 강제한다면, Astra에서는 작동하지만 Fable에서는 실패합니다. 구조를 프롬프트나 도구 스키마로 옮기세요. temperature: 0을 설정한다면 Fable에서는 이를 제거해야 합니다.
데이터 처리 방식도 다릅니다. Anthropic에 따르면 Fable 5.2는 30일 데이터 보존이 필요하며, Anthropic이 명시적으로 승인하지 않는 한 제로 데이터 보존 옵션으로는 사용할 수 없습니다. 프로덕션 코드를 이 모델로 라우팅하기 전에 보안 정책과 대조해서 확인하세요.
GPT-6.2 Astra가 우위를 점하는 부분은?
Astra의 강점은 그 모델을 둘러싼 도구 상자입니다. Responses API에서 OpenAI는 apply_patch, hosted_shell, computer_use, code_interpreter, mcp, skills, tool_search를 지원 도구로 나열하고 있습니다. 멀티 에이전트 베타를 통해 Astra가 작업을 서브에이전트에게 위임할 수도 있습니다.
직접 패치 적용기와 셸 러너를 만들고 싶지 않다면 이것이 큰 의미를 갖습니다.
Willison이 인용한 Theo Browne의 사전 출시 피드백에 따르면, Astra는 긴 작업에서 “많은 서브에이전트를 불러들여 꽤 잘 관리할 수 있지만”, 사용자가 답할 수 없는 내부 세부 사항에 대해 질문하며 멈추는 경우가 종종 있다고 합니다. 명확한 중단 조건을 제공하세요.
Astra는 더 다양한 비용 등급도 제공합니다. 50% 할인된 Batch, Standard의 2배인 Fast 모드, 그리고 Standard보다 각각 30%와 40% 저렴한 2시간 및 8시간 완료 백그라운드 윈도우가 있습니다. 하룻밤 사이에 돌리는 테스트 생성은 이 등급들을 활용하면 더 저렴하게 실행할 수 있습니다.
Claude Fable 5.2가 우위를 점하는 부분은?
Fable은 길고 캐시 의존도가 높은 컨텍스트에서 강세를 보입니다. 캐시 읽기 비용이 토큰 100만 개당 $0.20, 즉 입력 가격의 2.5%에 불과하고, 전체 1M 윈도우가 긴 프롬프트 배수 없이 표준 요금으로 청구됩니다.
Anthropic은 Fable 5.2를 수 시간 동안 실행되는 에이전트 세션용으로 포지셔닝하고 있습니다. effort 제어는 low부터 max까지 가능하며, Anthropic은 기본값인 high에서 시작해 측정상 이득이 확인되는 경우에만 xhigh로 올리라고 권장합니다.
어려운 창의적 코딩 작업에서도 초기 반응이 더 좋습니다. Willison의 출시 테스트에서, Codex CLI에서 Ultra effort로 두 개의 새 OpenAI 모델에 Three.js 애니메이션 프롬프트를 실행했지만 어느 쪽도 Fable 5.2에서 얻은 결과를 따라가지 못했습니다.
Fable은 Amazon Bedrock, Google Cloud, Microsoft Foundry에서도 실행되며, Fast 모드는 토큰 100만 개당 $16 / $80의 비용으로 최대 2.5배 높은 출력 속도를 제공합니다. 요청 예제는 Claude Fable 5.2 API 가이드를 참고하세요.
자신의 API 워크로드로 GPT-6.2 Astra와 Claude Fable 5.2를 테스트하는 방법은?
벤치마크는 남의 작업을 측정합니다. 대신 동일한 프롬프트를 두 API에 모두 실행해 보세요:
- 에이전트 기록에서 버그 수정, 리팩토링, 테스트 작성 같은 실제 프롬프트 5~10개를 고르세요.
- 각 모델별로 내용이 동일한 요청을 각 API의 고유 형식으로 작성하세요.
- 200 상태 코드, 비어 있지 않은 답변, 에이전트가 파싱하는 응답 형태를 검증(assert)하세요.
- 각 요청을 여러 번 실행하고 토큰 수, 지연 시간, 통과율을 비교하세요.
두 호출 모두 일반 HTTP입니다. 다음은 Responses API에서의 Astra 요청입니다:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6.2-astra", "reasoning": {"effort": "high"},
       "input": "Review this diff and list the bugs."}'
Fable 5.2는 Anthropic의 Messages API를 통해 claude-fable-5-2 모델로 호출하며 temperature 필드는 넣지 않습니다.
코딩 에이전트가 Apidog CLI로 A/B 테스트를 실행하게 하기
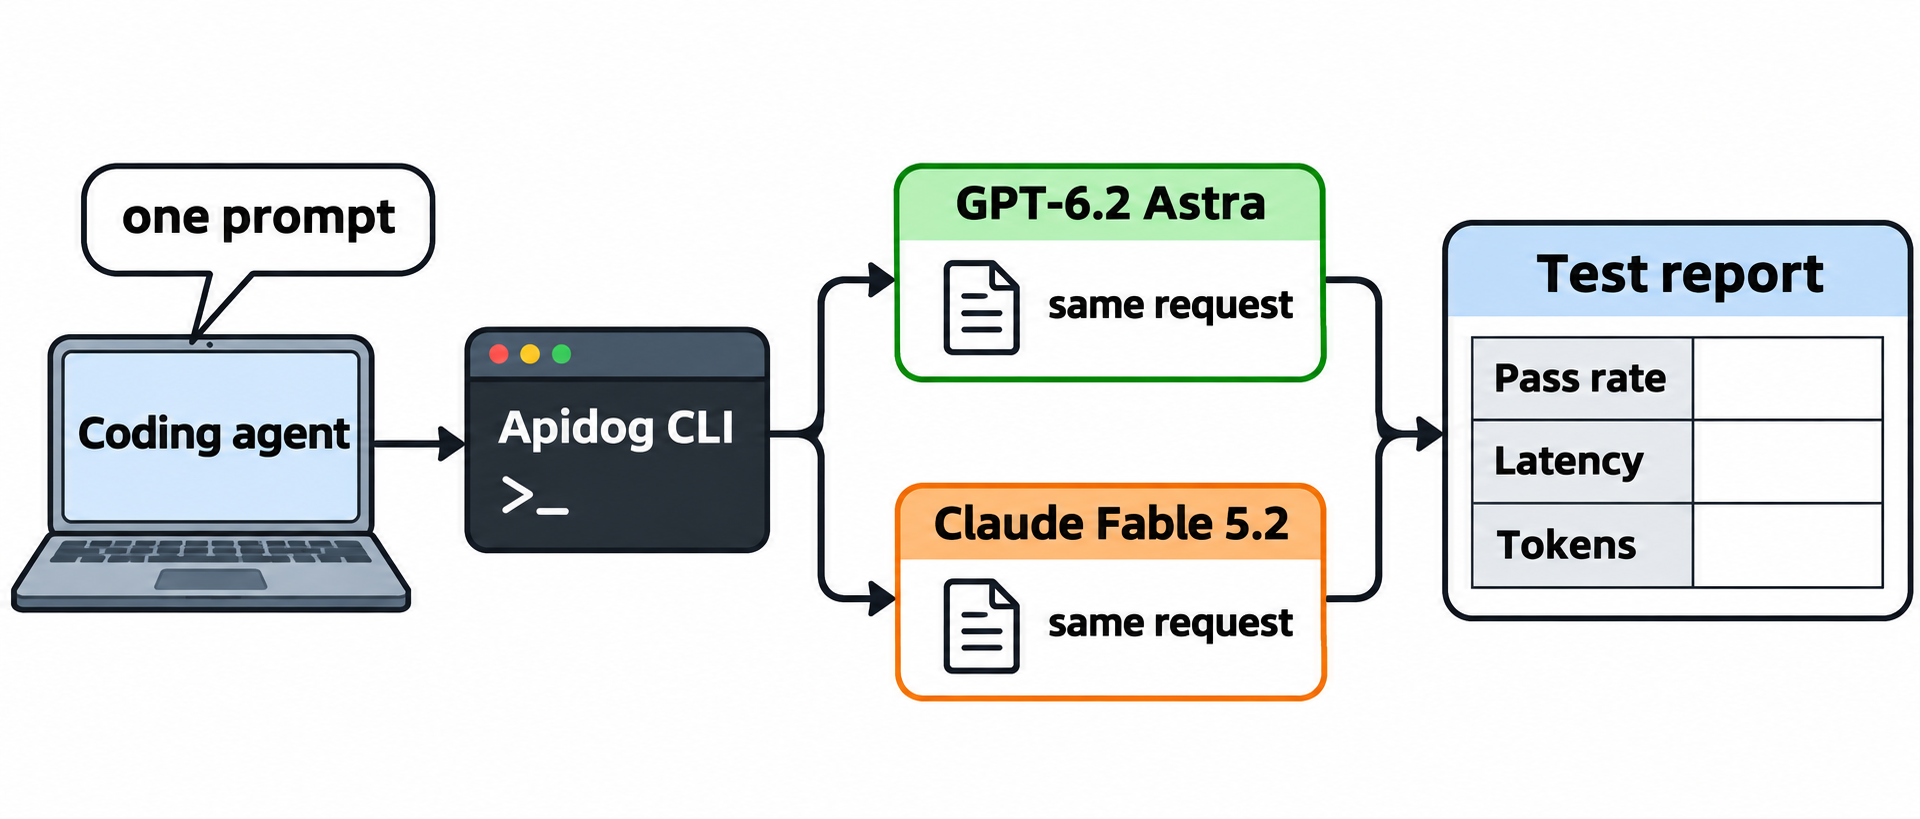
요청 쌍을 손으로 실행하는 일은 금방 지겨워집니다. 대신 Claude Code, Codex 또는 Cursor가 Apidog CLI를 조종하게 하세요. 설정은 명령 세 개면 충분합니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 에이전트에게 프롬프트 하나를 주세요:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gpt-6.2-astra through the OpenAI Responses
API, and one that sends the same prompt to claude-fable-5-2 through
the Claude Messages API with no temperature field. Keep both API keys
in private environment variables. Assert a 200 status and a non-empty
answer, record token usage and response time, run each case 5 times
and summarize cost per run. Validate every payload before you write it.
에이전트가 페이로드 스키마를 확인하고, 테스트 케이스를 작성하고, 실행합니다. 아래 플래그들은 CLI 2.2.12의 apidog run --help에서 가져온 것입니다:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <ASTRA_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5는 각 케이스를 다섯 번 반복하므로, 느린 응답 하나가 결과를 좌우하지 않습니다. --upload-report를 추가하면 Apidog 앱에서 실행 결과를 볼 수 있습니다. 이것은 워크플로우 템플릿이며, 이 문서 작성 시점에는 이 머신에서 Astra에 대해 실행해 보지 않았습니다.
앞서 다룬 API 특이 사항 섹션도 테스트로 만들 수 있습니다. tool_choice: any를 Fable에 보내 400을 기대하는 부정 케이스와, effort: none을 Astra에 보내 400을 기대하는 부정 케이스를 에이전트에게 요청하세요. 어느 쪽 프로바이더든 규칙을 바꾸면 에이전트보다 먼저 테스트 스위트가 알려줄 것입니다. 에이전트 설정 방법은 Claude Code에서 Apidog CLI 사용 가이드와 Codex에서 Apidog CLI 사용 가이드를 참고하세요.
Apidog의 Free 플랜은 최대 4명의 사용자를 지원하므로 이 비교를 실행하기에 충분합니다.
FAQ
GPT-6.2 Astra가 Claude Fable 5.2보다 저렴한가요? 기본 가격은 토큰 100만 개당 입력 $8, 출력 $40으로 동일합니다. Fable은 캐시 읽기($0.20 vs $0.40)와 입력 272K를 초과하는 모든 요청, 즉 Astra가 입력 요금을 두 배로 올리는 구간에서 더 저렴합니다.
어느 모델의 컨텍스트 윈도우가 더 큰가요? Astra는 컨텍스트 1,050,000 토큰에 입력 상한이 922,000 토큰입니다. Fable 5.2는 1M 토큰입니다. 두 모델 모두 요청당 출력 상한은 128K 토큰입니다.
Claude Fable 5.2에서 강제 도구 호출을 사용할 수 있나요? 아니요. tool_choice를 any 또는 tool로 설정하면 400 오류가 반환됩니다. 모델이 스스로 도구를 선택하게 하고, 기대하는 구조는 프롬프트나 도구 스키마에 설명하세요.
GPT-6.2 Astra에서 추론을 끌 수 있나요? 아니요. API는 reasoning.effort가 none으로 설정되면 400 오류를 반환합니다. 빠르고 저렴한 호출이 필요하다면 지원되는 더 낮은 effort 레벨을 선택하세요.
코딩 에이전트는 어느 모델에서 돌려야 하나요? 먼저 자신의 워크로드를 보세요. 길고 캐시 의존도가 높은 프롬프트는 Fable 5.2에 유리하고, 호스티드 패치, 셸, 서브에이전트 도구를 원하는 OpenAI 네이티브 스택은 Astra에 유리합니다. 전환하기 전에 실제 프롬프트 5~10개로 두 모델을 모두 테스트해 보세요.