
Z.ai는 이제 거의 같은 이름, 동일한 1M 토큰 컨텍스트 창, 그리고 9배의 가격 차이를 가진 두 가지 모델을 판매합니다. 이름만으로는 선택에 도움이 되지 않습니다. "Flash"는 더 작고, 빠르며, 약한 변형을 의미하지만, 이 세 단어 중 정확한 것은 하나뿐입니다.
간단히 말하자면, GLM-5.3-Flash는 더 저렴하고, 이미지를 기본적으로 처리하며, 코딩 플랜 사용자에게는 3배의 할당량을 제공합니다. GLM-5.3은 약간 더 스마트하고 거의 두 배 빠르게 생성합니다. 대부분의 워크로드에서 Flash가 올바른 기본값이며, 비싼 모델을 선택하는 경우에는 그 타당성을 입증해야 합니다.
이 게시물은 해당 규칙이 깨지는 지점을 설명합니다.
비교표
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| 지능 지수 (인공 분석) | 57 | 60 |
| 1M 토큰당 혼합 가격 | $0.10 | $0.90 |
| 1M당 입력 / 출력 리스트 | $0.15 / $0.50 | $1.40 / $4.40 |
| 출력 속도 | 초당 약 49 토큰 | 초당 약 86 토큰 |
| 첫 토큰까지의 시간 | 1.52초 | 1.57초 |
| 컨텍스트 창 | 1,048,576 | 1,048,576 |
| 네이티브 이미지 입력 | 예 | 아니요, 어댑터 기반 |
| 매개변수 | 총 320B / 활성 18B | 더 큼, 완전히 공개되지 않음 |
| 라이선스 | MIT, 오픈 웨이트 | 오픈 웨이트 |
| 코딩 플랜 할당량 | 3배 | 1배 |
속도 및 지능 수치는 인공 분석 측정치입니다. 가격은 아래에서 논의할 출시 할인 전 Z.ai의 정가입니다.
9배의 가격 차이가 발생하는 이유
GLM-5.3-Flash는 하이브리드 선형 및 희소 어텐션(attention)을 갖춘 새로운 기반 위에 구축된 320B 규모의 전문가 혼합 모델로, 토큰당 18B 매개변수를 활성화합니다. Z.ai는 GLM-5.3보다 어텐션 계산량이 약 3배 적고 KV 캐시 크기가 약 4.4배 작다고 보고합니다.
KV 캐시 크기는 긴 컨텍스트 서비스를 비싸게 만드는 요인입니다. 4.4배 감소는 Z.ai가 1M 토큰 창을 10분의 1 가격으로 제공할 수 있는 주요 이유입니다. 더 짧은 컨텍스트나 약한 모델에 대해 더 적은 비용을 지불하는 것이 아닙니다. 요청당 서비스 발자국(serving footprint)이 실제로 더 작기 때문에 더 적은 비용을 지불하는 것입니다.
이는 프로모션 할인이 아닌 실제 엔지니어링 결과이며, 이는 가격 유지 여부에 중요합니다.
3점 지능 차이가 의미하는 것
인공 분석 지능 지수에서 57점 대 60점은 절대적인 측면에서 좁은 차이입니다. 비교를 위해, 비슷한 크기의 중간 오픈 웨이트 모델은 27점을 기록하므로, 이 두 모델 모두 해당 분야를 훨씬 상회합니다.
하지만 3점은 무시할 수 없는 차이입니다. 이 정도 크기의 지수 차이는 일반적으로 다음과 같이 나타납니다: 다단계 추론 체인에서 약간 더 나쁜 성능, 매우 긴 에이전트 작업에서 약간 더 많은 드리프트, 모호한 지침에 대한 더 높은 민감도. 이는 간단한 추출, 분류, 요약 또는 단일 파일 코드 편집에서는 거의 나타나지 않습니다.
실용적인 테스트는 작업에 검증 가능한 답변이 있는지 여부입니다. 출력을 프로그램적으로 확인할 수 있다면, Flash의 가끔 발생하는 오류는 저렴하게 찾아내고 저렴하게 재시도할 수 있으며, 9분의 1 가격으로 많이 재시도할 수 있습니다. 작업이 사람이 읽고 판단해야 하는 산문(prose)을 생성하는 경우, 품질 차이는 회복하기 더 어렵고 가격 차이는 결과보다 덜 중요합니다.
속도는 Flash가 실제로 지는 유일한 부분입니다
이 부분은 이름이 역설적입니다. GLM-5.3은 초당 약 86토큰을 생성합니다. GLM-5.3-Flash는 약 49토큰을 생성합니다. 더 크고 비싼 모델이 출력을 생성하는 데 거의 두 배 빠릅니다.
첫 토큰까지의 시간은 1.52초 대 1.57초로 사실상 같으므로, 둘 다 응답 시작 시에 동일하게 반응성을 느낍니다.
결과는 전적으로 출력 길이에 따라 달라집니다:
- 짧은 응답. 무관합니다. 둘 다 약 1.5초 만에 시작하고 누구도 처리량 차이를 알아차리기 전에 완료됩니다.
- 긴 생성. 4,000토큰 응답은 Flash에서 약 82초, GLM-5.3에서 약 47초가 걸립니다. 대화형 도구에서는 의미 있는 차이입니다.
- 동시성을 가진 배치 작업. 또한 거의 무관합니다. 스트림당 속도보다는 병렬 요청으로 확장하기 때문이며, 가격 차이는 많은 병렬성을 제공합니다.
기다리는 사람에게 장문의 출력을 스트리밍하는 경우 GLM-5.3이 더 나은 경험을 제공합니다. 이는 9배 더 많은 비용을 지불하는 가장 확실한 경우입니다.
멀티모달리티가 진정한 구분선입니다
GLM-5.3-Flash는 텍스트와 동일한 채팅 완료 요청에서 이미지, 비디오 및 파일을 콘텐츠 블록으로 허용합니다. GLM-5.3은 이를 기본적으로 수행하지 않으며, 비전은 별도의 어댑터를 통해 처리됩니다.
애플리케이션이 무언가를 봐야 하는 경우, 이것은 비교가 아니라 요구 사항입니다. Flash는 한 번의 호출, 한 번의 컨텍스트 창, 한 번의 청구 라인에서 이를 수행하는 유일한 모델입니다.
이 기능은 이 모델군에서 진정으로 새로운 방식으로 1M 컨텍스트와 결합됩니다: 긴 사양 문서와 빌드된 결과의 스크린샷이 동일한 프롬프트에 포함될 수 있습니다. Z.ai 자체 포지셔닝은 인터페이스 관찰 및 결과 렌더링에 대해 이야기하며, 이는 이미지 캡셔닝보다는 코딩 에이전트 프레임워크입니다.
저희의 비전 가이드는 페이로드와 워크플로우를 다룹니다. 해당 경로를 기반으로 구축된 것을 유지 관리하는 경우, 이전 전용 비전 모델은 GLM-5V-Turbo의 API 가이드에 설명되어 있습니다.
코딩 플랜 관점
GLM 코딩 플랜 구독자에게는 계산이 다르면서도 더 간단합니다. Flash는 플랜에 포함되어 있으며 GLM-5.3보다 사용 가능한 할당량이 3배 더 많다고 보고됩니다. Z.ai는 또한 비수기 호출이 표준 포인트의 절반을 소모한다고 언급합니다.
플랜 할당량에 대해 Claude Code 또는 Cline을 실행하는 경우, 3점 지수 하락에 대해 3배 더 많은 요청은 일상적인 작업에 쉬운 거래입니다. 어려운 문제에는 GLM-5.3을 유지하고 Flash가 볼륨을 처리하도록 하십시오. 두 하니스 모두 설정은 저희 Claude Code 및 Cline 가이드에 있습니다.
플랜 조건은 모델 사양보다 더 자주 변경되므로, 계획을 세우기 전에 z.ai에서 할당량 승수를 확인하십시오.
가격 마감일
GLM-5.3-Flash에 대한 50% 출시 할인은 2026년 9월 9일까지 적용됩니다. 그때까지 유효 요금은 100만당 입력 $0.075 및 출력 $0.25이며, 이는 GLM-5.3과의 가격 차이를 대략 18배로 확대합니다.
할인이 만료된 후에는 정가인 $0.15 및 $0.50가 적용되어 차이가 약 9배로 돌아갑니다. 어떤 경우든 Flash는 극적으로 저렴합니다. 마감일은 비용 예상치를 확정하는 데 중요하며, 두 모델 간의 선택에는 영향을 미치지 않습니다. 저희 가격 분석에는 계산된 수치가 있습니다.
결정 규칙
다음 경우 GLM-5.3-Flash를 사용하십시오:
- 입력에 이미지, 비디오 또는 파일이 포함될 때.
- 토큰당 비용이 최적화하려는 제약 조건일 때.
- 대량의 추출, 분류 또는 라우팅 작업을 실행할 때.
- 코딩 플랜을 사용하고 할당량을 더 오래 사용하고 싶을 때.
- 자체 호스팅할 수 있는 MIT 라이선스 오픈 웨이트를 원할 때. 로컬에서 실행하기는 하드웨어에 대한 내용을 다룹니다.
다음 경우 GLM-5.3을 사용하십시오:
- 기다리는 사람에게 긴 응답을 스트리밍하고 처리량이 체감되는 경험일 때.
- 작업이 장기적인 추론이며 3점의 지수 차이가 단계별로 누적될 때.
- 출력 품질이 테스트로 확인되기보다는 사람이 판단할 때.
두 모델 모두 사용 시: 라우팅이 가능한 경우. 대부분의 트래픽은 Flash로 보내고, 실패, 낮은 신뢰도 또는 작업 유형에 따라 GLM-5.3으로 에스컬레이션하십시오. 9배의 가격 차이는 라우터를 구축할 가치를 만들고, 두 모델 모두 동일한 OpenAI 호환 엔드포인트 뒤에 있으므로 라우팅은 통합이 아니라 모델 ID 스왑에 가깝습니다.
모델 간 마이그레이션
이미 GLM-5.3을 사용 중이고 전환을 고려 중이라면, 기계적인 부분은 사소하고 검증 부분이 핵심 작업입니다.
변경되지 않는 것. 기본 URL, 인증 체계, 요청 및 응답 형태, 스트리밍 의미론, 도구 호출 스키마. 두 모델 모두 동일한 OpenAI 호환 인터페이스 뒤에 있습니다. 스왑은 모델 ID 문자열입니다.
변경되는 것. 호출당 비용이 약 9배 감소합니다. 생성 속도는 약 절반으로 느려집니다. 추론 품질은 3점의 지수만큼 변동됩니다. 그리고 이전에는 사용할 수 없었던 이미지 입력을 얻게 됩니다.
커밋하기 전에 확인할 사항. 실제 프롬프트를 두 모델 모두에서 실행하고 네 가지 축에서 비교하십시오: 검증 가능한 경우의 출력 정확성, 첫 토큰뿐만 아니라 생성 시간을 포함한 종단 간 지연 시간, 각 응답의 `usage` 객체에서 토큰 수, 그리고 가장 긴 현실적인 컨텍스트에서의 동작.
네 번째 항목에서 가장 많은 문제가 발생합니다. 짧은 프롬프트에서는 동등해 보이는 모델도 컨텍스트가 가득 차면 눈에 띄게 달라질 수 있으며, 벤치마크 표는 사용자 자신의 데이터에 대해 결코 알려주지 않습니다.
기본 모델부터 시작했다면, GLM-5.3은 무엇인가에서 자체적으로 설명하고, GLM-5.3 API 가이드에는 마이그레이션하려는 설정이 있습니다.
표를 믿기보다는 테스트하십시오
위의 모든 수치는 벤더의 주장이나 다른 사람의 워크로드에서 실행된 제3자 벤치마크입니다. 어느 것도 이 두 모델이 사용자 프롬프트에서 어떻게 작동하는지 알려주지 않습니다.
스왑은 하나의 문자열입니다. OpenAI 호환 클라이언트를 `https://api.z.ai/api/paas/v4/`로 지정하고, 실제 프롬프트를 `glm-5.3-flash`와 `glm-5.3`에서 실행하여, 중요한 트래픽에 대한 출력, 지연 시간 및 토큰 수를 비교하십시오. API 가이드에 설정 방법이 있습니다.
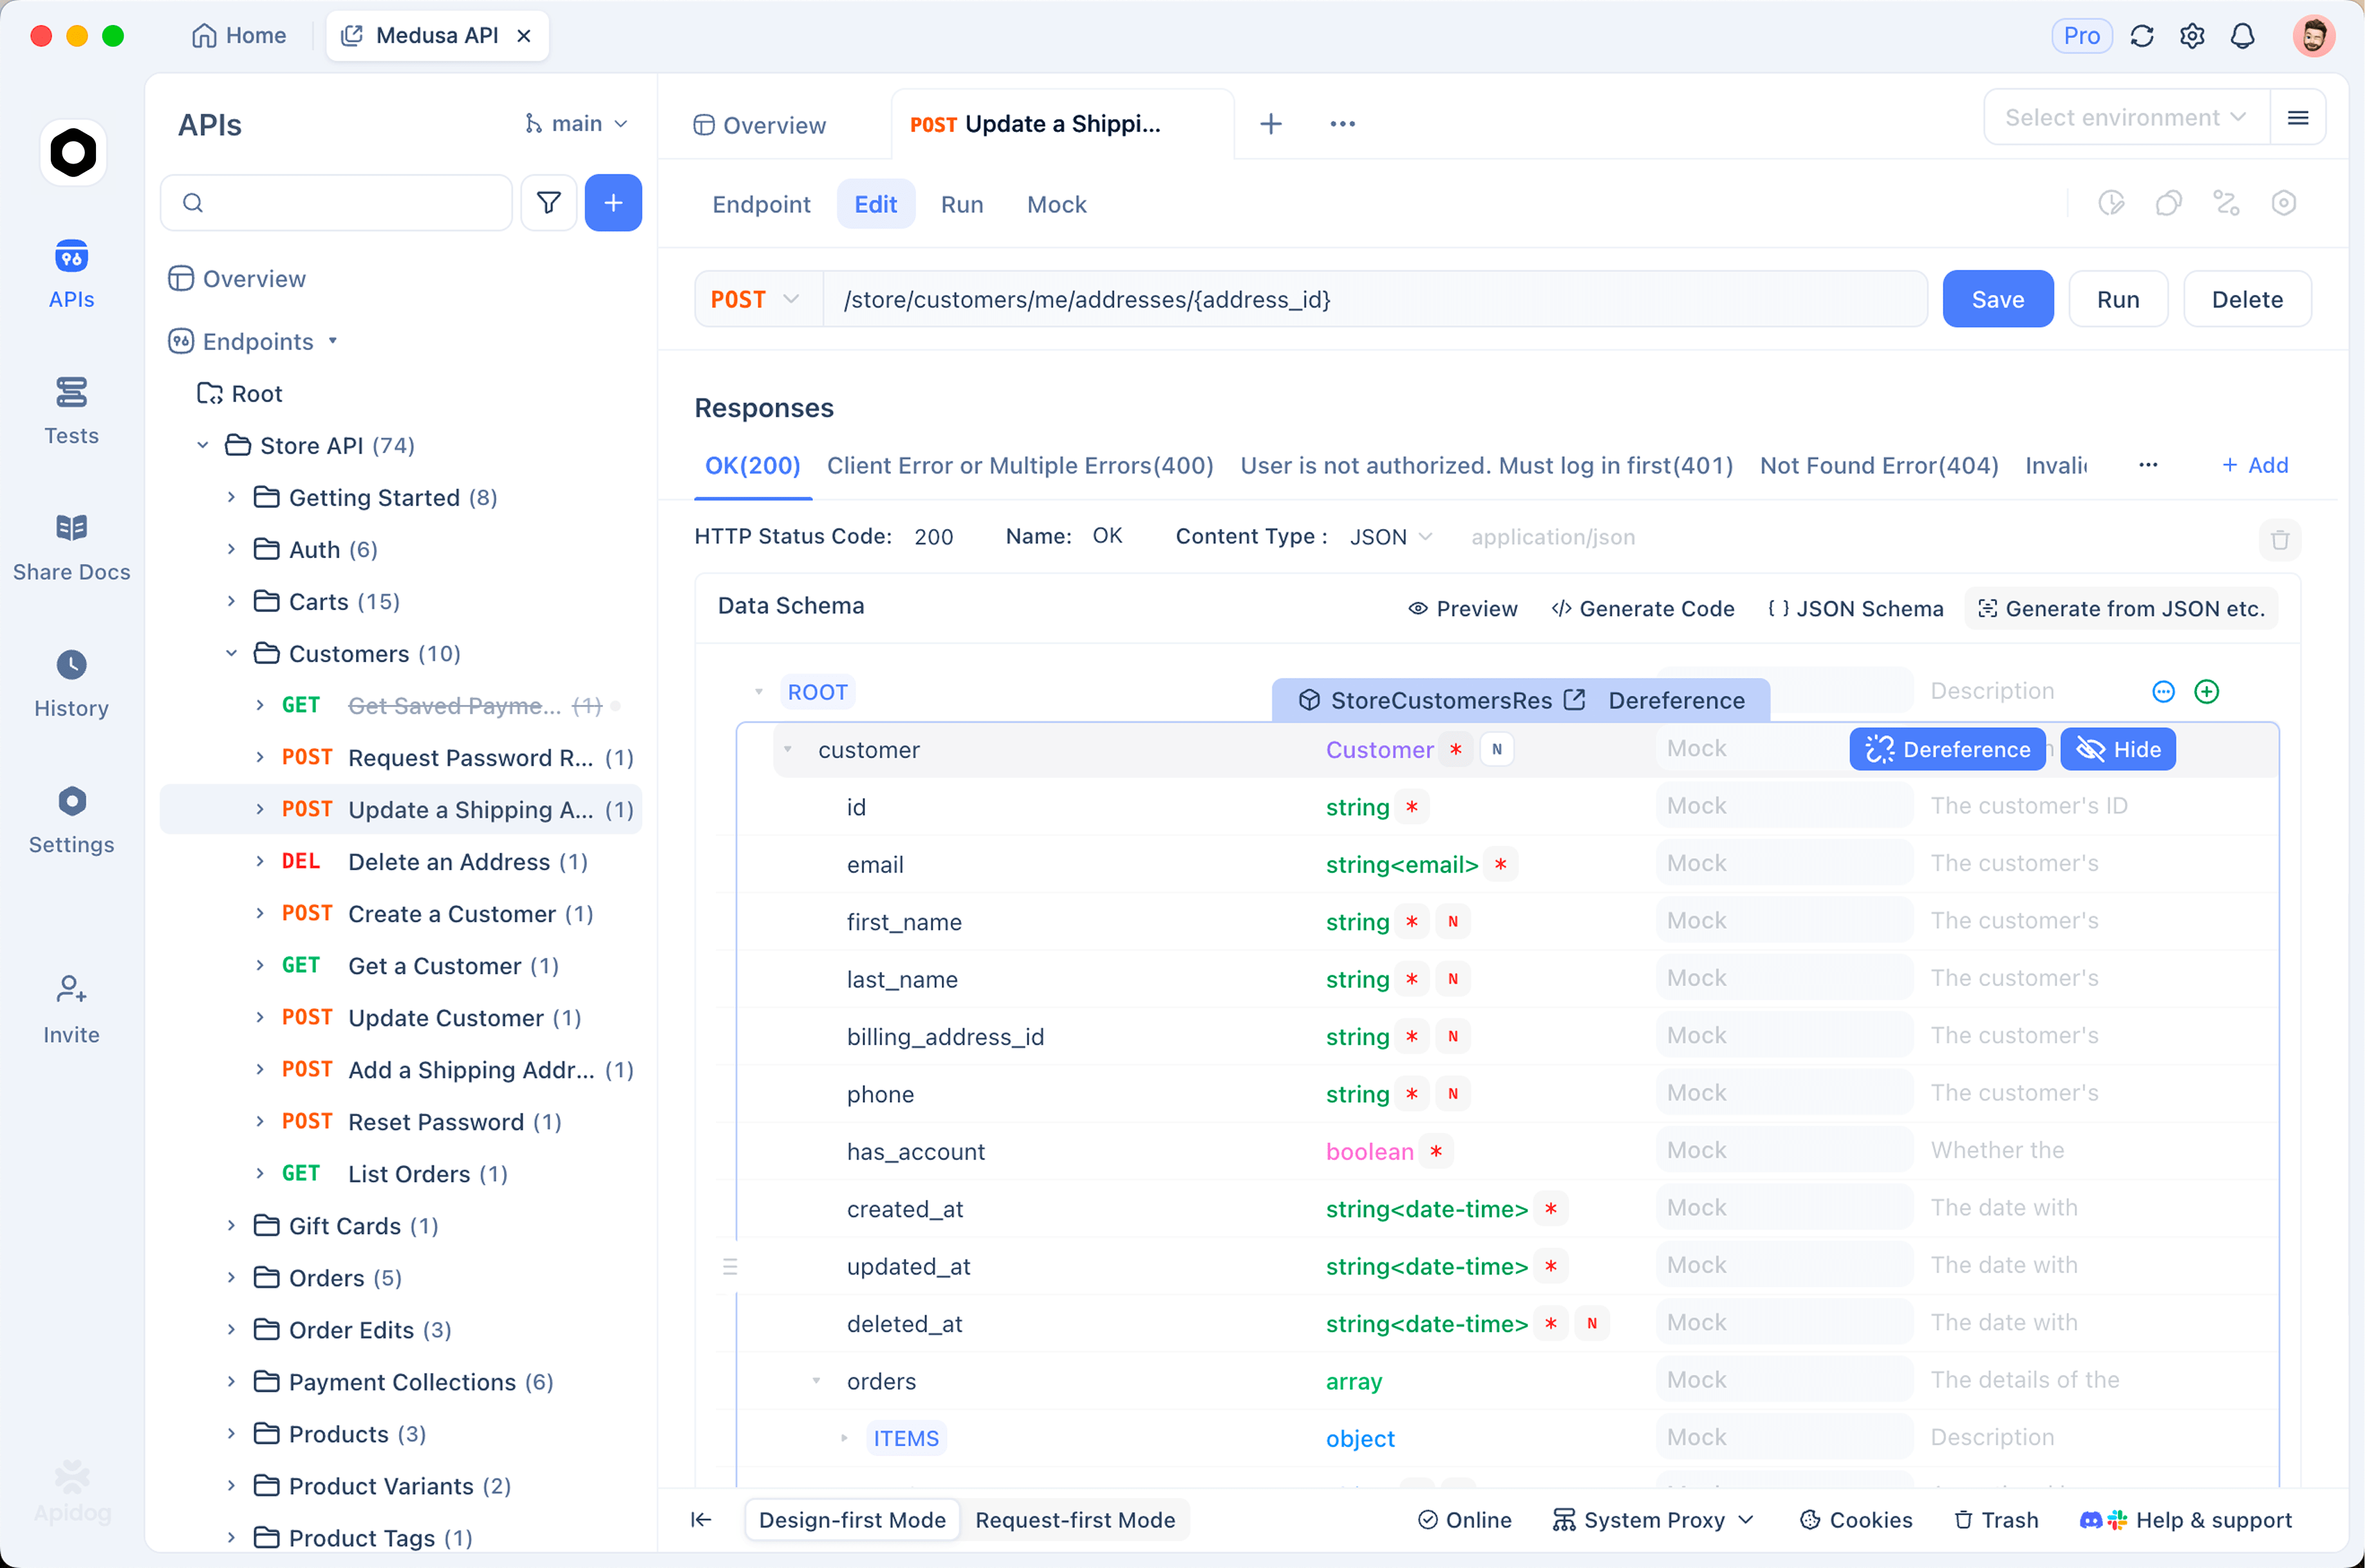
이것이 비교를 반복 가능한 스위트로 저장하는 것이 유용한 지점입니다. Apidog에서는 모델 ID를 환경 변수로 사용하여 두 호출을 한 컬렉션에 보관하고, 애플리케이션이 읽는 필드에 어설션을 첨부한 다음, 할인이 만료되거나 Z.ai가 다음 개정판을 출시할 때 전체를 다시 실행할 수 있습니다. 30초 안에 다시 테스트할 수 있는 모델 선택은 다시 검토할 수 있는 결정이지만, 셸 기록에만 남아있는 것은 그렇지 않습니다.
자주 묻는 질문
GLM-5.3-Flash는 GLM-5.3의 더 작은 버전인가요? 아닙니다. 이는 증류(distillation)나 가지치기(pruned) 변형이 아니라, 다른 어텐션 아키텍처를 가진 별도로 훈련된 기본 모델입니다.
컨텍스트 창이 동일한가요? 예, 둘 다 1,048,576 토큰입니다.
코딩에 어느 것이 더 좋나요? Flash는 Z.ai에 따르면 Terminal-Bench 2.1에서 84.3점, DeepSWE에서 63.4점으로 강력합니다. GLM-5.3은 일반 추론에서 약간 더 강력합니다. 코딩 플랜 사용자에게는 3배의 할당량이 일반적으로 결정을 좌우합니다.
코드 변경 없이 전환할 수 있나요? 예. 동일한 OpenAI 호환 엔드포인트에 다른 모델 ID를 사용합니다. 이미지 입력만 Flash 전용 기능입니다.
더 저렴한 모델이 계속 저렴하게 유지될까요? 가격은 프로모션이 아닌 더 작은 KV 캐시와 낮은 어텐션 계산량을 반영하므로 구조적 이점은 지속될 것입니다. 추가 50% 출시 할인은 2026년 9월 9일에 만료됩니다.