
Gemini 4 Neon의 thinking level은 모델이 답변하기 전에 얼마나 깊이 추론할지를 결정하는 네 가지 설정, 즉 low, medium, high, xhigh를 제공합니다. Neon의 기본값은 high입니다. Google은 대부분의 복잡한 작업에서는 high를 유지하고, 어려운 다단계 문제에서 high가 성능을 내지 못할 때만 xhigh로 전환할 것을 권장합니다. xhigh는 더 많은 토큰을 소모하고 시간이 더 오래 걸리기 때문입니다.
Gemini 4 Neon thinking level이란?
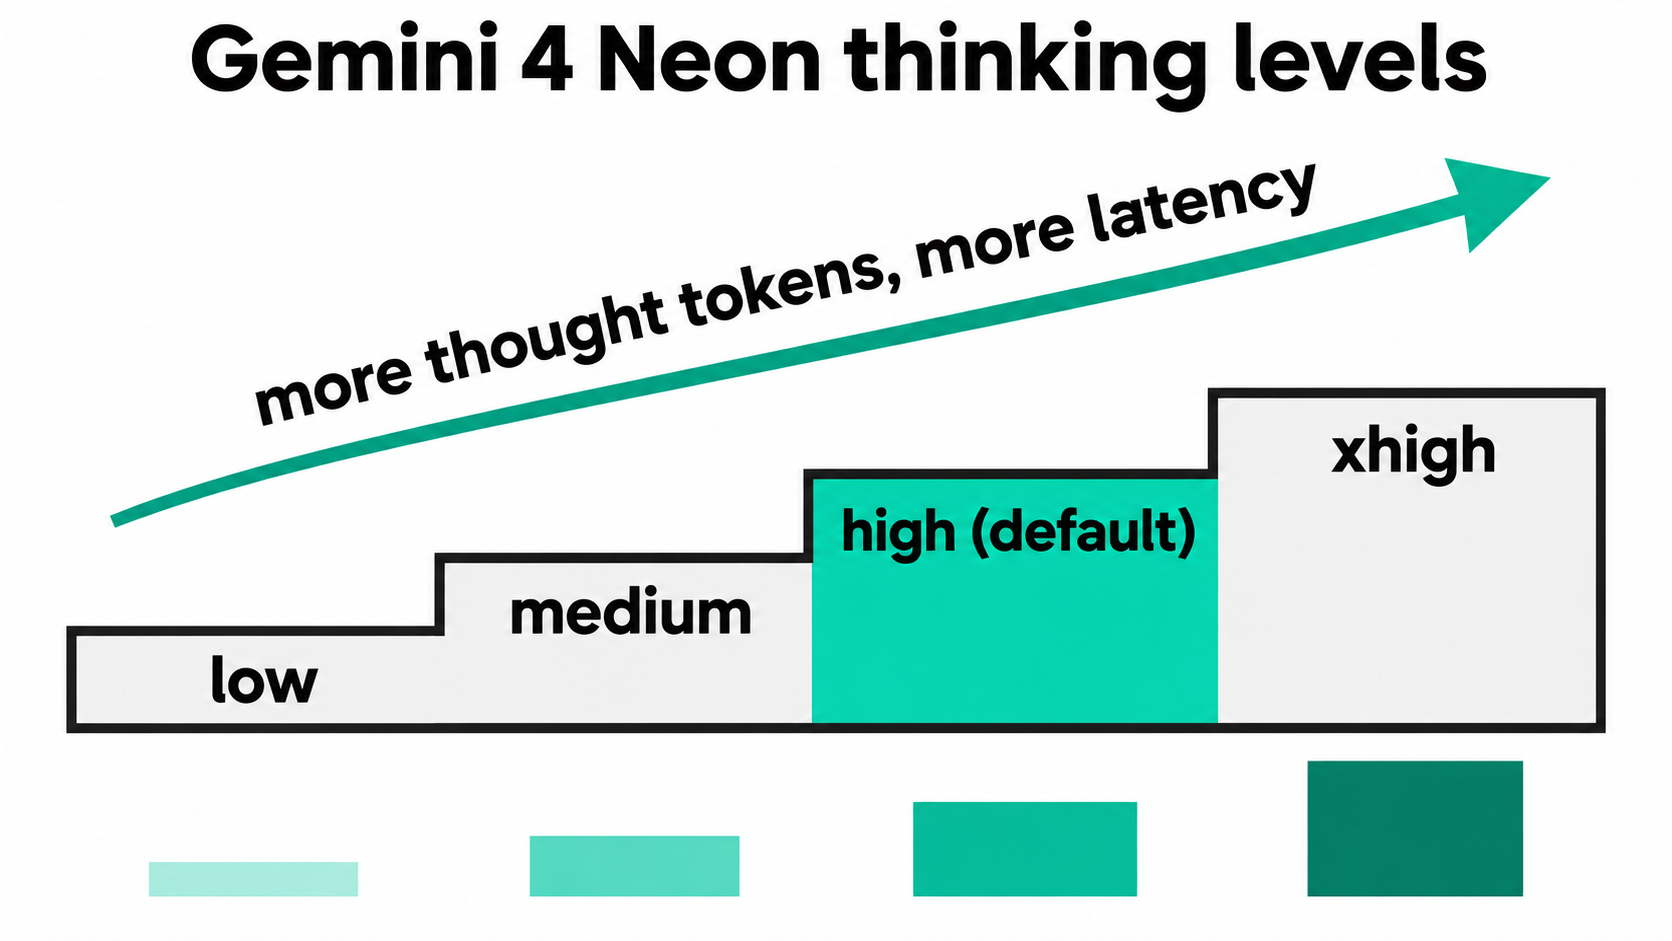
Thinking level은 thinking_level 파라미터의 값으로, gemini-4-neon이 답변을 작성하기 전에 얼마나 많은 내부 추론을 수행할지 설정합니다. Neon은 low, medium, high(기본값), xhigh의 네 가지를 지원합니다. level이 높을수록 더 많은 thinking 토큰을 사용하고 지연 시간이 늘어나며, level이 낮을수록 더 빠르게 답변하고 비용이 적게 듭니다.
Google의 thinking 가이드가 Neon의 각 level을 다음과 같이 설명합니다.
thinking_level |
토큰 사용량 | Google 권장 용도 |
|---|---|---|
low |
가장 적은 토큰, 가장 낮은 지연 시간 | 빠른 채팅, 고처리량 처리; 에이전트 작업에서도 여전히 유용함 |
medium |
더 적은 토큰, 더 빠른 응답 | 대화형 코딩, 실시간 UI 프로토타이핑, 지연 시간에 민감한 도구 호출 |
high (기본값) |
지능과 속도의 균형 | 복잡한 코딩, 에이전트 실행, 도구 호출, 멀티모달 지식 작업 |
xhigh |
가장 많은 토큰, 가장 깊은 추론 | 어려운 다단계 엔지니어링, high가 부족한 분석적·과학적 문제 |
예상할 수 있는 두 가지 값이 빠져 있습니다. Neon은 minimal을 오류로 거부하므로, Gemini 3 Flash 앱에서 복사한 코드가 이 값을 보내면 작동하지 않습니다. 그리고 기존 thinkingBudget 토큰 수는 Gemini 4에서 더 이상 사용되지 않습니다. 단독으로 보내면 경고와 함께 가장 가까운 level로 매핑되지만, thinkingLevel과 함께 보내면 400을 반환합니다.
Neon의 기본값은 다른 Gemini 4 모델과 어떻게 다른가?
Neon은 더 큰 형제 모델들보다 한 단계 높은 level에서 시작합니다. Gemini 4 Neon 릴리스 노트에 따르면 Neon과 Hydrogen은 기본값이 high이고 xhigh를 지원하는 반면, Carbon과 Argon은 기본값이 medium이고 high까지만 지원합니다.
| 모델 | 기본 level | 지원 level |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
이는 모델을 전환할 때 중요합니다. thinking_level을 설정하지 않고 Carbon 워크로드를 Neon으로 옮기면 모든 요청이 medium 추론에서 high 추론으로 뛰어올라 토큰 수가 달라집니다. 더 큰 모델들을 비교하고 있다면 Gemini 4 Carbon vs Argon 비교에서 그 차이를 다루고 있습니다.
Gemini API에서 thinking_level은 어떻게 설정하나?
Neon은 Interactions API와 generateContent 모두의 유료 등급에서 실행됩니다. 필드 이름은 두 API에서 다릅니다.
Interactions API: generation_config 안에 thinking_level을 넣습니다.
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent: generationConfig.thinkingConfig 안에 thinkingLevel을 사용합니다.
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
Python SDK에서는 Interactions 호출이 generation_config={"thinking_level": "high"}를 받고, generateContent 호출은 thinking_config=types.ThinkingConfig(thinking_level="low")를 받습니다. temperature, top_p, top_k는 지정하지 마세요. Google에 따르면 Neon은 범위 내 값은 무시하고 범위를 벗어난 값은 400으로 거부합니다. 동일한 API 설계에 대한 첫 요청 전체 예시는 Gemini 4 Hydrogen API 가이드를 참고하세요.
high와 xhigh는 언제 각각 사용해야 하나?
기본적으로 high를 사용하고, 해당 작업에서 high가 품질 기준을 충족하지 못할 때만 xhigh로 올리세요. Google의 출시 글은 xhigh를 "가장 어려운 엔지니어링, 분석, 과학 워크로드를 위한 더 깊은 다단계 추론"으로 설명합니다.
다음의 경우 xhigh를 선택하세요.
- 작업에 의존 단계가 많고 초반의 실수가 결과를 망치는 경우. 예를 들어 여러 파일에 걸친 리팩터링이나 동시성 감사가 그렇습니다.
high가 자신감 있지만 틀린 답변을 준 경우. 단순히 느린 것이 아니라 평가 세트에서 틀렸을 때입니다.- 지연 시간이 크게 중요하지 않은 경우. 백그라운드 작업, 야간 리뷰, 배치 분석 같은 작업입니다.
- 틀린 답변의 비용이 토큰 비용보다 큰 경우. 보안 패치나 금융 계산이 그렇습니다.
다음의 경우 high를 유지하거나 더 낮추세요.
- 프롬프트가 추출이나 포맷팅인 경우. Google은
xhigh가 "텍스트나 JSON 추출 같은 단순한 프롬프트에서 과도하게 생각하거나max_output_tokens를 소진할 수 있다"고 경고합니다. - 사용자가 기다리는 경우. 채팅, 자동 완성, 실시간 도구 호출에는
medium이나low가 적합합니다. - 대량으로 실행하는 경우. 추가되는 모든 thinking 토큰에 비용이 청구되며, 그 차이는 요청 수가 늘수록 증폭됩니다.
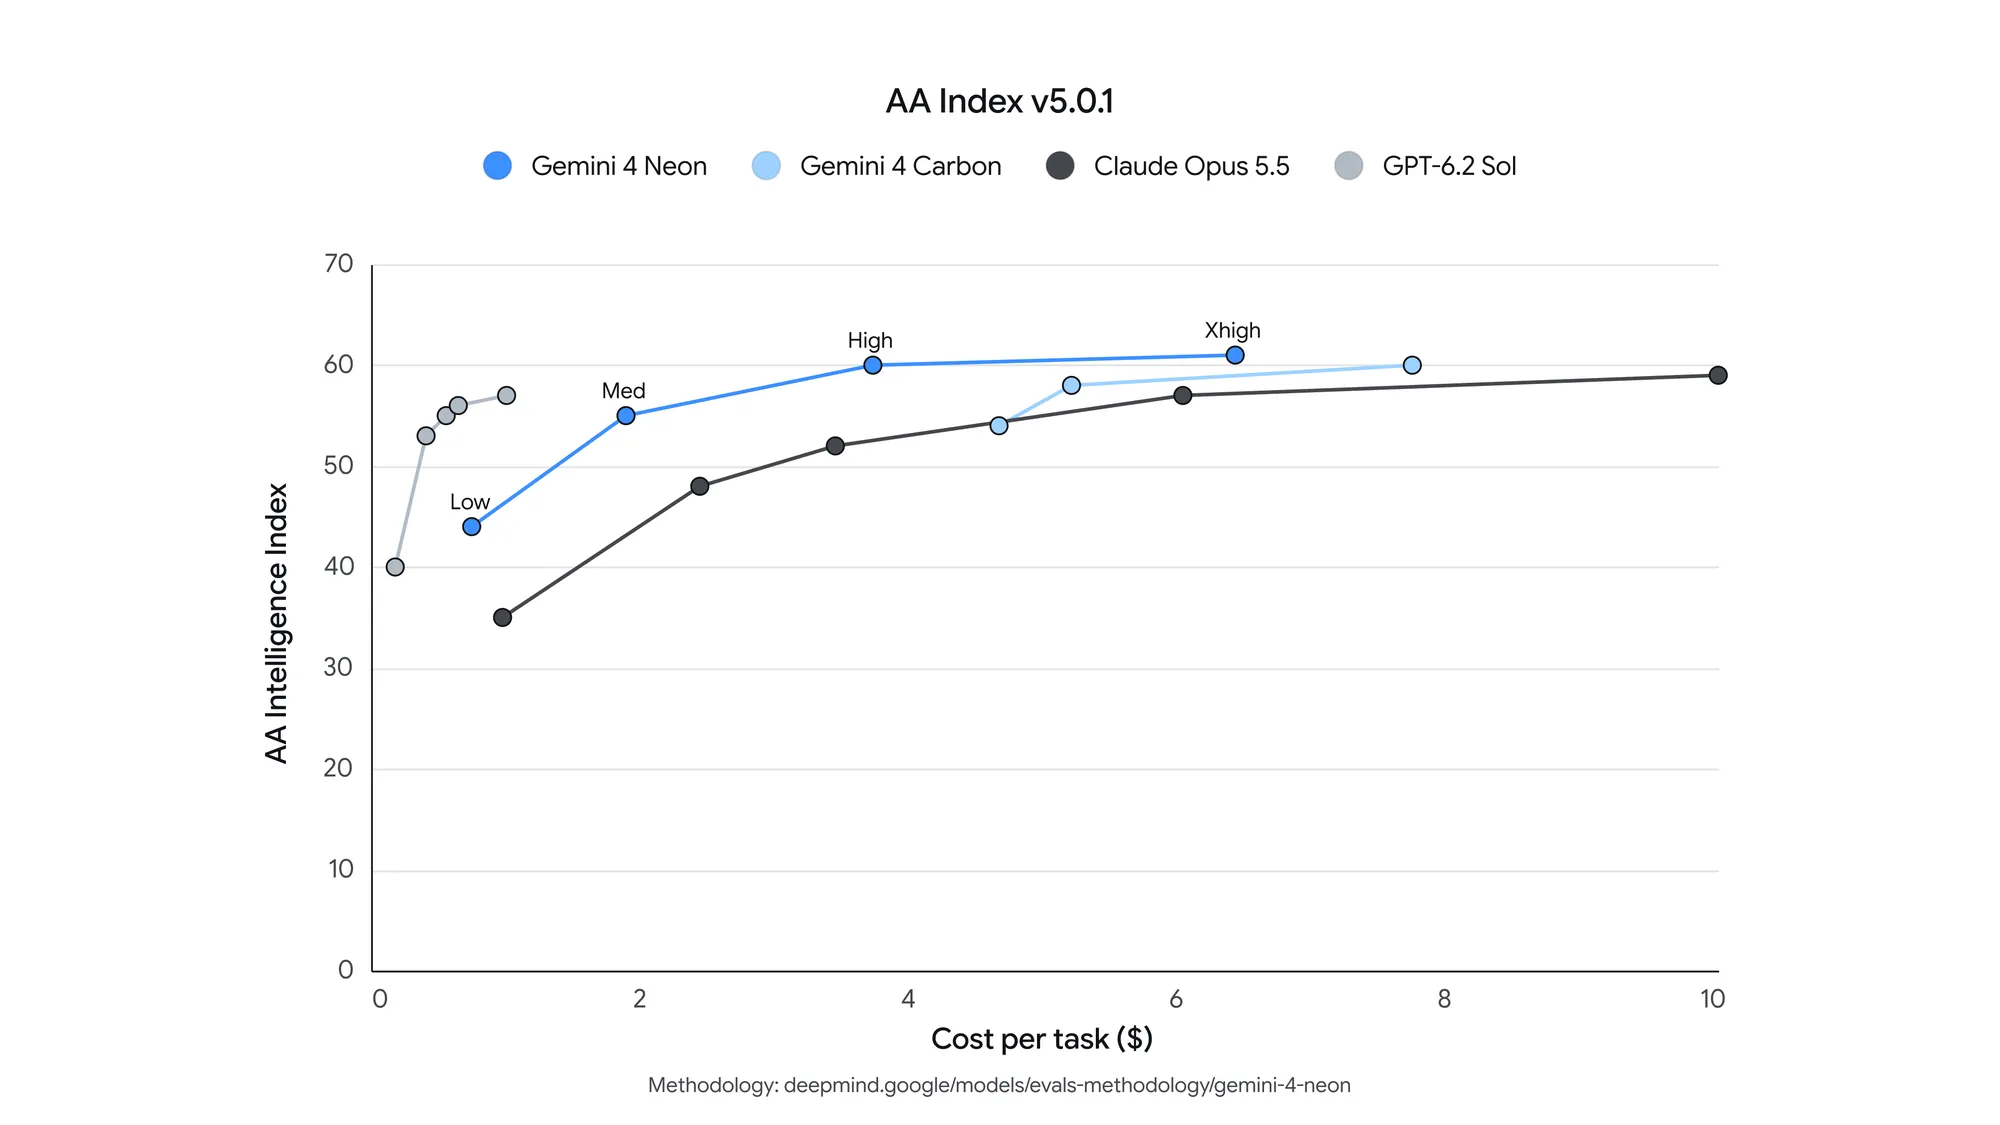
Google의 벤치마크 수치도 이 구분을 뒷받침합니다. 출시 발표에서 xhigh의 Neon은 Artificial Analysis Intelligence Index에서 61점을 기록해 3위를 차지했습니다. 기본값인 high에서는 Google이 Carbon보다 작업당 비용이 32% 낮다고 보고합니다. 이는 Google의 수치이지 저희 테스트는 아니지만, 트레이드오프를 보여줍니다. xhigh는 Neon의 최고 점수를 사고, high는 효율을 삽니다.
각 thinking level의 비용은 얼마인가?
모든 level의 토큰당 가격은 같으며, 달라지는 것은 지불하는 토큰 수입니다. Neon은 100만 입력 토큰당 $3.00, 100만 출력 토큰당 $15.00이며, Google의 가격 페이지는 출력 요율에 thinking 토큰이 포함된다고 명시합니다. 암시적 캐싱을 사용하면 캐시된 입력은 100만 토큰당 $0.15로 떨어집니다(Neon에서는 명시적 캐싱이 지원되지 않음). 이 모델에는 무료 등급이 없습니다.
따라서 level의 비용은 추가되는 thinking 토큰 수에 100만 토큰당 $15를 곱한 값입니다. 다음은 입력 토큰 2,000개와 표시되는 답변 토큰 800개로 구성된 한 요청의 계산입니다. Thinking 토큰 수는 계산 방식을 보여주기 위해 임의로 선택한 것이며 측정값이 아닙니다.
| Thinking 토큰 (가정) | 입력 비용 | 출력 + thinking 비용 | 요청당 합계 | 10,000건당 |
|---|---|---|---|---|
| 500 | $0.006 | $0.0195 | $0.0255 | $255 |
| 2,000 | $0.006 | $0.042 | $0.048 | $480 |
| 8,000 | $0.006 | $0.132 | $0.138 | $1,380 |
Thinking이 청구서를 빠르게 지배합니다. Thinking 토큰이 8,000개일 때 추론은 요청 비용의 87%를 차지합니다. 그래서 Google은 네 가지 level 모두에서 평가를 실행하고 "품질 기준을 충족하는 가장 낮은 thinking_level을 선택하라"고 권장합니다. 더 저렴한 모델에서 같은 트레이드오프를 비교하고 싶다면 Gemini 3.8 Flash thinking level 가이드에서 다룹니다.
level별 토큰과 지연 시간은 어떻게 측정하나?
같은 프롬프트를 각 level에서 실행하고 usage 블록을 확인하세요. Interactions API에서는 응답의 usage 객체가 total_input_tokens, total_output_tokens, total_thought_tokens를 각각 보고합니다. generateContent에서는 thinking 토큰이 usageMetadata.thoughtsTokenCount로 나타납니다.
다음 루프는 하나의 프롬프트를 네 level 모두에 보내고 thinking 토큰과 실제 소요 시간을 출력합니다.
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
실제 워크로드에서 10~20개의 프롬프트로 실행해 보세요. 프롬프트 하나로는 알 수 있는 것이 거의 없습니다. 여러 개를 모아야 high와 xhigh가 품질에서 갈리기 시작하는 지점을 볼 수 있습니다.
테스트하는 동안 HTTP 클라이언트의 타임아웃을 높게 설정하세요. Google의 마이그레이션 노트에 따르면 어려운 프롬프트는 몇 분이 걸릴 수 있으므로 최소 15분의 타임아웃을 설정하거나 백그라운드 실행을 사용할 것을 권장합니다.
xhigh가 때때로 빈 답변을 반환하는 이유는?
max_output_tokens는 thinking과 표시되는 출력을 함께 제한합니다. Neon이 예산 전체를 추론에 사용하면 상호작용은 incomplete 상태로 중단되고 잘렸거나 빈 답변을 반환하며, 생성한 thinking 토큰에 대한 비용은 여전히 청구됩니다.
Google 문서의 세 가지 규칙으로 이를 피할 수 있습니다.
- 기존의 낮은 상한을 제거하세요. 앱에 8,192 같은 값이 하드코딩되어 있다면 동기 호출 기본 상한인 65,536으로 올리세요.
- 상한이 아니라 level을 낮추세요. 비용이나 지연 시간을 줄이려면
max_output_tokens를 줄이는 대신medium이나low로 낮추세요. - 긴 작업은 백그라운드로 전환하세요. 65,536 토큰을 넘는 답변에는
background를true로 설정하고max_output_tokens를 최대 1,048,576에서 입력을 뺀 값으로 올리세요. 입력, thinking, 출력은 하나의 100만 토큰 윈도를 공유합니다. Gemini 4 Argon 장문 출력 가이드에서 폴링 패턴을 자세히 다룹니다.
Apidog CLI로 코딩 에이전트가 네 level을 모두 벤치마크하게 하기
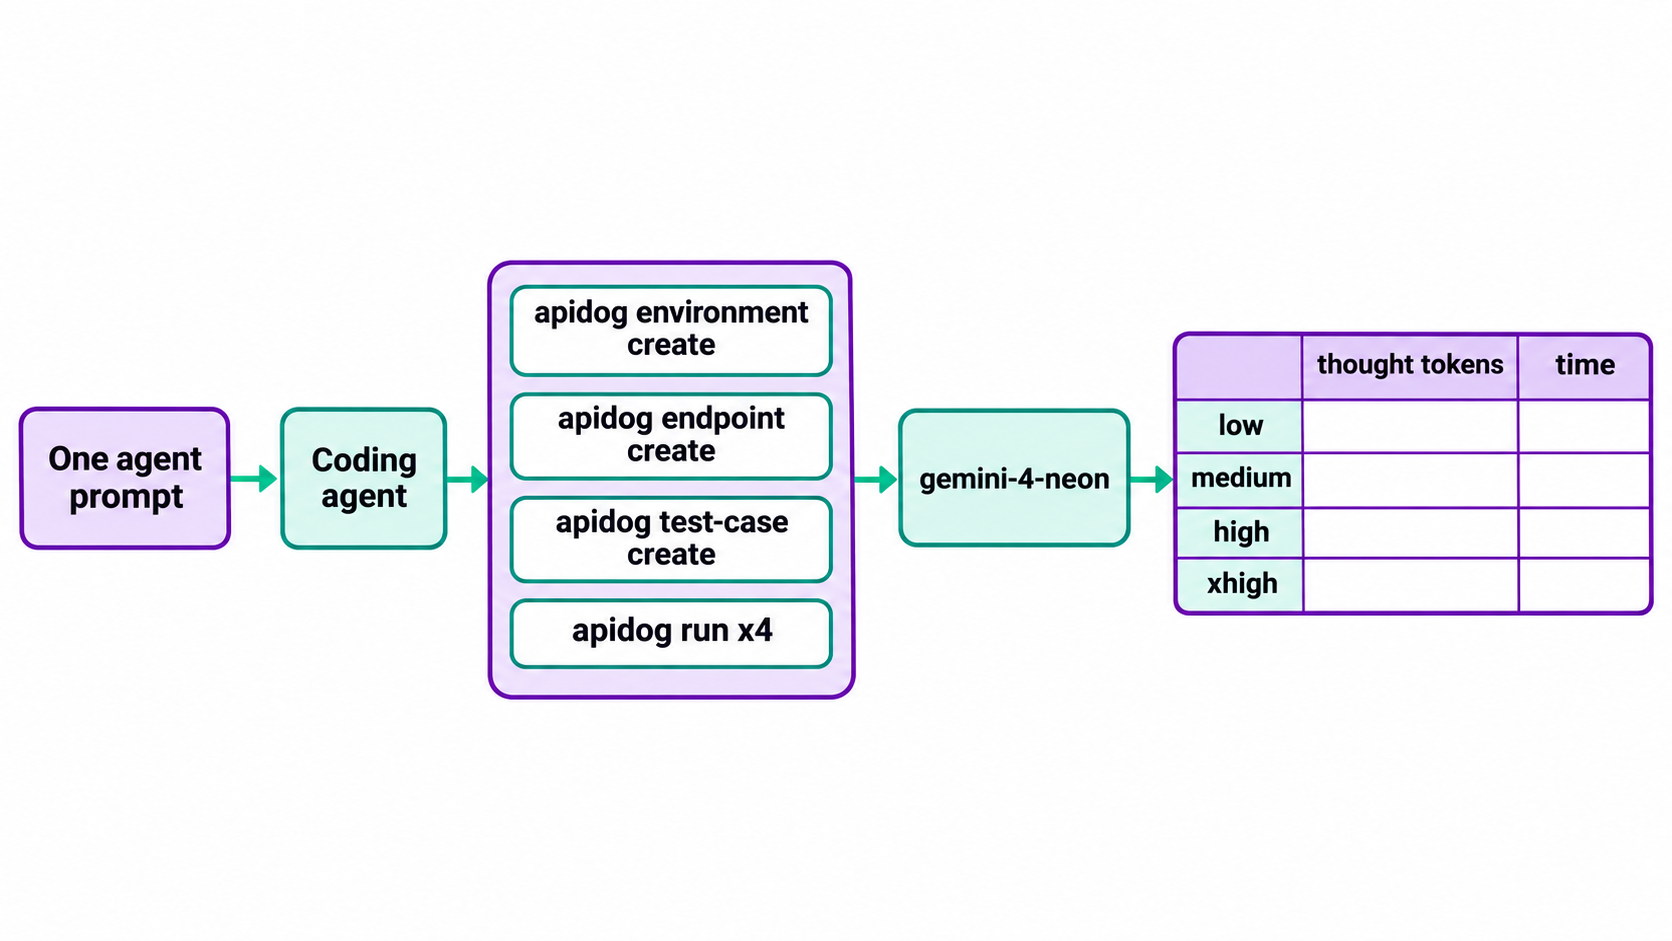
이 루프를 직접 반복해서 돌리는 일은 금방 지루해집니다. 대신 코딩 에이전트(Claude Code, Codex, Cursor)에게 Apidog CLI로 재사용 가능한 테스트 하나를 만들게 하고, 새로운 수치가 필요할 때마다 각 level에서 다시 실행하게 하세요.
한 번만 설정하세요.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 에이전트에게 프롬프트 하나를 전달하세요.
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
에이전트는 각 페이로드 스키마를 읽고, JSON을 검증하고, 리소스를 작성한 뒤 실행을 반복합니다.
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
status is "completed" 단언은 이전 섹션의 incomplete 함정을 잡아내므로, 예산을 다 써버린 level은 빈 문자열을 반환하는 대신 확실하게 실패합니다. -r cli,json을 -r junit으로 바꾸면 같은 실행을 CI에 넣을 수 있습니다. Apidog CLI CI/CD 가이드에서 파이프라인을 보여주고, Apidog CLI in Claude Code에서 에이전트 설정을 다룹니다. Apidog의 무료 플랜은 최대 4명의 사용자를 지원합니다.
FAQ
Gemini 4 Neon의 기본 thinking level은 무엇인가요? high입니다. 이를 얻기 위해 thinking_level을 보낼 필요는 없습니다. Carbon과 Argon의 기본값은 medium이므로, 이들 모델에서 마이그레이션할 때는 level을 명시적으로 설정하세요.
Gemini 4 Neon은 minimal thinking을 지원하나요? 아니요. Neon은 low, medium, high, xhigh를 지원하며 minimal은 오류로 거부합니다. 가장 빠르고 저렴한 응답에는 low를 사용하세요.
Gemini 4 Neon에서 thinking 토큰에 요금이 부과되나요? 예. Thinking 토큰은 100만 출력 토큰당 $15.00 요율로 청구됩니다. Google은 모델이 처리하는 모든 토큰을 계산하며, 여기에는 thinking 토큰도 포함됩니다.
Gemini 4 Neon에서 thinkingBudget을 여전히 사용할 수 있나요? Gemini 4 모델에서는 더 이상 지원되지 않습니다. 단독으로 보내면 가장 가까운 thinkingLevel로 매핑되고 경고를 반환합니다. thinkingLevel과 함께 보내면 요청이 400으로 실패합니다.
xhigh가 항상 high보다 정확한가요? 항상 그렇지는 않습니다. Google에 따르면 xhigh는 텍스트나 JSON 추출 같은 단순한 프롬프트에서 과도하게 생각하고 max_output_tokens를 소진할 수 있습니다. 자신의 프롬프트에서 둘 다 테스트하고 통과하는 가장 낮은 level을 유지하세요.
Gemini 4 Neon thinking level을 무료로 사용할 수 있나요? 아니요. Gemini 4 Neon은 Gemini API 무료 등급에서 사용할 수 없습니다. Google AI Studio와 Google Antigravity에서는 유료 Google AI Pro 및 Ultra 플랜에 연결되어 있습니다.