
Gemini 4 Neon의 컨텍스트 캐싱은 암시적(implicit) 방식만 지원합니다. 캐시를 직접 만드는 것이 아닙니다. Google이 4,096 토큰 이상의 반복되는 프롬프트 접두사를 자동으로 캐싱하며, 캐시된 입력 토큰은 $3 대신 1M당 $0.15로 청구됩니다. 즉, 95% 할인입니다. 이 혜택을 받으려면 매 요청의 안정적인 부분을 앞쪽에 배치하고 바이트 단위까지 동일하게 유지한 뒤, usage.total_cached_tokens에서 캐시 적중을 확인하면 됩니다.
아래에서는 캐시 적중을 위한 프롬프트 구성, 에이전트 루프 규칙, 캐시된 토큰 수 확인 방법, 그리고 코딩 에이전트가 대신 실행해 주는 테스트까지 다룹니다.
Gemini 4 Neon 컨텍스트 캐싱은 어떻게 작동하나요?
Gemini 4 Neon의 컨텍스트 캐싱은 자동 접두사 캐싱입니다. 새 요청이 최근 요청과 동일한 토큰으로 시작하고, 그 공통 접두사가 4,096 토큰 이상이면 Google이 반복되는 부분을 캐시에서 제공하고 캐시 요금으로 청구합니다. 활성화할 설정도 없고, 관리해야 할 캐시 객체, TTL, 저장 비용도 없습니다.
Google은 2026년 11월 18일 Neon을 공개했습니다(모델 ID는 gemini-4-neon, 출시 포스트 참고). 캐싱 관련 사항은 다음 표 하나로 정리됩니다:
| 항목 | Gemini 4 Neon |
|---|---|
| 캐싱 방식 | 암시적만 지원, 기본 활성화 |
명시적 캐싱 (cachedContents, caches.create) |
미지원 |
| 캐시 적중을 위한 최소 접두사 | 4,096 토큰 |
| 표준 입력 | 1M 토큰당 $3.00 |
| 캐시된 입력 (Standard) | 1M 토큰당 $0.15 |
| 캐시된 입력 (Batch 및 Flex) | 1M 토큰당 $0.075 |
| 캐시된 입력 (Priority) | 1M 토큰당 $0.27 |
| 적중 확인 위치 | usage.total_cached_tokens |
| 무료 등급 | 없음, 유료 등급 전용 |
할인율은 모든 등급에서 95%입니다. $3의 5%가 $0.15, $1.50의 5%가 $0.075, $5.40의 5%가 $0.27입니다. thinking 토큰을 포함한 출력 토큰은 Standard 기준 1M당 $15로 그대로이며, 캐싱은 입력에만 적용됩니다.
Gemini 4 Neon의 암시적 캐싱과 명시적 캐싱 비교
Gemini 2.5나 3에서 명시적 캐싱을 사용하고 계셨다면, 코드가 깨지는 변경 사항입니다. Google의 Neon 마이그레이션 노트는 명확합니다. Gemini 4 Neon은 "명시적 캐싱(cachedContents, caches.create)을 지원하지 않으므로" 요청에서 "cached_content 필드를 제거"해야 합니다.
캐싱 문서에는 Interactions API는 암시적 캐싱만 지원하며, 어떤 Gemini 4 모델에서도 명시적 캐싱을 사용할 수 없다고 나와 있습니다. 명시적 캐시는 지원되는 Gemini 3 및 2.5 모델에서 generateContent를 통해 계속 사용할 수 있습니다.
마이그레이션 시 해야 할 일은 다음과 같습니다:
caches.create를 호출하고 캐시 이름을 저장하는 코드를 삭제합니다.- 모든 요청 본문에서
cached_content를 제거합니다. - 더 이상 사용하지 않는 캐시 스토리지에 대한 비용 지불을 중단합니다.
- 기존에 명시적으로 캐싱하던 콘텐츠가 각 요청의 맨 앞에 오도록 프롬프트를 재구성합니다.
특정 문서를 고정하거나 TTL을 지정할 수는 없고, 적중도 보장되지 않습니다. 다만 적중 확률을 크게 높일 수는 있습니다.
Gemini 4 Neon 캐시에 적중하도록 프롬프트를 구성하는 방법
캐시 적중을 위해서는 길고 동일한 접두사를 짧은 시간 간격으로 다시 전송해야 합니다. Google 문서는 두 가지 팁을 제시합니다: 크고 공통적인 콘텐츠를 프롬프트 앞부분에 배치하고, 비슷한 접두사를 가진 요청을 짧은 시간 안에 전송하는 것입니다.
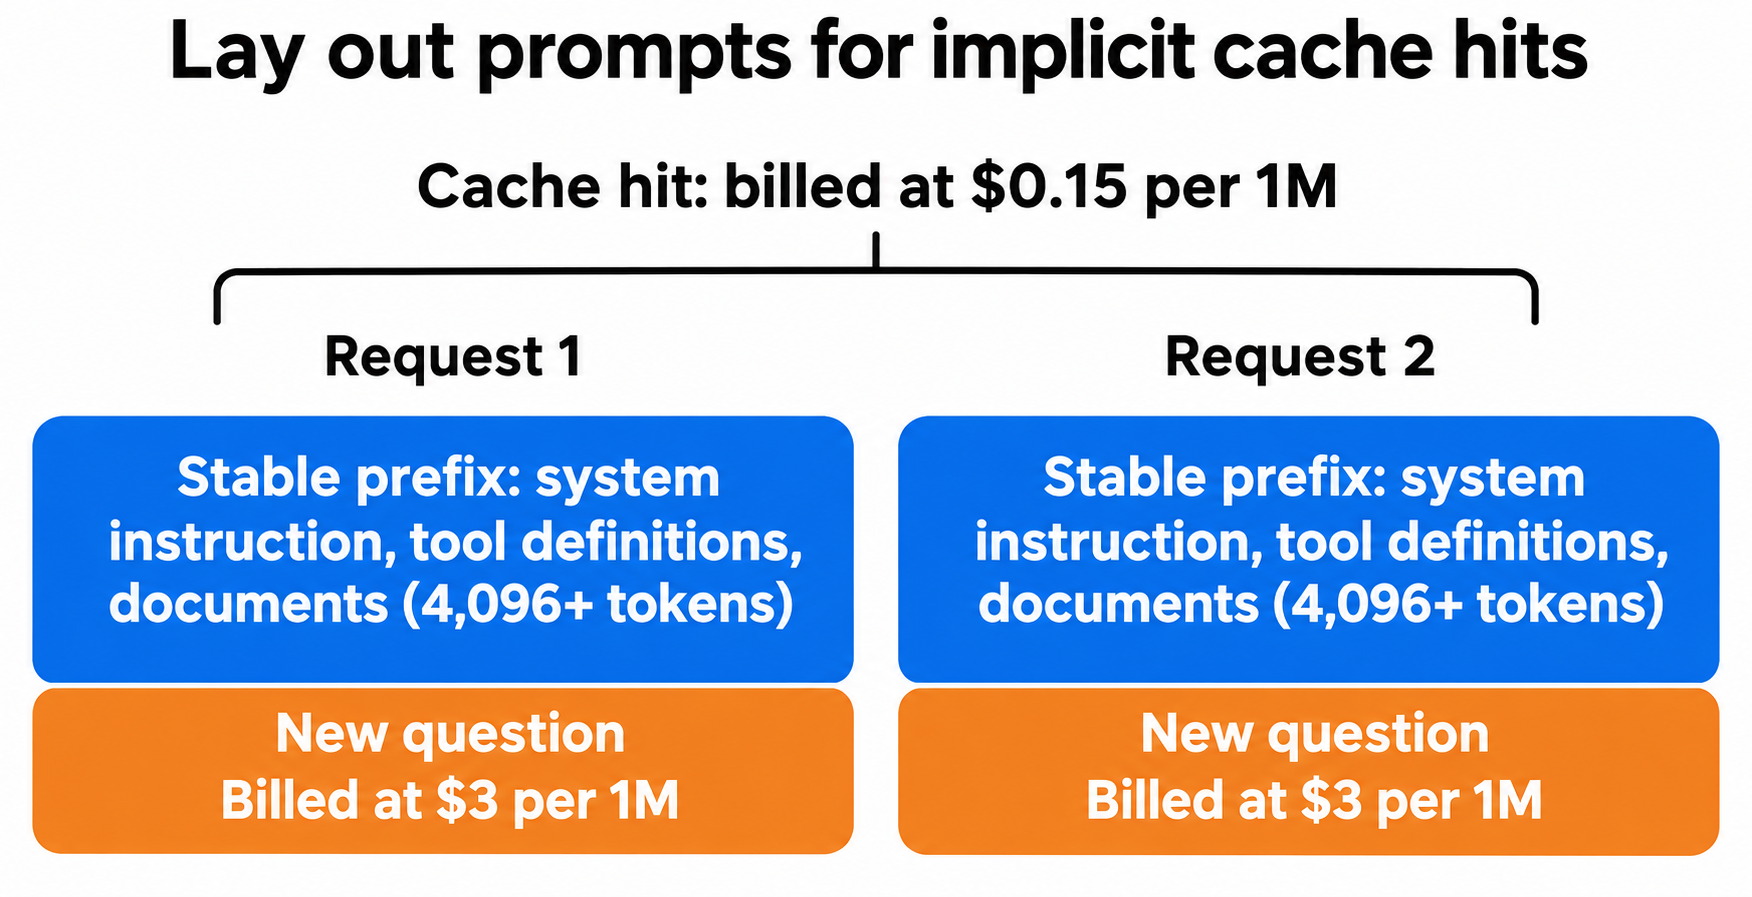
모든 요청을 다음 순서로 구성하세요:
- 시스템 지침. 고정된 텍스트. 타임스탬프, 사용자 이름, 요청 ID 없음.
- 도구 및 함수 선언. 매번 동일한 목록, 동일한 순서, 동일한 설명.
- 공유 문서. 코드베이스, 계약서, API 명세, 긴 정책 파일.
- 변하는 부분. 사용자의 질문, 최신 도구 결과, 오늘 날짜.
캐시 적중에 실패하는 가장 흔한 원인은 상단 근처에 작은 동적 값이 들어가는 것입니다. 시스템 지침에 Current time: 2026-11-19T09:14:02Z 같은 줄이 있으면 매 호출마다 접두사가 달라져서 그 뒤의 내용은 아무것도 일치하지 않게 됩니다. 이런 값은 문서 뒤, 즉 끝으로 옮기세요.
그 외 접두사를 깨뜨리는 요인: 무작위 순서로 생성된 도구 목록, 공백이 달라지며 재직렬화된 문서, 다른 순서로 반환되는 검색 청크 등이 있습니다.
접두사는 4,096 토큰 이상으로 유지하세요. 2,000 토큰짜리 시스템 프롬프트만으로는 기준을 충족하지 못합니다. 여기에 긴 공유 문서를 함께 보내면 합산된 접두사가 기준을 넘게 됩니다.
Interactions API에서는 안정적인 지침을 system_instruction에 넣고, 문서는 input의 앞쪽에 배치하세요:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

SYSTEM = open("review_rules.md").read()      # fixed text
CODEBASE = open("repo_snapshot.txt").read()  # ~200K tokens, unchanged

def ask(question: str):
    interaction = client.interactions.create(
        model="gemini-4-neon",
        system_instruction=SYSTEM,
        input=CODEBASE + "\n\nQuestion: " + question,
    )
    print("cached tokens:", interaction.usage.total_cached_tokens)
    return interaction

ask("Where do we validate JWT expiry?")
ask("Which handlers skip input validation?")
첫 번째 호출이 캐시를 채웁니다. 두 번째 호출에서 캐시된 토큰 수가 0으로 출력된다면 접두사 중 무언가가 변경된 것입니다.
암시적 캐싱은 두 가지 대화 모드 모두에서 작동합니다. 위 예제 같은 상태 비저장(stateless) 호출도 해당되고, previous_interaction_id로 연결된 상태 저장(stateful) 세션도 마찬가지입니다. 전체 요청 형식은 Gemini 4 Neon API 가이드를 참고하세요.
에이전트 루프에서의 캐싱 작동 방식: 2,050 토큰 규칙
에이전트 루프는 매 턴마다 전체 히스토리를 다시 전송하기 때문에 캐싱의 효과가 가장 큰 곳입니다. 다만 Gemini 4 모델에는 알아두어야 할 규칙이 하나 추가되었습니다. Google의 캐싱 문서에 따르면: "Gemini는 새 요청이 최소 2,050 토큰 이상 추가될 때만 이전 요청 전체를 캐싱합니다." 모델 출력, thoughts, 함수 결과 모두 이 총량에 포함됩니다.
한 턴에서 2,050 토큰 미만이 추가되면 Gemini는 이전 요청의 마지막 2,050 토큰을 표준 입력 요율로 다시 처리합니다. 접두사의 앞부분은 여전히 캐시에 적중할 수 있지만, 그 뒷부분은 1M당 $3으로 청구됩니다.
Google에 따르면 대부분의 에이전트 턴은 이 기준을 넘습니다. 기준을 넘지 못하는 경우는 {"ok": true}를 반환하는 상태 확인 같은 작은 단계가 반복되는 잦은 루프입니다. 턴당 비용은 작지만(1M당 $3 기준 2,050 토큰은 약 $0.006), 수천 번의 짧은 턴에 걸쳐 누적됩니다. 루프에서 아주 작은 호출이 많이 발생한다면 로직이 허용하는 범위 내에서 작은 도구 결과를 하나의 턴에 묶어 보내세요.
Gemini 4 Neon 컨텍스트 캐싱으로 얼마나 절약할 수 있나요?
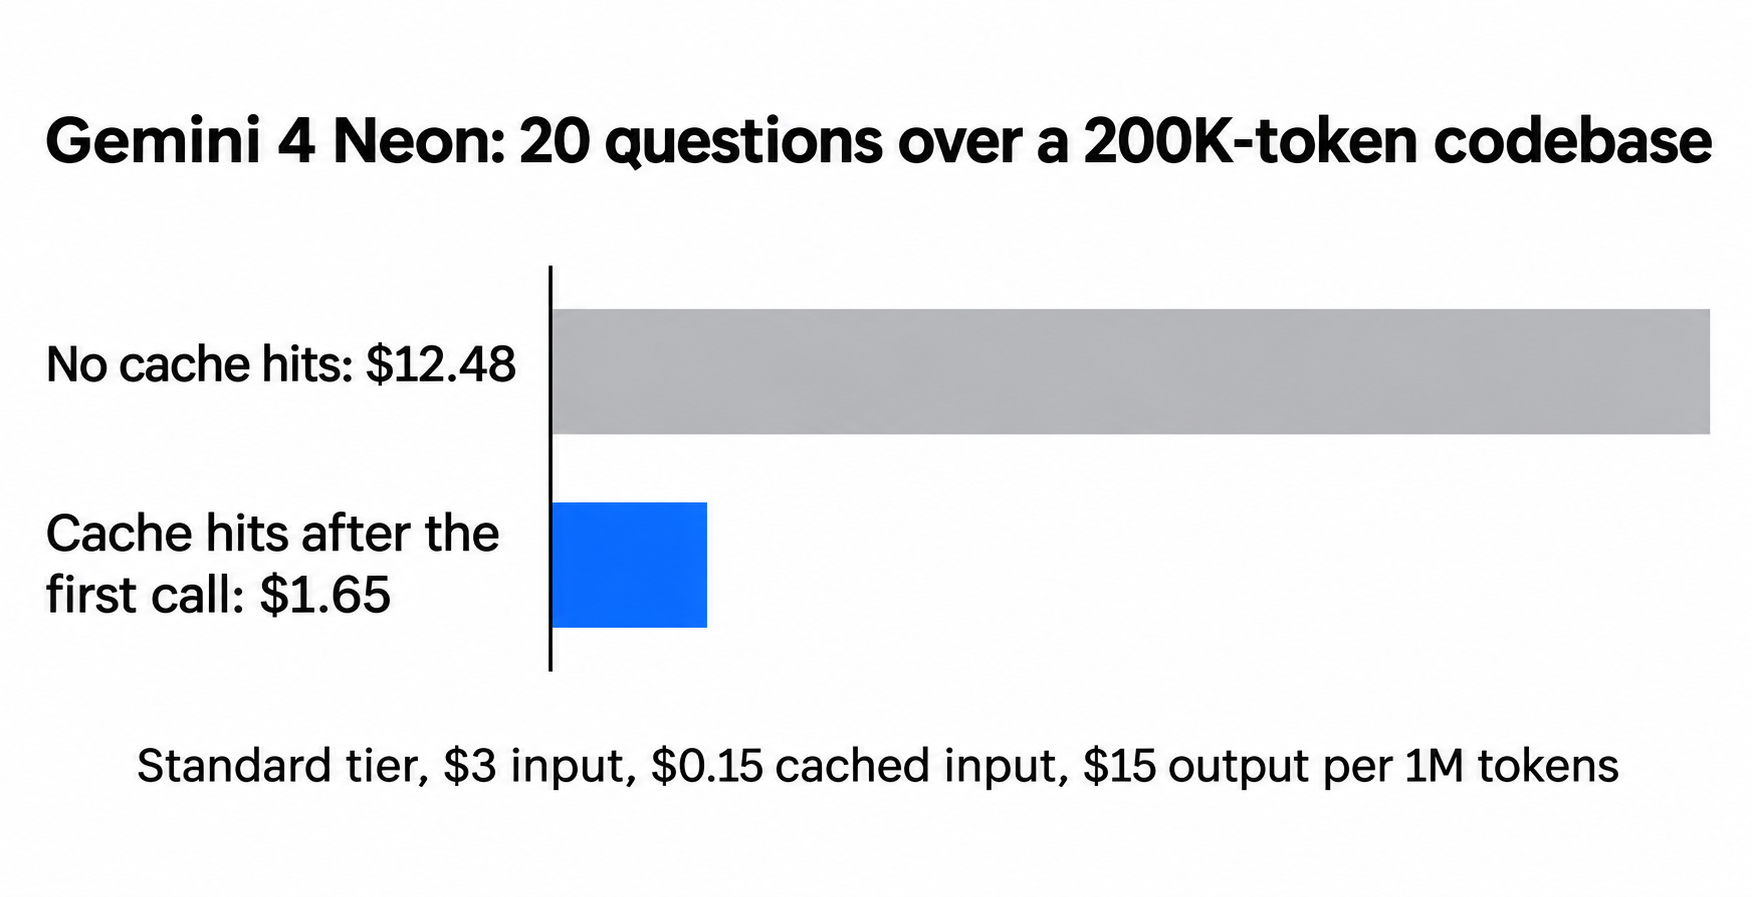
200,000 토큰 규모의 코드베이스에 대해 20개의 질문에 답변하는 코드 리뷰 어시스턴트를 생각해 봅시다. 각 질문은 3,000 토큰을 추가하고 1,000 토큰의 답변을 받으며, Standard 등급을 사용합니다.
캐시 적중이 없을 때 각 호출의 비용은 다음과 같습니다:
- 입력: 203,000 × $3 / 1M = $0.609
- 출력: 1,000 × $15 / 1M = $0.015
- 호출당: $0.624, 따라서 20회 호출에 $12.48
첫 호출 이후 캐시에 적중할 때, 2번부터 20번까지 호출의 비용은 다음과 같습니다:
- 캐시된 접두사: 200,000 × $0.15 / 1M = $0.030
- 새 입력: 3,000 × $3 / 1M = $0.009
- 출력: $0.015
- 호출당: $0.054
캐시가 적용되지 않은 첫 호출 $0.624를 더하면 세션 전체 비용은 $1.65로, 약 87% 절약됩니다.
절감률이 95%에 미치지 못하는 이유는 출력과 새 입력에는 할인이 적용되지 않기 때문입니다. 공유 접두사가 나머지 부분에 비해 클수록 입력 비용은 95%에 가까워집니다. 같은 작업을 Batch로 실행하면 캐시 요율이 다시 절반인 $0.075로 내려갑니다. 전체 요금표와 thinking 레벨 비용은 Gemini 4 Neon 요금을 참고하세요.
응답에서 Gemini 4 Neon의 캐시된 토큰을 확인하는 방법
모든 응답에서 usage.total_cached_tokens를 확인하세요. Google은 이 필드를 캐시 적중된 토큰 수를 보여주는 필드로 문서화하고 있으며, Python과 JavaScript SDK 모두에서 제공됩니다.
curl과 jq를 사용하는 경우:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d @request.json | jq '.usage'
호출 비용을 계산하려면 캐시된 토큰은 1M당 $0.15로, 나머지 입력은 $3으로, 출력과 thinking은 $15로 청구합니다. 요청 ID 옆에 캐시된 토큰 수를 로그로 남기세요. 전체 트래픽에서 갑자기 0으로 떨어진다면 대개 배포 과정에서 접두사가 변경되었음을 의미합니다. 새 도구 추가, 문구가 바뀐 규칙, 혹은 시스템 지침에 들어간 타임스탬프가 원인일 수 있습니다.
Apidog CLI로 코딩 에이전트에게 캐시 적중 테스트시키기
평범한 리팩토링 중에도 접두사는 깨질 수 있고, 청구서가 도착할 때까지 아무도 눈치채지 못합니다. 캐시 확인을 코딩 에이전트가 관리하고 CI가 실행하는 API 테스트로 만드세요.
Apidog CLI를 사용하면 Claude Code, Codex, Cursor, OpenCode가 터미널에서 API 테스트를 만들고 실행할 수 있습니다. 한 번만 설정하세요:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 에이전트에게 프롬프트 하나를 주면 됩니다:
In Apidog project <id>, create an environment for the Gemini API with a
GEMINI_API_KEY variable. Build a test scenario called "Neon cache hit" with two
steps that POST to /v1beta/interactions with model gemini-4-neon, using our
production system_instruction and the docs/context.md file as the start of
input, then two different questions. Assert HTTP 200 on both, and assert that
usage.total_cached_tokens on step 2 is greater than 4096. Run it and tell me
the cached token count.
에이전트가 환경과 시나리오를 만들고, 페이로드를 CLI의 스키마와 대조한 뒤 실행합니다:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog test-scenario create --project <id> --name "Neon cache hit"
apidog cli-schema get test-scenario-update
apidog cli-schema validate test-scenario-update --file scenario.json
apidog test-scenario update <scenarioId> --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
다음 달에 누군가 시스템 프롬프트에 타임스탬프를 추가하면, 변경 사항이 배포되기 전에 2단계의 assertion이 실패합니다. Apidog CLI CI/CD 가이드를 참고해 apidog run -t <scenarioId> --project <id> -e <envId> -r junit을 파이프라인에 넣거나, Claude Code에서 Apidog CLI 사용하기부터 시작하세요. 실행할 때마다 실제 Neon 호출이 두 번 이루어지므로, 위 요율 기준으로 실행당 몇 센트 정도의 비용이 듭니다. Apidog의 Free 플랜은 최대 4명의 사용자까지 지원합니다.
프로바이더 전반에서 접두사 캐싱이 작동하는 방식은 프롬프트 캐싱이란?을 참고하세요.
FAQ
Gemini 4 Neon은 명시적 컨텍스트 캐싱을 지원하나요? 아니요. Google의 Neon 가이드에 따르면 cachedContents나 caches.create를 지원하지 않으며, 요청에서 cached_content를 제거해야 합니다. Neon은 기본적으로 활성화되는 암시적 캐싱만 사용합니다.
Gemini 4 Neon에서 캐시 적중을 위한 최소 프롬프트 크기는 얼마인가요? 4,096 토큰의 공유 접두사입니다. 이는 Gemini 4 Hydrogen, Argon, Carbon과 동일한 최소치입니다. Gemini 2.5 Flash와 Pro는 2,048이 필요합니다.
Gemini 4 Neon의 캐싱 할인율은 얼마인가요? 캐시된 입력에 대해 95%입니다. Standard는 1M 토큰당 $3에서 $0.15로, Batch와 Flex는 $1.50에서 $0.075로, Priority는 $5.40에서 $0.27로 내려갑니다. 출력과 thinking 토큰에는 할인이 적용되지 않습니다.
Gemini 4 Neon이 프롬프트를 캐싱하도록 강제할 수 있나요? 아니요. 암시적 캐싱에는 활성화할 설정도, 선택할 TTL도 없으며 적중도 보장되지 않습니다. 각 요청의 시작 부분에 길고 동일한 접두사를 유지하고 비슷한 요청을 가까운 시간 안에 전송함으로써 확률을 높일 수 있습니다.
내 요청이 캐시에 적중했는지 어떻게 알 수 있나요? 응답의 usage.total_cached_tokens를 확인하세요. 0보다 큰 값이 있다면 그만큼의 입력 토큰이 캐시 요율로 청구되었다는 뜻입니다.
캐싱은 previous_interaction_id와 함께 작동하나요? 네. Google 문서에 따르면 암시적 캐싱은 previous_interaction_id로 연결된 상태 저장 대화와, 전체 히스토리를 직접 전송하는 상태 비저장 호출 모두에서 작동합니다.