
Gemini 4 Neon 벤치마크 결과, Artificial Analysis Coding Agent Index에서 58.6점으로 1위, Terminal-Bench 4.1에서 65.2%, Vals Index에서 70.9%로 2위를 기록했습니다. Google은 또한 기본 high 사고 수준에서 Gemini 4 Carbon보다 작업당 비용이 32% 저렴하다고 밝혔습니다. 다만 대부분의 항목은 xhigh에서 실행됐고, 일부는 Google 자체 하네스에서 측정된 것입니다.
이 마지막 부분이 바로 이 글의 핵심입니다. Gemini 4 Neon 개요에서는 사양과 가격을 다뤘습니다. 이 글에서는 공개된 모든 점수, 누가 측정했는지, 어떤 사고 수준에서 측정됐는지, 그리고 "작업당 비용"을 여러분의 실제 청구서와 비교해 확인할 수 있는 숫자로 바꾸는 방법을 알려드립니다.
Gemini 4 Neon 벤치마크 한눈에 보기
Gemini 4 Neon은 2026년 11월 18일 출시된 Google의 중간급 Gemini 4 모델로, 백만 입력 토큰당 3달러, 백만 출력 토큰당 15달러에 책정됐습니다. 가장 뛰어난 공개 결과는 에이전트 코딩과 지식 노동 분야에서 나오며, 네 개의 독립 리더보드에서 1위 또는 2위를 차지합니다.
다음은 Google의 출시 블로그에 실린 주요 항목입니다:
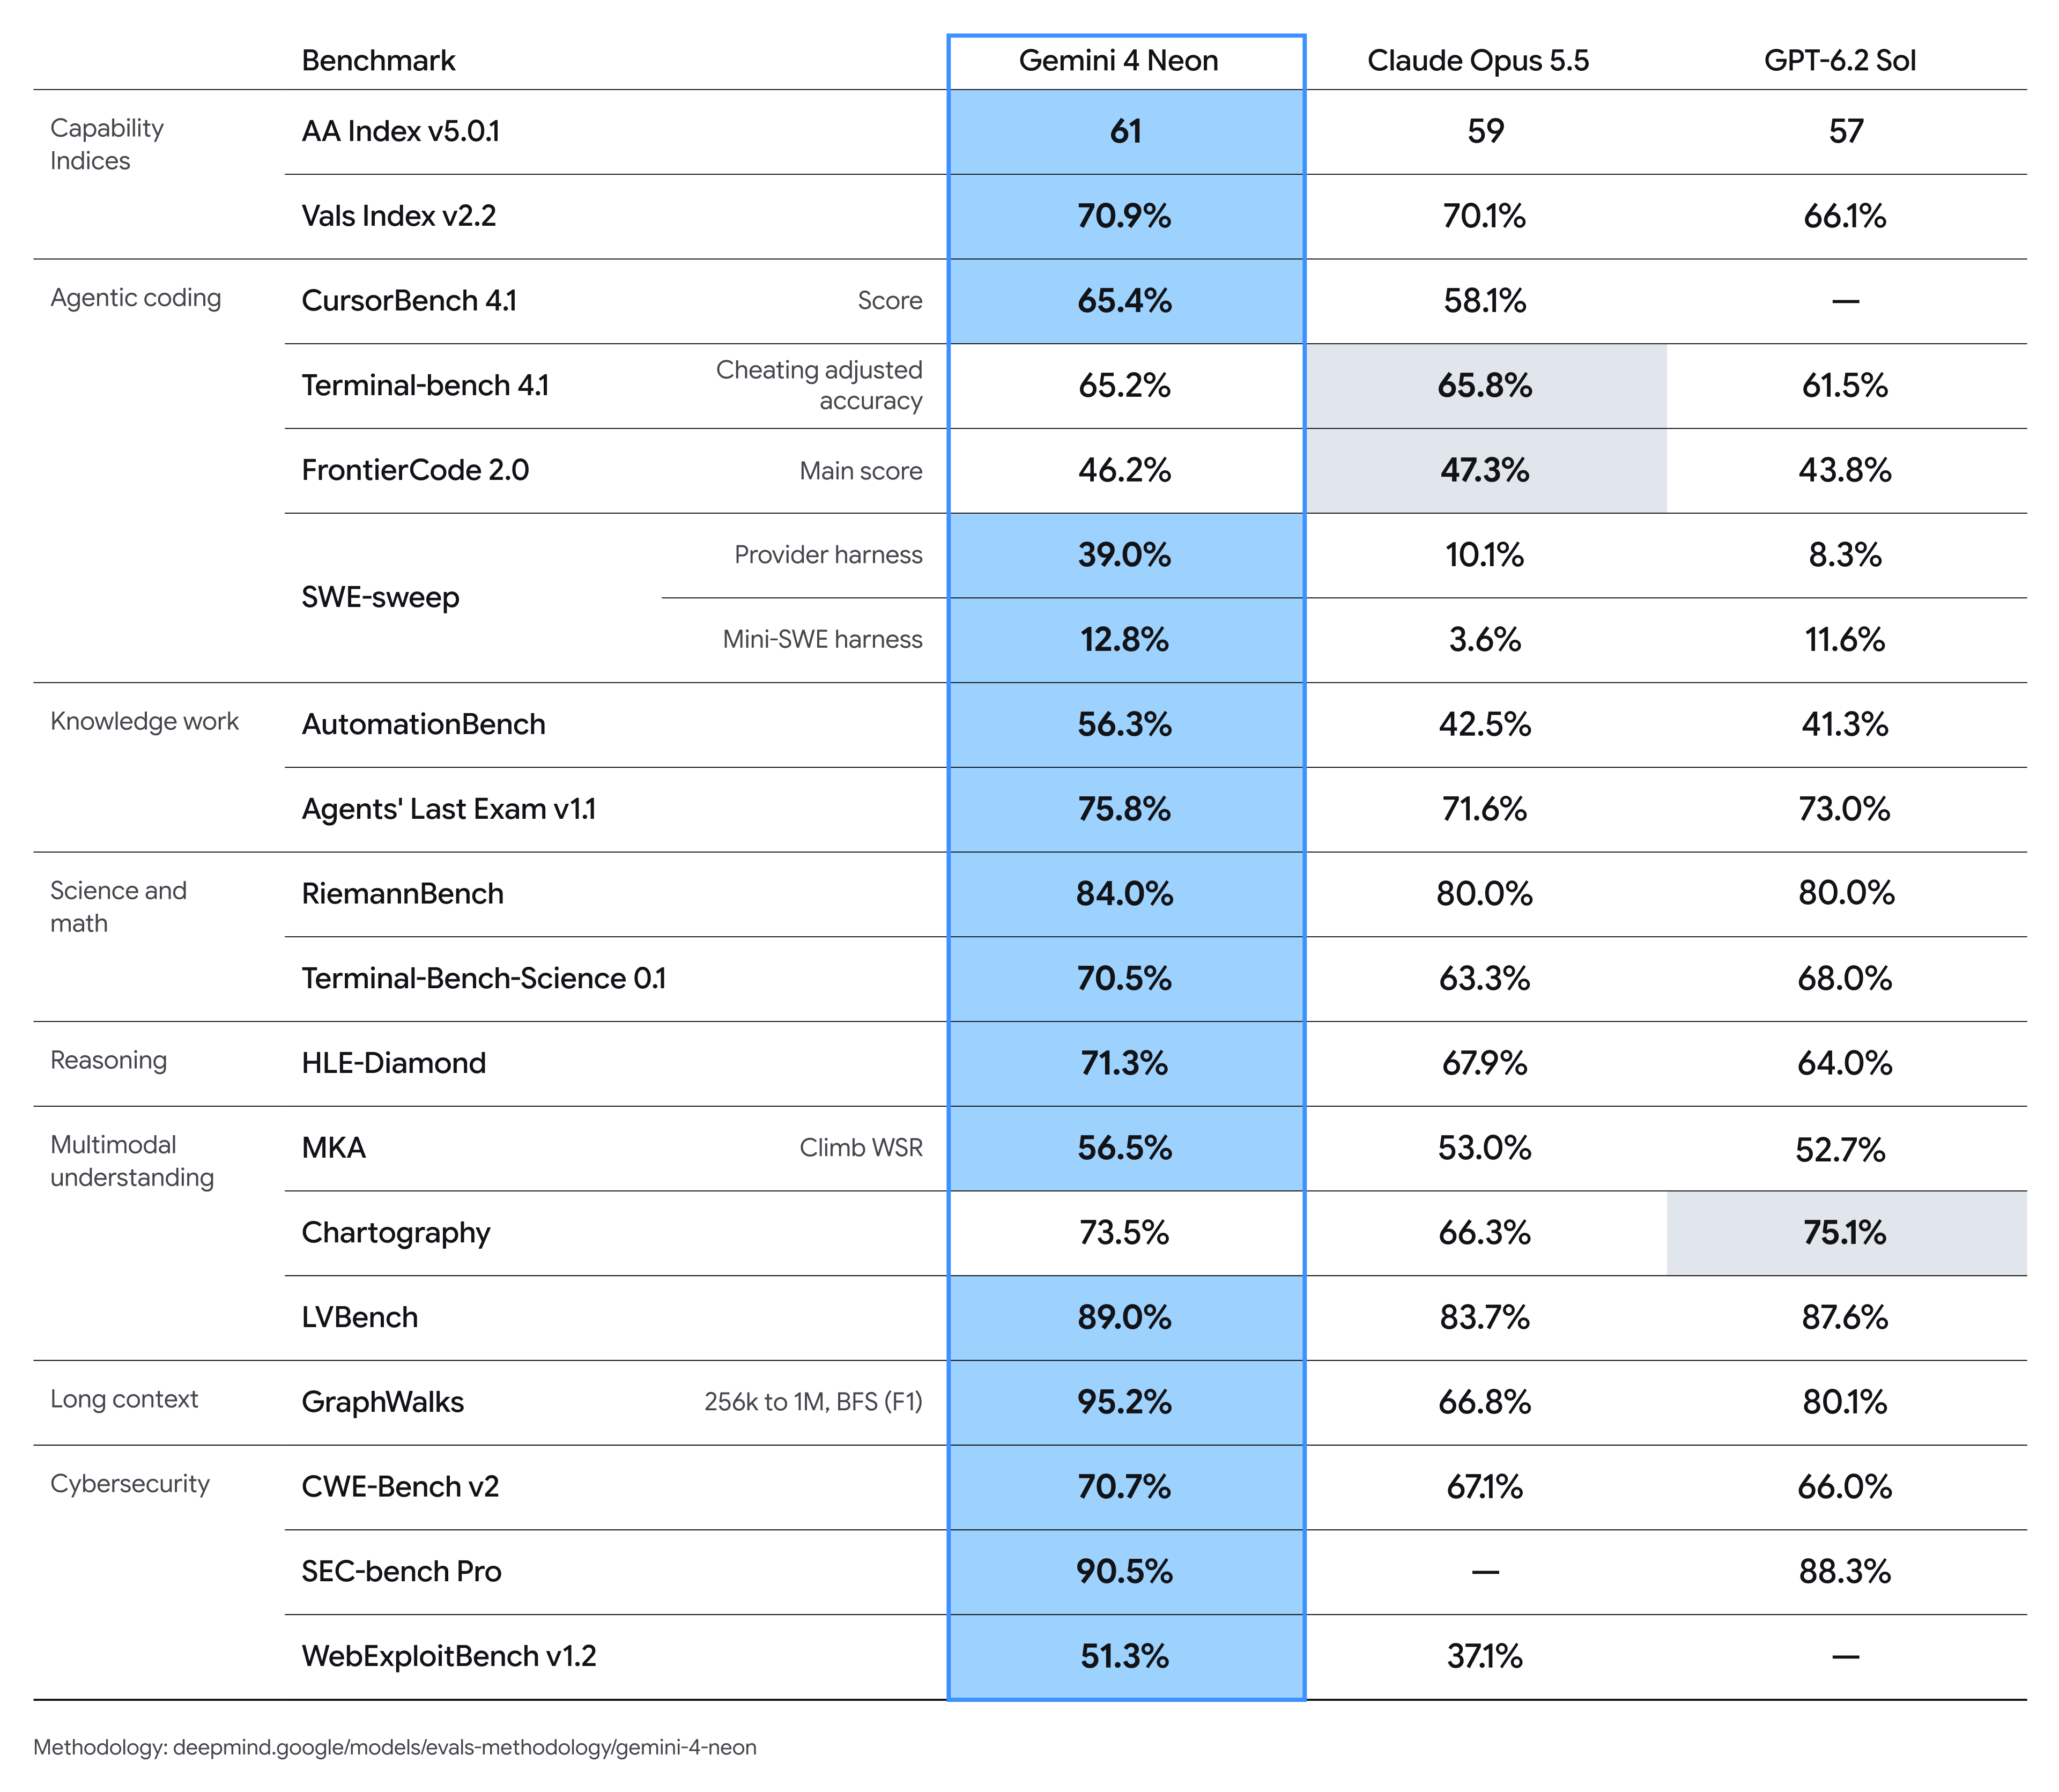
Google은 Vals AI의 Legal Research Bench와 Tax Agent Bench에서도 1위를 기록했다고 밝혔습니다.
Gemini 4 Neon 코딩 벤치마크
Neon이 가장 강점을 보이는 분야는 코딩이며, 동시에 하네스가 가장 큰 영향을 미치는 분야이기도 합니다. Google의 평가 방법론 PDF에 각 코딩 항목이 어떻게 산출됐는지 설명되어 있습니다.
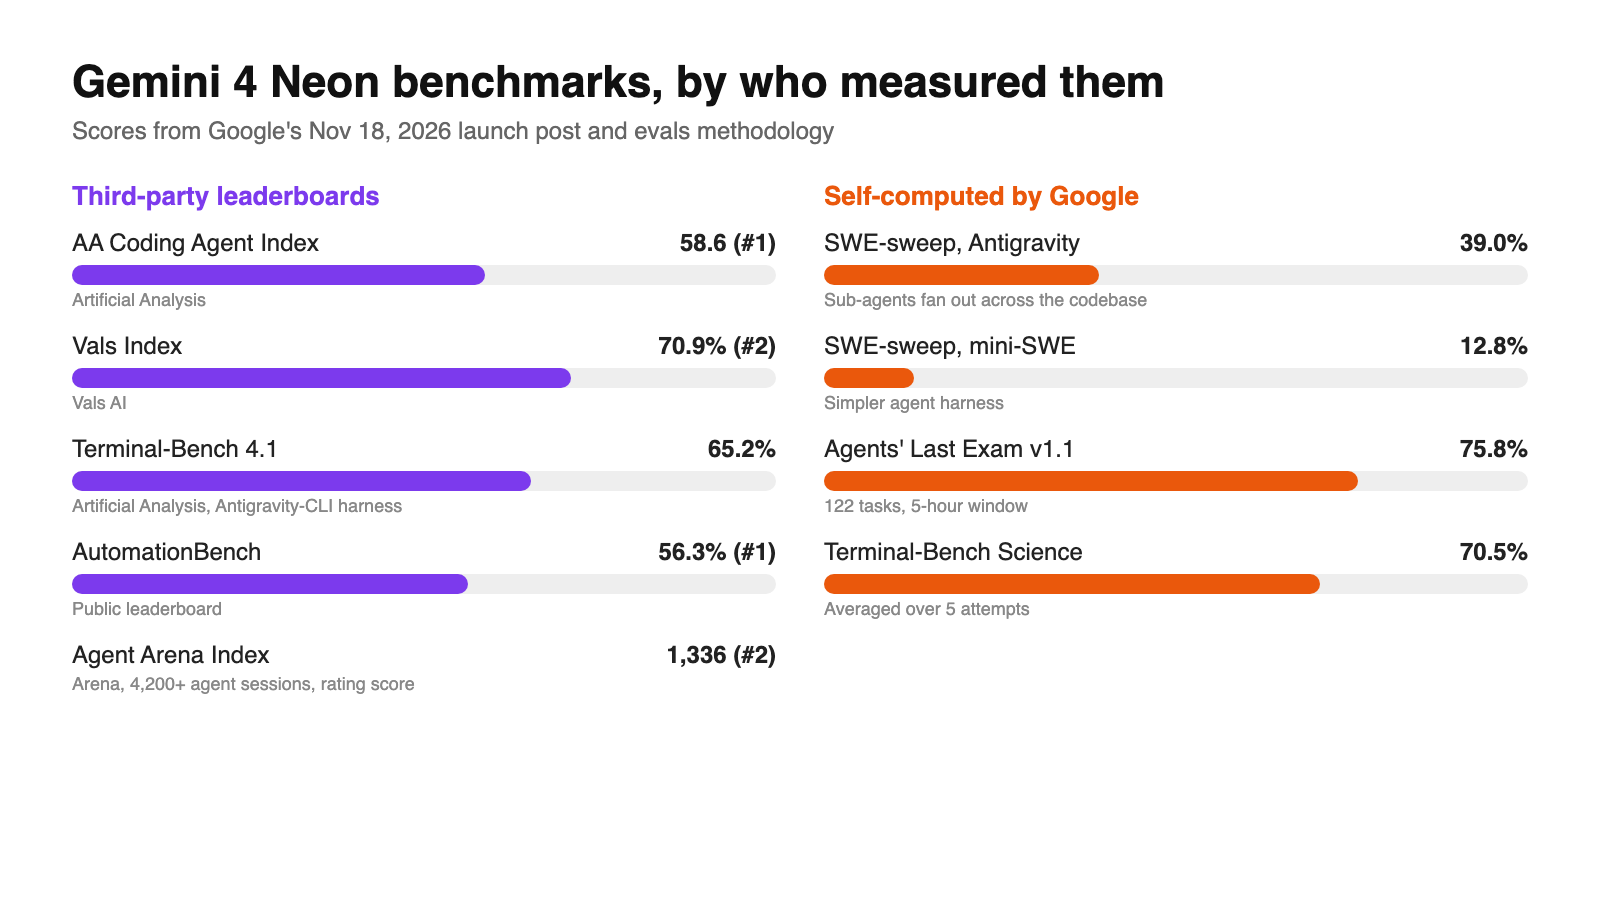
Artificial Analysis Coding Agent Index: 58.6, 1위. 독립적인 종합 지표이므로 Google의 환경에 가장 덜 영향을 받은 항목입니다. 현재 순위는 Artificial Analysis에서 확인할 수 있습니다.
Terminal-Bench 4.1: 65.2%. Artificial Analysis가 공개 Antigravity-CLI 하네스 1.5.9 버전으로 Neon을 실행했습니다. 다른 모델의 점수는 공식 리더보드에서 가져왔으며, 모든 결과는 부정행위 보정 정확도를 사용합니다. 공정한 방식이지만, Neon은 Google 자체 에이전트 도구 안에서 실행됐습니다.
FrontierCode 2.0: 46.2%. 공개 리더보드에서 가져온 항목이며, 프로덕션에서 기본으로 적용되는 high에서 실행됐습니다. 일상적인 트래픽에 대해 코딩 숫자 하나만 신뢰해야 한다면, 이 항목을 신뢰하시면 됩니다.
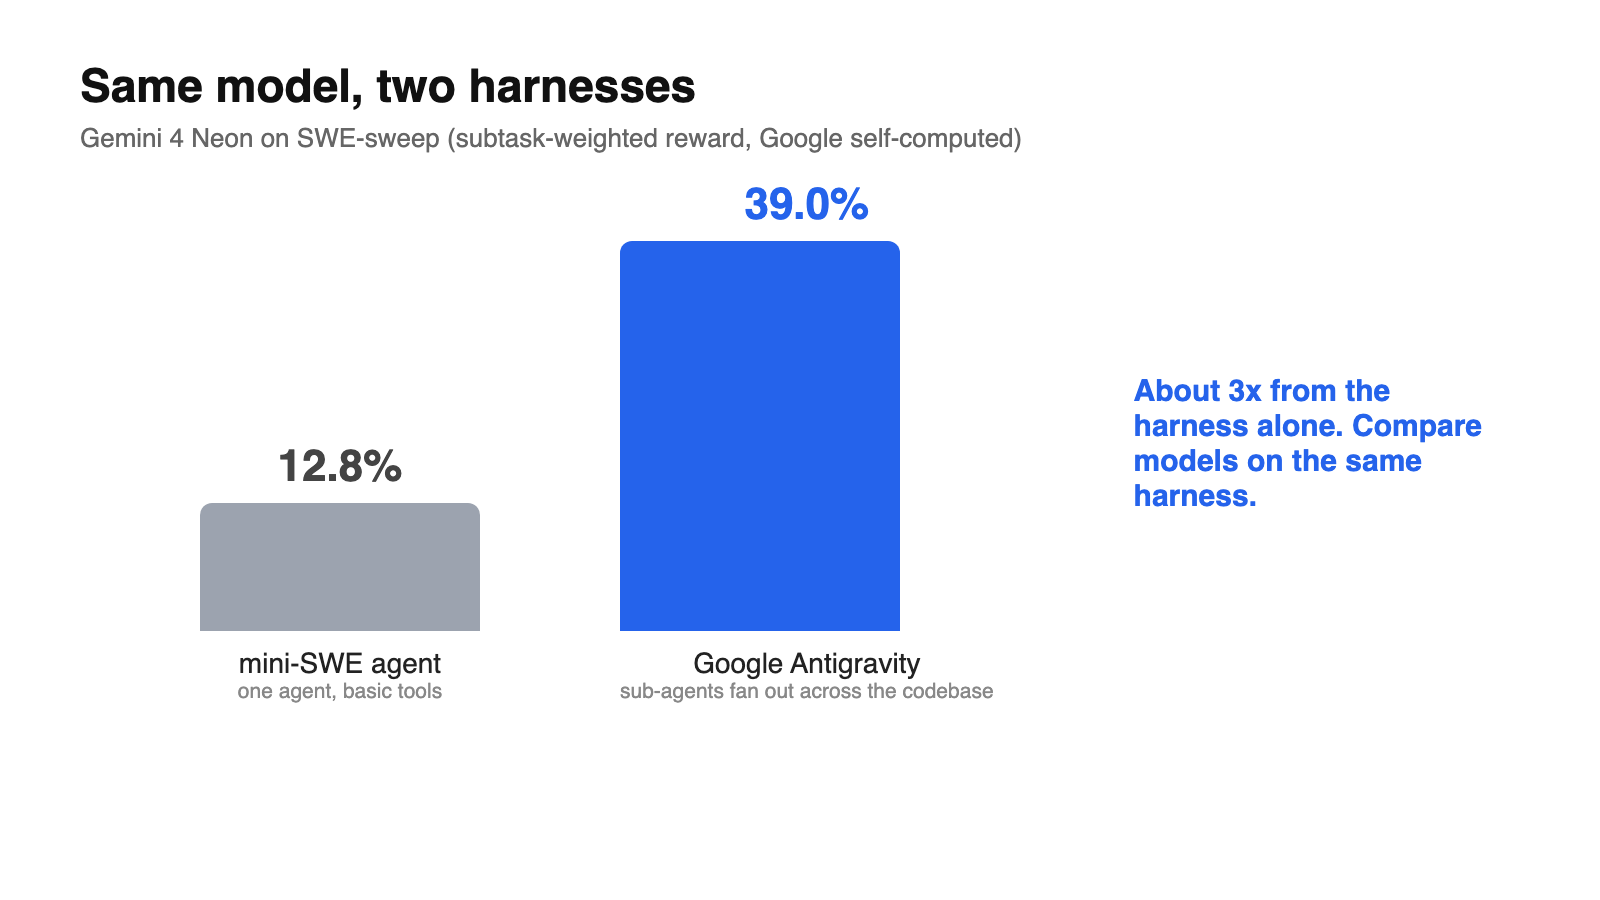
SWE-sweep: Antigravity에서 39.0%, mini-SWE에서 12.8%. 둘 다 Google이 자체 산출한 수치입니다. 3배 차이는 하네스에서 비롯됩니다. Google은 Antigravity-CLI에 서브 에이전트를 코드베이스 전반에 분산 배치하는 기본 도구가 포함되어 있으며, 이것이 버그 탐색 작업에 적합하다고 설명합니다. 동일한 비교에서 Opus 5.5는 Claude Code에서, GPT-6.2 Sol은 Codex에서 실행됐습니다. 12.8%는 모델 자체로, 39.0%는 모델과 최적의 도구를 결합한 결과로 해석하시면 됩니다.
에이전트 및 지식 노동 벤치마크
Neon을 여러 단계에 걸쳐 무인으로 운영할 계획이라면 다음 항목들이 중요합니다.
- Agent Arena Index: 1,336, 2위. 4,200건 이상의 실제 에이전트 세션을 기반으로 산출됐습니다. Google은 또한 Neon이 조종 가능성(steerability) 부문에서 2위를 기록했다고 밝혔는데, 이는 사용자가 작업 도중 수정을 가할 때 깔끔하게 적응한다는 뜻입니다.
- AutomationBench: 56.3%, 1위. Zapier의 비즈니스 자동화 벤치마크이며, 공개 리더보드에서 가져왔습니다.
- Vending-Bench 2: $16,843, 1위. Andon Labs의 장기 지평 비즈니스 운영 시뮬레이션입니다. 점수는 백분율이 아니라 벌어들인 금액입니다.
- Agents' Last Exam v1.1: 75.8%. Antigravity-CLI 1.4.8에서 실행당 5시간의 시간 제한을 두고 122개 과제 세트로 자체 산출했습니다. Opus 5.5의 점수는 공개 리더보드에서, GPT-6.2 Sol의 점수는 시스템 카드에서 가져왔으므로 설정이 서로 다릅니다.
- Chartography: 73.5%. 복잡한 전문 차트를 읽는 능력이며, 도구 없이 자체 산출했습니다.
과학 및 수학 분야에서 Neon은 Terminal-Bench Science에서 70.5%(자체 산출, 5회 시도 평균), RiemannBench에서 84.0%, HLE-Diamond에서 71.3%(Artificial Analysis 리더보드 기준)를 기록했습니다.
Google의 수치 산출 방식
방법론에서 나온 네 가지 규칙은 표를 읽는 방식을 바꿔놓습니다:
- 기본적으로 최고 사고 수준 사용. "별도 표시가 없는 한 모든 결과는 Gemini API에서 최고 사고 설정으로 실행됩니다." 즉
xhigh입니다. FrontierCode 2.0만 명시적으로high로 표시되어 있습니다. 프로덕션 호출은 기본값이high이므로, 사고 토큰이 더 적게 들고 점수도 표에 나온 것보다 낮을 수 있습니다. - Pass@1, 단일 시도. 별도 표시가 없는 한( Terminal-Bench Science는 5회 시도 평균) 다수결 투표나 병렬 테스트 타임 컴퓨트는 사용하지 않았습니다.
- 경쟁 모델 수치는 자체 보고. Gemini가 아닌 모델의 점수는 별도 표시가 없는 한 각 제공사에서 가져왔습니다. Opus 5.5와 GPT-6.2 Sol은 사용 가능한 경우 최대 추론 설정을 사용합니다.
- 사이버 항목을 제외하면 안전 필터 활성화. 사이버 보안 항목은 필터를 끈 상태로 실행됐습니다.
사고 수준 가이드에서 xhigh가 추가 토큰을 쓸 가치가 있는 경우를 다룹니다.
작업당 비용: 32% 절감 주장의 의미
작업당 비용은 벤치마크 과제 하나를 완료하는 데 드는 총 지출이며, 토큰당 가격이 아닙니다. 토큰 가격이 더 높은 모델이라도 더 적은 단계와 사고 토큰으로 정답에 도달하면 작업당 비용은 더 낮을 수 있습니다.
Google은 세 가지 비용 관련 주장을 내놓습니다:
| 주장 | 사고 수준 | 비교 대상 |
|---|---|---|
| AA Intelligence Index에서 높은 점수를 유지하면서 작업당 비용 32% 절감 | high |
Gemini 4 Carbon |
| Vals Index와 Agent Arena에서 작업당 비용 약 50~80% 절감 | high |
최상위 경쟁 프런티어 모델 |
| 작업당 비용 36% 이상 절감 | xhigh |
최고 설정의 경쟁 모델 |
주목할 불일치가 있습니다. 정확도 항목은 대부분 xhigh를 쓰는 반면, 대표적인 32% 절감은 high 기준입니다. 둘 다 사실이지만 동시에 성립하지는 않습니다. 비용 절감을 얻든 최고 점수를 얻든 둘 중 하나이며, 그 격차는 여러분이 직접 측정해야 합니다.
자체 작업당 비용을 추정하는 방법은 다음과 같습니다. 사고 토큰은 출력으로 청구됩니다.
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
입력 토큰 20,000개, 출력 토큰 4,000개인 코딩 작업의 비용은 $0.06 + $0.06 = $0.12입니다. 입력 토큰 중 15,000개가 캐시에 적중하면 $0.015 + $0.00225 + $0.06 = 약 $0.077로 떨어집니다. 같은 작업을 xhigh에서 실행하면 출력 개수가 변동하므로, 통과/실패 여부뿐 아니라 사고 수준별 토큰 수도 기록하세요. Gemini 4 Neon 가격 상세에서 Batch, Flex, Priority 요금을 다룹니다.
사이버 및 안전 항목
사이버 점수는 공개 API가 아니라 Fairwind Program을 통해 신뢰할 수 있는 방어자에게 제공되는 "사이버용 Gemini 4 Neon"에서 나온 것입니다.
| 벤치마크 | 점수 | 비고 |
|---|---|---|
| SEC-bench Pro | 90.5% | 최고 수준, 과제당 비용은 약 절반 |
| WebExploitBench v1.2 | 51.26% | 최고 수준, 대형 모델 대비 절반의 비용 |
| AutoBaxBench (hard 등급) | 76% | 최고 수준, 모든 등급에서 Carbon보다 안전한 코드 |
| CWE-bench v2 | 70.7% | Carbon 대비 3.4% 향상 |
| ExploitGym | 수치 미공개 | Carbon의 절반 토큰으로 프런티어 수준 달성 |
같은 글에 실린 안전 관련 수치: Neon은 Terminal-Bench 4.0 과제의 1.98%를 거부했고, Terminal-Bench 4.0에서 부정행위 점수 0.0%를 기록했으며, Google의 코딩 부정행위 평가에서 2.45%의 과제에서 편법을 사용했고, 에이전트 정직성 평가에서는 99.2%를 통과했습니다. 최고 사고 수준에서 실시간 안전장치를 켰을 때 Gray Swan의 간접 프롬프트 인젝션 벤치마크의 모든 공격을 방어했습니다.
Neon이 앞서지 못하는 분야
Neon이 모든 분야에서 1위인 것은 아니며, Google도 이를 인정합니다:
- Artificial Analysis Intelligence Index: 종합 3위로, "더 크고 느린 모델들에 살짝 뒤처집니다."
- Vals Index: 1위가 아닌 2위.
- Agent Arena Index: 2위.
Google은 또한 가장 어려운 장기 지평 프로젝트에는 여전히 Carbon을 권장합니다. 세 가지 Gemini 4 모델 중에서 고민 중이라면 Neon vs Carbon vs Hydrogen 비교에서 트레이드오프를 정리해 두었고, Gemini 4 Argon 벤치마크 글에서 이전 모델의 표를 어떻게 읽어야 하는지 확인할 수 있습니다.
Apidog CLI로 Gemini 4 Neon 직접 벤치마크하기
리더보드는 여러분의 제품이 아니라 Google의 하네스를 설명합니다. Neon이 그 가격만큼 가치가 있는지 확인하는 가장 빠른 방법은 코딩 에이전트가 동일한 프롬프트를 high와 xhigh에서 실행하고 각각의 토큰과 지연 시간을 기록하게 하는 것입니다.
Neon에는 무료 API 티어가 없으므로 유료 Gemini API 키가 필요합니다. 다음 요청은 Google의 문서화된 Interactions API 형식을 따르며, 이 글을 위해 실제로 실행해 보지는 않았습니다:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
Apidog CLI를 사용하면 Claude Code, Codex, Cursor, OpenCode에서 터미널로 API 테스트를 만들고 실행할 수 있습니다. 한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 에이전트에 프롬프트 하나를 주면 됩니다:
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
에이전트는 환경을 만들고, 테스트 케이스 페이로드를 스키마와 대조해 검증한 뒤, 사고 수준마다 한 번씩 실행합니다:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
프롬프트가 길다면 --timeout-request 900000을 추가하세요. 어려운 xhigh 실행은 몇 분이 걸릴 수 있습니다. 프롬프트가 바뀔 때마다 비교를 다시 실행하려면 동일한 apidog run ... -r junit을 Apidog CLI CI/CD 가이드와 함께 CI에 넣거나, Claude Code에서의 Apidog CLI에서 시작하세요. Apidog의 무료 플랜은 최대 4명의 사용자까지 지원합니다.
FAQ
Gemini 4 Neon의 가장 뛰어난 벤치마크 결과는 무엇인가요? Artificial Analysis Coding Agent Index에서 58.6으로 1위, 그리고 AutomationBench(56.3%)와 Vending-Bench 2($16,843)에서도 1위를 차지했습니다.
벤치마크는 어떤 사고 수준에서 실행됐나요? 대부분 xhigh(최고 설정)입니다. Google의 방법론에 따르면 별도 표시가 없는 한 최고 사고 설정으로 결과를 산출합니다. FrontierCode 2.0(46.2%)만 기본값인 high로 표시되어 있습니다.
Gemini 4 Neon이 Carbon보다 작업당 저렴한가요? Google은 high에서 작업당 비용이 32% 낮다고 밝혔습니다. 이는 벤치마크 실행에서 나온 작업당 수치이므로, 트래픽을 옮기기 전에 여러분의 프롬프트에서 직접 확인하세요.
Neon이 SWE-sweep에서 39.0%와 12.8%를 받는 이유는 무엇인가요? 하네스가 다르기 때문입니다. 39.0%는 서브 에이전트를 코드베이스 전반에 분산하는 Google Antigravity 내부 결과이고, 12.8%는 더 단순한 mini-SWE 에이전트 결과입니다.
Gemini 4 Neon의 벤치마크는 독립적인가요? 일부만 그렇습니다. Artificial Analysis, Vals, Arena, AutomationBench, FrontierCode 항목은 제3자가 측정했습니다. SWE-sweep, Agents' Last Exam, Terminal-Bench Science는 Google이 자체 산출했습니다.