Gemini 4 Neon API는 모델 ID로 gemini-4-neon을 사용합니다. https://generativelanguage.googleapis.com/v1beta/interactions로 POST 요청을 보내고, x-goog-api-key 헤더에 API 키를 담고, JSON 본문에 model과 input을 넣으면 호출할 수 있습니다. 이 모델은 유료 등급에서만 실행되며, 입력 토큰 백만 개당 3달러, 출력 토큰 백만 개당 15달러이고, 기본 thinking 레벨은 high입니다.
이 가이드에서는 Neon만의 차별점, 즉 유료 등급 설정, 다른 Gemini 4 모델에서의 전환, 64K 토큰을 넘는 출력, Neon과 Hydrogen의 조합, 비용 관리 방법을 다룹니다. 모든 필드 이름은 Google 공식 문서를 기준으로 합니다.
첫 Gemini 4 Neon API 호출 전에 무엇이 필요한가요?
결제가 설정된 프로젝트의 Gemini API 키, 모델 ID gemini-4-neon, 그리고 Interactions 엔드포인트가 필요합니다. Google은 2026년 11월 18일, Gemini 4 계열의 중간 모델로서 Hydrogen과 Carbon 사이에 위치한 Neon을 출시했습니다.
| 항목 | 값 |
|---|---|
| 모델 ID | gemini-4-neon |
| 엔드포인트 | generativelanguage.googleapis.com의 POST /v1beta/interactions |
| 인증 헤더 | x-goog-api-key: $GEMINI_API_KEY |
| API | Interactions API 및 generateContent |
| Thinking 레벨 | low, medium, high (기본값), xhigh |
| 컨텍스트 윈도우 | 1,048,576 토큰 (입력, thinking, 출력이 공유) |
| 동기 호출당 출력 | 65,536 토큰 |
| 롱 디코드(Long decode) | 입력 토큰을 제외한 최대 1,048,576 토큰 |
| 무료 등급 | 없음 |
| 유료 가격 | 입력 $3.00 / 1M, 출력 $15.00 / 1M (thinking 포함) |
| 캐시된 입력 | 암시적 캐싱 사용 시 $0.15 / 1M |
PDF 처리, 함수 호출, 스트리밍의 경우 요청 형식은 Gemini 4 Hydrogen API 가이드와 동일하며, 모델 ID만 바꾸면 됩니다.
Neon에서 사용할 수 있는 Gemini API 키는 어떻게 발급받나요?
Neon은 무료 등급에 포함되어 있지 않으므로 키만으로는 부족합니다. 키가 속한 프로젝트에 결제가 설정되어 있어야 합니다.
- Google AI Studio에서 API 키 페이지를 열어 키를 생성하거나, 기존에 갖고 있던 키를 재사용하세요.
- 키의 프로젝트가 유료 등급인지 확인하세요. Google 가이드에도 명확히 나와 있습니다: “Neon은 유료 등급에서만 사용할 수 있습니다(무료 등급 제외).”
- 키를 내보내세요:
export GEMINI_API_KEY="YOUR_API_KEY". Google GenAI SDK는 이 값을 자동으로 읽어옵니다. - 대량 배치 작업을 계획하기 전에 rate limits 페이지에서 유료 등급의 속도 제한을 확인하세요. [VERIFY: Neon의 등급별 RPM 및 TPM 수치]
첫 Gemini 4 Neon API 요청은 어떻게 보내나요?
Interactions 엔드포인트에 model과 input을 보내면 됩니다. Google 퀵스타트 문서에 나온 형식은 다음과 같습니다:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Review this Go handler for missing error checks and suggest fixes."
  }'
Python SDK(pip install -U google-genai)를 사용한 동일한 호출:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Review this Go handler for missing error checks and suggest fixes.",
)

print(interaction.output_text)
print(interaction.usage)
테스트하는 동안에는 모든 응답에서 usage를 확인하세요. thinking 토큰은 출력 요율인 $15로 과금되므로, 비용이 커지는 지점은 바로 thinking 토큰 수입니다.
이 스니펫들은 Google의 가이드를 따른 것으로, 이 글을 쓰면서 직접 실행해 본 것은 아닙니다. 응답 형식은 직접 첫 호출을 해서 확인해 보세요.
Hydrogen이나 Carbon에서 전환할 때 무엇이 달라지나요?
이미 다른 Gemini 4 모델을 사용 중이라면, 전환을 위해 요청 스키마를 바꿀 필요가 없습니다. model 문자열만 변경하고 다음 세 가지를 확인하세요:
| 확인 항목 | Neon | Hydrogen | Carbon 및 Argon |
|---|---|---|---|
| 기본 thinking 레벨 | high |
high |
medium |
| 최고 레벨 | xhigh |
xhigh |
high |
| 1M당 입력 / 출력 가격 | $3 / $15 | $1.50 / $7.50 | Carbon 가격 참조 |
Carbon이나 Argon에서 넘어온 경우라면, 기본값이 medium에서 high로 바뀌기 때문에 같은 프롬프트에서도 thinking 토큰이 더 많이 소모됩니다. 이전 동작을 유지하려면 thinking_level을 명시적으로 설정하세요:
interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions.",
    generation_config={"thinking_level": "medium"},
)
Gemini 3.8 Flash 이하 버전에서 넘어온 경우라면, 확인할 항목이 더 많습니다. Google의 마이그레이션 체크리스트에 따르면:
- 낮은 출력 상한을 올리세요.
max_output_tokens는 thinking과 답변을 합쳐서 계산합니다. 8,192처럼 하드코딩된 상한을 제거하거나 65,536으로 올리고, 비용을 줄여야 한다면 thinking 레벨을 낮추세요. minimal을 제거하세요. Neon은 이 값에 대해 오류를 반환합니다.- 샘플링 파라미터를 제거하세요. 서버는 범위 내의
temperature,top_p,top_k를 무시하며, 범위를 벗어난 값은400을 반환합니다. - 명시적 캐싱을 걷어내세요. Neon은
cachedContents나caches.create를 지원하지 않으므로,cached_content필드를 제거하세요. - 도구는 네이티브로 선언하세요. 선언된 도구 없이 raw JSON 도구 호출을 프롬프트로 유도하면
MALFORMED_FUNCTION_CALL이 반환될 수 있습니다. 함수 호출이나 구조화된 출력을 사용하세요.
Neon에서 64K 토큰 이상의 출력을 얻으려면 어떻게 하나요?
동기 요청은 스트리밍 여부와 관계없이 65,536 토큰에서 멈춥니다. 전체 마이그레이션 명세와 그 테스트 스위트처럼 더 긴 출력이 필요하다면, background를 true로 설정하고 max_output_tokens를 65,536 이상으로 올리세요. 그러면 Google 서버가 설정한 상한에 도달할 때까지 64K 토큰 단위로 생성을 계속합니다.
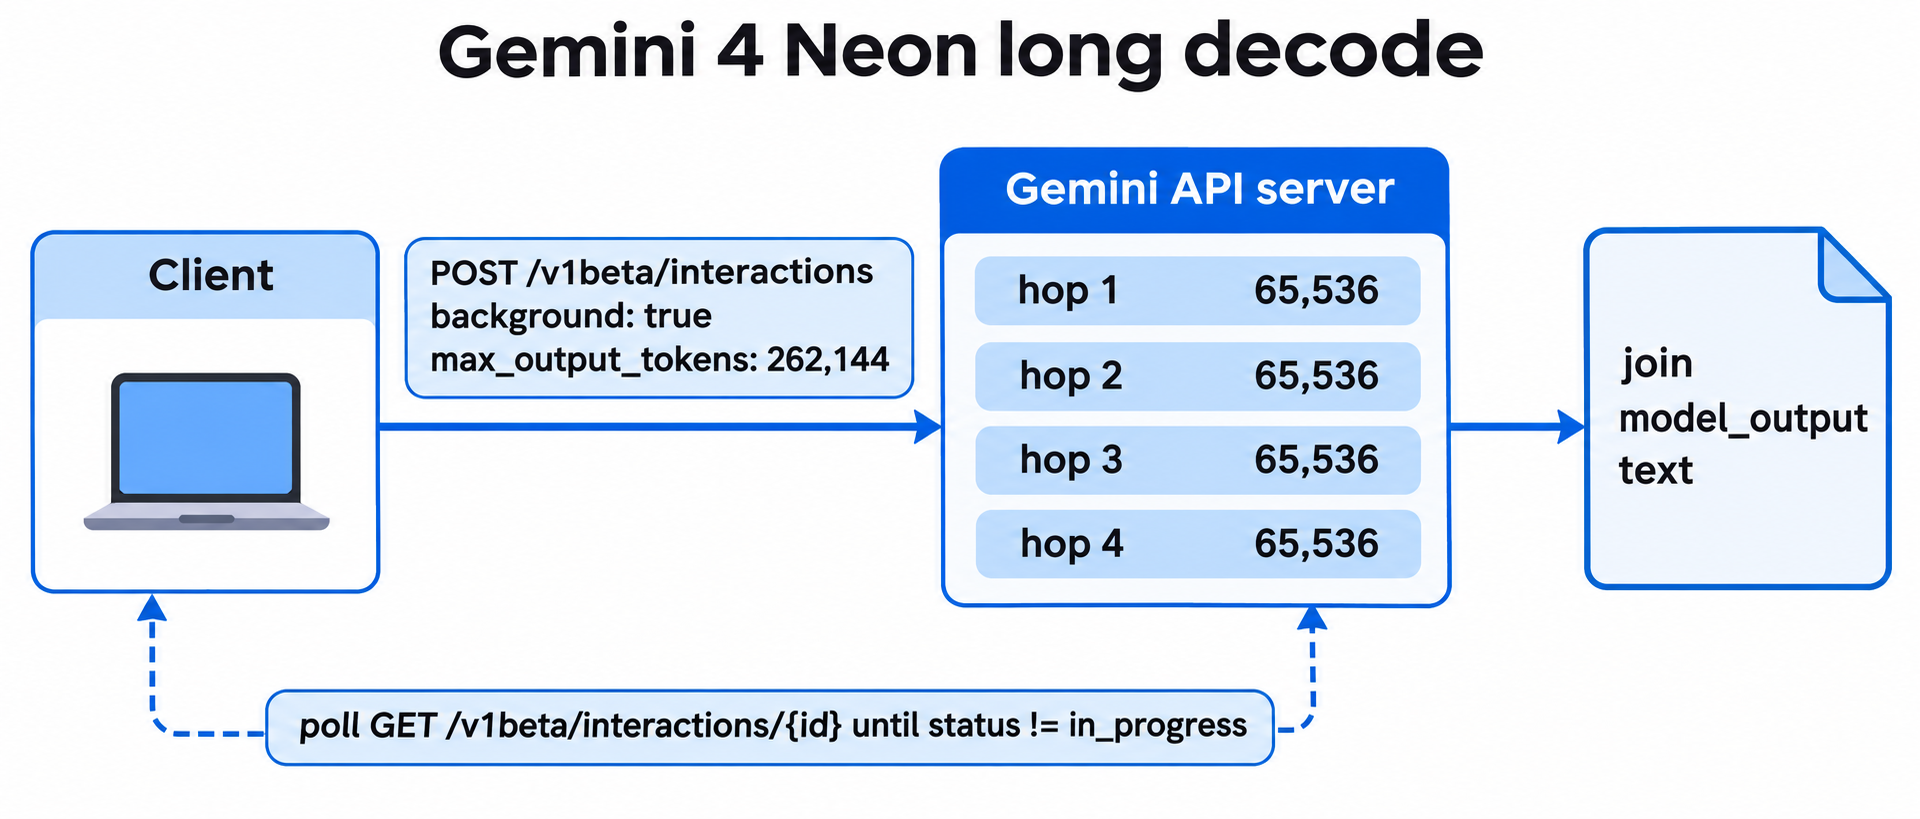
작업을 시작하고 id를 저장하세요:
export ID=$(curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-neon",
    "input": "Generate a complete multi-module migration specification and test suite for this service.",
    "background": true,
    "generation_config": {
      "max_output_tokens": 262144,
      "thinking_level": "high"
    }
  }' | jq -r '.id')
그다음 완료될 때까지 폴링하면서 각 단계의 텍스트를 합칩니다(Python, 내보낸 ID 사용):
import os, time

interaction = client.interactions.get(id=os.environ["ID"])
while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

text = "".join(
    c.text
    for step in interaction.steps if step.type == "model_output"
    for c in step.content if c.type == "text"
)
Google 가이드의 세 가지 규칙을 지키면 문제를 피할 수 있습니다:
max_output_tokens없이background만 설정하면, 서버는 65,536 토큰에서 멈춥니다.- 상한은 입력 토큰을 제외한 최대 1,048,576까지 설정할 수 있습니다. Google은 길고 여러 단계로 이루어진 작업에는 131,072 또는 262,144를 권장합니다.
- 복잡한 프롬프트는 몇 분씩 걸릴 수 있습니다. 백그라운드 모드를 사용하거나, HTTP 클라이언트 타임아웃을 최소 15분으로 설정하세요.
상호작용 데이터를 Google 쪽에 저장하고 싶지 않다면, 롱 디코드 가이드에서 최신 SDK의 클라이언트 측 이어쓰기(continuation) 방법도 문서화하고 있습니다.
Neon과 Hydrogen은 어떻게 조합하나요?
판단이 필요한 작업에는 Neon을, 대량 처리에는 Hydrogen을 사용하세요. Neon이 워크플로를 계획하거나 검토한 다음, 그 interaction의 id를 previous_interaction_id로 전달하여 단일 단계를 수행하는 gemini-4-hydrogen 호출을 하면 됩니다. Google의 Cloud 개발자 가이드에서 이 패턴을 보여줍니다:
plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
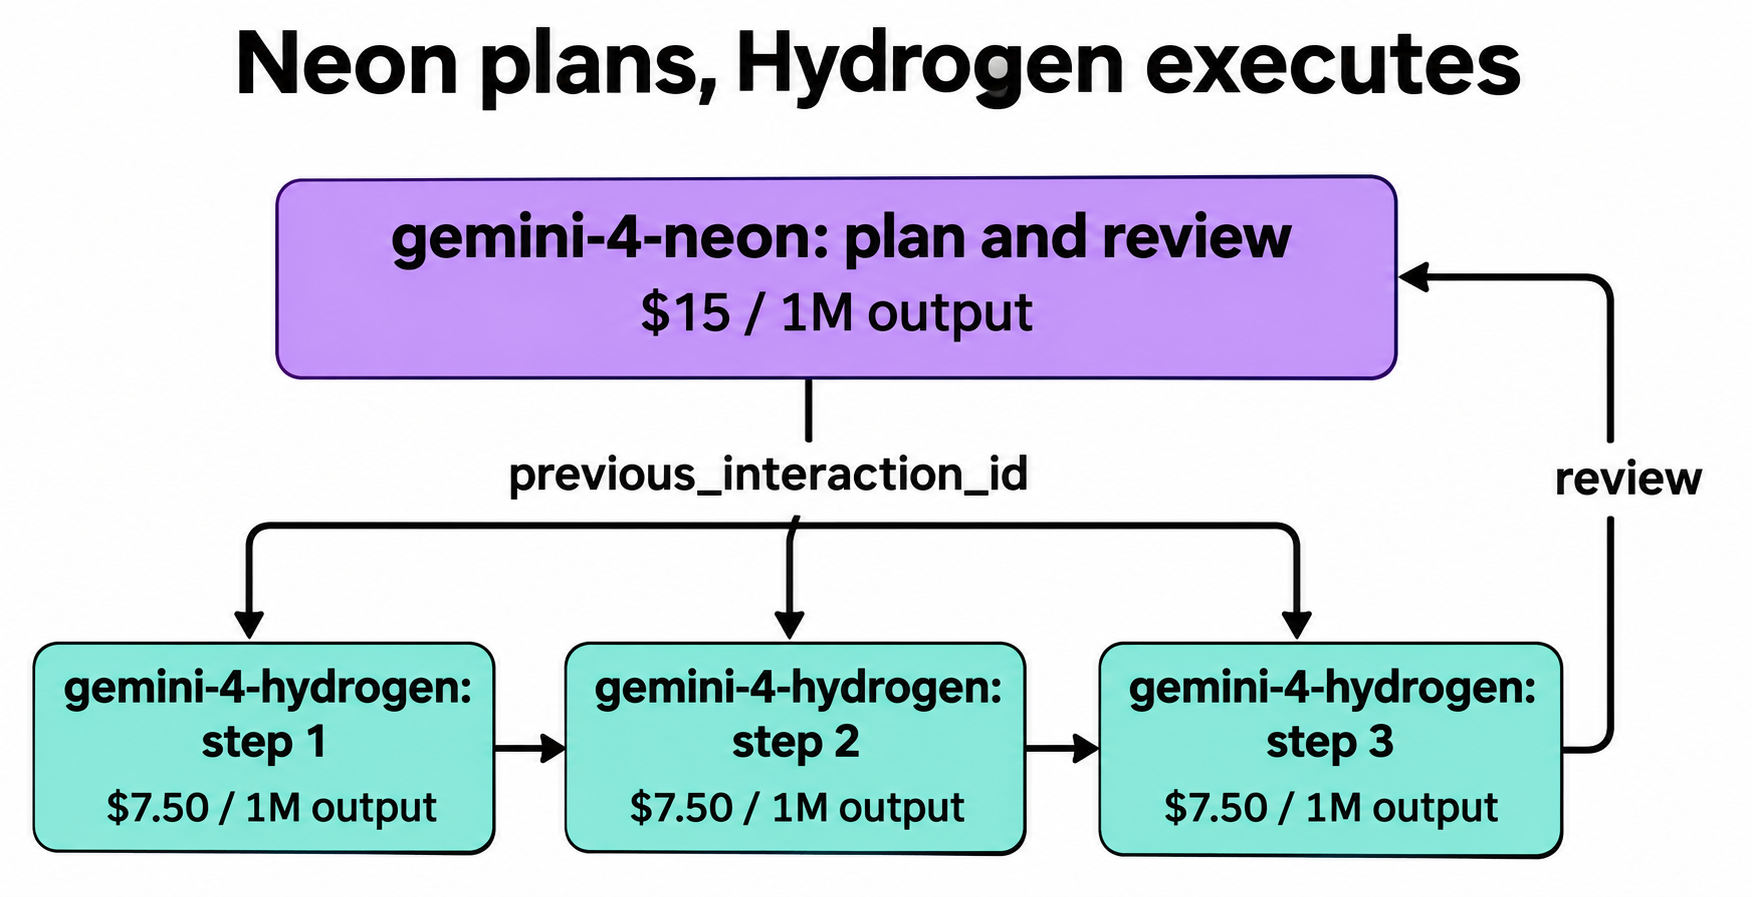
Hydrogen이 Neon 대신 생성하는 출력 토큰 하나하나가 비용을 절반으로 줄여줍니다. Gemini 4 Hydrogen 오케스트레이터 가이드에서 Carbon을 플래너로 사용하는 같은 루프를 자세히 다룹니다.
Gemini 4 Neon API 비용은 어떻게 낮출 수 있나요?
통상적으로 효과가 큰 순서대로 정렬한 네 가지 방법입니다:
- 통과하는 수준 중 가장 낮은 thinking 레벨을 고르세요. Google의 조언은 높은
max_output_tokens로 네 가지 레벨 모두에서 평가를 실행한 다음, 품질 기준을 충족하는 가장 낮은thinking_level을 선택하는 것입니다. - 긴 프롬프트를 재사용하세요. 암시적 캐싱은 기본적으로 4,096 토큰 이상의 프롬프트에 적용되며, 캐시된 입력 비용을 백만 개당 $3.00에서 $0.15로, 95%나 절감합니다. 프롬프트에서 길고 안정적인 부분(시스템 텍스트, 문서, 스키마)은 앞쪽에 두세요.
- 실행은 Hydrogen에 맡기세요. 위의 조합 패턴을 참조하세요.
- 모든 토큰을 세세요. Google은 모델이 처리하는 모든 토큰에 과금합니다. 여기에는 thinking 토큰과 grounding 사용 시 추가되는 내부 지침도 포함됩니다. Google Search를 이용한 grounding은 쿼리당 과금됩니다.
간단한 계산 예시: 입력 20,000 토큰, 출력 8,000 토큰(thinking 포함)인 호출은 입력에 $0.06, 출력에 $0.12가 들어 정가 기준 $0.18입니다.
Apidog CLI로 코딩 에이전트가 Neon과 Hydrogen을 비교하게 하세요
당신의 프롬프트에서 Neon이 Hydrogen의 두 배 가격 값을 할까요? 코딩 에이전트(Claude Code, Codex, Cursor)가 Apidog CLI로 테스트 케이스를 하나 만들어 두 모델에 대해 실행하도록 해보세요.
한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 에이전트에 프롬프트 하나를 주세요:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY,
MODEL (default "gemini-4-hydrogen") and THINKING (default "high"). Add an
endpoint for POST /v1beta/interactions with the x-goog-api-key header from
GEMINI_API_KEY. Create a test case that sends model {{MODEL}}, our code-review
prompt and generation_config.thinking_level {{THINKING}}, and asserts: HTTP 200,
status is "completed", a non-empty model_output step, and usage.total_tokens
exists. Run it for gemini-4-hydrogen and gemini-4-neon, then compare
usage.total_thought_tokens and usage.total_output_tokens.
에이전트는 무언가를 작성하기 전에 각 페이로드 스키마를 읽고 JSON을 검증합니다:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
각 실행의 토큰 수에 모델 가격을 곱하면, 출시 발표용 평균 수치가 아닌 당신의 프롬프트에 대한 실제 작업당 비용이 나옵니다. --upload-report를 추가하면 Apidog 앱에서 실행 결과를 볼 수 있고, -r cli,json을 -r junit으로 바꾸면 같은 검증을 CI에 넣을 수 있습니다. 파이프라인은 Apidog CLI CI/CD 가이드에서, 에이전트 설정은 Claude Code에서의 Apidog CLI에서 확인하세요. Apidog의 무료 플랜은 최대 4명까지 사용할 수 있습니다.
FAQ
Gemini 4 Neon의 모델 ID는 무엇인가요? gemini-4-neon입니다. Interactions API와 generateContent 모두에서 동작합니다.
Gemini 4 Neon API는 무료인가요? 아닙니다. Neon은 Gemini API의 유료 등급에서만 사용할 수 있으며, 입력 토큰 백만 개당 $3, 출력 토큰 백만 개당 $15입니다. Google AI Pro 및 Ultra 구독자는 AI Studio 채팅에서 사용해 볼 수 있습니다.
Hydrogen용으로 작성한 코드가 Neon에서도 동작하나요? 네. Google에 따르면 Gemini 4 모델 간 전환에는 요청 스키마 변경이 필요 없습니다. model 문자열만 업데이트한 다음, 기본 high thinking 레벨을 그대로 사용할지 결정하면 됩니다.
Gemini 4 Neon API의 최대 출력은 얼마인가요? 동기 요청당 65,536 토큰입니다. background를 true로 설정하고 max_output_tokens를 더 높게 지정하면, Neon은 입력을 제외한 1,048,576 토큰 윈도우까지 생성할 수 있습니다.
Gemini 4 Neon은 temperature를 지원하나요? 아니요. 서버는 범위 내의 temperature, top_p, top_k 값은 무시하고, 범위를 벗어난 값에는 400을 반환합니다. 품질과 속도·비용 사이의 균형은 thinking_level로 조절하세요.
Neon은 명시적 컨텍스트 캐싱을 지원하나요? 아니요. 요청에서 cached_content를 제거하세요. 암시적 캐싱은 4,096 토큰 이상의 프롬프트에 자동으로 계속 적용되며, 캐시된 입력은 95% 할인됩니다.