
Gemini 4 Hydrogen API는 모델 ID gemini-4-hydrogen을 사용합니다. https://generativelanguage.googleapis.com/v1beta/interactions로 POST 요청을 보내고, x-goog-api-key 헤더에 키를 담고, JSON 본문에 model과 input을 포함하면 됩니다. 무료 티어와 유료 티어(입력 $1.50, 출력 $7.50 / 1M 토큰) 모두에서 사용할 수 있으며, 기본 thinking 레벨은 high입니다.
이 가이드는 전 과정을 다룹니다: 키 발급, 첫 요청, thinking 레벨, PDF 처리, 함수 호출, 스트리밍, 오류 처리까지. 모든 필드 이름은 Google 공식 문서에서 가져온 것입니다.
첫 Gemini 4 Hydrogen API 호출 전에 무엇이 필요한가요?
Gemini API 키, 모델 ID gemini-4-hydrogen, 그리고 Interactions 엔드포인트가 필요합니다. Google은 2026년 11월 12일 Carbon과 Argon과 함께 빠른 Gemini 4 모델인 Hydrogen을 출시했습니다(Gemini 4 Hydrogen이란?).
| 항목 | 값 |
|---|---|
| 모델 ID | gemini-4-hydrogen |
| 엔드포인트 | generativelanguage.googleapis.com의 POST /v1beta/interactions |
| 인증 헤더 | x-goog-api-key: $GEMINI_API_KEY |
| API | Interactions API 및 generateContent |
| Thinking 레벨 | low, medium, high(기본값), xhigh |
| 컨텍스트 윈도우 | 1,048,576 토큰 (입력, thinking, 출력이 공유) |
| 동기식 호출당 출력 | 65,536 토큰 (스트리밍 여부와 무관) |
| 무료 티어 | 있음, 속도 제한 적용 |
| 유료 가격 | 입력 $1.50 / 1M, 출력 $7.50 / 1M (thinking 포함) |
| 캐시된 입력 | 암시적 캐싱을 통해 $0.075 / 1M |
Google 문서에서는 generateContent를 레거시로 분류하므로, 여기서는 Interactions를 사용한 예제를 다룹니다.
Hydrogen용 Gemini API 키는 어떻게 발급받나요?
Hydrogen은 무료 티어에 포함되어 있어 결제 설정 없이 시작할 수 있습니다:
- Google AI Studio에서 API 키 페이지를 엽니다.
- Create API key를 클릭합니다. AI Studio에서 생성한 새 키는 서비스 계정에 바인딩되는 인증 키입니다.
- 키를 내보냅니다:
export GEMINI_API_KEY="YOUR_API_KEY". SDK는GEMINI_API_KEY또는GOOGLE_API_KEY를 읽으며, 둘 다 설정된 경우GOOGLE_API_KEY가 우선합니다. - AI Studio 외부에서 생성된 Cloud 프로젝트는 무료 티어를 사용하기 전에 프로젝트 인증이 필요할 수 있습니다.
Google은 무료 티어 수치를 시작 가이드가 아닌 속도 제한 페이지에 공개합니다. $0에서 얻을 수 있는 내용은 Gemini 4 Hydrogen 무료 가이드를 참고하세요.
첫 Gemini 4 Hydrogen API 요청은 어떻게 보내나요?
Interactions 엔드포인트에 model과 input을 전송합니다. 모델을 변수로 두면 모델 교체가 한 줄 수정으로 끝납니다.
export GEMINI_MODEL="gemini-4-hydrogen"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Write a Python function that retries an HTTP call with exponential backoff."
  }'
Python SDK(pip install -U google-genai)로 보내는 동일한 호출:
import os
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model=os.environ.get("GEMINI_MODEL", "gemini-4-hydrogen"),
    input="Write a Python function that retries an HTTP call with exponential backoff.",
)

print(interaction.output_text)
print(interaction.usage)
응답에는 id, status, steps 배열이 포함됩니다. 텍스트는 model_output 스텝에, 추론 내용은 thought 스텝에 있으며, SDK의 output_text는 텍스트를 합쳐서 제공합니다. usage 객체에는 total_input_tokens, total_thought_tokens, total_output_tokens, total_tokens가 담겨 있습니다.
이 스니펫들은 Google의 퀵스타트를 따른 것입니다. 이 글을 쓰는 시점에 직접 실행해 보지는 않았습니다(테스트 머신에 Gemini 키가 없음), so 첫 응답의 형태를 직접 확인해 보세요.
Gemini 4 Hydrogen의 thinking 레벨은 어떻게 설정하나요?
generation_config 안에 thinking_level을 설정합니다. Hydrogen은 기본값이 high이고, 새로운 xhigh 레벨이 추가되었으며, minimal을 지정하면 오류가 발생합니다.
thinking_level |
토큰 사용량 | Google의 권장 용도 |
|---|---|---|
low |
가장 적은 토큰, 가장 낮은 지연 시간 | 빠른 채팅, 대량 처리 작업 |
medium |
적은 토큰, 빠른 속도 | 대화형 코딩, 실시간 UI 프로토타이핑, 빠른 도구 호출 |
high(기본값) |
균형 | 복잡한 코딩, 에이전트 실행, 멀티모달 문서 작업 |
xhigh |
가장 많은 토큰, 가장 깊은 추론 | high로 부족한 어려운 다단계 문제 |
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "medium",
      "max_output_tokens": 65536
    }
  }'
기억할 규칙이 두 가지 있습니다. max_output_tokens는 thinking과 출력을 합쳐서 제한하기 때문에 예전의 낮은 상한(예: 8,192)은 답변을 중간에 자를 수 있습니다. Google은 상한을 65,536으로 올리고 대신 thinking 레벨을 낮추라고 권고합니다. 그리고 thinking 토큰은 $7.50의 출력 요금으로 청구되므로, 눈에 보이는 답변 길이가 같더라도 xhigh는 더 많은 비용이 듭니다. 레벨별 비용은 Gemini 4 Hydrogen 가격 분석에서 자세히 계산해 볼 수 있습니다.
또한 Google은 Hydrogen에서 서버가 temperature, top_p, top_k를 무시한다고 밝혔으므로 요청에서 제거하세요.
Gemini 4 Hydrogen에 PDF는 어떻게 보내나요?
input 배열에 지시문이 담긴 text 항목과 함께 document 항목을 추가합니다. 작은 파일은 PDF를 base64로 인라인 전송하면 됩니다:
PDF_PATH="invoice.pdf"
B64=$(base64 < "$PDF_PATH" | tr -d '\n')

curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": [
      {"type": "document", "data": "'"$B64"'", "mime_type": "application/pdf"},
      {"type": "text", "text": "Extract the line items as a table."}
    ]
  }'
더 큰 파일이나 여러 턴에 걸친 재사용에는 Files API로 한 번 업로드(무료, 48시간 보관)한 뒤 {"type": "document", "uri": "<file uri>", "mime_type": "application/pdf"}를 대신 전달하세요. 문서 처리 가이드에 따르면 PDF는 최대 50MB 또는 1,000페이지까지 가능하며, 모델은 텍스트뿐 아니라 그 안의 차트, 표, 이미지까지 읽습니다.
Gemini 4 Hydrogen에서 함수 호출은 어떻게 작동하나요?
tools에 함수를 선언합니다. 모델은 아무것도 실행하지 않고 function_call 스텝을 반환하고, 여러분의 코드가 함수를 실행한 뒤 function_result를 돌려보냅니다. Google의 함수 호출 가이드에서 가져온 첫 단계입니다:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "What'\''s the temperature in London?",
    "tools": [{
      "type": "function",
      "name": "get_current_temperature",
      "description": "Gets the current temperature for a given location.",
      "parameters": {
        "type": "object",
        "properties": {
          "location": {"type": "string", "description": "The city name"}
        },
        "required": ["location"]
      }
    }]
  }'
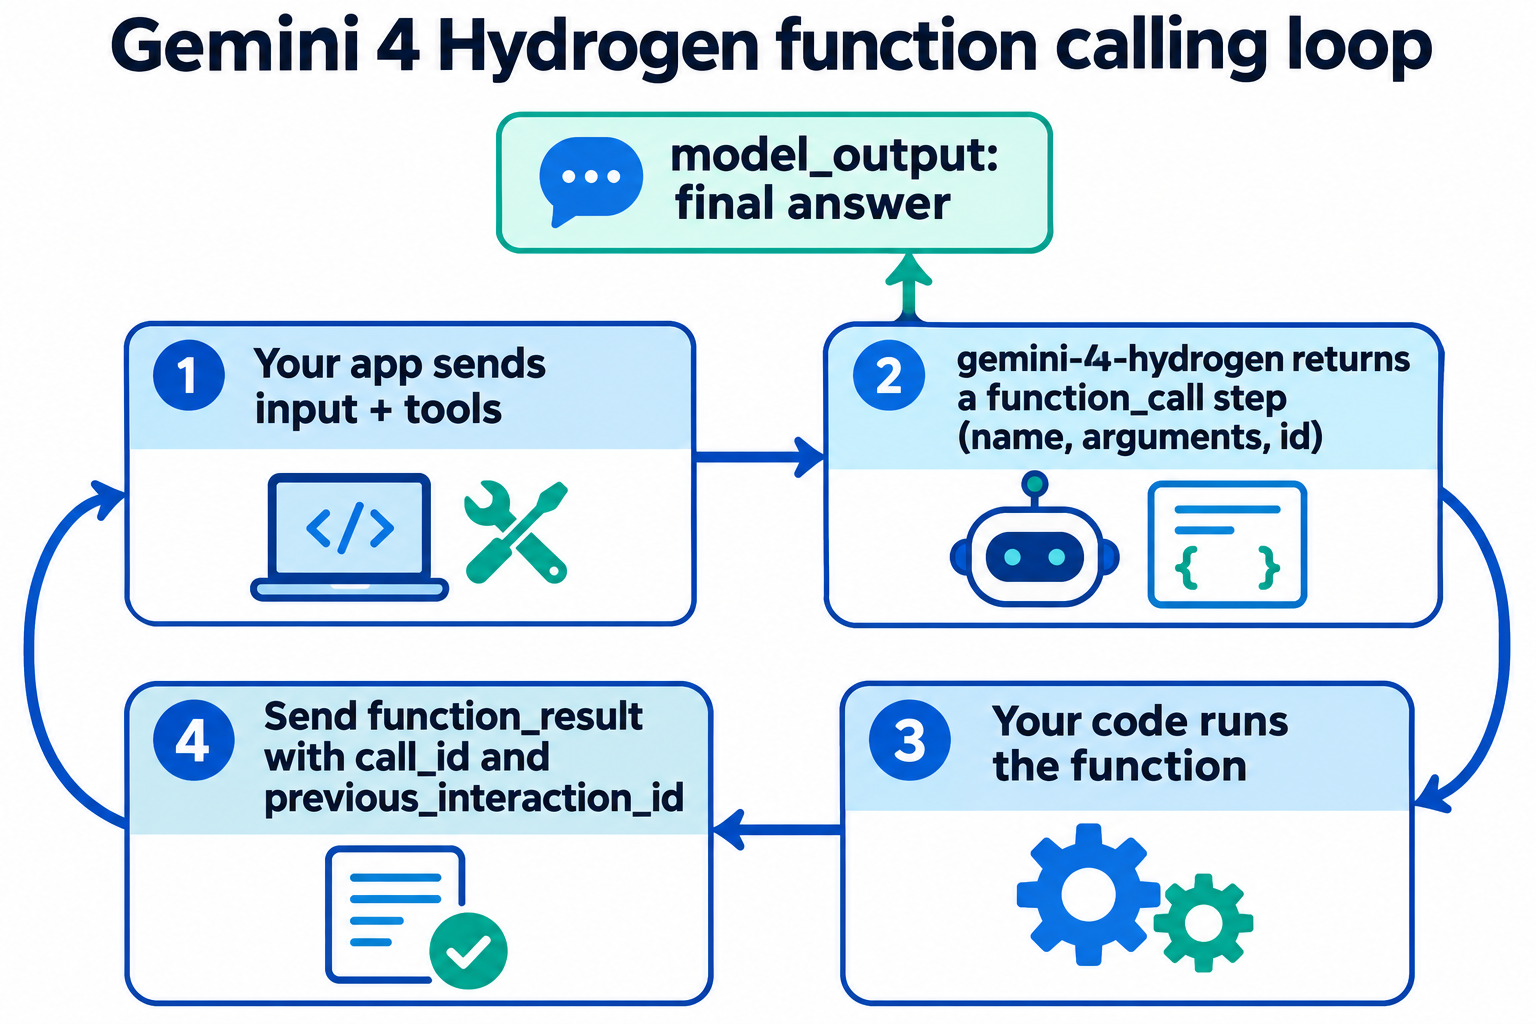
type이 function_call인 스텝을 찾아 name, arguments, id를 읽습니다. 함수를 실행한 뒤 같은 세션에서 결과를 돌려보냅니다:
fc = next(s for s in interaction.steps if s.type == "function_call")
result = get_current_temperature(**fc.arguments)

final = client.interactions.create(
    model="gemini-4-hydrogen",
    input=[{
        "type": "function_result",
        "name": fc.name,
        "call_id": fc.id,
        "result": [{"type": "text", "text": json.dumps(result)}],
    }],
    tools=[weather_function],
    previous_interaction_id=interaction.id,
)
print(final.output_text)
previous_interaction_id는 대화와 thinking 상태를 Google 측에 유지하므로 히스토리를 다시 보낼 필요가 없습니다. Google의 마이그레이션 노트에는 다음과 같은 경고도 있습니다: 도구를 선언하지 않은 상태에서 모델에게 원시 JSON "tool calls"를 출력하도록 프롬프트하면 MALFORMED_FUNCTION_CALL이 반환될 수 있습니다. 도구는 네이티브 방식으로 선언하거나 구조화된 출력을 사용하세요.
Gemini 4 Hydrogen 응답은 어떻게 스트리밍하나요?
본문에 "stream": true를 추가합니다. API는 Server-Sent Events로 응답합니다:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  --no-buffer \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Explain idempotency keys in three short paragraphs.",
    "stream": true
  }'
Google의 스트리밍 가이드에 따르면, 먼저 interaction.created를 받고, 각 스텝(thought, 그다음 model_output)마다 step.start, step.delta, step.stop을 받고, 마지막으로 최종 usage와 함께 interaction.completed를 받습니다. model_output 스텝의 delta.text를 이어 붙여 답변을 만들면 됩니다. 스트리밍이 상한을 올려주지는 않습니다. 각 호출은 여전히 65,536 토큰에서 멈춥니다. 더 긴 출력이 필요하면 "background": true로 설정하고 max_output_tokens를 65,536 이상으로 지정한 뒤, status가 in_progress나 queued에서 벗어날 때까지 GET /v1beta/interactions/{id}를 폴링하세요.
Gemini 4 Hydrogen API 오류는 어떻게 처리하나요?
비스트리밍 오류는 HTTP 상태 코드와 code, message를 담은 error 객체로 반환됩니다. 스트림에서는 같은 필드를 가진 error 이벤트를 받습니다. 가장 자주 마주하게 될 코드들입니다. 출처는 Google의 API 오류 페이지:
| HTTP | code |
대처 방법 |
|---|---|---|
| 400 | invalid_request |
페이로드 수정; 필드 이름을 문서와 대조 |
| 403 | permission_denied |
키 권한, 인증 또는 결제 상태 확인 |
| 404 | model_not_found |
모델 문자열이 gemini-4-hydrogen인지 확인 |
| 429 | rate_limit_exceeded |
백오프 후 재시도 |
| 429 | quota_exceeded |
일일 할당량 초과; 초기화까지 대기 |
| 503 | service_unavailable |
백오프 후 재시도 |
Google의 문제 해결 가이드에 따르면 지수 백오프에 지터를 더하고 재시도 횟수 제한을 두어 429, 408, 5xx만 재시도하고, 400, 402, 403은 절대 재시도하지 말아야 합니다. Python SDK는 이미 일시적 오류를 최대 네 번까지 자동으로 재시도합니다.
Apidog CLI로 코딩 에이전트가 Hydrogen API를 테스트하게 하기
프롬프트를 바꾸거나 thinking 레벨을 조정할 때마다 JSON을 일일이 읽는 대신, 코딩 에이전트(Claude Code, Codex, Cursor)에게 반복 가능한 테스트를 만들게 하고 Apidog CLI로 실행하세요.
한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 에이전트에 프롬프트 하나를 주세요:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING (default "low"). Add an endpoint for POST /v1beta/interactions with the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-hydrogen", a short prompt and generation_config.thinking_level
{{THINKING}}, and asserts: HTTP 200, status is "completed", steps contains a
non-empty model_output, and usage.total_tokens exists. Run it at low and at high,
then compare usage.total_thought_tokens.
에이전트는 무엇이든 작성하기 전에 CLI의 스키마에 대해 각 페이로드를 검증합니다:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=low" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=high" -r cli,json
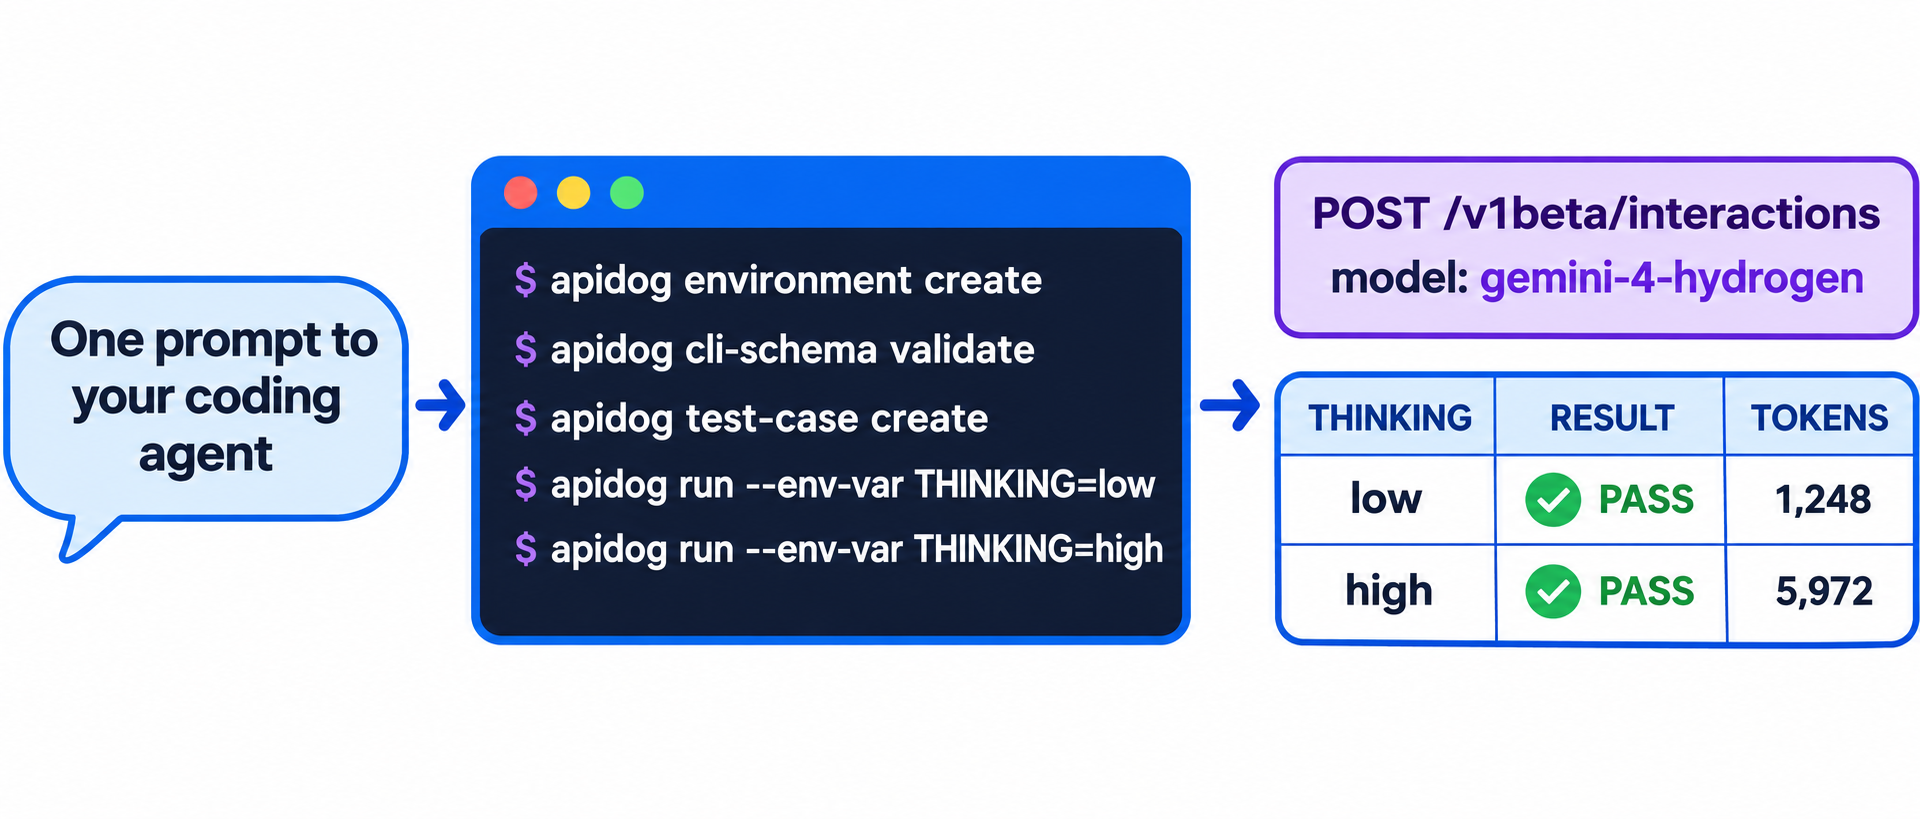
두 실행 결과는 같은 프롬프트에 대한 thought 토큰 수를 비교하며, 바로 요금을 좌우하는 수치입니다. -r cli,json을 -r junit으로 바꾸면 같은 실행을 CI에 넣을 수 있습니다. 파이프라인은 Apidog CLI CI/CD 가이드에서, 에이전트 설정은 Claude Code에서 Apidog CLI 사용하기에서 확인하세요. Apidog의 무료 플랜은 최대 4명까지 지원합니다.
FAQ
Gemini 4 Hydrogen의 모델 ID는 무엇인가요? gemini-4-hydrogen입니다. Interactions API와 generateContent 모두에서 동작합니다.
Gemini 4 Hydrogen API는 무료인가요? 네, 제한 내에서 무료입니다. Google은 Gemini API와 AI Studio의 무료 티어에 Hydrogen을 속도 제한과 함께 포함하고 있습니다. 유료 사용 시 입력 토큰 1M당 $1.50, 출력 토큰 1M당 $7.50입니다.
Gemini 3.8 Flash에서 어떻게 마이그레이션하나요? 모델 문자열을 바꾸고, 낮은 max_output_tokens 상한을 올리고, temperature, top_p, top_k 및 명시적 캐싱(cachedContents)를 제거하고, minimal thinking을 low나 medium으로 교체하세요.
Hydrogen은 컨텍스트 캐싱을 지원하나요? 암시적 캐싱만 지원합니다. 4,096 토큰 이상의 프롬프트에 기본적으로 적용되며 캐시 히트 시 95% 할인됩니다. 명시적 캐싱은 지원되지 않습니다.
API에서 Hydrogen은 Gemini 4 Argon과 어떻게 다른가요? 요청 스키마는 같습니다. Hydrogen은 기본값이 high이고 xhigh가 추가된 반면, Argon은 기본값이 medium입니다. 모델 조합에 대해서는 Gemini 4 Argon API 가이드, Gemini 4 Carbon API 가이드, Gemini 4 Hydrogen Orchestrator를 참고하세요.