
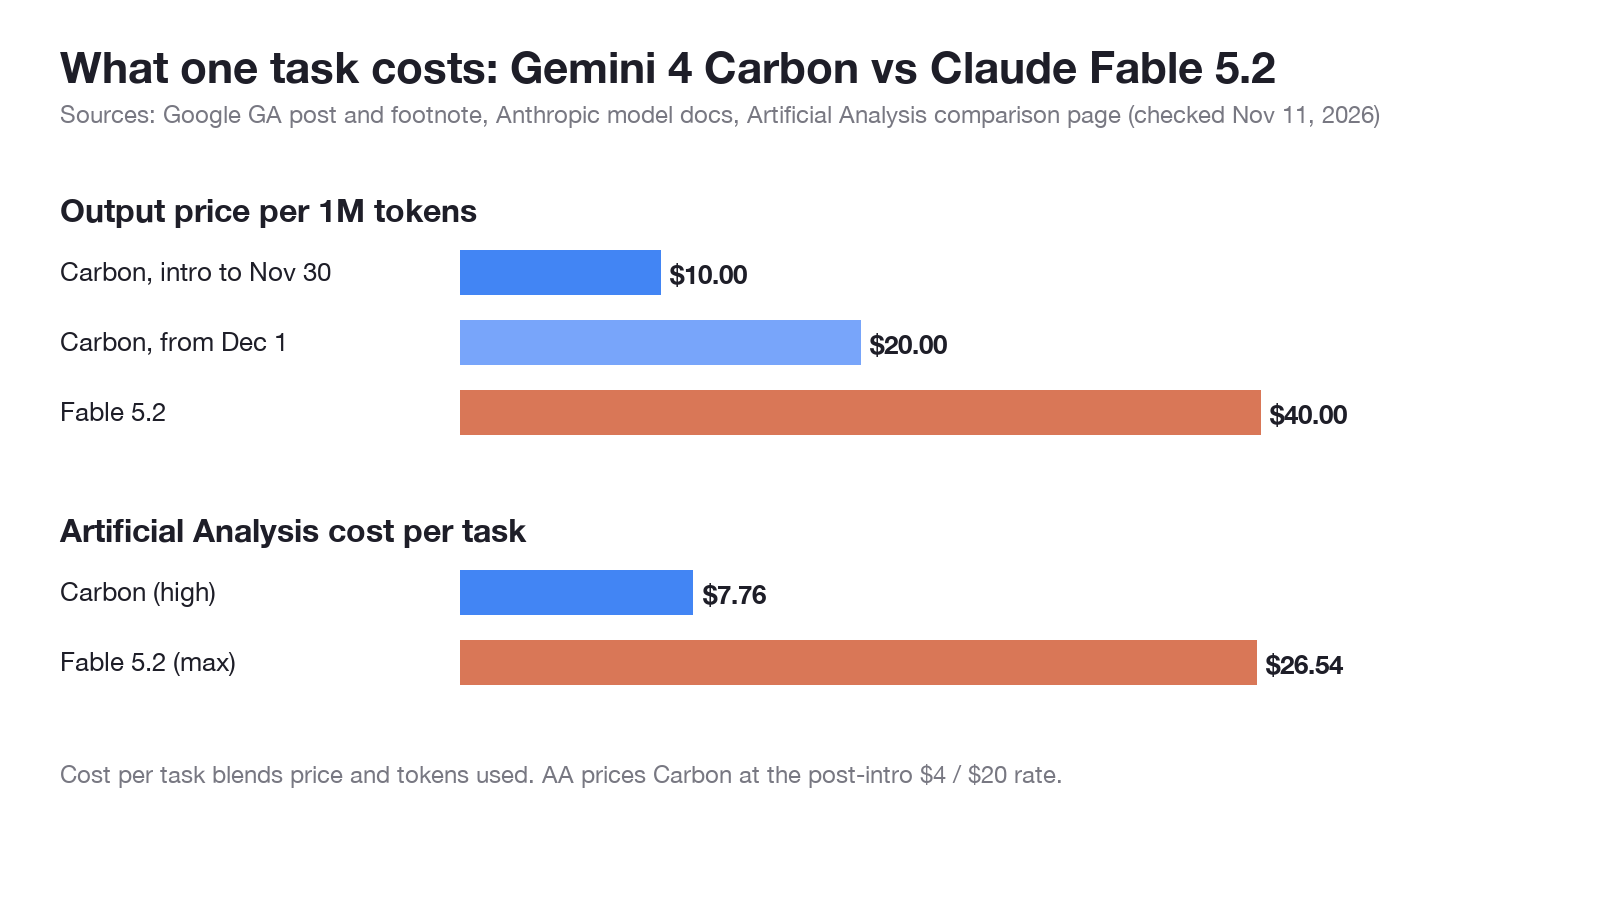
2026년 11월 11일 기준으로, 공개된 코딩 및 에이전트 벤치마크 대부분에서 Google의 Gemini 4 Carbon이 더 저렴한 모델이고 Claude Fable 5.2가 더 강력한 모델입니다. Carbon은 11월 30일까지 100만 입/출력 토큰당 $2 / $10으로 책정되며(이후 $4 / $20), Fable 5.2는 $8 / $40입니다. Artificial Analysis에 따르면 작업당 비용은 $7.76 대 $26.54입니다.
두 모델은 하루 차이로 출시되었고(Fable 5.2는 11월 9일, Carbon GA는 11월 10일), 각 벤더의 표는 자사 모델에 유리하게 구성되어 있습니다. 이 가이드는 모든 수치를 측정 주체별로 분류해서 보여드린 뒤, 여러분의 실제 요청으로 두 모델을 A/B 테스트하는 방법까지 소개합니다.
Gemini 4 Carbon vs Claude Fable 5.2: 핵심 결론
작업당 비용이 가장 중요하거나, 비즈니스 자동화 워크플로 또는 보안 업무를 위해서라면 Gemini 4 Carbon을 선택하세요. 어려운 코딩, 터미널, 컴퓨터 사용 작업에서 최고 점수가 필요하고 작업당 약 3.4배 더 높은 비용을 감수할 수 있다면 Claude Fable 5.2를 선택하세요. 일상적인 엔지니어링 업무에서는 두 벤더 모두 더 저렴한 기본 모델을 먼저 권장합니다.
Google의 GA 게시물은 "Argon이 대부분의 소프트웨어 엔지니어링 및 지식 작업에 여전히 이상적인 선택입니다"라고 밝히며, 더 많은 토큰을 사용해 탐색하고 검증하는 어려운 작업을 위해 Carbon을 포지셔닝하고 있습니다. Anthropic의 모델 문서도 자신들의 방식으로 같은 내용을 말합니다: 대부분의 워크로드는 Claude Opus 5.5로 시작하고, 까다로운 추론 및 장기 에이전트 작업에는 Fable 5.2로 전환하라는 것입니다.
즉, 기본 모델로 부족할 때 두 모델 중 하나를 사용하는 것이 좋습니다. 아직 기본 모델을 정하지 못했다면 먼저 Gemini 4 Carbon vs Argon 글을 읽어보세요.
Gemini 4 Carbon과 Claude Fable 5.2의 가격과 사양은 어떻게 다를까?
다음은 각 벤더가 공개한 사실들로, 모든 항목에 출처를 표기했습니다.
| 사양 | Gemini 4 Carbon | Claude Fable 5.2 | 출처 |
|---|---|---|---|
| 모델 ID | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| 출시일 | 2026년 11월 10일 GA | 2026년 11월 9일 | Google, Anthropic |
| 100만 토큰당 입력 가격 | 11월 30일까지 $2, 이후 $4 | $8 (fast 모드 $16) | Google 각주, Anthropic |
| 100만 토큰당 출력 가격 | 11월 30일까지 $10, 이후 $20 | $40 (fast 모드 $80) | Google 각주, Anthropic |
| 컨텍스트 윈도우 | 100만 토큰 | 100만 토큰 | AI Studio 모델 카드, Anthropic 문서 |
| 최대 출력 | 65K / 1M 표기됨 [VERIFY] | 128K 토큰 | AI Studio 모델 카드, Anthropic 문서 |
| 추론(Thinking) | 구성 가능한 추론 수준 | 적응형, 항상 켜짐, 기본 노력 수준 high |
Google 퀵스타트, Anthropic 문서 |
| 이용 방법 | Gemini API 유료 티어, AI Studio, Android Studio, Gemini for business, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| 무료 API 티어 | 안내 없음 | 안내 없음 | Google, Anthropic |
Google의 GA 게시물에는 Vertex AI, Gemini CLI, GitHub Copilot이 언급되지 않았으므로, 아직 이들을 염두에 둔 계획은 세우지 않는 것이 좋습니다. Carbon의 도입 가격은 Argon과 동일하므로, 11월이 평가를 진행하기에 가장 저렴한 시기입니다.
전체 요금표는 Claude Fable 5.2 가격 안내와 Google의 Gemini 4 Carbon 발표를 참고하세요.
벤치마크에서는 어떤 모델이 우세할까?
어느 표를 읽느냐에 따라 달라지므로, 세 개의 표를 구분해서 보여드립니다.
Anthropic의 표 (Fable 5.2와 함께 공개)
Anthropic의 Fable 5.2 출시 게시물에는 Gemini 4 Carbon 열이 포함되어 있습니다. 해당 페이지는 Carbon 수치를 누가 측정했는지 밝히지 않으므로, 벤더 보고 수치로 간주해야 합니다.
| 벤치마크 (Anthropic의 표) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69.9% | 61.2% |
| FrontierCode 2.0 | 49.1% (xhigh 노력) | 41.1% (medium 노력) |
| Terminal-Bench-Science 0.1 | 74.6% | 64.8% |
| OSWorld 2.1 (오프라인 세트, partial) | 89.3% | 81.5% |
| AA-Briefcase v1.1 (루브릭) | 66.1% | 61.8% |
| Chartography (도구 없음) | 73.4% | 72.5% |
| AutomationBench | 51.4% | 53.9% |
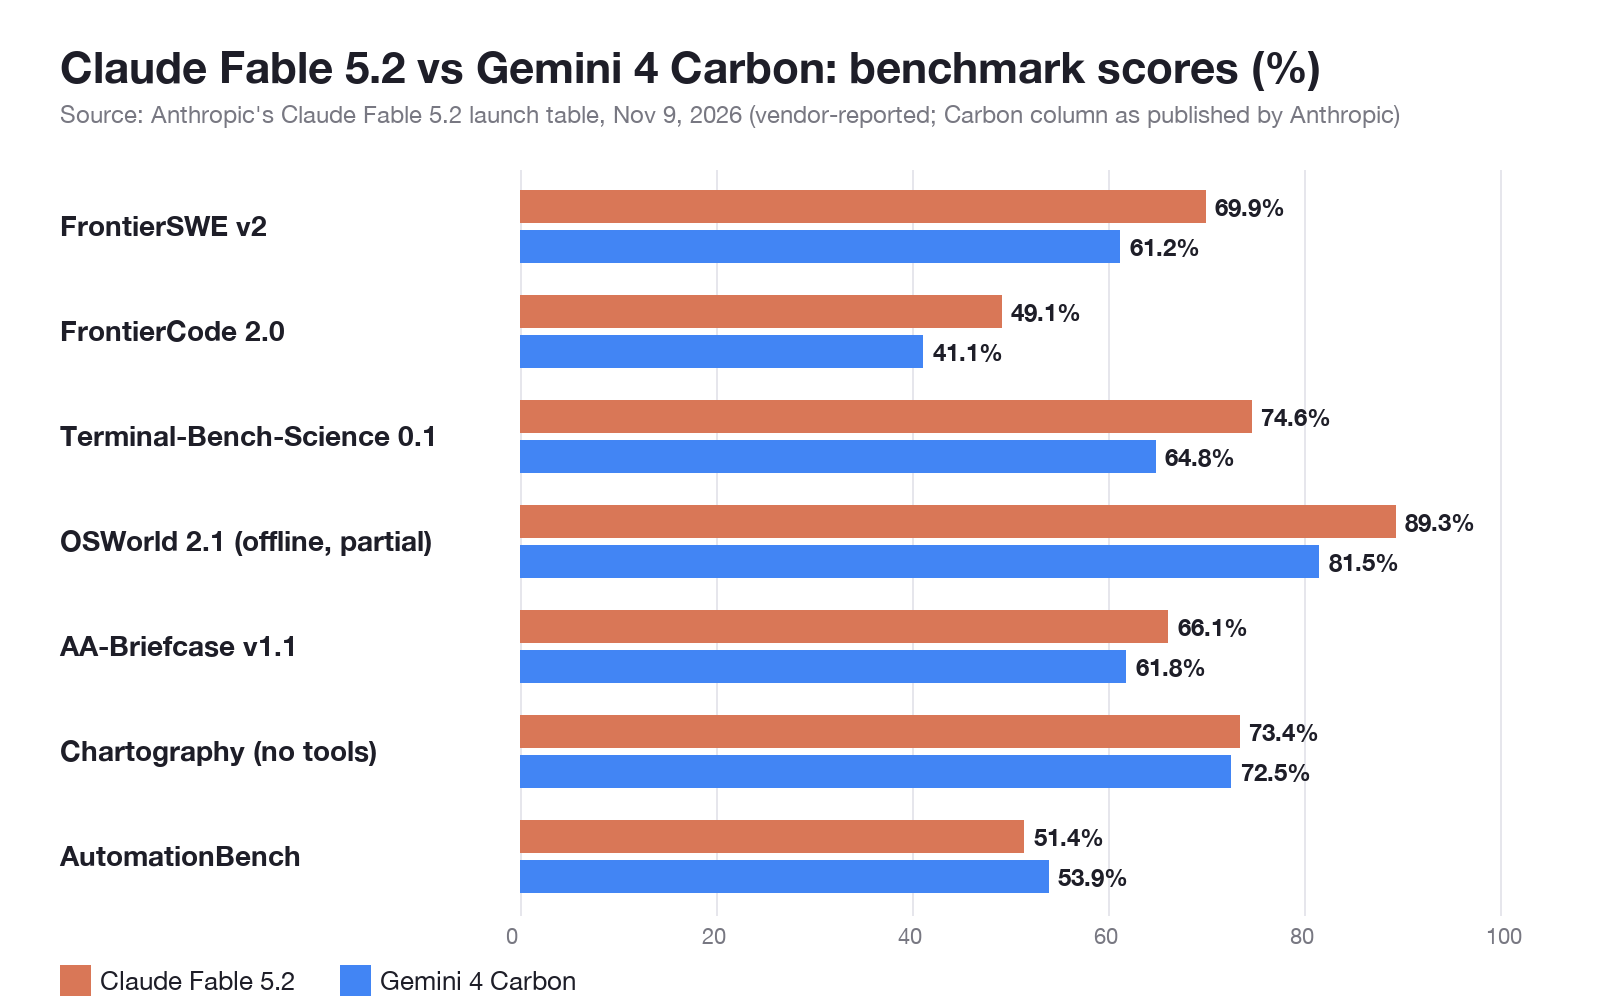
FrontierCode 행에 주목하세요: Fable은 xhigh 노력 수준으로, Carbon은 medium으로 실행되었습니다. 설정의 이 격차는 점수의 격차만큼이나 중요합니다.
Google의 표 (Carbon GA와 함께 공개)
Google은 Fable 5.2와의 정면 비교 수치를 공개하지 않았습니다. 대신 파트너 리더보드 결과를 보고하는데, Carbon은 "차순위 외부 모델 대비 2배 이상 낮은 작업당 비용으로" CursorBench 4.0, Perplexity의 WANDR, Zapier의 AutomationBench에서 1위를 차지했습니다. Multimodal Knowledge Agent 벤치마크에서는 최상위 모델 대비 6배 이상 낮은 평균 작업당 비용으로 2위를 기록했습니다. Google은 이러한 주장에서 경쟁 모델명을 밝히지 않았습니다.
Artificial Analysis (독립 기관)
Artificial Analysis 비교 페이지는 두 모델을 동일한 Intelligence Index v5.0.1로 평가합니다:
| 지표 (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| 작업당 비용 | $26.54 | $7.76 |
| 전체 인덱스 실행 비용 | $22,191 | $8,240 |
| 출력 속도 | 103 tokens/s | 82 tokens/s |
Fable 5.2 (max)는 현재 해당 인덱스에서 1위입니다. Carbon은 5점 낮지만 작업당 비용은 약 29% 수준입니다. Artificial Analysis는 Carbon을 $4 / $20, 즉 11월 이후 요금으로 책정했기 때문에, 비용 수치에는 이미 12월 가격이 반영되어 있습니다.
Claude Fable 5.2가 우세한 분야는?
Anthropic의 수치 기준으로, Fable 5.2는 가장 어려운 코딩 및 컴퓨터 사용 작업에서 우세합니다:
- 저장소 규모 코딩: FrontierSWE v2에서 69.9% vs 61.2%.
- 터미널 및 연구 작업: Terminal-Bench-Science 0.1에서 74.6% vs 64.8%.
- 컴퓨터 사용: OSWorld 2.1에서 89.3% vs 81.5%.
- 독립 인덱스: Artificial Analysis에서 65 vs 60. 어느 벤더도 직접 측정하지 않은 유일한 점수입니다.
- 출력 길이: 요청당 최대 128K 출력이 공식 문서로 확인됩니다.
작업 실패가 엔지니어의 오후 몇 시간을 낭비로 만든다면, FrontierSWE에서 8포인트 높은 점수는 토큰 요금보다 더 큰 가치를 가질 수 있습니다. 설정 방법은 Claude Fable 5.2 API 가이드를 참고하세요.
Gemini 4 Carbon이 우세한 분야는?
Carbon은 작업당 비용과, Google이 이를 위해 설계한 워크로드에서 우세합니다:
- 작업당 비용: Artificial Analysis에서 $7.76 vs $26.54, 약 3.4배 저렴합니다.
- 비즈니스 자동화: Anthropic의 자체 표에서 AutomationBench에서 53.9% vs 51.4%.
- 보안: Google 기준 SEC-bench Pro, ExploitGym, CWE-bench v1에서 선두이며, Fairwind Program을 통해 방어자용 게이트된 Carbon for cyber 모델을 제공합니다.
- 11월 가격: 11월 30일까지 $2 / $10으로, 입력과 출력 모두 Fable 요금의 4분의 1 수준입니다.
- 에이전트 팀: Google Antigravity의 /swarm 미리보기는 하나의 프롬프트를 협업 팀으로 변환하여, Carbon이 계획과 감사를 담당하는 동안 더 가벼운 모델들이 병렬로 작업합니다.
이 모델이 처음이라면 Gemini 4 Carbon이란?부터 시작해 보세요.
작업 하나의 실제 비용은 얼마일까?
정가는 요율을 알려줄 뿐, 실제 청구액을 알려주지는 않습니다. 작업 비용은 가격에 모델이 사용하기로 선택한 토큰 수를 곱한 값이며, Google은 Carbon이 탐색과 검증에 더 많은 토큰을 사용한다고 밝혔습니다.
입력 50,000 토큰, 출력 10,000 토큰인 요청 하나를 예로 들어 보겠습니다:
- Carbon, 도입 요금: (0.05 x $2) + (0.01 x $10) = $0.20
- Carbon, 12월 1일부터: (0.05 x $4) + (0.01 x $20) = $0.40
- Fable 5.2: (0.05 x $8) + (0.01 x $40) = $0.80
이 계산은 양쪽 모두 10,000 토큰을 출력한다고 가정합니다. 실제로는 그렇지 않을 것입니다. Fable이 10,000 토큰으로 추론하는 작업을 Carbon이 30,000 토큰으로 처리한다면, Carbon의 12월 비용은 $0.80으로 올라가고 격차는 좁혀집니다. Artificial Analysis는 전체 테스트 스위트에서 실측을 진행했고, 그래도 Carbon이 작업당 약 3.4배 저렴하다는 결과를 얻었습니다. 직접 측정해 보기 전까지는 이것이 가장 신뢰할 수 있는 신호입니다.
자신의 요청으로 Gemini 4 Carbon과 Claude Fable 5.2를 A/B 테스트하는 방법
벤치마크는 남의 작업입니다. 공정한 테스트는 동일한 프롬프트를 양쪽 API에 보내고 토큰 사용량과 지연 시간을 나란히 기록하는 것입니다.
두 호출 모두 일반 HTTP입니다. 다음은 Google의 Interactions API 퀵스타트를 바탕으로 작성한 Carbon 요청으로, 모델명을 변수로 넣었습니다:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2는 Anthropic의 Messages API를 통해 claude-fable-5-2를 모델로 사용합니다.
Apidog CLI로 코딩 에이전트에게 A/B 테스트 맡기기
요청 쌍을 손으로 실행하다 보면 금방 지겨워집니다. 대신 Claude Code, Codex 또는 Cursor가 Apidog CLI를 조작하게 하세요. 설정은 명령 세 개면 충분합니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 에이전트에게 프롬프트 하나를 주면 됩니다:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
에이전트가 스키마를 확인하고, 케이스를 작성하고, 실행합니다. 아래 플래그들은 CLI 2.2.12의 apidog run --help에서 가져온 것입니다:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5는 각 케이스를 다섯 번 반복 실행하므로, 한 번의 느린 응답이 결과를 좌우하지 않습니다. --upload-report를 추가하면 Apidog 앱에서 실행 결과를 볼 수 있습니다. 이것은 워크플로 템플릿이며, 저희가 이 환경에서 Carbon에 대해 직접 실행해 본 것은 아닙니다. 에이전트 설정은 Apidog CLI in Claude Code 가이드에서, Gemini 요청 측은 Gemini 4 Argon API 가이드에서 다룹니다.
Apidog의 Free 플랜은 최대 4명의 사용자를 지원하므로, 이 비교를 실행하기에 충분합니다.
FAQ
Gemini 4 Carbon이 Claude Fable 5.2보다 나은가요?
모든 면에서 그렇지는 않습니다. Fable 5.2는 Anthropic의 벤치마크 대부분과 Artificial Analysis 인덱스(65 vs 60)에서 더 높은 점수를 기록합니다. Carbon은 작업당 비용($7.76 vs $26.54)과 AutomationBench에서 우세합니다.
Gemini 4 Carbon은 Claude Fable 5.2보다 얼마나 저렴한가요?
정가 기준으로 Carbon은 2026년 11월 30일까지 4배 저렴하고(100만 토큰당 $2 / $10 vs $8 / $40), 12월 1일부터는 2배 저렴합니다($4 / $20). Artificial Analysis의 작업당 측정 기준으로는 약 3.4배 저렴합니다.
두 모델 모두 100만 토큰 컨텍스트 윈도우를 지원하나요?
네. Google의 AI Studio 모델 카드는 Carbon에 대해, Anthropic의 문서는 Fable 5.2에 대해 각각 100만 토큰을 명시합니다. Fable의 최대 출력은 128K 토큰이며, Carbon의 정확한 출력 한도는 Google의 개발자 가이드에서 확인하세요.
Gemini 4 Carbon이나 Claude Fable 5.2의 API에 무료 티어가 있나요?
어느 벤더도 무료 티어를 안내하지 않습니다. Carbon은 Gemini API 유료 티어와 Google AI Ultra 앱에서 이용할 수 있고, Fable 5.2는 토큰 단위로 과금됩니다.
기본 모델을 이 중 하나로 바꿔야 할까요?
아마 그렇지 않을 것입니다. Google은 대부분의 소프트웨어 엔지니어링 및 지식 작업에 Argon이 여전히 적합한 선택이라고 밝혔고, Anthropic도 대부분의 워크로드에 Opus 5.5를 권장합니다. 기본 모델이 실패하는 작업만 Carbon이나 Fable로 라우팅하고, 그 결과를 자신의 요청으로 직접 비교해 보세요.