2026년 11월 11일 기준으로, Google의 Gemini 4 Carbon API는 모델 ID gemini-4-carbon을 사용하며, 2026년 11월 30일까지 입력 토큰 100만 개당 $2, 출력 토큰 100만 개당 $10의 비용이 들고, 이후에는 각각 $4와 $20이 됩니다. Google은 2026년 11월 10일에 이 모델을 Gemini API 유료 티어에서만 일반 공개(GA)했습니다.
이 가이드는 새 API 키 발급부터 첫 요청 전송까지의 과정을 안내하고, 청구서를 결정하는 사용량 지표가 무엇인지 보여주며, 테스트 작업은 코딩 에이전트에게 맡기는 방법까지 다룹니다.
Gemini 4 Carbon 모델 ID란 무엇인가?
Gemini 4 Carbon의 모델 ID는 gemini-4-carbon입니다. Gemini API의 Interactions 엔드포인트로 보내는 요청의 model 필드에, Python 또는 JavaScript SDK에서, 혹은 Google AI Studio 프롬프트에서 이 값을 전달합니다. Google은 Carbon을 자사에서 가장 강력한 추론 모델이라고 부르며 어려운 작업에 사용할 것을 권장하고, 일상적인 작업에는 여전히 Gemini 4 Argon이 기본 모델로 유지됩니다.
모델 자체에 대한 배경 정보는 Gemini 4 Carbon이란? 글에서 확인할 수 있습니다.
| 항목 | 값 | 출처 |
|---|---|---|
| 모델 ID | gemini-4-carbon |
Google AI Studio 문서 |
| 제공 시작일 | 2026년 11월 10일 | Google 출시 공식 발표 |
| 이용 가능 범위 | Gemini API 유료 티어, Google AI Studio, Android Studio | Google 출시 공식 발표 |
| 무료 티어 | 제공되지 않음 | Google AI Studio 문서 |
| 컨텍스트 윈도우 | 1,048,576 토큰, 입력·추론·출력이 공유 | Google AI Studio 문서 |
| 동기식 응답당 최대 출력 | 65,536 토큰 | Google AI Studio 문서 |
| 긴 디코딩(Long decode) | 입력 토큰을 제외한 최대 100만 토큰, background: true 사용 시 |
Google AI Studio 문서 |
| 추론(Thinking) 레벨 | low, medium(기본값), high |
Google AI Studio 문서 |
| 2026년 11월 30일까지 가격 | 입력 $2, 출력 $10 / 100만 토큰 | Google 출시 공식 발표 |
| 2026년 12월 1일부터 가격 | 입력 $4, 출력 $20 / 100만 토큰 | Google 출시 공식 발표 |
| 캐시된 입력(암시적 캐싱) | 100만 토큰당 $0.10, 12월 1일부터 $0.20 | Google AI Studio 문서 |
Gemini 4 Carbon용 Gemini API 키는 어떻게 발급하나?
Carbon은 유료 티어에서만 실행되므로 키만으로는 부족합니다. Cloud Billing이 연결된 프로젝트에 속한 키가 필요합니다:
- Google AI Studio에서 API 키 페이지를 엽니다. 신규 사용자는 프로젝트와 키가 자동으로 생성되며, 그렇지 않은 경우 Create API key를 클릭합니다.
- API 키 페이지 또는 Projects 페이지에서 Set up billing을 클릭합니다.
- Cloud Billing 계정을 생성하거나 연결하고, 결제 수단을 추가한 뒤, Google의 퀵스타트 안내에 따라 최소 $5 상당의 크레딧을 선결제합니다.
- 셸에서 키를 내보냅니다:
export GEMINI_API_KEY="YOUR_API_KEY".
API 키가 아예 필요 없는 방법은 Gemini 4 Carbon 무료 이용 방법 글에서 다룹니다.
첫 Gemini 4 Carbon API 요청은 어떻게 보내나?
Google의 Carbon 퀵스타트는 Interactions API를 사용합니다. 본문에 model과 input을 담아 /v1beta/interactions로 POST 요청을 보내는 방식입니다. 모델 이름을 변수에 담아두면 나중에 Carbon과 Argon 사이를 전환할 때 한 줄만 수정하면 됩니다.
curl 사용 시:
export GEMINI_MODEL="gemini-4-carbon"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Find the race condition in this retry loop and rewrite the lock safely.",
    "generation_config": {
      "thinking_level": "medium"
    }
  }'
Python SDK 사용 시 (pip install -U google-genai):
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-4-carbon")

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model=MODEL,
    input="Find the race condition in this retry loop and rewrite the lock safely.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
print(interaction.usage)
두 코드 예제 모두 Google 문서의 예시를 따릅니다. 이 글을 작성하는 환경에는 유료 Carbon 키가 없어서 직접 실행해 보지는 않았으므로, 응답 형식은 직접 첫 호출을 해서 확인해 보세요.
Google의 마이그레이션 노트에 나온 세 가지 사항은 디버깅 시간을 크게 줄여줍니다:
- 샘플링 파라미터 제거.
temperature,top_p,top_k는 Carbon에서 무시되므로 제거하세요. - 타임아웃 늘리기. 어려운 프롬프트는 몇 분이 걸릴 수 있습니다. Google은 백그라운드 실행 또는 최소 15분 이상의 HTTP 타임아웃을 권장합니다.
- 상태는 서버에 유지. 대화 기록을 다시 보내는 대신, 멀티턴 채팅과 함수 호출에는
previous_interaction_id를 전달하세요.
이미 Argon을 사용 중인가요? Gemini 4 Argon API 가이드도 동일한 요청 구조를 사용합니다.
응답에서 사용량과 추론 토큰은 어떻게 읽나?
모든 상호작용(interaction)은 usage 객체를 반환합니다. 비용에 영향을 주는 필드는 다음과 같습니다:
total_input_tokens: 시스템 지시문과 도구 선언을 포함해 보낸 토큰 수.total_thought_tokens: 모델이 답변 전에 추론에 사용한 토큰 수.total_output_tokens: 눈에 보이는 답변 토큰 수.total_tokens: 위 항목들의 합계.
주목해야 할 필드는 total_thought_tokens입니다. Google의 추론 가이드에 따르면 응답 가격은 출력 토큰과 추론 토큰의 합이며, 따라서 추론도 $10의 출력 요율로 청구됩니다. Google은 또한 Carbon이 한 턴당 작업을 탐색하고 검증하기 위해 Argon보다 "더 많은 추론 토큰을 사용한다"고 밝혔습니다. 어려운 프롬프트에서는 추론 비용이 청구액의 대부분을 차지할 수 있습니다.
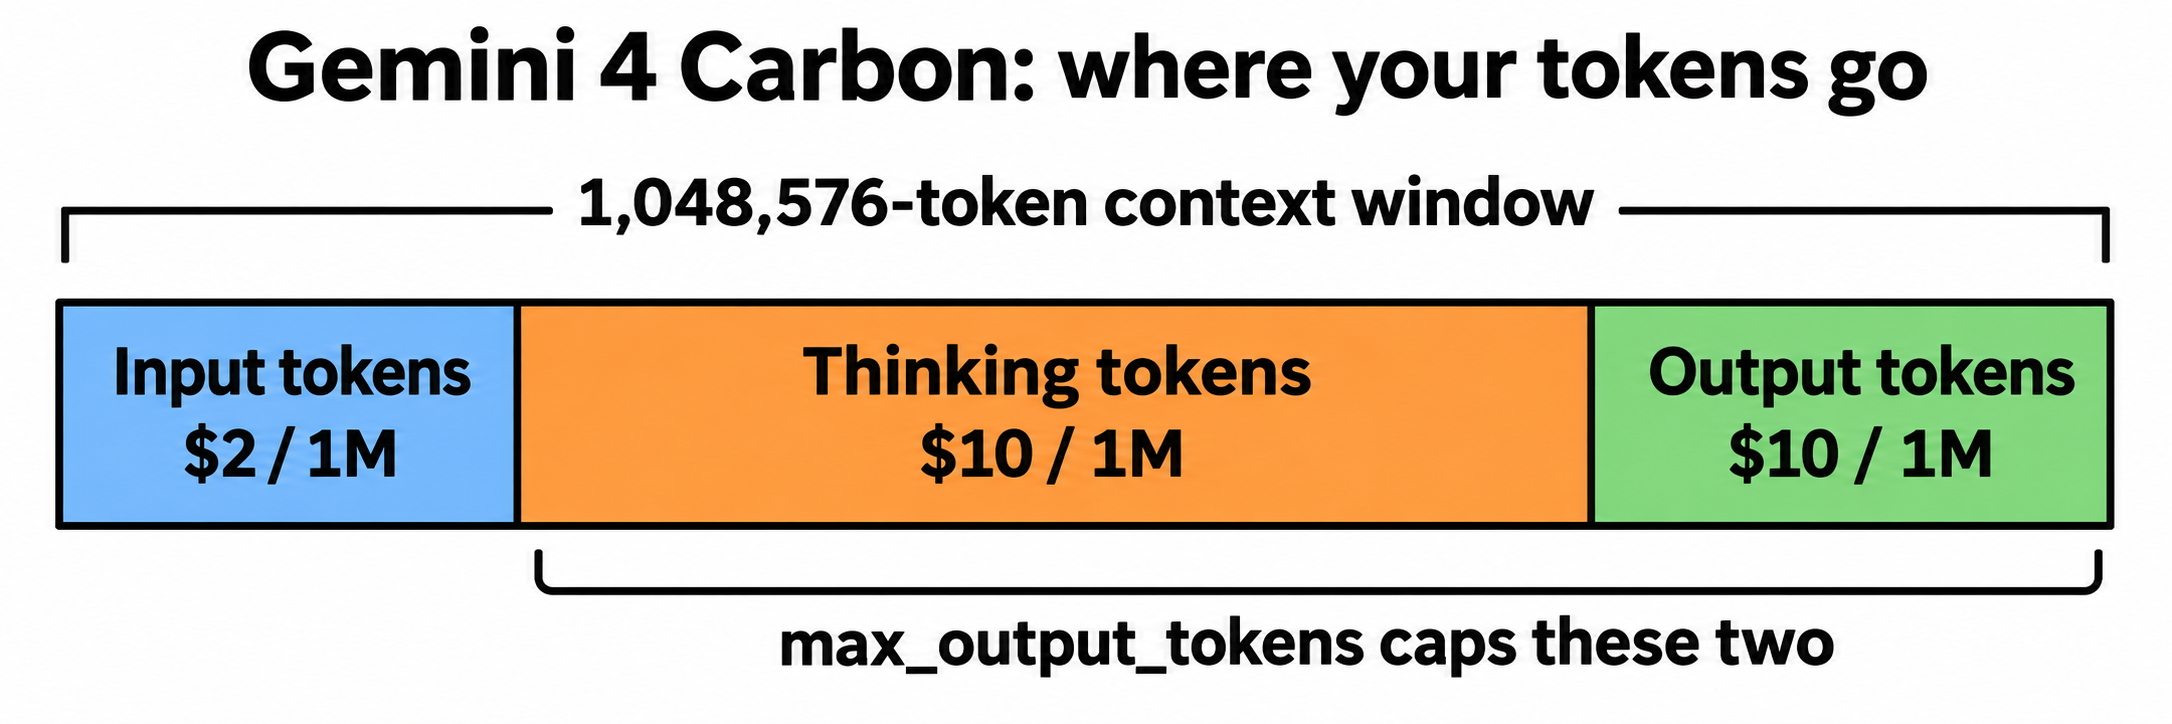
max_output_tokens는 추론과 출력을 합한 상한을 설정합니다. 너무 낮게 설정하면 Carbon이 예산을 추론에 소진해 답변이 잘릴 수 있습니다. Google이 제시하는 시작점은 다음과 같습니다:
- 일반 작업: 기본값 65,536 유지.
- 32K 미만 제한이 있는 앱: 최소 32,768로 상향.
- 복잡한 추론 및 코딩:
background: true설정과 함께 131,072 또는 262,144 토큰으로 설정.
background: true를 사용하면 Google 서버가 64K 토큰 단위로 응답을 이어서 생성합니다. 상태가 in_progress 또는 queued에서 벗어날 때까지 상호작용을 폴링한 뒤, 각 model_output 단계의 텍스트를 모두 합치면 됩니다.
어떤 Gemini 4 Carbon 추론 레벨을 사용해야 하나?
추론(thinking) 레벨은 품질, 지연 시간, 비용을 조절하는 핵심 수단입니다. 추론 가이드와 Carbon 문서에 따른 Google의 권장 사항은 다음과 같습니다:
| 추론 레벨 | 토큰 사용량 | 적합한 용도 |
|---|---|---|
low |
가장 적은 토큰, 가장 낮은 지연 시간 | 단순하고 비용에 민감한 작업, 가벼운 분석과 글쓰기 |
medium(기본값) |
균형 잡힘 | 복잡한 코드와 에이전트 작업을 포함한 대부분의 작업 |
high |
가장 많은 토큰, 첫 토큰까지 가장 느림 | 어려운 수학, 과학, 가장 어려운 코드나 에이전트 작업 |
Google은 세 레벨 모두에서 자체 평가를 실행하고, 품질 기준을 충족하는 가장 낮은 레벨을 유지할 것을 권장합니다. Carbon에서는 low와 high 사이의 격차가 곧 예산 소비의 차이입니다.
Argon 대신 Gemini 4 Carbon에 작업을 보내야 할 때는?
Google은 이 점을 명확히 밝히고 있습니다: "Argon은 대다수의 소프트웨어 엔지니어링 및 지식 작업에 여전히 이상적인 선택입니다." 두 모델은 100만 토큰 컨텍스트 윈도우, 내장 도구, 도입 가격(토큰당)까지 동일하기 때문에, 차이는 턴당 소비하는 토큰 양입니다. 복잡한 근본 원인 디버깅, 아키텍처 설치, 밀도 높은 멀티모달 종합, 증명, 보안 감사에는 Carbon을 사용하세요. 인터랙티브 코딩, 일상적인 기능 개발, 빠른 프로덕션 반복 작업에는 Argon을 유지하는 것이 좋습니다. Gemini 4 Carbon vs Argon 비교 글에서 더 자세히 다루며, Carbon과 Anthropic의 최신 모델을 비교하고 싶다면 Gemini 4 Carbon vs Claude Fable 5.2와 Claude Fable 5.2 API 가이드를 참고하세요.
Gemini 4 Carbon API 호출 비용은 얼마인가?
Google에 따르면 Gemini 4 Carbon은 2026년 11월 30일까지 입력 토큰 100만 개당 $2, 출력 토큰(추론 포함) 100만 개당 $10이며, 이후에는 각각 $4와 $20입니다.
한 번의 호출로 계산해 보면, 2,000 입력 토큰, 6,000 추론 토큰, 1,500 출력 토큰을 사용하는 예시적 요청을 가정해 봅시다. 이는 측정값이 아닌 예시 수치입니다:
- 입력: 2,000 x $2 / 1M = $0.004
- 추론 + 출력: 7,500 x $10 / 1M = $0.075
- 합계: 오늘 기준 약 $0.079, 12월 1일부터 약 $0.158
추론량은 프롬프트에 따라 크게 달라지므로, 실제 자신의 usage 객체를 확인하세요. 전체 가격 계산, 12월 가격 인상, 작업당 비용에 대해서는 Gemini 4 Carbon 가격 안내를 참고하세요.
Apidog CLI로 코딩 에이전트에게 Carbon API 테스트 맡기기
추론 레벨, 출력 한도, 프롬프트를 여러 번 바꾸게 될 것입니다. 변경할 때마다 JSON을 눈으로 확인하는 대신, 코딩 에이전트(Claude Code, Codex, Cursor)에게 반복 가능한 테스트를 작성하게 하고 Apidog CLI로 실행해 보세요.
한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 에이전트에게 프롬프트 하나만 주면 됩니다:
In Apidog project <projectId>, add an endpoint for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from the GEMINI_API_KEY variable in
environment <envId>. Create a test case that sends model "gemini-4-carbon",
a short prompt and thinking_level "low", and asserts: HTTP 200, status is
"completed", usage.total_thought_tokens exists, and usage.total_tokens is
below 20000. Run it and summarize any failures.
테스트에서 low를 사용하면 매 실행 비용이 저렴하게 유지됩니다. 에이전트가 스키마를 읽고, 페이로드를 검증하고, 테스트 케이스를 실행합니다:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog test-case category --project <projectId>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
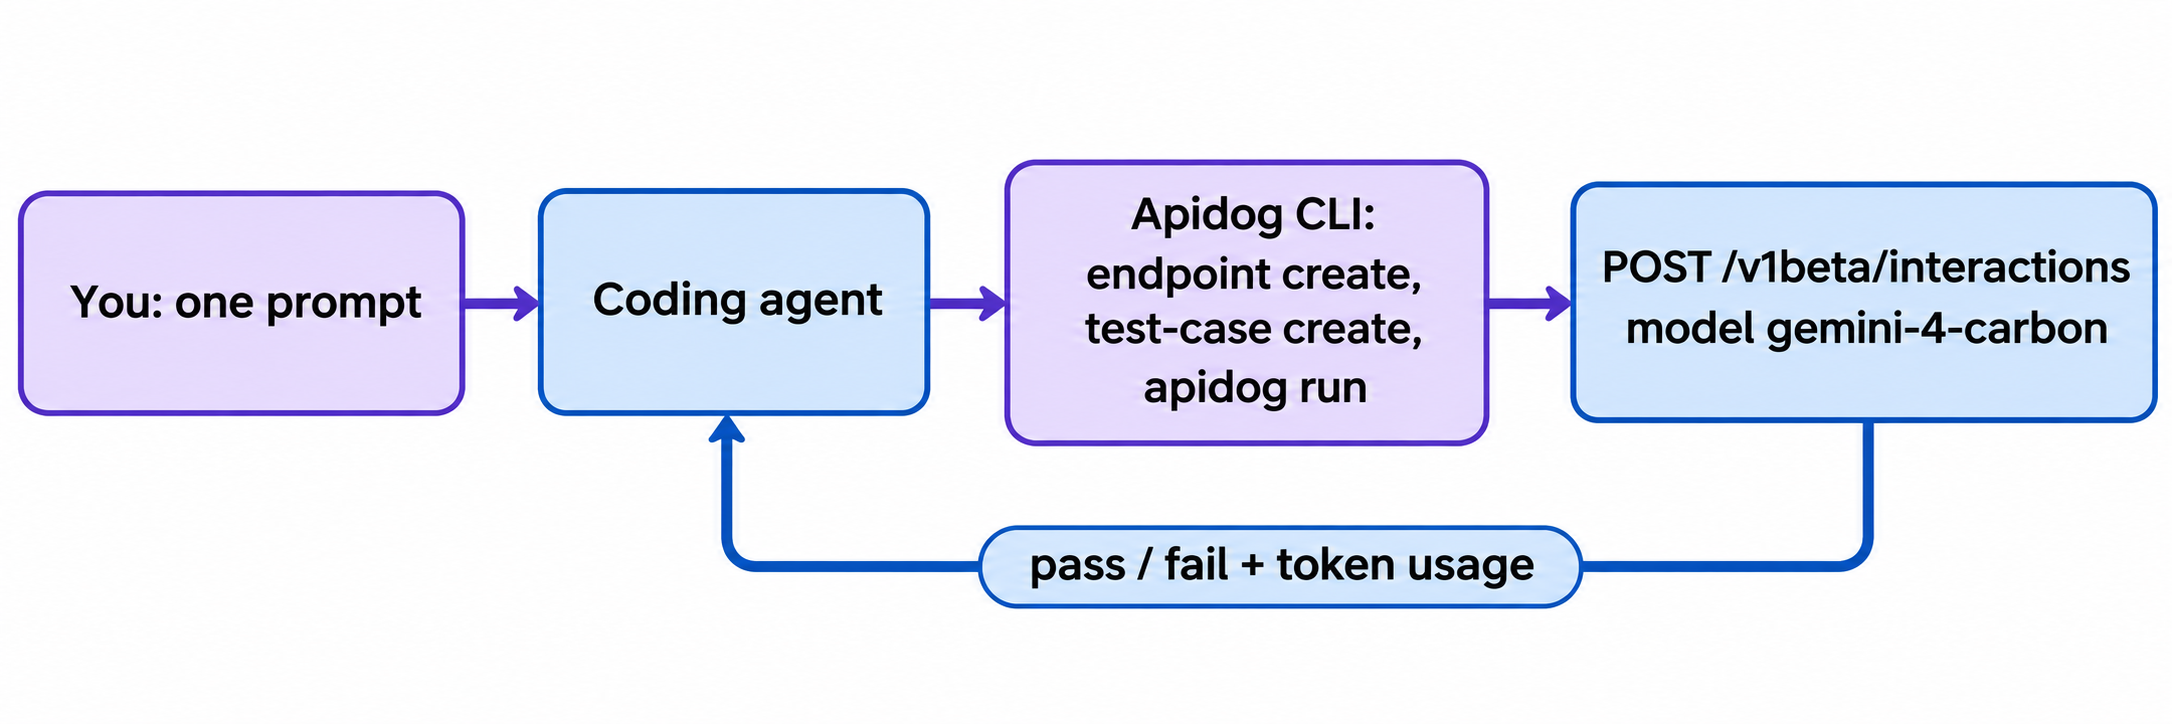
토큰 예산 어서션(assertion)이 가장 유용합니다. 프롬프트 변경으로 추론이 한도를 초과하면, 요금이 늘어나기 전에 테스트가 실패합니다. -r cli,json을 -r junit으로 바꾸면 동일한 명령어를 CI에서 실행할 수 있습니다. Apidog CLI CI/CD 가이드에서 파이프라인 구성을, Claude Code에서의 Apidog CLI 글에서 에이전트 설정 과정을 확인할 수 있습니다. Apidog 무료 플랜은 최대 4명의 사용자까지 지원합니다.
에이전트가 모든 것을 처음부터 설정하게 하려면 이렇게 지시하세요: “https://apidog.com/apidog-cli-installation-guide.md를 읽고 Apidog CLI를 설정해 줘.”
FAQ
Gemini 4 Carbon API는 무료인가요? 아닙니다. Google 문서에 따르면 Gemini 4 Carbon은 Gemini API 무료 티어에서 제공되지 않습니다. Cloud Billing이 연결되고 최소 $5 상당의 크레딧을 선결제한 유료 티어 프로젝트가 필요합니다. 소비자 측에서는 Google AI Ultra 구독자에게 Gemini 앱, AI 모드, Antigravity를 통해 Carbon이 제공되고 있습니다.
Gemini 4 Carbon은 Vertex AI에서 사용 가능한가요? Google의 출시 발표에서는 Gemini API, Google AI Studio, Android Studio, Gemini for business, Antigravity, CodeMender를 언급했습니다. Vertex AI는 언급되지 않으므로, 이를 기반으로 계획하기 전에 Google Cloud의 모델 목록을 확인하세요.
Gemini 4 Carbon의 컨텍스트 윈도우는 얼마인가요? 1,048,576 토큰이며, 입력·추론·출력이 공유합니다. 동기식 응답은 65,536 토큰에서 멈추고, 백그라운드 실행 시에는 입력 토큰을 제외한 최대 100만 토큰까지 응답이 이어질 수 있습니다.
Interactions API 대신 generateContent를 사용할 수 있나요? Google의 Carbon 퀵스타트는 Interactions API를 사용하며, 문서에서는 클라이언트 측 긴 디코딩 이어쓰기를 위해 GenerateContent API를 언급합니다. 앱이 이미 generateContent를 사용 중이라면, 마이그레이션 전에 그 환경에서 모델 ID 교체를 먼저 테스트해 보세요.
Gemini 4 Argon에서 Carbon으로 전환하려면 어떻게 하나요? 모델 문자열을 gemini-4-argon에서 gemini-4-carbon으로 바꾸면 됩니다. Google에 따르면 요청 스키마 변경은 필요 없습니다. Carbon이 더 오래 추론하므로 max_output_tokens와 HTTP 타임아웃을 늘리고, 작업에 high가 필요하지 않다면 thinking_level은 medium으로 유지하세요.