
아직 공개된 Gemini 4 Argon API는 없으며, Google은 모델 ID를 게시하지 않았습니다. Google은 2026년 9월 30일에 Argon을 발표했으며, 현재 Fairwind 프로그램 방어자들(Fairwind 파트너들이 Gemini Enterprise에서 관리형 모델로 사용하는 집단)에게만 제공되고 있습니다. Artificial Analysis는 Google AI Studio를 Argon의 유일한 API 제공업체로 기재하고 있지만, 속도나 지연 시간 데이터는 없습니다. 이는 가입할 수 있는 엔드포인트라기보다는 허용 목록에 포함된 사전 출시 액세스에 해당합니다. Google은 더 광범위한 출시가 시작되면 "유료 API 고객과 Google AI Ultra 구독자"부터 시작될 것이라고 밝혔으므로, 유료 Gemini API 키가 있으면 가장 먼저 사용하게 될 것입니다.
발표와 액세스 사이의 그 공백은 여러분이 활용할 수 있는 시간입니다. 이 가이드는 Google이 Argon API에 대해 확인한 것과 확인하지 않은 것을 구분하고, 오늘 Gemini 3.8 Flash에서 실행할 수 있는 코드를 안내하여 Argon으로의 전환이 단일 변수 변경으로 이루어지도록 합니다. 여러분은 요청을 구성하고, 출시 알림을 설정하고, Apidog에서 응답을 모의(mock)하며, Argon 가격으로 비용 상한선을 추가할 것입니다. 모델 자체에 대해서는 Gemini 4 Argon이 무엇인지부터 시작하고, 출시 단계에 대해서는 Gemini 4 Argon 출시일 가이드를 참조하세요.
Gemini 4 Argon API에 대해 확인된 사항과 확인되지 않은 사항
Google의 출시 게시물은 가격과 출력 제한을 제공합니다. 통합에 필요한 거의 모든 다른 정보는 아직 공개되지 않았습니다.
| 항목 | 상태 | 세부 정보 |
|---|---|---|
| 입력 가격 | 확인됨 | 100만 토큰당 $2 (도입), 도입 기간 후 $4 |
| 출력 가격 | 확인됨 | 100만 토큰당 $10 (도입), 도입 기간 후 $20 |
| 캐시된 입력 | 확인됨 | 입력 95% 할인: 도입 $0.10, 일반 $0.20 |
| 출력 제한 | 확인됨 | 64K에서 1M 토큰으로 증가 |
| API 표면 | 신호됨 | Google 문서에 따르면 모든 새 모델은 Interactions API에서 출시됩니다. |
| 모델 ID | 미공개 | 모델 페이지, 가격 페이지, 변경 로그에 없음 |
| 입력 컨텍스트 창 | 미공개 | Google의 장문 컨텍스트 평가는 최대 1M 토큰 프롬프트를 사용했지만, 이는 사양이 아닙니다. |
| 사고 수준 | 미공개 | 평가는 "최고 사고 설정"으로 실행되었습니다. 이름과 기본값은 알려지지 않았습니다. |
| 요율 제한 | 미공개 | 발표된 계층 없음 |
| 배치 지원 | 미공개 | 배치 또는 Flex 가격 없음 |
| 장문 프롬프트 계층 | 미공개 | 3.1 Pro는 200K 이상에서 더 많은 비용을 청구합니다. Argon의 규칙은 명시되지 않았습니다. |
| 도입 기간 길이 | 미공개 | $2/$10 가격의 종료일 없음 |
두 행을 더 자세히 살펴볼 필요가 있습니다. "API 표면" 행은 새 모델이 "Interactions API에서 출시될 것"이라고 명시된 Interactions API 문서에서 가져온 것입니다. Argon은 새로운 모델이므로, 먼저 그곳에서 출시될 것으로 예상됩니다. Google은 generateContent가 이를 지원할지 여부는 언급하지 않았습니다. "출력" 행은 Google이 모델에 대해 명시한 제한이지만, Vals AI는 테스트한 구성에 대해 최대 262K 출력을 나열하고 있으므로, 모든 엔드포인트가 첫날부터 전체 백만 토큰을 제공한다고 가정하지 마십시오. 1M 출력 토큰 가이드에서는 해당 제한이 스트리밍, 시간 초과 및 저장소에 미치는 영향을 다룹니다.
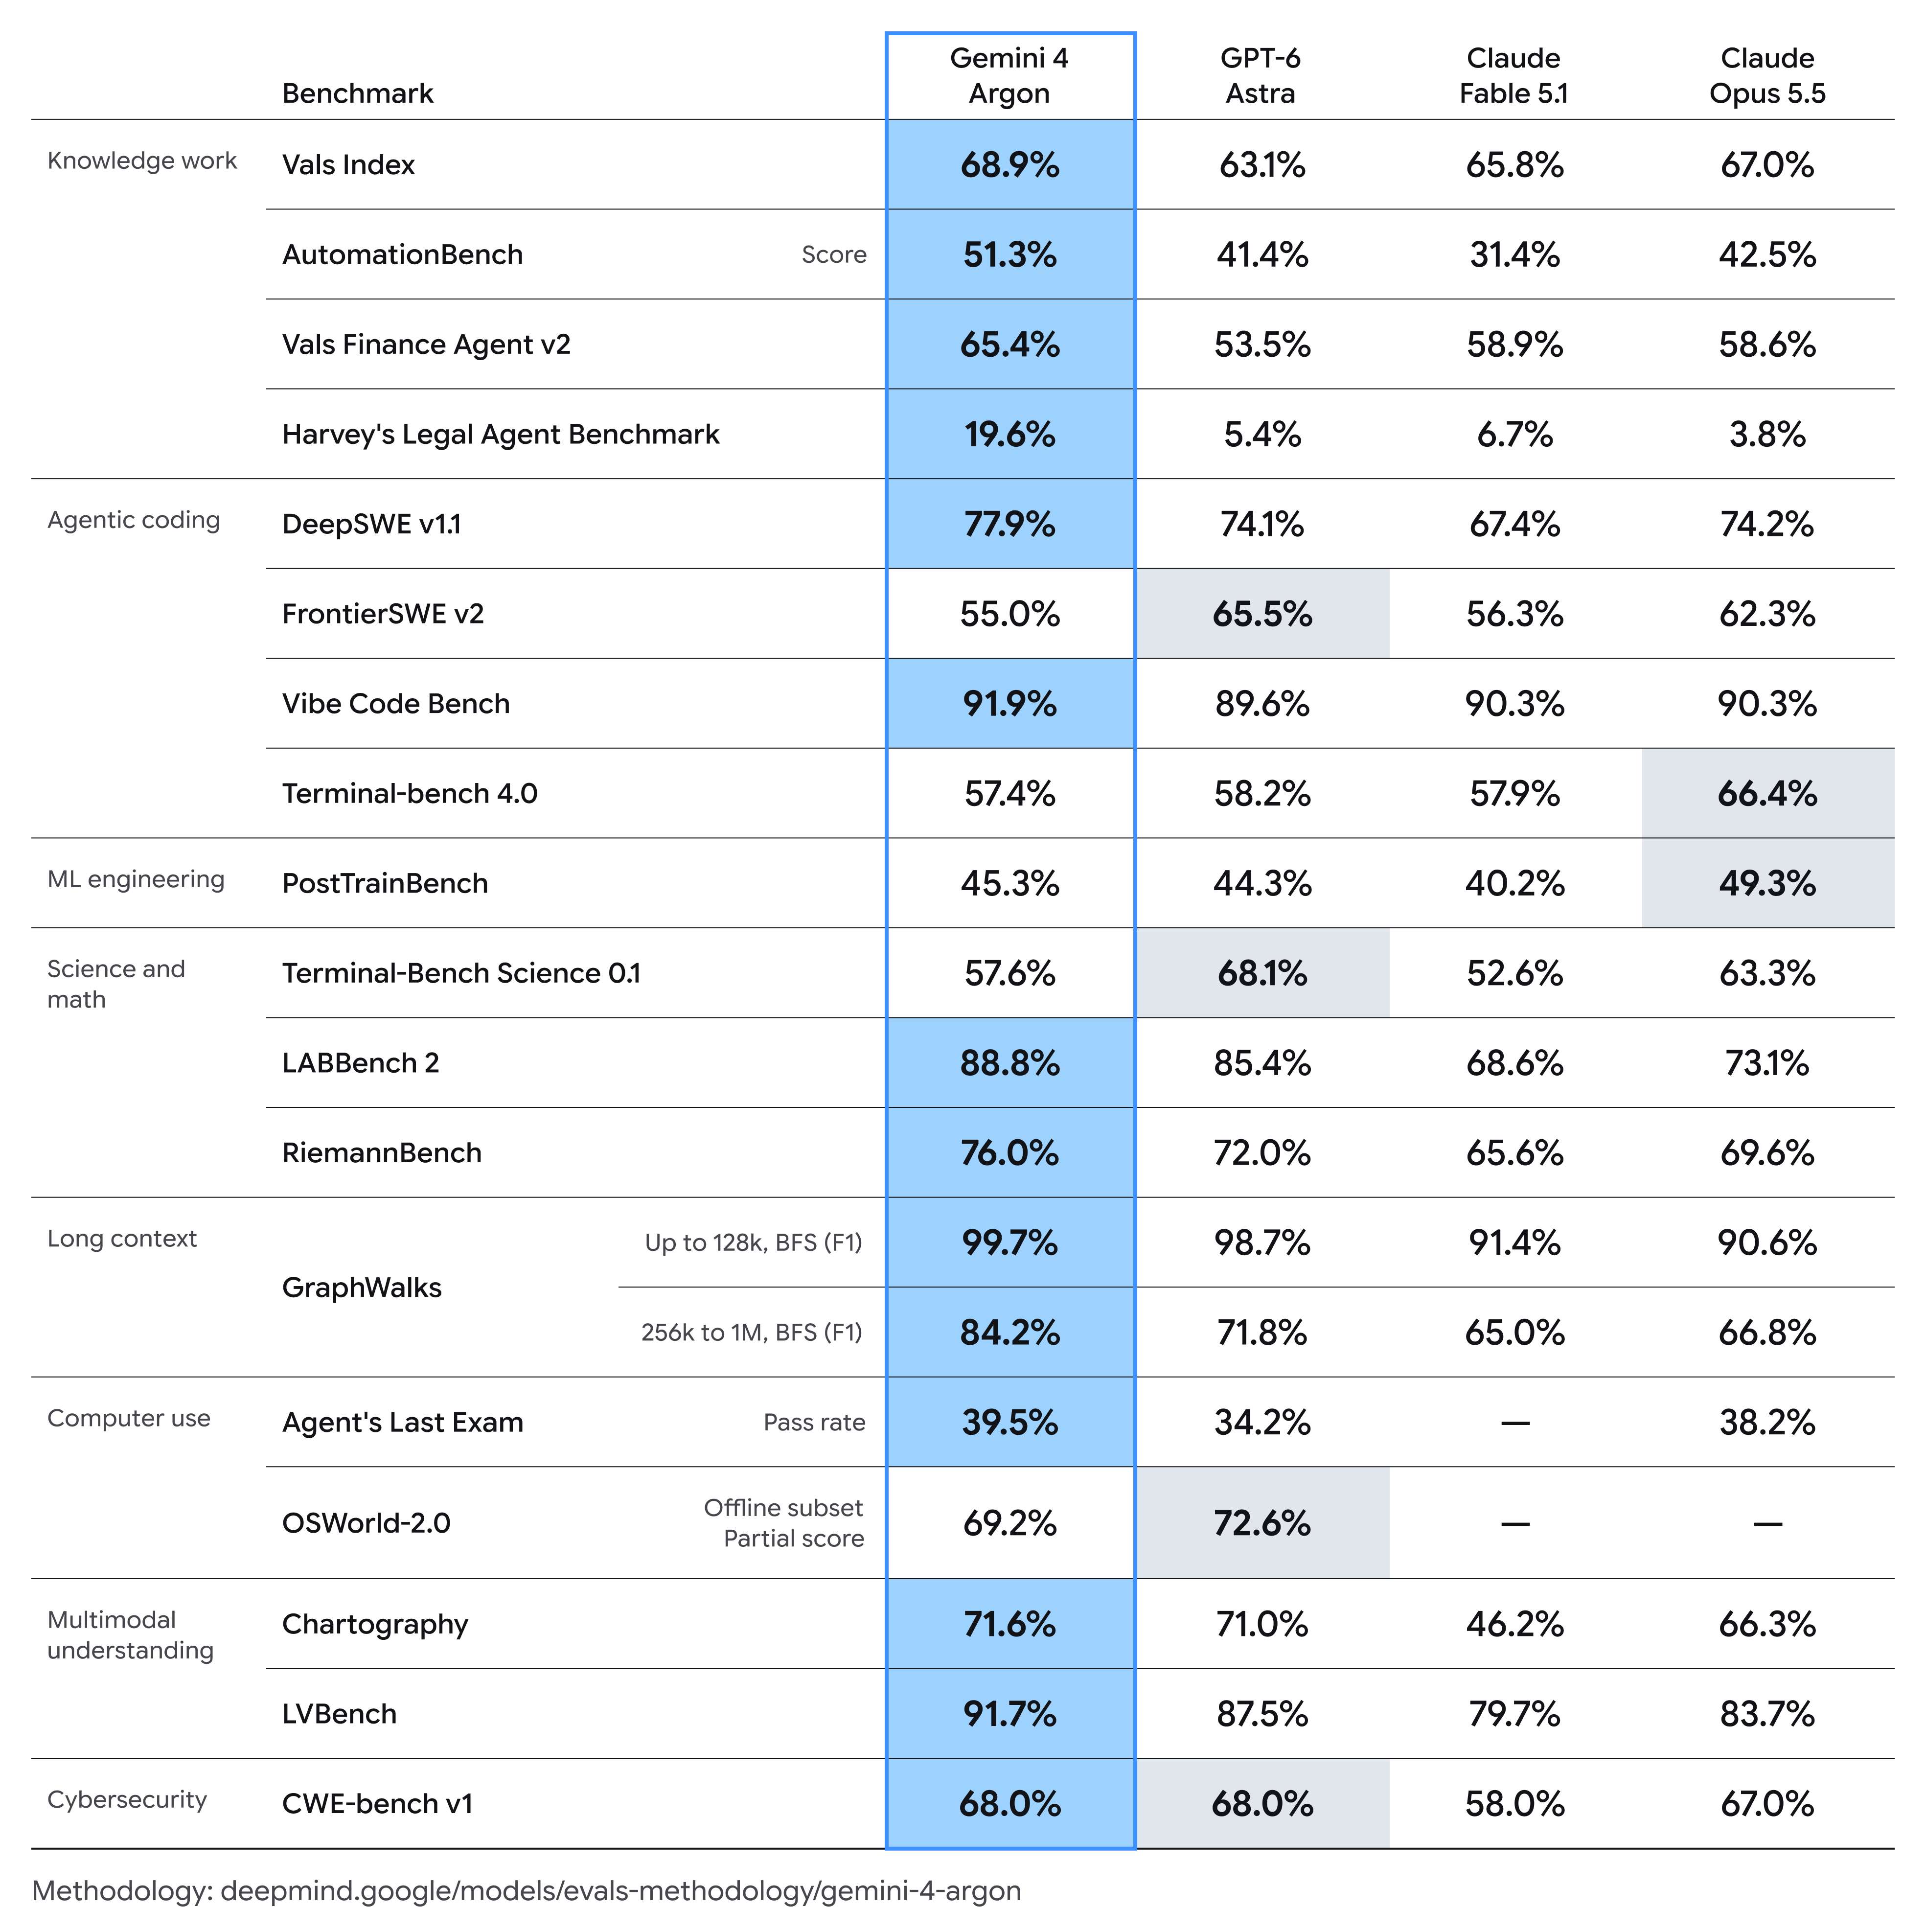
가격에 대해서는 한 단락이면 충분합니다. 20,000 토큰 프롬프트와 5,000 출력 토큰을 사용하는 요청은 도입 요율에서 20,000 x $2/1M + 5,000 x $10/1M = $0.04 + $0.05 = $0.09가 들고, 표준 $4/$20에서는 $0.18이 듭니다. Argon의 도입 출력 가격($10)은 Gemini 3.1 Pro Preview의 $12보다 낮고, 표준 가격은 Claude Opus 5.5와 정확히 일치합니다. Gemini 4 Argon 가격 분석은 캐시된 입력과 최대 1M 토큰 응답을 포함한 전체 시나리오를 다룹니다.
온라인에서 찾은 모델 ID를 하드코딩하지 마십시오.
Argon 모델 ID를 검색하면 벤치마크 사이트, 집계 서비스, 오픈소스 풀 리퀘스트에서 문자열을 찾을 수 있을 것입니다. 그것들은 자리 표시자입니다. Vals AI는 자체 모델 페이지에 자체 슬러그를 사용하고, 한 GitHub 풀 리퀘스트는 ID를 "임시적으로" 추가하며, OpenRouter 스타일 경로는 찾을 수 없는 페이지로 이어집니다. Google은 그 중 어떤 것도 확인하지 않았으며, 여러 매체에서 추측을 하드코딩하는 것에 대해 명시적으로 경고하고 있습니다.
추측한 ID는 가장 도움이 되지 않는 방식으로 실패합니다. 배포 당일 프로덕션에서 404 오류가 발생하거나, 래퍼가 오류를 너무 광범위하게 포착하는 경우 자동 실패로 이어질 수 있습니다. 대신 모델 이름을 구성에 보관하십시오. 아래의 모든 예제에서 모델은 기본적으로 오늘 호출할 수 있는 안정적인 모델인 gemini-3.8-flash로 설정된 GEMINI_MODEL 환경 변수에서 가져옵니다. Google이 Argon의 ID를 게시하면, 하나의 값만 변경하면 됩니다.
Gemini 3.8 Flash에서 코드를 준비하세요.
Gemini 3.8 Flash (gemini-3.8-flash)는 Argon이 사용할 것으로 예상되는 동일한 엔드포인트, 헤더 및 응답 형식으로 실행되며, 2026년 12월 31일까지 100만 토큰당 $0.75/$3.75의 비용이 듭니다. API 키는 GEMINI_API_KEY에 저장되어야 하며, 코드에 직접 붙여넣지 마십시오. 전체 설정은 Gemini 3.8 Flash API 가이드에 있습니다.
1단계: Interactions API 요청 보내기
Interactions API는 Google의 주요 API이며, 2026년 6월부터 일반적으로 사용 가능합니다. Argon의 수준 이름이 게시되지 않았으므로 모델과 사고 수준을 모두 변수에 보관하십시오.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Python SDK는 Interactions API를 위해 google-genai 2.3.0 이상이 필요합니다.
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
3.8 Flash에서는 유효한 수준이 low, medium (기본값), high이며, minimal은 HTTP 400을 반환합니다. 사고 수준 가이드에서 절충점에 대해 설명합니다. 다중 턴 작업의 경우, 이전 응답의 ID를 previous_interaction_id로 전달하고, 서버 측 저장소를 사용하지 않으려면 store: false를 보내십시오.
2단계: generateContent 경로 계속 작동시키기
대부분의 기존 코드는 Google이 여전히 완전히 지원한다고 밝힌 레거시 generateContent 엔드포인트를 호출합니다. 다음은 동일한 요청입니다.
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
사고 수준이 어디에 있는지 주목하십시오. Interactions에서는 generation_config.thinking_level에, 여기서는 generationConfig.thinkingConfig.thinkingLevel에 있습니다. 클라이언트가 둘 다 래핑하는 경우, 기본적으로 새 모델을 Interactions를 통해 라우팅하십시오. 도구 정의도 동일한 주의가 필요합니다. Gemini 3.8 Flash 함수 호출을 참조하십시오.
3단계: models.list로 출시 확인 예약하기
변경 로그를 새로고침하지 마십시오. API에 문의하십시오. 모델 엔드포인트는 사용 가능한 모델과 해당 토큰 제한 및 지원되는 메서드를 반환합니다.
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
프로덕션 앱이 사용하는 키를 사용하여 cron 또는 CI 스케줄에서 시간 단위로 실행하십시오. 2026년 10월 1일에 유료 프로젝트 키로 이 호출을 실행했을 때, 61개의 모델과 nextPageToken 없음, 그리고 "argon"을 포함하는 이름은 반환되지 않았습니다. 일치하는 날에는 실제 모델 이름, outputTokenLimit이 전체 1M인지 여부, 그리고 어떤 메서드가 나열되는지 세 가지 정보를 한 번에 알려줄 것입니다.
4단계: 응답을 모의(mock)하여 액세스 전에 클라이언트 구축하기
Argon을 사용하는 코드를 빌드하기 위해 Argon이 필요하지 않습니다. 2단계 요청을 Apidog에 GEMINI_API_KEY와 GEMINI_MODEL을 환경 변수로 저장하고, 3.8 Flash를 대상으로 한 번 전송한 다음, 실제 응답을 응답 예제로 엔드포인트에 추출하십시오. Apidog의 기본 Smart Mock은 스키마에서 데이터를 생성하므로, 프로젝트의 기본 모의 메서드를 "Response example first"(프로젝트 설정, 기능 설정, 모의 설정)로 설정하십시오. 그러면 모의 URL은 저장된 응답을 반환하여 프런트 엔드, 큐 워커 및 파서가 토큰을 소비하지 않고 실행될 수 있습니다.
이 모의(mock)가 무엇인지 명확히 알아두십시오. Google이 Argon 전용 스키마를 게시하지 않았으므로, 이는 현재 Gemini 응답 스키마이지 Argon 전용 스키마가 아닙니다. Argon이 동일한 API에서 예상되므로 여전히 올바른 선택입니다. 용량이 큰 Argon 응답을 연습하려면 예제의 usageMetadata를 큰 값으로 편집하고 청구 및 알림 코드가 반응하는지 확인하십시오.
5단계: usageMetadata 및 비용 상한선에 대한 단언(assert)
모든 generateContent 응답에는 usageMetadata가 포함됩니다. Apidog에 각 응답의 가격을 Argon의 표준 요율로 책정하는 후처리 스크립트를 추가하여, 청구서가 발행되기 전에 테스트가 실패하도록 하십시오.
// Apidog 후처리 스크립트: Gemini 4 Argon의 표준 요율로 이 응답의 가격 책정
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // 도입 기간 후 입력 토큰당 USD
const OUT = 20 / 1e6; // 출력 토큰당 USD; 현재 Gemini 모델에서는 사고(thinking)도 출력으로 청구됩니다.
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata가 존재합니다", () => pm.expect(u).to.be.an("object"));
pm.test("Argon 요율에서 비용이 $0.10 미만입니다", () => pm.expect(cost).to.be.below(0.10));
요청당 상한선을 선택하십시오. $0.10은 이와 같은 짧은 프롬프트에 적합합니다. Google은 Argon이 사고(thinking) 토큰에 대해 어떻게 요금을 청구하는지 명시하지 않았으므로, 스크립트는 현재 Gemini 규칙을 가정합니다. 동일하게 저장된 요청을 지금 3.8 Flash에 대해 실행하고 나중에 Argon에 대해 실행하십시오. 토큰 수와 비용의 차이가 회귀 비교가 됩니다.
자주 묻는 질문
Gemini 4 Argon API를 사용할 수 있나요? 공개적으로는 아직 아닙니다. Argon은 Fairwind 프로그램 파트너들에게만 배포되고 있으며, 이들은 Gemini Enterprise를 통해 Argon을 사용합니다. 유료 API 고객과 Google AI Ultra 구독자가 다음이지만, 날짜는 정해지지 않았습니다.
Gemini 4 Argon 모델 ID는 무엇인가요? Google은 아직 게시하지 않았습니다. 타사 사이트의 문자열은 자리 표시자이므로, 모델을 환경 변수에 보관하고 models.list를 주시하십시오.
Gemini 4 Argon API 비용은 얼마인가요? 기간이 명시되지 않은 도입 기간 동안 100만 토큰당 입력 $2, 출력 $10이며, 그 후에는 $4와 $20입니다. 캐시된 입력은 95% 할인됩니다. Gemini 4 Argon 가격 책정을 참조하십시오.
Argon이 generateContent와 함께 작동할까요? Google은 언급하지 않았습니다. 문서에는 모든 새 모델이 Interactions API에서 출시된다고 명시되어 있으므로, Interactions를 기반으로 빌드하고 generateContent를 대체(fallback)로 취급하십시오.
Google AI Ultra로 API에 액세스할 수 있나요? 아니요. AI Ultra는 소비자 구독이며 API 키가 아닙니다. Google은 유료 API 고객부터 API 액세스가 시작된다고 말합니다.
다음 단계
모든 환경에서 GEMINI_MODEL을 설정하고, models.list 확인을 예약하며, 비용 단언이 첨부된 Interactions 및 generateContent 요청을 저장하십시오. Apidog를 다운로드하여 해당 요청, 모의(mock) 및 테스트를 하나의 작업 공간에 보관한 다음, Google이 ID를 게시할 때 변수 하나만 변경하십시오.