
Gemini 4 Argon의 주요 수치인 100만 토큰은 컨텍스트 창이 아닌 출력 한계입니다. Google은 단일 Argon 응답이 이전 64K 제한의 약 16배인 100만 토큰에 달할 수 있으며, Argon의 입력 창은 전혀 공개하지 않았다고 말합니다. 아직 호출할 것은 없습니다. Argon은 현재 Fairwind 프로그램 방어자에게만 제공되며, Google이 액세스를 시작하면 유료 API 고객에게 다음으로 제공됩니다 (출시일 및 액세스 가이드를 참조하십시오).
이렇게 긴 응답은 대부분의 API 스택이 의존하는 세 가지 가정을 깨뜨립니다. 즉, 호출이 몇 초 안에 완료되고, 본문이 메모리에 맞으며, 단일 요청의 비용이 작고 예측 가능하다는 가정입니다. 이 가이드에서는 최대 응답 비용, 스트리밍, 타임아웃, 출력 제한, 스토리지, 그리고 액세스 전에 Apidog에서 이 모든 것을 테스트하는 방법을 다룹니다. 모델 개요는 Gemini 4 Argon이란 무엇인가를 참조하고, 요청 형식은 Gemini 4 Argon API 가이드를 참조하십시오.
100만 출력 토큰은 100만 컨텍스트 창이 아닙니다
Argon에 대해 순위를 매긴 여러 페이지에서는 100만이라는 수치를 컨텍스트 창으로 설명하고 있으며, 한 헤드라인은 이를 “16배 더 큰 컨텍스트 창”이라고 부릅니다. 그것은 거꾸로 된 것입니다. Google의 출시 게시물에는 “모델의 출력 토큰 한도를 업계 최고 수준인 100만 토큰으로 확장했다”고 명시되어 있습니다. 64K는 Google의 이전 최고 Pro 모델인 Gemini 3.1 Pro Preview의 65,536 토큰 출력 제한과 일치합니다.
입력은 Google이 아직 공개하지 않은 별도의 수치입니다. 평가 방법론에 설명된 장문 컨텍스트 평가는 256K에서 1M 토큰 사이의 프롬프트를 사용했습니다. 이는 벤치마크 하위 집합이지 사양이 아닙니다. 출력 측면에도 주의할 점이 있습니다. Vals AI는 테스트한 Argon 구성에 대해 최대 262K 출력을 나열합니다. Google은 모델의 한도가 1M이라고 말하지만, 적어도 한 타사 평가자는 사용한 엔드포인트에서 더 낮은 한도를 확인했습니다.
| 모델 | 응답당 최대 출력 | 입력 또는 컨텍스트 창 |
|---|---|---|
| Gemini 4 Argon | 100만 (Google이 명시한 한도) | 미공개 |
| Gemini 3.1 Pro Preview | 65,536 | 1,048,576 |
| Gemini 3.8 Flash | 65,536 | 1,048,576 |
| GPT-6 Astra | 128,000 | 1,050,000 (최대 입력 922K) |
| Claude Opus 5.5 | 128K (베타 헤더를 사용한 Batch에서는 300K) | 100만 |
모든 경쟁사는 동기 출력을 128K로 제한하므로, Argon의 명시된 한도는 그들의 약 8배입니다. Google의 이유는 추론의 깊이에 있습니다. 여유 공간이 있으면 모델은 “단일 궤적에서 수십만 개의 토큰을 생성”하고 어려운 문제를 한 번에 해결할 수 있습니다. 다른 공급업체가 장기 실행을 처리하는 방법은 Claude Opus 5.5의 18시간 작업 및 GPT-6 Astra API 가이드를 참조하십시오.
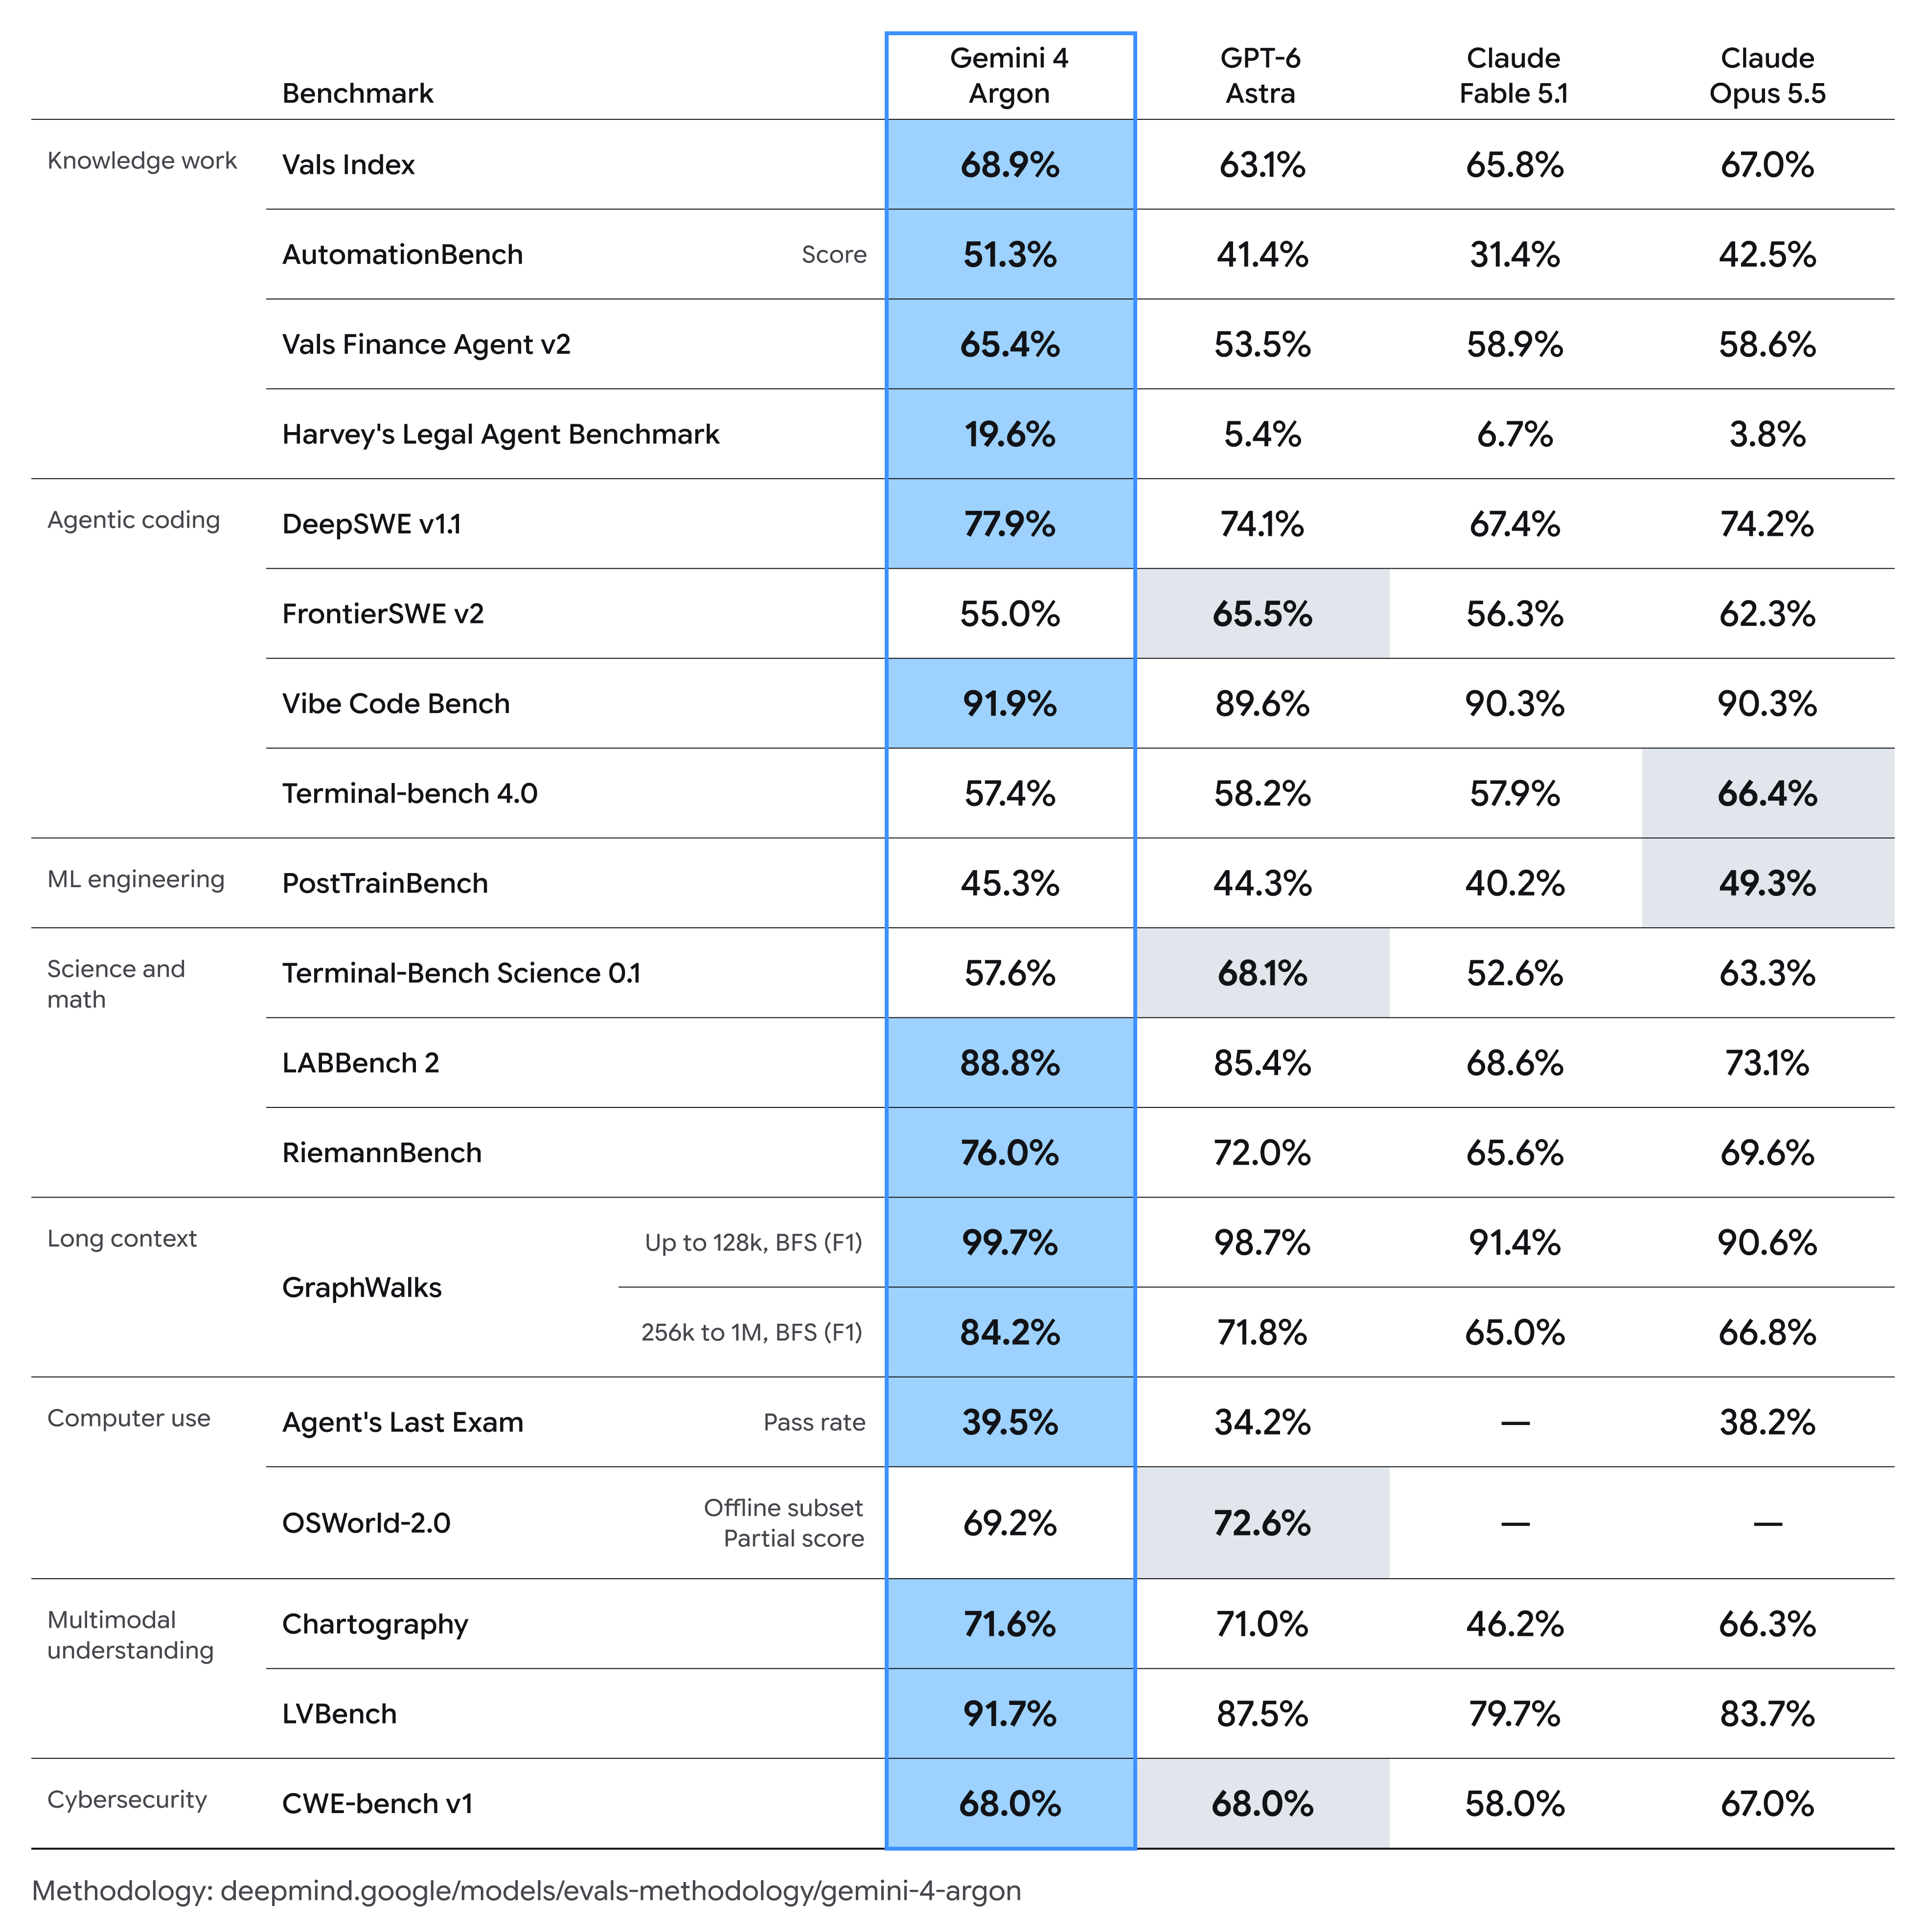
최대 응답 하나의 비용
먼저 상한선을 책정합니다. Argon의 출시 기간 동안 출력 요금은 100만 토큰당 $10이며, 그 이후에는 $20이므로, 완전한 길이의 응답 하나는 다음과 같은 비용이 발생합니다:
- 출시 기간: 1,000,000 x $10/1M = 출력 비용 $10.00
- 표준: 1,000,000 x $20/1M = 출력 비용 $20.00
입력은 별도로 추가됩니다. 200,000 토큰 프롬프트는 출시 요금으로 200,000 x $2/1M = $0.40, 표준 요금으로는 $0.80가 추가되므로, 단일 최대 호출은 $10.40 또는 $20.80입니다. 이러한 작업 100개를 실행하는 야간 작업은 출시 요금으로 $1,040의 비용이 듭니다.
사고(thinking) 과정이 이를 더 복잡하게 만듭니다. 현재 Gemini 모델에서는 사고 토큰이 출력으로 청구됩니다. Google은 Argon이 이 규칙을 따르는지 또는 사고 과정이 100만 토큰 상한선에 포함되는지에 대해 언급하지 않았습니다. 어느 쪽이든, 짧은 가시적 응답도 여전히 상당한 출력 비용을 발생시킬 수 있습니다. Gemini 4 Argon 가격 가이드에는 95% 할인된 캐시 입력 등 더 많은 시나리오가 포함되어 있습니다.
스트리밍이 필수적인 이유
스트리밍이 아닌 호출은 전체 응답이 완료될 때까지 아무것도 반환하지 않습니다. 수십만 개의 토큰에서는 이는 긴 무음 연결이며, 스택 전체의 유휴 타임아웃으로 인해 첫 바이트가 도착하기 전에 연결이 닫힐 수 있습니다.
대신 스트림을 사용하십시오. generateContent에서 메서드를 :streamGenerateContent?alt=sse로 바꾸면 Google은 서버 전송 이벤트를 보내며, 각 이벤트당 하나의 부분 후보 청크를 보냅니다. 각 이벤트가 도착하는 즉시 읽고 기록하십시오. 먼저 본문을 수집하지 마십시오. 이것은 현재 Gemini 3.8 Flash에서 실행되며, Google이 Argon의 모델 ID를 공개하지 않았으므로 모델은 변수에 있습니다 (Gemini 3.8 Flash API 가이드에 설정 방법이 있습니다).
import json, os, requests

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
URL = ("https://generativelanguage.googleapis.com/v1beta/models/"
       f"{MODEL}:streamGenerateContent?alt=sse")
body = {
    "contents": [{"parts": [{"text": "Write a test plan for every endpoint in a payments API."}]}],
    "generationConfig": {"maxOutputTokens": 60000},
}
usage = None
with requests.post(URL, json=body, stream=True, timeout=(10, 120),
                   headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]}) as r, \
        open("response.txt", "a", encoding="utf-8") as out:
    r.raise_for_status()
    for line in r.iter_lines(decode_unicode=True):
        if not line or not line.startswith("data:"):
            continue
        event = json.loads(line[5:])
        for cand in event.get("candidates", []):
            for part in cand.get("content", {}).get("parts", []):
                out.write(part.get("text", ""))
        out.flush()
        usage = event.get("usageMetadata", usage)
print(usage)
timeout=(10, 120)은 10초 연결 타임아웃과 120초 읽기 타임아웃을 설정합니다. requests에서 읽기 타임아웃은 전체 기간이 아닌 바이트 사이의 가장 긴 간격을 의미하므로, 계속 전송하는 스트림은 필요한 만큼 실행될 수 있습니다. 각 청크는 도착하는 즉시 디스크에 저장됩니다. 3.8 Flash에서는 모든 이벤트에 실행 중인 usageMetadata가 포함되므로, 마지막 이벤트에서 로깅 및 청구에 사용할 최종 토큰 수를 얻을 수 있습니다.
모든 홉에서의 타임아웃
클라이언트는 하나의 홉입니다. 긴 스트림은 또한 리버스 프록시, API 게이트웨이, 로드 밸런서, 그리고 어쩌면 서버리스 런타임을 거치며, 이들 중 어느 것이든 응답을 조기에 종료할 수 있습니다:
| 홉 | 확인할 사항 | 오류 시 증상 |
|---|---|---|
| HTTP 클라이언트 | 읽기 또는 유휴 타임아웃, 그리고 총 요청 타임아웃 | 긴 응답에서만 스트림 중간에 예외 발생 |
| 리버스 프록시 | text/event-stream에 대한 읽기 타임아웃 및 응답 버퍼링 |
이벤트가 버스트로 도착하거나 스트림이 끊어짐 |
| API 게이트웨이 | 최대 요청 지속 시간 | 모든 실행에서 동일한 경과 시간에 요청 실패 |
| 로드 밸런서 | 유휴 타임아웃 | 첫 이벤트 전 긴 일시 중지 중에 끊어짐 |
| 서버리스 함수 | 최대 실행 시간 | 모델이 계속 작성 중인데 함수가 종료됨 |
고정된 차단 지점을 주시하십시오. 긴 응답이 항상 동일한 경과 시간에 실패한다면, 일부 홉에 스트리밍으로 해결할 수 없는 엄격한 지속 시간 제한이 있는 것이며, 해당 작업은 요청 경로에서 벗어나야 합니다.
백그라운드에서 장기 작업 실행
가장 긴 작업의 경우, 실시간 연결에서 작업을 분리하십시오. 상호작용 API는 background=true를 사용하여 장기 실행 작업에 대한 백그라운드 실행을 지원합니다. 백그라운드 실행은 저장된 상호작용에 의존합니다. 문서에는 store=false가 백그라운드 실행과 호환되지 않는다고 명시되어 있으므로, 이러한 요청에는 스토리지를 켜두십시오. 완료된 백그라운드 상호작용을 검색하려면 Google 문서를 따르십시오. 폴링 엔드포인트를 추측하지 마십시오. Google은 새로운 모델이 상호작용 API에서 출시된다고 말하므로, Argon의 장기 작업이 거기서 실행될 계획을 세우십시오.
의도적으로 출력 제한
100만 한도는 목표가 아니라 상한선입니다. generateContent에서 generationConfig.maxOutputTokens는 각 응답을 제한합니다. 스트리밍 예제에서는 60,000으로 설정되어 있습니다. 3.8 Flash에서 사고 과정은 이 제한에 포함됩니다. 2,000으로 제한된 테스트 실행에서는 1,340개의 사고 토큰과 656개의 가시적 토큰이 반환되었습니다. 상호작용 API의 경우, Google 문서에서 출력 제한 필드를 확인한 후에 사용하십시오. 그런 다음 호출당 허용할 비용에 따라 제한을 선택하십시오.
| 출력 제한 | 최악의 경우 출력 비용, 표준 ($20/100만) | 출시 기간 ($10/100만) |
|---|---|---|
| 64,000 | 64,000 x $20/100만 = $1.28 | $0.64 |
| 128,000 | $2.56 | $1.28 |
| 500,000 | $10.00 | $5.00 |
| 1,000,000 | $20.00 | $10.00 |
제한에 도달한 응답은 일찍 중지되므로, 불완전한 것으로 간주하십시오. 최종 이벤트의 finishReason을 확인하십시오. MAX_TOKENS는 제한으로 인해 중단되었음을 의미합니다. 그런 다음 후속 턴에서 계속하거나 해당 작업에 대한 제한을 높이십시오.
버퍼링 없이 대용량 출력 저장 및 구문 분석
100만 토큰은 응답당 수 메가바이트의 텍스트입니다. 몇 가지 규칙을 따르면 작업자가 중단되는 것을 방지할 수 있습니다:
- 메모리에 하나의 문자열을 구축하는 대신, 청크가 도착하는 즉시 파일 또는 멀티파트 객체 업로드로 기록하십시오.
- 연결이 끊어지면 부분 파일을 유지하십시오. 맹목적으로 처음부터 다시 시도하면 출력이 다시 생성되고 청구됩니다.
- 구조가 필요한 경우 JSON Lines를 요청하십시오. 그러면 거대한 문서 하나가 닫히기를 기다리는 대신 각 줄이 자체적으로 구문 분석됩니다.
- 전체 본문 대신
usageMetadata및 바이트 수를 로깅하십시오. - 80만 토큰 응답이 도달하기 전에 데이터베이스 및 큐의 열 및 메시지 크기 제한을 확인하십시오.
액세스 오픈 전에 Apidog에서 테스트하기
이 모든 것을 대역을 사용하여 연습할 수 있습니다. Apidog를 다운로드하여 세 가지 점검 사항을 확인하십시오.
스트림 관찰. GEMINI_API_KEY 및 GEMINI_MODEL을 환경 변수로 사용하여 3.8 Flash에 스트리밍 요청을 보냅니다. Apidog는 text/event-stream 응답을 구문 분석하고 각 이벤트가 도착하는 즉시 타임라인 뷰에 표시하므로, 청크 크기, 간격 및 최종 usageMetadata를 확인할 수 있습니다.
훨씬 더 긴 가짜 응답 스트리밍. 실제 3.8 Flash 출력은 최대 65,536 토큰이므로, 동일한 이벤트 형식으로 훨씬 더 많은 데이터를 스트리밍하는 로컬 모의를 실행하십시오:
# long_stream_mock.py: 파서 및 타임아웃 테스트를 위한 Gemini 형식 SSE (가짜 데이터)
import json, time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

EVENTS, DELAY, CHUNK = 20000, 0.005, "lorem ipsum " * 40

class Handler(BaseHTTPRequestHandler):
    def do_POST(self):
        self.rfile.read(int(self.headers.get("Content-Length", 0)))
        self.send_response(200)
        self.send_header("Content-Type", "text/event-stream")
        self.end_headers()
        for i in range(EVENTS):
            event = {"candidates": [{"content": {"parts": [{"text": CHUNK}]}}]}
            if i == EVENTS - 1:  # fake counts sized like a near-max reply
                event["usageMetadata"] = {"promptTokenCount": 1200,
                    "candidatesTokenCount": 950000, "thoughtsTokenCount": 40000,
                    "totalTokenCount": 991200}
            self.wfile.write(f"data: {json.dumps(event)}\n\n".encode())
            self.wfile.flush()
            time.sleep(DELAY)

ThreadingHTTPServer(("127.0.0.1", 8787), Handler).serve_forever()
“모의” 환경의 기본 URL을 http://127.0.0.1:8787로 지정하고 동일한 스트리밍 요청을 보냅니다. 스트림은 약 2분 (테스트에서 128초) 동안 실행되며 960만 자의 텍스트를 전송합니다. 이는 버퍼링 파서, 이벤트를 보류하는 프록시 또는 너무 짧게 설정된 타임아웃을 노출하기에 충분합니다.
토큰 수에 대한 어설션. 스트리밍이 아닌 generateContent 요청에서 usageMetadata의 candidatesTokenCount와 thoughtsTokenCount의 합이 제한 이하로 유지되고, 계산된 비용이 Argon 가격에서 상한선 이하로 유지되는지 어설션하십시오. Argon API 가이드에는 즉시 사용할 수 있는 비용 스크립트가 있습니다.
자주 묻는 질문
- 100만은 Gemini 4 Argon의 컨텍스트 창인가요? 아닙니다. 100만은 응답당 출력 제한이며, 64K에서 증가했습니다. Google은 Argon의 입력 창을 공개하지 않았습니다.
- 100만 토큰 Argon 응답 비용은 얼마인가요? 출시 요금으로는 출력 $10, 표준 요금으로는 $20이며, 입력 비용은 별도입니다. 더 많은 시나리오는 Gemini 4 Argon 가격을 참조하십시오.
- 오늘 100만 토큰 응답을 생성할 수 있나요? 조직이 Argon 액세스가 가능한 Fairwind 그룹에 속해 있지 않다면 불가능합니다. Gemini 3.8 Flash 및 3.1 Pro Preview는 출력을 65,536 토큰으로 제한하며, Vals AI는 테스트한 Argon 구성에 대해 최대 262K 출력을 나열합니다.
- 긴 Argon 응답을 스트리밍해야 하나요? Google은 Argon에 대한 스트리밍 지침을 공개하지 않았지만, 몇 분 동안 실행되는 비스트리밍 호출은 스택의 모든 유휴 타임아웃에 노출됩니다. 스트리밍하거나 상호작용 API에서 백그라운드 실행을 사용하십시오.
- Argon의 출력 제한은 GPT-6 Astra 및 Claude Opus 5.5와 어떻게 비교되나요? 둘 다 동기 출력을 128K로 제한합니다. Anthropic은 베타 헤더를 사용하여 Batch에서 300K를 허용합니다. Argon의 명시된 100만은 그 약 8배입니다.
다음 단계
지금 Gemini 클라이언트에 3.8 Flash에서 스트리밍 및 출력 제한을 추가하고, 스택의 어떤 것도 스트림을 차단하지 않을 때까지 긴 모의 스트림에 대해 실행하십시오. Argon의 ID가 출시되면 GEMINI_MODEL을 변경하고 Apidog에서 동일한 테스트를 다시 실행하십시오.