DeepSeek은 2026년 9월 10일 DeepSeek-V4.1-Flash의 모델 카드를 발표했으며, V4-Pro 고객들에게는 다소 어색한 수치들이 공개되었습니다. 더 작고 저렴한 이 모델은 DeepSeek이 제시한 모든 코딩 및 에이전트 벤치마크에서 플래그십 모델보다 높은 점수를 기록했으며, 피크 시간대 토큰당 비용은 70~77% 더 저렴합니다. 9월 14일에는 V4-Pro를 완전히 흡수하여, 모든 deepseek-v4-pro 요청이 V4.1-Flash로 라우팅되고 Flash 요금으로 청구됩니다.
이는 일반적인 소규모 모델과 대규모 모델 간의 절충안이 아닙니다. 이것은 마감 기한이 있는 비교입니다. 만약 프로덕션 환경에서 V4-Pro를 사용하고 있다면, 라우팅 변경이 적용될 때 어떤 변화가 생기는지 알아낼 시간이 나흘 남았습니다. V4-Flash를 사용하고 있다면, 이미 변경이 완료되었습니다: 오늘부터 deepseek-v4-flash라는 이름은 V4.1-Flash에 의해 서비스됩니다.
아래에서는 세 가지 모델의 아키텍처, DeepSeek이 보고한 벤치마크, USD 가격, 처리량을 다루며, 이어서 라우팅 변경 전에 Apidog에서 deepseek-v4-pro와 deepseek-flash 모두에 동일한 프롬프트 세트를 실행하여 출력, 지연 시간, 사용량 카운트를 비교하는 워크플로우를 소개합니다. 아키텍처에 대한 심층 분석을 위해서는 먼저 DeepSeek-V4.1-Flash가 무엇인지를 읽어보시고, 마이그레이션 체크리스트는 V4-Pro 서비스 종료 가이드를 참조하십시오.
요약 (TL;DR)
- V4.1-Flash는 DeepSeek 자체 벤치마크에서 우위를 점합니다. DeepSWE v1.1은 핵심 지표로, V4-Pro의 62.7점, V4-Flash의 54.4점에 비해 74.2점을 기록했습니다.
- 세 모델 중 가장 저렴합니다. 피크 시간대 캐시 미스 입력 비용은 V4-Pro의 132달러, 구형 V4-Flash의 44달러에 비해 100만 토큰당 30달러입니다.
- 처리량에 최적화되어 있습니다. 프리필(prefill) 시 80억 개의 활성 파라미터, 토큰당 890바이트의 KV 캐시, 2,500의 동시성 제한을 가집니다.
- 9월 14일 이후에는 하나의 선택지뿐입니다. V4-Pro 트래픽은 V4.1-Flash로 라우팅됩니다. 중요한 것은 무엇을 얻고 잃는지이지, 어떤 것을 선택할지가 아닙니다.
사양 비교
V4.1 세대는 재사후 학습이 아닌 새로운 아키텍처입니다. DeepSeek은 이를 Causal Encoder-Decoder (CED)라고 부르는데, 20개의 인코더와 20개의 디코더로 구성된 40개의 레이어와 각 레이어당 384개의 라우팅된 전문가 및 하나의 공유 전문가를 가집니다. 모델 카드에 따르면 백본은 5520억 개의 파라미터를 가집니다 (비전 인코더 포함 시 7630억 개).
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| 아키텍처 세대 | V4 MoE | V4 MoE | V4.1 Causal Encoder-Decoder, 40개 레이어 |
| 총 파라미터 | 284B (OpenRouter 비전 빌드 목록) | 여기서는 미공개 | 백본 552B, 비전 인코더 포함 763B |
| 활성 파라미터 | 13B | 여기서는 미공개 | 프리필 8B, 디코드 16B |
| 컨텍스트 창 | 100만 토큰 | 100만 토큰 | 100만 토큰 |
| 최대 출력 | 384K 토큰 | 384K 토큰 | 384K 토큰 |
| 비전 | 별도 Vision-Exp 빌드 | 여기서는 미공개 | 네이티브, DeepSeek-ViT 인코더 |
| 라이선스 | 여기서는 다루지 않음 | 여기서는 다루지 않음 | MIT, 가중치는 Hugging Face에 공개 |
| 동시성 제한 | 2,500 | 500 | 2,500 |
| API 상태 | 종료됨, V4.1-Flash에서 별칭 서비스 중 | 9월 14일 V4.1-Flash로 라우팅 변경 | 9월 10일부터 GA, 모델 ID deepseek-flash |
주목할 만한 세부 사항은 분할된 활성 파라미터 수입니다: V4-Flash는 모든 토큰에 130억 개를 사용했지만, V4.1-Flash는 입력에 80억 개, 품질이 중요한 출력에 160억 개를 사용합니다.
벤치마크: 11.5점의 출처
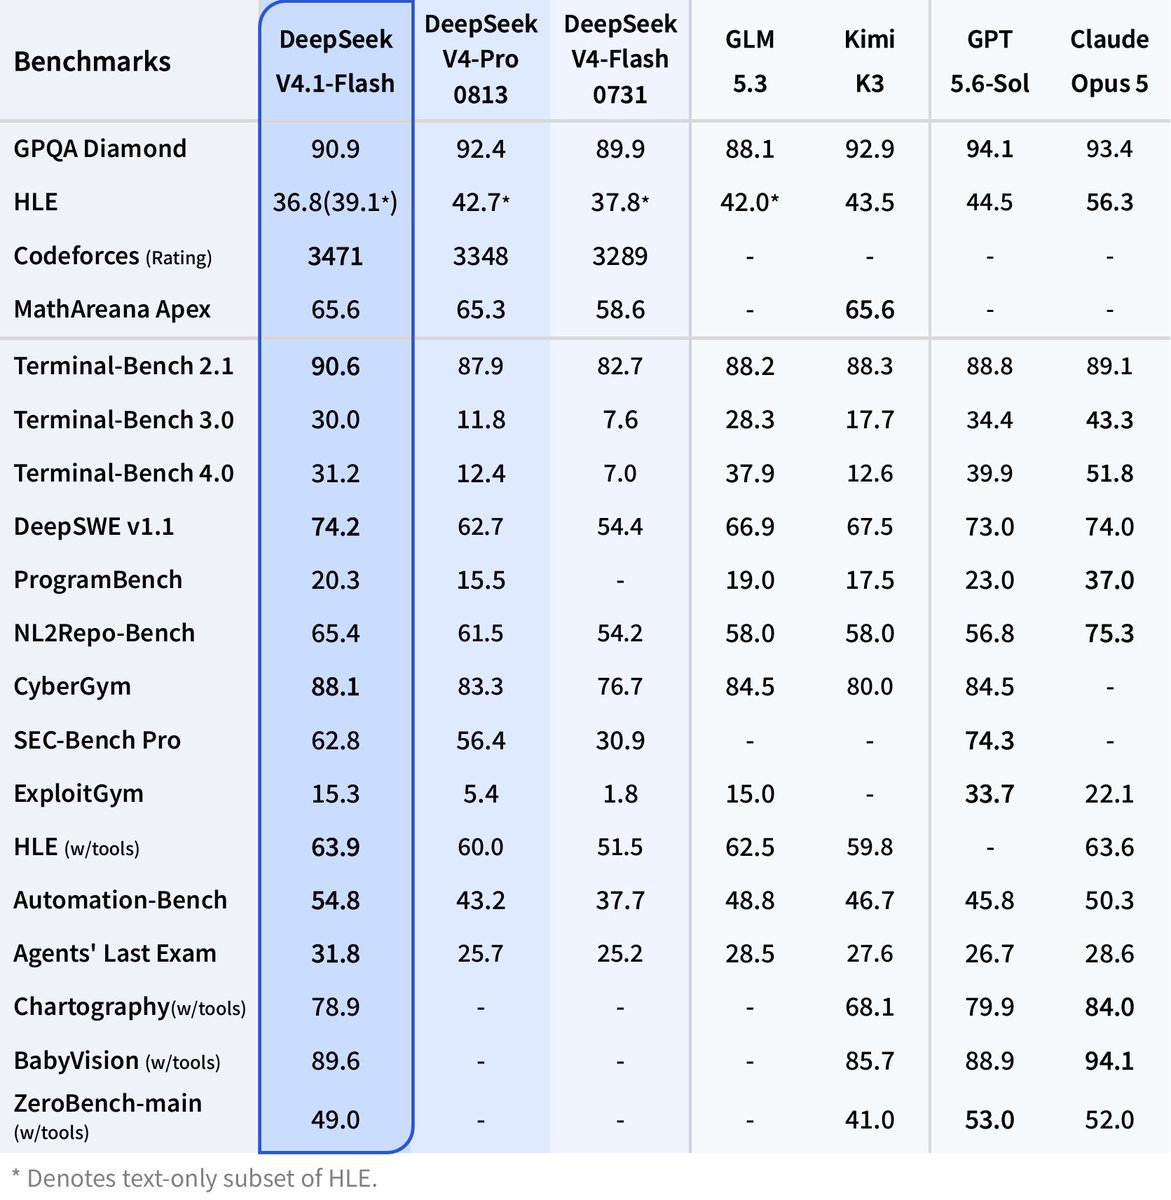
아래의 모든 수치는 모델 카드에서 DeepSeek이 보고한 것입니다. 독립적인 실행 결과는 게시되지 않았으며, 서비스 종료 공지에 언급된 "여러 당사자에 의한 테스트"는 그들의 이름을 밝히지 않았습니다. 이 수치들을 공급업체의 주장으로 간주하고 사용자 고유의 프롬프트로 검증하십시오.
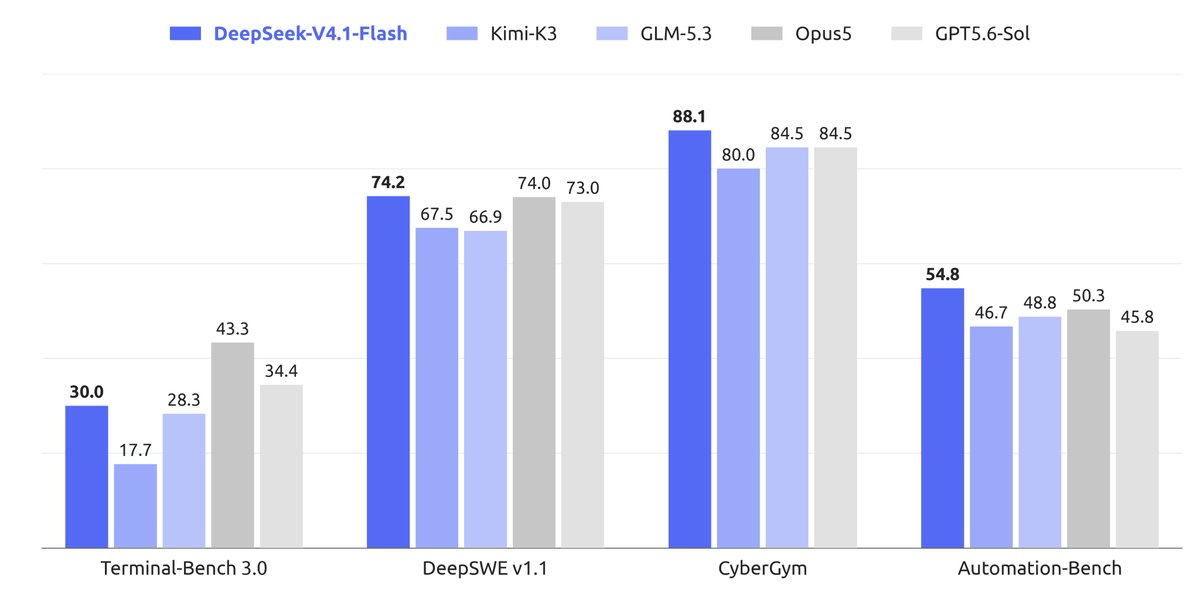
DeepSWE v1.1 (Pro 대비 +11.5점, V4-Flash 대비 +19.8점). 헤드라인을 장식하는 수치이며, 의사결정을 바꿀 만큼 충분히 큰 격차입니다. DeepSWE는 코딩 에이전트가 매일 수행하는 다중 파일 소프트웨어 엔지니어링 작업을 측정합니다. 이 수치가 사용자 리포지토리에서도 유효하다면, V4.1-Flash는 4배 더 비싼 모델보다 코딩 능력이 우수합니다.
Terminal-Bench 2.1 (+2.7점). 셸 기반 에이전트 작업입니다. V4-Flash-0731은 이미 7월에 V4-Pro-Preview를 이겼으며, V4.1은 3점 미만으로 리드를 확장했습니다. 실제적인 차이지만 결정적이지는 않습니다.
HumanEval (+2.6점) 및 GSM8K (+0.4점). 두 벤치마크 모두 거의 포화 상태입니다. 모든 모델이 GSM8K에서 90점 이상을 기록하며, HumanEval은 프로덕션 코드에 대해 많은 것을 말해주지 않습니다. 이 항목들은 크게 중요하게 다루지 마십시오.
MiniMax M3 대 DeepSeek V4 대 Qwen 3.7에는 다른 오픈 모델과 비교한 V4 세대의 수치가 있습니다. 아직 V4.1은 포함되지 않았습니다.
비용: 세 모델, 여섯 가지 가격 등급
피크 시간대는 월요일부터 금요일, UTC 01:00부터 04:00 및 06:00부터 10:00까지이며, 그 외 시간은 비피크 시간대로 절반 가격이 적용됩니다. 요금은 9월 10일부로 적용되는 가격 페이지 기준 100만 토큰당입니다. V4-Flash 행은 2026년 8월 21일 기준 USD 요금을 "이전" 열로 사용합니다.
| 모델 및 등급 | 입력, 캐시 히트 | 입력, 캐시 미스 | 출력 |
|---|---|---|---|
| V4-Flash, 비피크 (8월 21일 요금) | $0.007 | $0.22 | $0.66 |
| V4-Flash, 피크 (8월 21일 요금) | $0.014 | $0.44 | $1.32 |
| V4-Pro, 비피크 | $0.022 | $0.66 | $1.98 |
| V4-Pro, 피크 | $0.044 | $1.32 | $3.96 |
| V4.1-Flash, 비피크 | $0.003 | $0.15 | $0.60 |
| V4.1-Flash, 피크 | $0.006 | $0.30 | $1.20 |
V4-Flash와 비교했을 때, V4.1은 캐시 히트 입력을 약 57%, 캐시 미스 입력을 약 32%, 출력을 약 9% 절감합니다. V4-Pro와 비교했을 때는 피크 시간대 캐시 미스 입력에서 77%, 출력에서 70% 절감됩니다.
월별 계산 예시. 코딩 에이전트가 월 20억 입력 토큰을 처리하며, 캐시 히트율은 70% (시스템 프롬프트와 레포 컨텍스트가 턴마다 재사용됨)이고, 3억 출력 토큰을 모두 피크 시간대에 생성합니다.
| V4-Pro, 피크 | V4-Flash, 피크 | V4.1-Flash, 피크 | V4.1-Flash, 비피크 | |
|---|---|---|---|---|
| 14억 캐시 히트 입력 | $61.60 | $19.60 | $8.40 | $4.20 |
| 6억 캐시 미스 입력 | $792.00 | $264.00 | $180.00 | $90.00 |
| 3억 출력 | $1,188.00 | $396.00 | $360.00 | $180.00 |
| 월별 총계 | $2,041.60 | $679.60 | $548.40 | $274.20 |
이는 V4-Pro보다 73% 적은 금액이며, 배치 작업을 비피크 시간대로 옮기면 다시 절반으로 줄어듭니다. 출력 토큰이 모든 열에서 지배적이므로, 70% 출력 절감이 캐시 히트 헤드라인보다 더 중요합니다. V4.1-Flash 가격 분석에서 캐시 히트 계산을 다룹니다.
속도 및 처리량
DeepSeek은 초당 토큰 수치(tokens-per-second figure)를 공개하지 않으므로, 처리량에 대한 이야기는 세 가지 아키텍처적 사실과 한 가지 일화에 기반합니다.
- 토큰당 890바이트의 KV 캐시. FP4 메인 KV 캐싱은 전역 캐시를 V4-Flash의 약 1/4 크기로 만듭니다. 릴리스 노트에는 이전 세대 대비 HBM의 1/4, SSD 저장 공간의 1/8이라고 명시되어 있습니다. 100만 토큰 전체 컨텍스트에는 약 0.9GB의 캐시가 필요합니다.
- 프리필 시 80억 개의 활성 파라미터. V4-Flash의 130억 개보다 입력 토큰당 계산량이 적으므로, 대규모 컨텍스트에서의 첫 토큰 응답 시간(time-to-first-token)이 줄어들 것입니다.
- 동시성 2,500 대 500. 재라우팅된 V4-Pro 트래픽은 Flash의 제한을 계승하여 에이전트 플릿에 5배의 이득을 제공합니다.
- 한 사용자의 보고: "거의 400 t/s". 한 X 사용자가 베타 기간 중 비디오 테스트에서 이 수치를 게시했습니다. 이는 벤치마크가 아닌 일화입니다. HN 베타 스레드는 대부분 비슷한 열광을 보입니다.
이 모든 것을 신뢰하기 전에 자신만의 p50 및 p95를 측정하십시오.
9월 14일 이후 얻고 잃는 것
전환 이후에는 "어떤 모델을 선택해야 할까"라는 질문이 사라집니다. deepseek-v4-pro는 별칭이 되므로, 정직한 관점은 손익 계산입니다.
얻는 것: 모든 제시된 벤치마크에서 더 높은 점수, 70~77% 더 낮은 피크 가격, 5배의 동시성, 별도의 비전 모델 ID 없이 네이티브 이미지 입력, 그리고 DeepSeek이 1에서 100까지 연속적으로 제어 가능하다고 설명하는 추론 노력(reasoning-effort) 다이얼.
잃는 것: V4-세대 체크포인트를 고정할 수 있는 능력. V4-Pro의 스타일, 장황함, 또는 도구 호출 형식에 맞춰 조정된 프롬프트는 변화할 수 있습니다. 출력 길이 및 추론 토큰(reasoning-token) 수가 변경될 수 있으며, 이는 요금표에는 나타나지 않는 방식으로 청구서에 영향을 미칩니다. 그리고 라우팅 변경은 사용자 일정이 아닌 DeepSeek의 일정에 따라 발생합니다.
두 번째 목록이 14일 이후가 아닌 그 전에 차이를 비교해야 하는 이유입니다.
전환 전에 Apidog에서 V4-Pro와 V4.1-Flash 비교
Apidog는 API 계층을 테스트하므로, 두 모델 ID에 동일한 프롬프트 세트를 실행하고 결과를 비교하기에 적합한 도구입니다.
- 엔드포인트 추가. 프로젝트를 생성하고
POST https://api.deepseek.com/chat/completions를 추가하거나 OpenAPI 사양을 가져옵니다. - 환경에 키와 모델 ID를 입력.
DEEPSEEK_API_KEY와MODEL변수를 저장합니다.MODEL=deepseek-v4-pro를 사용하는v4-pro환경과MODEL=deepseek-flash를 사용하는v41-flash환경 두 개를 생성하고, 헤더에Bearer {{DEEPSEEK_API_KEY}}, 본문에"model": "{{MODEL}}"로 참조합니다. - 실제 프롬프트를 요청으로 저장. 프로덕션 환경을 대표하는 20~30개의 프롬프트 (시스템 프롬프트, 도구 호출 턴, 긴 컨텍스트 요약, 다중 파일 코드 편집 등)를 선택합니다. 응답 본문에
usage객체가 포함되도록 각 프롬프트를stream: false로 저장합니다. - 청구서에 영향을 미치는 필드에 어설션 추가. 저장된 요청에서 테스트 시나리오를 구축하고
usage.prompt_tokens,usage.completion_tokens,usage.prompt_cache_hit_tokens에 어설션을 추가합니다. 단계별 응답 시간을 기록하고, 환경 이름을 헤더에 찍어 실행을 라벨링할 수 있도록 사전 요청 스크립트를 추가합니다. - 각 환경별로 한 번씩 실행 후 비교.
v4-pro환경에서 시나리오를 실행한 다음,v41-flash환경에서 실행합니다. 완성 토큰 수 (라우팅 변경이 출력 비용에 영향을 미침), 단계별 지연 시간, 그리고 형식 변경을 위해 내용 자체를 비교합니다. - 14일에 CI에서 재실행. 전환 시
apidog-cli를 사용하여 파이프라인에서 동일한 시나리오를 실행합니다. 라우팅 변경으로 인해 문제가 발생한 경우 지원 티켓 대신 실패한 어설션으로 나타납니다.
동일한 비교를 스크립트로 구현:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
피크 시간대와 비피크 시간대에 실행하고 출력을 보관하십시오. Apidog 다운로드를 통해 비교, 어설션, 실행 기록을 한 곳에서 관리할 수 있습니다.
자주 묻는 질문 (FAQ)
V4.1-Flash가 V4-Pro보다 코딩 성능이 좋은가요? DeepSeek이 보고한 수치에 따르면 그렇습니다: DeepSWE v1.1에서 74.2점 대 62.7점, Terminal-Bench 2.1에서 90.6점 대 87.9점입니다. 코딩 성능에서 V4 세대가 Claude와 어떻게 비교되는지는 DeepSeek V4 대 Claude Opus 코딩 비교를 참조하십시오.
9월 14일 이후 제 V4-Pro 통합은 어떻게 되나요? UTC 04:00부터 모든 deepseek-v4-pro 요청은 V4.1-Flash에 의해 서비스되고 Flash 요금으로 청구됩니다. 귀하의 코드는 계속 작동하지만, 그 뒤의 모델은 변경됩니다. 마이그레이션 가이드에 전체 체크리스트가 있습니다.
deepseek-v4-flash를 deepseek-flash로 이름을 바꿔야 하나요? 현재는 아닙니다. deepseek-v4-flash와 deepseek-v4-flash-vision-exp는 여전히 허용되며 V4.1-Flash에 의해 서비스됩니다. DeepSeek은 삭제 날짜를 명시하지 않았으므로, 다음 번에 설정을 변경할 때 deepseek-flash로 전환하십시오.
V4.1-Flash가 V4-Pro보다 빠른가요? DeepSeek은 그렇다고 말하지만, 구체적인 수치는 공개하지 않았습니다. 아키텍처는 이 주장을 뒷받침합니다: 프리필 시 80억 개의 활성 파라미터와 V4-Flash의 1/4 크기인 KV 캐시를 가집니다. 직접 측정해 보십시오.
다른 곳에서 V4-Pro를 계속 실행할 수 있나요? 14일 이후 DeepSeek API에서는 불가능합니다. V4 세대의 배경은 DeepSeek V4란 무엇인가에서 확인할 수 있으며, V4.1-Flash 가중치는 Hugging Face에 MIT 라이선스로 공개되어 있습니다.
간단히 말해서
V4.1-Flash는 더 작고, 더 저렴하며, 동시에 더 높은 점수를 기록합니다. 적어도 공급업체의 표에 따르면 그렇지만, 그 표는 사용자 프롬프트에 더 나은지 여부를 알려주지 못합니다. 이번 주에 Apidog에서 두 모델 ID 모두에 동일한 프롬프트 세트를 실행하고, 차이점을 기록하면 사용자보다 먼저 9월 14일에 무엇이 변경될지 알 수 있을 것입니다.