
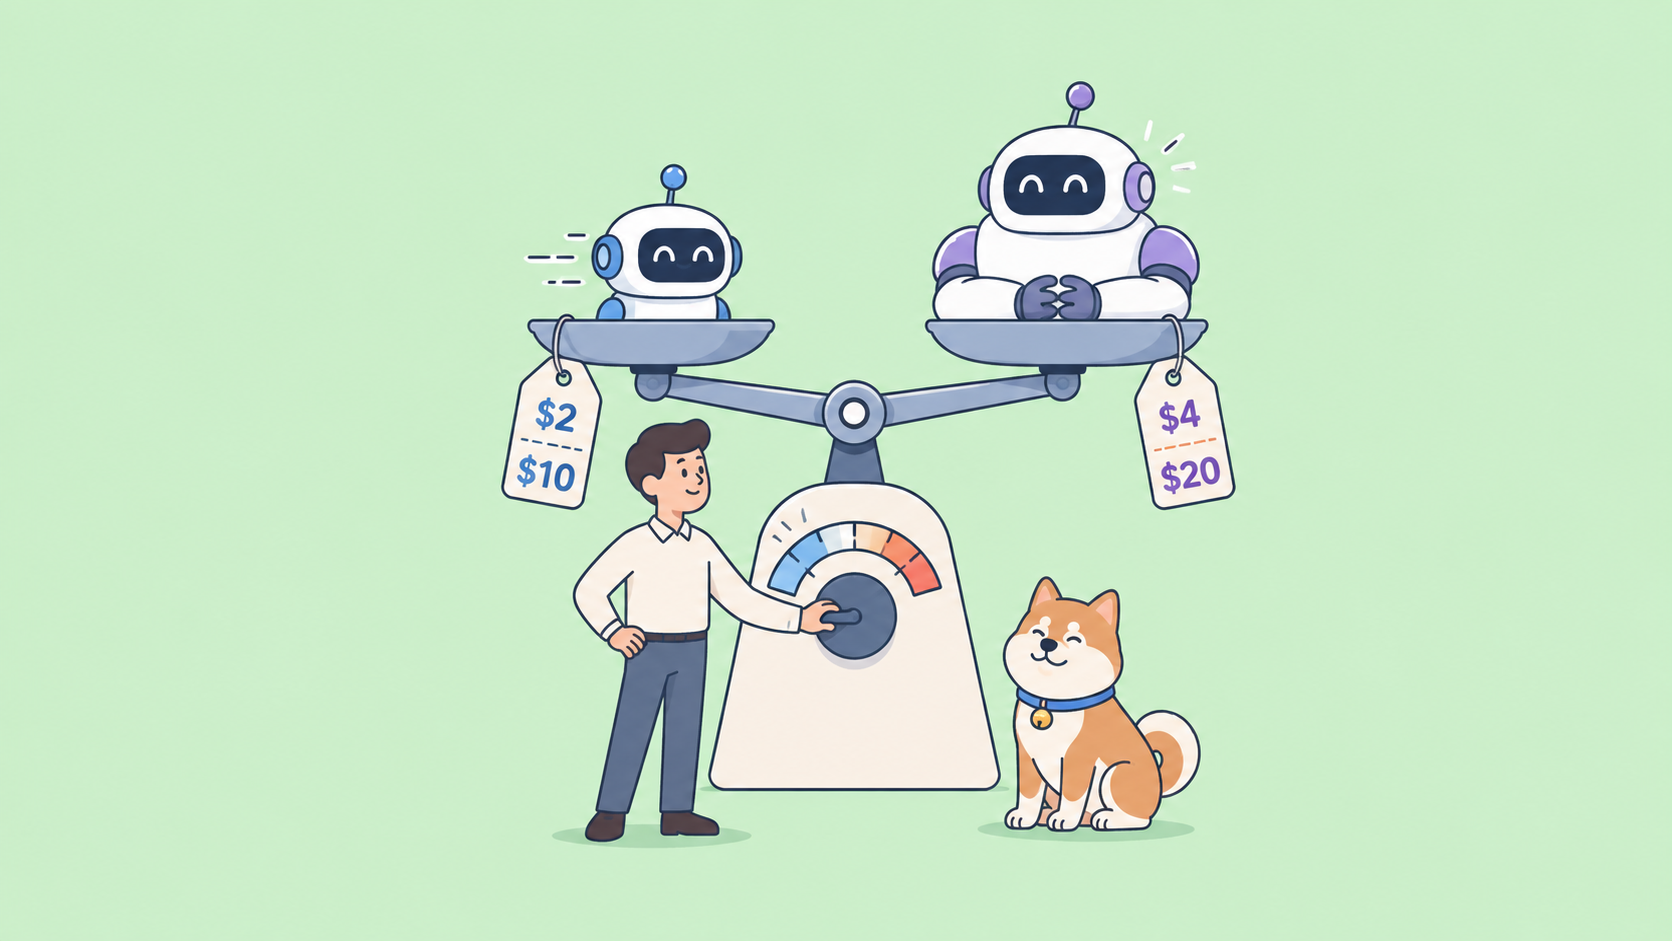
Claude Sonnet 5.5는 1백만 입력/출력 토큰당 $2/$10의 비용이 들며, 이는 Claude Opus 5.5의 $4/$20의 절반입니다. Anthropic의 출시 표에서 대부분의 항목에서 Opus 5.5와 몇 점 차이로 비슷하며, Terminal-Bench 4.0에서는 Opus 5.5를 능가합니다 (70.6% 대 66.4%). 하지만 Anthropic은 Opus 5.5가 "복잡하고 개방적인 작업에서 여전히 명확하게 더 강력하다"고 말합니다. 결론: 잘 정의된 대량 작업 및 서브 에이전트는 낮은 노력에서 높은 노력 수준으로 Sonnet 5.5에 할당하세요. 길고 개방적인 작업이나 Sonnet을 xhigh 또는 max로 밀어붙여야 하는 경우 Opus 5.5를 사용하세요. Opus가 중간 또는 높은 노력 수준에서 유사하거나 더 적은 비용으로 더 높은 점수를 얻는 경우가 많기 때문입니다.
각 모델에 대한 자세한 내용은 Claude Sonnet 5.5란 무엇인가 및 Claude Opus 5.5란 무엇인가를 참조하십시오. 마지막 섹션에서는 Apidog에서 자신만의 프롬프트로 두 모델을 테스트하는 방법을 보여줍니다.
사양 및 가격 비교
| Sonnet 5.5 | Opus 5.5 | |
|---|---|---|
| API 모델 ID | claude-sonnet-5-5 |
claude-opus-5-5 |
| 입력 / 출력 (1백만 토큰당) | $2 / $10 | $4 / $20 |
| 캐시 쓰기 (5분) | $2.50 | $5 |
| 캐시 읽기 | $0.20 | $0.20 |
| 빠른 모드 | 사용 불가 | $8 / $40 |
| API의 기본 노력 수준 | high |
medium |
| 사고 방식 | 기본적으로 적응형 또는 between_tools |
적응형, 항상 켜짐 |
| 컨텍스트 / 최대 출력 | 1M / 128K | 1M / 128K |
| 지연 시간 클래스 | 빠름 | 보통 |
가장 중요한 세 가지 항목은 다음과 같습니다:
- 캐시 읽기 비용은 동일하므로, 캐시 사용량이 많은 에이전트 루프에서는 주로 출력 및 캐시 쓰기에서 차이가 발생합니다. Claude Sonnet 5.5 가격 책정에서 계산을 확인할 수 있습니다. 두 모델 모두 긴 컨텍스트에 대한 추가 요금은 부과하지 않습니다.
- 기본 노력 수준이 다릅니다. 기본 설정 테스트에서는 Sonnet이
high로, Opus가medium으로 설정되며, 이 조합에서는 Opus가 우세한 경향이 있습니다. - 빠른 모드는 Opus 전용입니다 (문서). Anthropic은 Sonnet 5.5가 Sonnet 5보다 30% 이상 빠르게 출력을 생성한다고 말합니다.
벤치마크: 출시 표에서는 비슷하지만, 시스템 카드에서는 더 큰 차이
1번부터 8번까지의 항목은 Anthropic의 출시 표에서 가져왔으며; 나머지는 시스템 카드에서 가져왔습니다. Cognition은 FrontierCode를, Cursor는 CursorBench를, Zapier는 AutomationBench를, Artificial Analysis (AA)는 GDPval-AA와 AA-Briefcase를 실행했으며; Anthropic은 다른 항목들을 실행했습니다. Sonnet은 별도로 명시되지 않는 한 최대 노력 수준에서 테스트되었습니다.
| 벤치마크 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% (xhigh) |
| FrontierCode 1.1 Main | 46.2% max, 52.1% xhigh | 54.4% |
| CursorBench 4.0 | 55.5% | 57.8% |
| GDPval-AA v2.1 (Elo) | 1844 | 1846 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1822 |
| HLE, 도구 포함 | 64.5% | 67.7% |
| OSWorld 2.1, 부분 | 80.1% | 81.8% |
| Chartography, 도구 없음 | 61.6% | 64.4% |
| SWE-Bench Pro | 81.3 | 89.9 |
| SWE-Bench Multimodal | 54.3 | 61.4 |
| HLE, 도구 없음 | 56.9 | 64.4 |
| OSWorld 2.1, 엄격한 통과 | 43.5% | 48.7% |
| ProgramBench, 긴 컨텍스트 | 79.7% | 91.2% |
| Terminal-Bench-Science 0.1 | 59.9% | 58.7% |
| AutomationBench | 44.7 | 42.5 |
| HealthBench Professional | 69.2 | 65.6 |
출시 표는 유리한 부분만 보여줍니다: Terminal-Bench를 제외하고, Opus는 Sonnet의 xhigh FrontierCode 점수를 포함하여 다른 퍼센티지 항목에서 1.7점에서 3.2점 앞서 있습니다. 다섯 개의 시스템 카드 항목에서는 그 격차가 5.2점에서 11.5점으로 벌어집니다: SWE-Bench Pro, SWE-Bench Multimodal, 도구 없는 HLE, 엄격한 OSWorld, 긴 컨텍스트 ProgramBench. 길고, 보조 도구 없이 전체 작업을 수행하는 분야에서 Opus가 앞서 있습니다.
Terminal-Bench 4.0의 승리는 주의해서 해석해야 합니다: 시스템 카드 8.5 섹션에 따르면, Opus 테스트의 10%에서 안전 장치 폴백이 발생한 반면 Sonnet은 1.5%에 불과했으며, AA 자체 테스트에서는 Sonnet 5.5가 63.6%를 기록했습니다. 자세한 내용은 Claude Sonnet 5.5 벤치마크에서 확인할 수 있습니다.
노력 수준이 대결을 결정합니다
출시 표는 각 모델을 최적의 설정에서 비교합니다. 하지만 실제 청구서는 그렇지 않습니다. Anthropic의 출시 페이지에는 시도 또는 작업당 비용과 함께 모든 노력 수준이 표시되어 있습니다:
| 벤치마크, 모델 | 낮음 (Low) | 보통 (Medium) | 높음 (High) | 매우 높음 (Xhigh) | 최대 (Max) |
|---|---|---|---|---|---|
| Terminal-Bench, Sonnet | 20.0% ($0.76) | 28.8% ($0.83) | 43.0% ($1.94) | 61.5% ($5.30) | 70.6% ($12.54) |
| Terminal-Bench, Opus | 38.5% ($1.29) | 57.6% ($2.94) | 64.2% ($3.88) | 66.4% ($7.35) | 64.8% ($11.24) |
| CursorBench, Sonnet | 35.8% ($0.50) | 39.2% ($0.70) | 47.8% ($1.67) | 53.1% ($3.88) | 55.5% ($9.67) |
| CursorBench, Opus | 43.7% ($1.17) | 52.5% ($2.91) | 56.0% ($3.97) | 56.0% ($6.98) | 57.8% ($13.43) |
| FrontierCode, Sonnet | 29.3% ($0.19) | 36.5% ($0.24) | 49.4% ($0.42) | 52.1% ($1.59) | 46.2% ($20.78) |
| FrontierCode, Opus | 47.3% ($0.40) | 54.6% ($0.80) | 54.0% ($1.09) | 51.4% ($2.25) | 54.4% ($6.19) |
| AA-Briefcase, Sonnet | 1264 ($0.87) | 1461 ($1.64) | 1634 ($3.95) | 1746 ($9.63) | 1811 ($29.19) |
| AA-Briefcase, Opus | 1285 ($1.15) | 1642 ($4.40) | 1705 ($6.27) | 1780 ($12.27) | 1822 ($21.05) |
표가 보여주는 것은 다음과 같습니다:
- Opus는 중간 노력 수준에서 종종 Sonnet의 높은 노력 수준을 능가합니다. Terminal-Bench 4.0: Opus는 시도당 $2.94에 57.6%를 기록하며, Sonnet은 $1.94에 43.0%를 기록합니다.
- Opus는 최대치 미만에서 Sonnet의 최고 성능을 더 저렴하게 능가할 수 있습니다. CursorBench: 높은 노력 수준의 Opus (56.0%, $3.97) 대 최대 노력 수준의 Sonnet (55.5%, $9.67). FrontierCode: 중간 노력 수준의 Opus (54.6%, $0.80) 대 Sonnet의 최고 성능 (52.1%, $1.59).
- Sonnet은 최대 노력 수준에서 Opus의 최대 노력 수준보다 비용이 더 많이 들 수 있습니다: AA-Briefcase에서 $29.19 대 $21.05로, 더 낮은 점수를 기록합니다. Anthropic의 각주에 따르면 FrontierCode에서 Sonnet의 최대 점수가 xhigh 점수보다 낮았던 이유는 검토 서브 에이전트를 분산시켰기 때문입니다.
- Sonnet은 곡선의 가장 낮은 부분을 차지합니다. 낮은 설정에서 Sonnet은 모든 차트에서 Opus의 가장 저렴한 지점보다 비용이 적게 듭니다.
토큰 가격이 절반이라고 해서 작업당 비용도 절반인 것은 아닙니다. 노력 수준이 높아질수록 Sonnet은 더 많은 토큰을 소비합니다. OfficeChai가 보고한 AA 데이터에 따르면, Sonnet 5.5는 최대 노력 수준에서 인덱스 작업당 약 193,000개의 출력 토큰을 사용하여 Opus 5.5보다 약 60% 더 많습니다.
이것이 Hacker News 스레드의 주요 논쟁점입니다. 많은 댓글 작성자들이 차트를 보고 Opus가 더 낮은 노력 수준에서 Sonnet의 높은 또는 xhigh 노력 수준과 같거나 능가하며, Sonnet은 낮은 또는 중간 노력 수준과 Opus 오케스트레이터의 서브 에이전트로서의 틈새시장을 남겨둔다고 해석했습니다.
Anthropic의 프롬프트 가이드에 따르면 Sonnet 5.5의 노력 수준이 재조정되었습니다: high (잘 정의된 에이전트 코딩의 경우 medium)에서 시작하고, xhigh 및 max는 측정된 성능 향상을 위해 아껴두세요. 요청 간에 최상위 노력 수준을 변경하면 프롬프트 캐시가 무효화되므로, 워크로드별로 설정하세요 (API 가이드).
안전 및 행동 차이점
프롬프트 주입 결과는 나뉩니다. Gray Swan의 간접 프롬프트 주입 벤치마크에서 Sonnet 5.5의 공격 성공률은 15번 시도에서 3.4%입니다 (Sonnet 5: 6.7%): Opus 5.5보다 저항력이 낮지만, 테스트된 모든 비-Claude 모델보다는 높으며, GUI 컴퓨터 사용에서는 가장 취약합니다 (12.5%). Shade의 적응형 공격자에 대해 Sonnet은 코딩에서 Opus를 능가하며 (안전 장치 없을 때 3.01% 대 54.61%, 프로브 켜졌을 때 2.63% 대 11.13%), 컴퓨터 사용에서는 동률을 이룹니다 (0.07%); 브라우저 사용에서는 Anthropic이 평가한 모델 중 성공적인 공격이 없는 첫 번째 모델입니다. Opus 5.5 및 프롬프트 주입을 참조하십시오.
두 모델 모두 사이버 안전 장치를 갖추고 있으며; Sonnet 5.5는 이를 탑재한 첫 번째 Sonnet 모델입니다. 위험도가 높은 것으로 분류된 사이버 작업은 Sonnet 5로 폴백되며, Anthropic 앱에서는 자동으로, API에서는 옵트인하는 경우에만 가능합니다 (`fallbacks: "default"`, 베타). 시스템 카드에서는 양성 보안 작업에서도 거부율이 더 높을 수 있다고 경고합니다.
시스템 카드는 또한 Sonnet 5.5가 압박 상황에서 Opus 5.5보다 더 정직하지만, 환각 현상에는 더 취약하다고 분석합니다.
단일 시스템에서 Sonnet 5.5와 Opus 5.5 혼합 사용
두 모델을 모두 활용하는 한 가지 방법: Opus가 계획하고, Sonnet이 실행합니다. 세 가지 중요한 메커니즘이 있습니다.
- 사고 블록은 교차되지 않습니다. Sonnet 5.5는 Opus 5 및 Opus 5.5 사고 블록을 삭제하며 (청구되지 않음; 요청은 여전히 200을 반환함), 블록은 모델, 대화 및 계정에 바인딩됩니다. 대화 도중에 모델을 전환하면 추론이 사라지므로, 텍스트를 통해 인계해야 합니다: Opus가 계획을 메시지로 작성하고, Sonnet이 그 계획에서 시작합니다 (마이그레이션 가이드).
- 어드바이저 도구는 Opus 5.5를 Sonnet 5.5 실행자의 어드바이저로 허용합니다; 조언은 `advisor_redacted_result`로 암호화되어 반환됩니다.
- Claude Code는 `opusplan`을 가지고 있습니다: Opus는 계획 모드에서, Sonnet은 실행을 위해 사용됩니다. `sonnet` 별칭은 Anthropic API (v2.1.284 이상)에서만 Sonnet 5.5를 의미하며, 따라서 Bedrock, Google Cloud 및 Foundry에서는 `opusplan`이 이전 Sonnet에서 실행됩니다. Claude Code의 Claude Sonnet 5.5를 참조하십시오.
GPT-6 Sol의 위치
GPT-6 Sol은 Sonnet 5.5와 동일하게 1백만 입력/출력 토큰당 $2/$10의 정가를 공유하며, 캐시 읽기는 $0.20 (90% 할인)이고 872k 컨텍스트 창을 제공합니다. Anthropic의 표에서는 Sol에 네 가지 항목을 부여합니다: FrontierCode 49.3%, GDPval-AA 1487, AA-Briefcase 1483, 그리고 도구 없는 Chartography 53.6%. 각주에 따르면 OpenAI는 최근 Sol의 이미지 이해 버그를 수정했으며, AA 및 Surge AI 점수에는 아직 반영되지 않았을 수 있습니다.
벤치마크에 따라 작업당 비용이 달라집니다. AA-Briefcase에서 최대 노력 수준일 때, Sol은 작업당 $2.67인 반면 Sonnet은 $29.19이며, 점수는 1483대 1811입니다. FrontierCode에서 Sonnet의 높은 노력 수준은 Sol의 최고 성능 (49.4% 대 49.3%)과 일치하며, 비용은 $2.07에 대해 $0.42입니다. GPT-6 Sol 대 Claude Opus 5.5 및 GPT-6 Sol이란 무엇인가를 참조하십시오.
어떤 워크로드에 어떤 모델을 사용할까
| 워크로드 | 모델 및 노력 수준 |
|---|---|
| 대량 채팅, 분류, 추출 | Sonnet 5.5, 낮음 또는 보통 |
| 범위가 명확한 버그 수정, PR 규모의 변경 사항 | Sonnet 5.5, 보통 또는 높음 |
| Opus 계획을 실행하는 서브 에이전트 | Sonnet 5.5, 보통 또는 높음 |
| 길고 개방적인 에이전트 작업 | Opus 5.5, 보통 다음 높음 |
Sonnet을 xhigh 또는 max로 사용해야 하는 모든 것 |
Opus 5.5, 보통 또는 높음 |
| 긴 컨텍스트 코드베이스 추론 | Opus 5.5, 보통 또는 그 이상 |
| 신뢰할 수 없는 콘텐츠를 읽는 에이전트 | 둘 중 하나; 자신만의 주입 사례를 테스트하세요 |
자신만의 트래픽으로 두 모델 모두 테스트하기
위 모든 차트는 다른 사람의 테스트 환경에서 나온 것이며, 사용자 본인의 프롬프트, 도구 또는 토큰 조합에 기반한 것이 아닙니다. 데이터에서 강조하는 조합으로 시작하세요:
ask() {
  curl -s https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d '{"model":"'"$1"'","max_tokens":16000,
         "output_config":{"effort":"'"$2"'"},
         "messages":[{"role":"user","content":"Review this diff and list each bug as JSON: ..."}]}' \
  | jq '{model, stop_reason, usage}'
}
ask claude-sonnet-5-5 high
ask claude-opus-5-5 medium
Apidog에서 반복 가능하도록 만드세요: `https://api.anthropic.com/v1/messages`로 하나의 요청을 보내고, `ANTHROPIC_API_KEY`를 환경 변수로 설정하고, 요청 본문에 `{{model}}`과 `{{effort}}`를 사용하세요. 각 조합별로 복제하고 모든 실행이 동일한 내용을 확인하도록 후처리기를 추가하세요:
const body = pm.response.json();
pm.test("finished cleanly", () => {
  pm.expect(body.stop_reason).to.not.be.oneOf(["max_tokens", "refusal"]);
});
pm.test("stays inside the token budget", () => {
  pm.expect(body.usage.output_tokens).to.be.below(8000);
});
각 조합을 10~20회 실행하여 `usage`, 응답 시간 및 합격률을 비교하세요; 토큰 수에 정가를 곱한 것이 작업당 실제 비용입니다. LLM 애플리케이션 테스트 방법에 대해 더 자세히 알아보세요.
자주 묻는 질문 (FAQ)
- Claude Sonnet 5.5가 Opus 5.5보다 낫습니까? 대부분의 항목에서는 그렇지 않습니다. Opus 5.5는 Terminal-Bench 4.0과 GDPval-AA의 거의 동점인 경우를 제외하고 출시 표에서 우세합니다. 이전 세대의 대결: Claude Opus 5 vs Sonnet 5.
- Sonnet 5.5가 Opus 5.5 비용의 절반입니까? 토큰당으로는 그렇습니다. 작업당으로는 노력 수준에 따라 다릅니다: 최대 노력 수준에서는 Sonnet이 AA-Briefcase에서 더 많은 비용이 들었습니다 ($29.19 대 $21.05).
- 대화 도중에 모델을 전환할 수 있습니까? 네, 하지만 Sonnet 5.5는 Opus 5.5의 사고 블록을 삭제하므로 상태를 텍스트로 전달해야 합니다.
- Sonnet 5.5 또는 GPT-6 Sol (1백만 입력/출력 토큰당 $2/$10)? Sonnet은 최적의 설정에서 공유된 네 가지 항목 모두에서 우세합니다; Sol은 작업당 훨씬 저렴할 수 있습니다. 둘 다 테스트해 보세요.
다음 단계
가장 비용이 많이 드는 두 가지 프롬프트를 Sonnet 5.5의 `높음` 노력 수준과 Opus 5.5의 `보통` 노력 수준으로 실행하고, 라우팅 규칙을 변경하기 전에 합격률과 작업당 비용을 비교하십시오. 요청, 검증 및 결과를 하나의 프로젝트에 보관하려면 Apidog를 다운로드하십시오.