
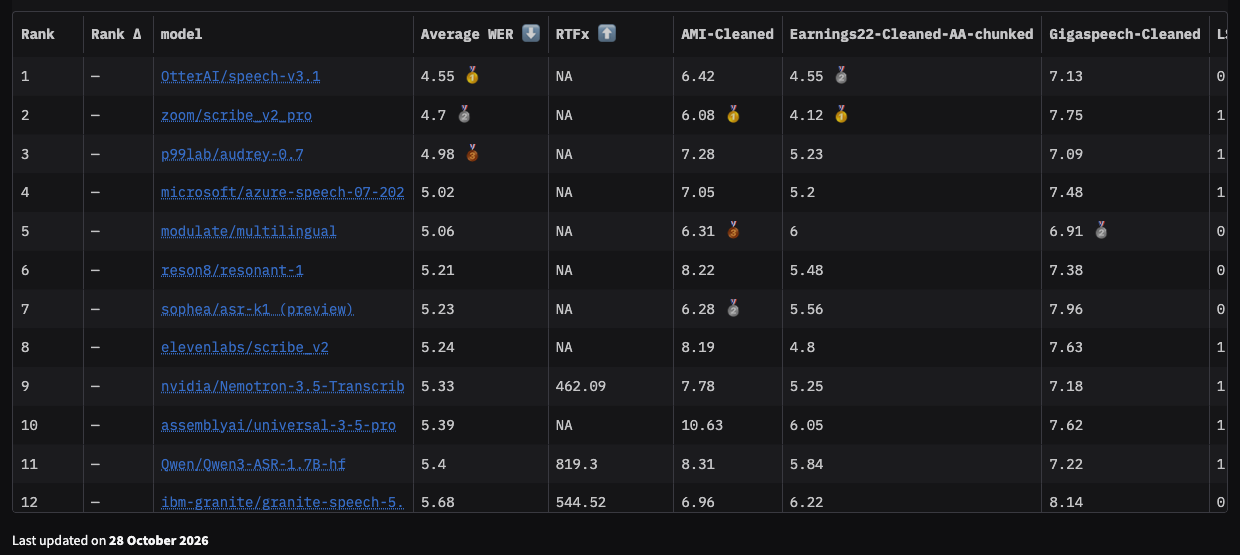
2026년 10월 최고의 오픈소스 음성-텍스트 변환 모델은 10월 28일에 공개된 NVIDIA의 Nemotron 3.5 Transcribe입니다. 같은 날 업데이트된 Hugging Face Open ASR Leaderboard에서 평균 5.33%의 단어 오류율을 기록하며 61개 모델 중 9위를 차지했습니다. 그보다 위에 있는 여덟 개 모델은 모두 폐쇄형 상용 API입니다. 여전히 많은 튜토리얼에서 기본값으로 쓰이는 OpenAI의 whisper-large-v3는 7.16%로 41위에 머물러 있습니다.
아래에는 지금 고려할 만한 아홉 개의 오픈 가중치 음성 인식 모델을 해당 리더보드 순위에 따라 정리했으며, 각 모델의 속도, 강점, 그리고 적합한 용도를 함께 제시합니다. 모든 WER과 속도 수치는 2026년 10월 29일에 확인한 리더보드에서 가져온 것입니다.
대신 호스팅 API 중에서 선택하려면 Nemotron 3.5 Transcribe API 가이드와 Whisper API 가이드를 읽어보세요.
순위를 매긴 방법
Open ASR Leaderboard는 모든 모델을 동일한 영어 테스트 세트에서 실행합니다: 회의(AMI), 실적 발표 통화(Earnings22), 팟캐스트 및 YouTube(GigaSpeech), 오디오북(LibriSpeech), 금융 통화(SPGISpeech), 잡음이 있는 음성(URGENT24), 대화 음성(Voice Arena Monsoon), 의회 연설(VoxPopuli), 그리고 두 개의 비공개 세트입니다. 순위 기준은 평균 WER이며, 낮을수록 좋습니다.
또한 리더보드의 속도 지표인 RTFx도 함께 표기합니다. 이는 연산 1초당 변환한 오디오의 초 수를 의미합니다. 높을수록 빠릅니다. 폐쇄형 API는 동일한 하드웨어에서 시간을 측정할 수 없기 때문에 “NA”로 표시됩니다.
체크포인트를 다운로드할 수 있고 리더보드에서 해당 모델의 RTFx를 보고하는 경우 오픈 가중치 모델로 간주했습니다. 상업적 사용 전에 각 라이선스를 확인하세요.
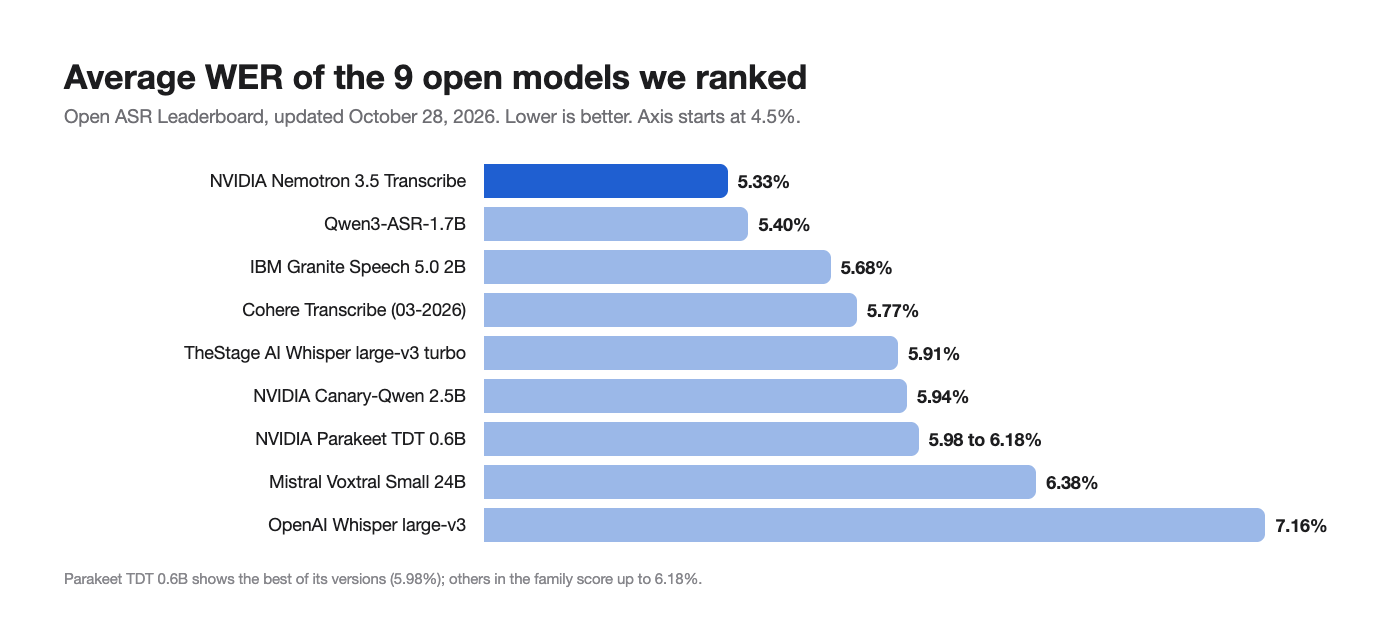
한눈에 보는 순위
| 순위(오픈) | 모델 | 평균 WER | RTFx | 전체 순위 |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5.33% | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5.40% | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5.68% | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5.77% | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5.91% | 1,177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5.94% | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B (여러 버전) | 5.98% ~ 6.18% | 비교 안 됨 | 24 ~ 31 |
| 8 | Mistral Voxtral Small 24B | 6.38% | 비교 안 됨 | 35 |
| 9 | OpenAI Whisper large-v3 | 7.16% | 비교 안 됨 | 41 |
참고로, 같은 리더보드에서 최고 성능을 낸 폐쇄형 API는 Otter speech-v3.1이 4.55%, Zoom Scribe v2 Pro가 4.70%, ElevenLabs Scribe v2가 5.24%, AssemblyAI Universal-3.5 Pro가 5.39%, OpenAI gpt-transcribe가 5.96%입니다. Nemotron 3.5 Transcribe는 무료로 다운로드할 수 있으면서도 AssemblyAI와 OpenAI의 호스팅 모델을 앞섭니다.
1. NVIDIA Nemotron 3.5 Transcribe: 전체 최고
5.33% WER, RTFx 462, OpenMDW-1.1 라이선스
NVIDIA의 새 모델은 전형적인 ASR 네트워크가 아닙니다. 음성으로 보강된 언어 모델로, 600M 파라미터의 ASR 인코더와 화자 인코더가 총 34B, 활성 파라미터 약 4.3B 규모의 Mamba-2와 Transformer 하이브리드 전문가 혼합(mixture-of-experts) LLM에 입력을 전달합니다. 이런 설계 덕분에 단순한 변환 이상의 일을 할 수 있습니다.
1위인 이유:
- 40개 언어 지원, 그중 13개는 “leading” 등급
- 65,536 토큰 컨텍스트로 1시간 분량 파일을 한 번에 처리
- 하나의 모델에서 화자 귀속(최대 8명)과 단어 타임스탬프 제공
- 프롬프트: 축어적 또는 정제된 문구, 전문 용어용 컨텍스트 용어, 번역
- 장문 정확도: 리더보드의 장문 세트에서 평균 WER 10.98%로, 모델 카드에 따르면 Parakeet-TDT-0.6B-v3의 13.37%보다 우수합니다
- 회의: 다중 화자 세트에서 평균 cpWER 15.80%로, DiCoW + DiariZen 파이프라인의 16.83%를 앞섭니다
단점: 큰 GPU가 필요하고(BF16 기준 H100 80GB 한 장, 또는 NVFP4 가중치를 사용하는 RTX 5090), 스트리밍을 지원하지 않으며, 오디오 질의응답은 영어만 지원합니다.
이런 경우에 선택하세요: 회의, 팟캐스트, 실적 발표 통화, 다국어 아카이브, 그리고 화자 라벨이나 1시간 파일이 중요한 모든 작업. 무료 방법으로 시작하거나 로컬에서 실행해 보세요.
2. Qwen3-ASR-1.7B: GPU 비용 대비 최고 정확도
5.40% WER, RTFx 819
Alibaba의 Qwen3-ASR-1.7B는 영어 평균에서 Nemotron보다 0.07포인트 뒤처질 뿐이면서, 리더보드 하드웨어에서 약 1.8배 빠르게 실행되며 전체 크기는 20분의 1에 불과합니다. NVIDIA 자체의 7개 언어 다국어 비교에서는 Nemotron이 4.62% 대 6.49%의 평균 WER로 더 확실히 앞섭니다.
이런 경우에 선택하세요: 내장 화자 귀속이 필요 없고, 더 작은 GPU에서 영어 위주의 배치 변환을 할 때. 이미 Qwen의 멀티모달 모델을 사용 중이라면 Qwen3.5-Omni 가이드를 참고하세요.
3. IBM Granite Speech 5.0 2B: 동급 크기 중 회의 오디오에서 최고
5.68% WER, RTFx 545
IBM의 Granite Speech 5.0은 AMI 회의 녹음에서 6.96%의 WER을 기록했는데, 이는 여기 소개된 상위 6개 오픈 모델 중 최고 AMI 점수이며 해당 세트에서 Nemotron의 7.78%보다 우수합니다. 약점은 SPGISpeech 금융 통화로 3.36%입니다.
이런 경우에 선택하세요: IBM Granite 스택으로 표준화하는 엔터프라이즈 팀, 그리고 중급 GPU에서의 회의 변환.
4. Cohere Transcribe: 빠르고 정확함
5.77% WER, RTFx 902
Cohere Labs의 2026년 3월 변환 모델은 오픈 모델 중 상위 5위권 정확도와 이 목록에서 가장 빠른 속도 중 하나를 결합했습니다. LibriSpeech에서 가장 강하고(clean 0.97%, other 2.05%), VoxPopuli에서는 5.38%로 다소 약합니다.
이런 경우에 선택하세요: 처리량이 정확도만큼 중요한 대용량 영어 파이프라인.
5. TheStage AI Whisper large-v3 turbo: 최상위권 중 가장 빠름
5.91% WER, RTFx 1,177
이것은 TheStage AI가 최적화한 Whisper large-v3 turbo 빌드로, 이 목록에서 가장 빠른 모델입니다. SPGISpeech에서 1.62%를 기록해 61개 모델 전체를 통틀어 해당 세트에서 세 번째로 좋은 점수입니다. 누군가 튜닝만 하면 Whisper 제품군이 얼마나 여전히 건재한지 보여줍니다.
이런 경우에 선택하세요: 기존 Whisper 코드를 보유하고 있으며 별도 수정 없이 속도와 정확도를 업그레이드하고 싶은 팀.
6. NVIDIA Canary-Qwen 2.5B: 이전 NVIDIA 플래그십
5.94% WER, RTFx 862
Canary-Qwen은 NVIDIA의 이전 음성+LLM 모델이며, Nemotron 3.5 Transcribe가 정상 자리를 대체했습니다. 여전히 빠르고 SPGISpeech 1.70%라는 뛰어난 점수를 냅니다. NVIDIA의 preference-ASR 테스트에서 Nemotron은 7.56%로 Canary-Qwen의 8.16%보다 우수합니다.
이런 경우에 선택하세요: 아직 80GB GPU로 옮기지 못하는 기존 NeMo 배포 환경.
7. NVIDIA Parakeet TDT 0.6B: 가장 작은 실용적 선택지
버전별 WER 5.98% ~ 6.18%
Parakeet TDT는 리더보드에 여러 0.6B 파라미터 버전이 있으며, 모두 서로 약 0.2포인트 이내에 있습니다. 600M 파라미터로, WER 6% 근처를 유지하는 이 목록에서 가장 작은 모델이라 보급형 GPU에서도 실행됩니다. 약점은 장문 오디오로, 여기서는 Nemotron이 2포인트 이상 앞섭니다.
이런 경우에 선택하세요: 엣지 기기, 저렴한 GPU, 그리고 음성 명령이나 통화 일부 같은 짧은 클립.
8. Mistral Voxtral Small 24B: 음성과 강력한 LLM의 결합
6.38% WER
Voxtral Small은 음성 입력을 24B Mistral 언어 모델과 결합하므로, Nemotron처럼 단순 변환뿐 아니라 오디오에 대한 질문에도 답할 수 있습니다. 순수 WER에서는 상위 5개 모델에 뒤처집니다. Voxtral vs. Whisper 비교 분석에서 이전 릴리스를 자세히 다룹니다.
이런 경우에 선택하세요: 마지막 1%p의 WER보다 언어 모델이 더 중요한 음성 비서와 오디오 Q&A.
9. OpenAI Whisper large-v3: 기준선
7.16% WER, 전체 41위
Whisper large-v3는 여전히 가장 널리 배포된 오픈 모델로, 래퍼, 파인튜닝, 튜토리얼 생태계가 가장 큽니다. 정확도 면에서는 이제 이 목록의 다른 모든 모델에 뒤처집니다. 프로덕션에서 사용 중이라면 상위 6개 중 아무 모델로 바꾸는 것이 가장 저렴한 품질 업그레이드입니다.
이런 경우에 선택하세요: Whisper 전용 도구에 의존하는 프로토타입, 또는 넘어서야 할 기준선.
어떤 모델을 선택해야 할까요?
| 작업 | 선택 |
|---|---|
| 여러 화자가 있는 회의 | Nemotron 3.5 Transcribe |
| 1시간 팟캐스트 또는 통화를 한 번에 처리 | Nemotron 3.5 Transcribe |
| 다국어 아카이브 | Nemotron 3.5 Transcribe |
| 더 작은 GPU에서의 영어 배치 작업 | Qwen3-ASR-1.7B |
| 최대 처리량 | TheStage Whisper large-v3 turbo 또는 Cohere Transcribe |
| 엣지 또는 저비용 하드웨어 | Parakeet TDT 0.6B |
| 오디오 Q&A와 변환 | Nemotron 3.5 Transcribe 또는 Voxtral Small |
| 기존 Whisper 코드, 최소 변경 | TheStage Whisper large-v3 turbo |
한 가지 주의: 리더보드 평균은 도메인 격차를 가립니다. Nemotron이 전체적으로 최고지만 AMI에서는 Granite가 앞서고 LibriSpeech에서는 여러 모델이 앞섭니다. 확정하기 전에 상위 2~3개 모델을 자신의 녹음 50~100개로 테스트하세요.
코딩 에이전트와 Apidog CLI로 후보 모델 벤치마크하기
그 비교 평가를 가장 빠르게 진행하는 방법은 코딩 에이전트에게 맡기는 것입니다. OpenAI 스타일의 /v1/audio/transcriptions 엔드포인트 뒤에 두세 개 모델을 서빙하고(SGLang-Omni가 Nemotron을 이렇게 서빙합니다), 그다음 에이전트가 Apidog CLI로 각 모델에 대해 동일한 검사를 작성하고 실행하도록 하세요.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그다음 에이전트에게 프롬프트 하나를 주세요:
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
에이전트는 스키마를 읽고, 페이로드를 검증하고, 케이스를 작성한 뒤 환경별로 실행합니다:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
저장된 변환 결과를 아무 WER 스크립트로나 참조 텍스트와 비교해 점수를 매기고, -r junit으로 승리한 환경의 실행을 CI에 유지하세요. Claude Code에서의 Apidog CLI와 CI/CD 파이프라인에서의 Apidog CLI를 참고하세요.
자주 묻는 질문
가장 정확한 오픈소스 음성-텍스트 변환 모델은 무엇인가요? 2026년 10월 28일 Open ASR Leaderboard 기준 평균 WER 5.33%의 NVIDIA Nemotron 3.5 Transcribe입니다.
Whisper는 여전히 쓸 만한가요? 작동은 하지만 whisper-large-v3는 7.16%로 41위입니다. TheStage의 large-v3 turbo처럼 튜닝된 Whisper 빌드는 5.91%를 기록합니다.
어떤 오픈 모델이 가장 빠른가요? 여기 소개된 모델 중에서는 TheStage AI의 Whisper large-v3 turbo로, RTFx는 1,177입니다.
이제 오픈 모델이 유료 API를 앞서나요? 일부는 그렇습니다. Nemotron 3.5 Transcribe는 AssemblyAI Universal-3.5 Pro(5.39%)와 OpenAI gpt-transcribe(5.96%)를 앞섭니다. Otter, Zoom, ElevenLabs는 여전히 전체적으로 앞서 있습니다. 호스팅 옵션은 음성-텍스트 API 모음에서 확인하세요.
화자 분리를 지원하는 모델은? Nemotron 3.5 Transcribe는 동일 모델에서 최대 8명까지 화자 분리를 수행합니다. 대부분의 다른 모델은 별도의 화자 분리 단계가 필요합니다.
결론
2026년 말 대부분의 팀에게는 80GB GPU가 있거나 호스팅 API에 시간당 $0.12를 지불할 수 있다면 Nemotron 3.5 Transcribe로 시작하는 것이 좋습니다. GPU 예산이 빠듯하면 Qwen3-ASR-1.7B를, 하드웨어가 더 제한적이라면 Parakeet을 선택하세요. 무엇을 선택하든 자신의 오디오로 테스트하고, 에이전트가 Apidog 검사를 계속 실행하도록 해서 선택한 모델이 모든 업그레이드 후에도 계속 성능을 내도록 하세요.