핵심 요약: AI 에이전트를 위한 비동기 툴 호출은 단일 블로킹 run()을 간결한 규약(contract)으로 분리합니다. 즉, start()는 즉시 작업 핸들을 반환하고, status()는 진행 상황을 보고하며, stop()은 작업을 취소하고, 결과는 추후 에이전트가 다음 턴에 읽을 수 있는 이벤트로 전달됩니다. 덕분에 시간이 오래 걸리는 작업이 백그라운드에서 실행되는 동안에도 에이전트는 사용자와 계속 대화하며 새로운 지시를 처리할 수 있습니다.
오늘날 대부분의 에이전트는 툴을 호출한 뒤 응답이 올 때까지 마냥 대기합니다. 6분짜리 테스트가 실행되는 도중에 두 번째 질문을 던지면 그 질문은 큐에 갇히게 됩니다. 200ms짜리 조회 작업이라면 괜찮겠지만, 배포나 웹 크롤링처럼 오래 걸리는 작업에서는 치명적입니다.
DeepSeek Harness 팀이 최근 발표한 글 “Exploring Super-agent Design”에서는 이 문제의 해결책으로 블로킹 방식의 run()을 start()와 stop()으로 대체하는 '전이중(full-duplex)' 방식을 제시합니다. 이 가이드에서는 에이전트 루프의 관점에서 툴 규약, 결과 수신 방식, 작업 취소, 그리고 각 툴에 필요한 API 설계를 다룹니다. 단일 장기 실행 호출의 HTTP 처리 방식이 궁금하다면 AI 에이전트와 장기 실행 API 호출: 폴링 vs 웹훅을 참고하시기 바랍니다.
에이전트 루프에서 비동기 툴 호출이란 무엇인가?
비동기 툴 호출은 결과 대신 핸들을 반환하는 툴 실행 방식입니다. 에이전트 루프는 핸들을 기록하고 즉시 해당 턴을 종료하여 사용자의 추가 요청을 받을 수 있는 상태를 유지합니다. 작업이 완료되면 런타임이 대화 컨텍스트에 완료 이벤트를 주입하고, 모델은 다음 턴에서 다른 메시지와 마찬가지로 이를 확인합니다.
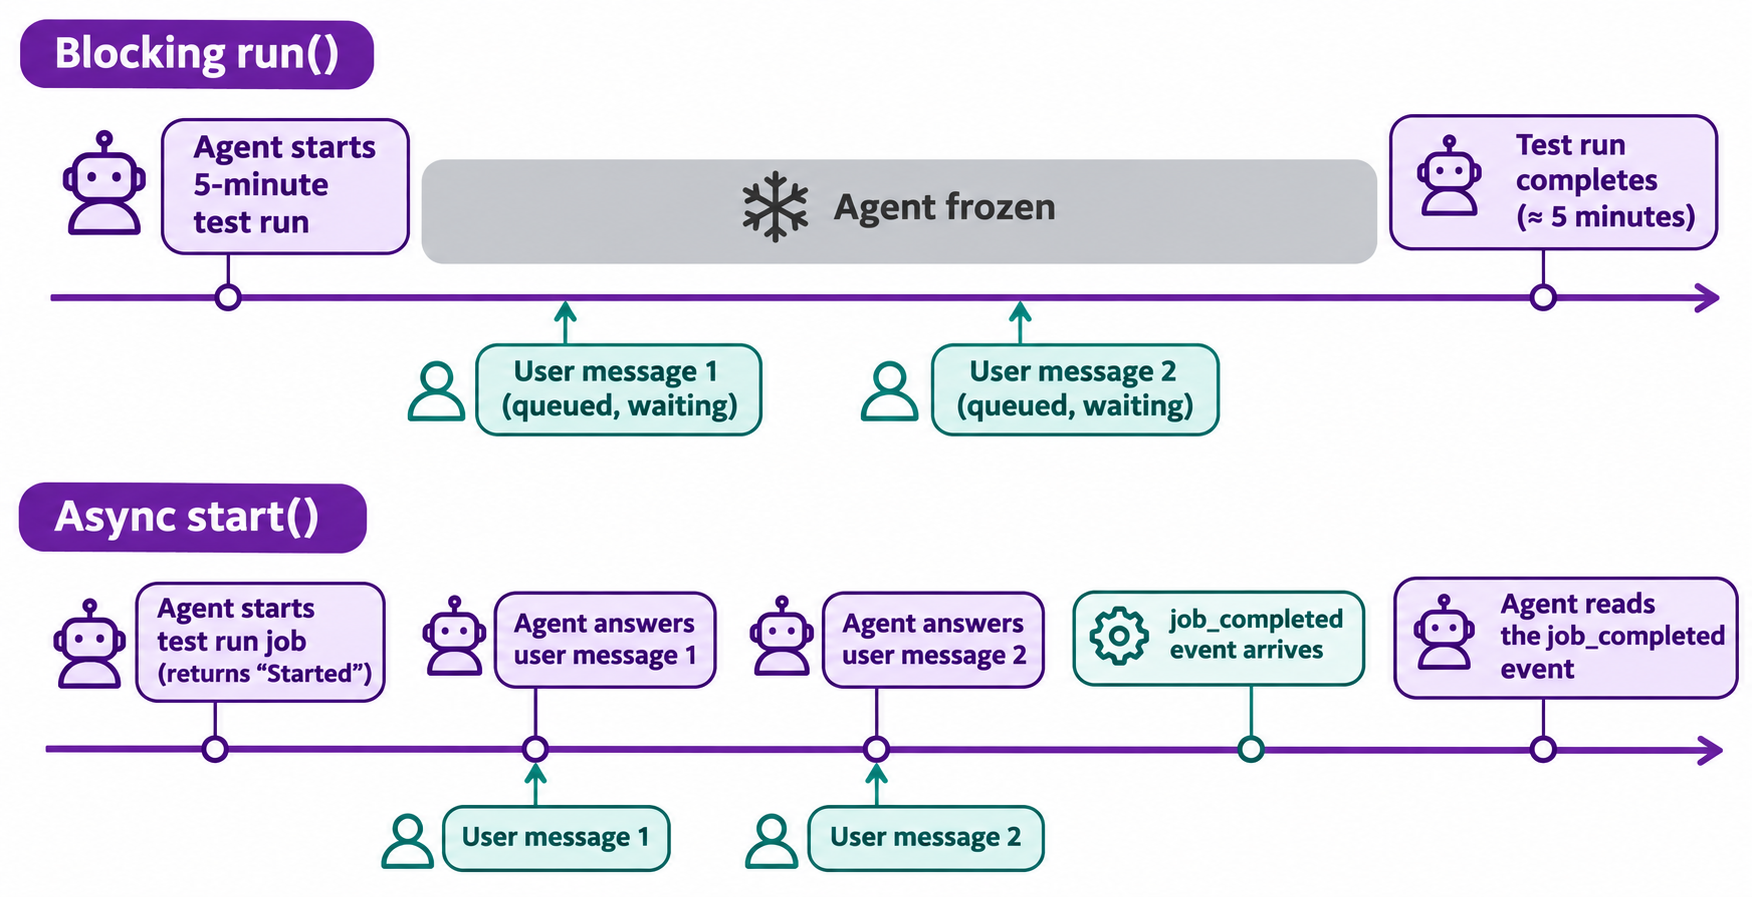
그 차이는 '누가 기다리는가'에 있습니다. run()에서는 모델이 기다리지만, start()에서는 런타임이 기다립니다.
블로킹 방식 run() |
비동기 방식 start() |
|
|---|---|---|
| 반환값 | 최종 결과 | Job id, “Started” |
| 작업 중 에이전트 상태 | 동작 중단(Frozen) | 대화, 계획 수립, 추가 작업 실행 가능 |
| 새 사용자 메시지 | 툴 반환 시까지 대기 큐에 보관 | 즉시 처리 |
| 작업 취소 | 전체 턴 강제 종료 | stop(job_id) |
DeepSeek의 글에서는 이를 상용 기능의 옵션이 아닌 하나의 아키텍처로 설명합니다. 전이중 방식은 DeepSeek Harness에 구현되어 있으나 기본적으로 활성화되어 있지 않으며, 일부 기능은 공식 DeepSeek 제품이 아닌 dsh-superagent-prototype이라는 프로토타입 플러그인에 포함되어 있다고 설명합니다. 따라서 완성된 제품이라기보다는 참고할 만한 참조 설계로 접근하는 것이 좋습니다. 관련 배경지식은 DeepSeek Harness란 무엇인가와 후속 글인 슈퍼 에이전트 구축 방법을 확인해 보세요.
블로킹의 문제점: 느린 툴 하나가 에이전트 전체를 멈추게 만든다
코딩 에이전트에게 전체 테스트 스위트 실행(5분 소요)과 특정 import 오류에 대한 질문을 동시에 요청한 상황을 떠올려 보십시오. 블로킹 방식을 사용할 경우, 질문이 테스트 결과와 아무런 관련이 없음에도 불구하고 테스트가 끝날 때까지 기다려야 합니다. 이때 세 가지 문제가 발생합니다.
- 지연 시간의 누적: 느린 툴이 실행되는 시간만큼 그 뒤에 대기 중인 모든 작업의 지연 시간이 그대로 늘어납니다.
- 명령의 유효성 상실: 실행 2분 뒤에 "E2E 테스트는 건너뛰어 줘"라고 말해도, 에이전트는 테스트가 완전히 끝날 때까지 이를 인식하지 못합니다.
- 타임아웃 발생: 게이트웨이는 몇 분 동안 열려 있는 유휴 연결을 강제로 끊어버리므로, 실제 작업이 성공하더라도 긴
run()호출 자체가 실패할 수 있습니다.
해당 글에서는 우리가 지향해야 할 특성으로 '생산성(productive)'을 꼽습니다. 즉, 이전 작업이 끝나기 전에 다음 지시를 받아 처리할 수 있는 역량입니다. 비동기 툴을 사용하면 바로 이러한 동작이 가능해집니다.
start, status, stop: 비동기 툴 규약
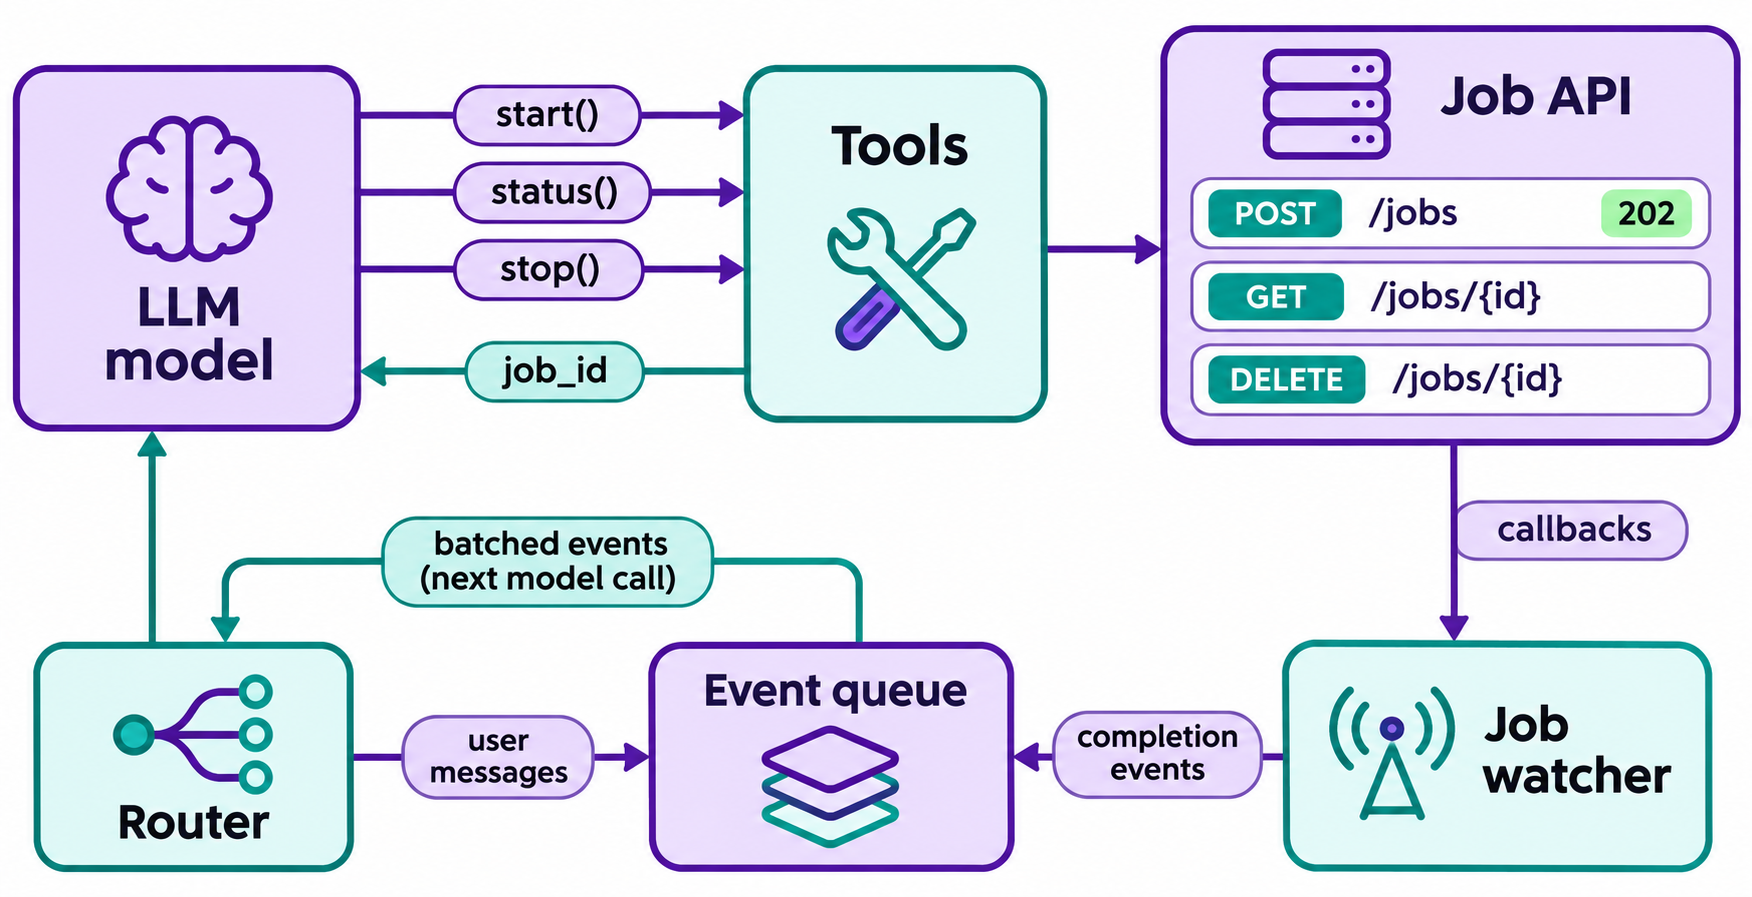
장기 실행 기능 하나당 단일 툴 대신 반환값이 매우 단순한 세 가지 툴을 모델에 제공합니다.
{
  "name": "start_test_run",
  "description": "Start the test suite. Returns immediately with a job_id. The result arrives later as a job_completed event; do not wait for it.",
  "input_schema": {
    "type": "object",
    "properties": {
      "suite": { "type": "string", "enum": ["unit", "e2e", "all"] },
      "idempotency_key": { "type": "string" }
    },
    "required": ["suite", "idempotency_key"]
  }
}
start_test_run은 {"job_id": "job_8f2", "status": "queued"}만을 반환합니다. get_job_status(job_id)는 queued, running, done, failed 중 하나의 상태와 함께 간단한 진행 상황 메모를 반환합니다. stop_job(job_id)는 취소를 요청하고 도달한 상태를 반환합니다.
모델이 올바르게 동작하도록 하려면 두 가지 규칙을 지켜야 합니다. 첫째, 설명(description)에 "대기하지 말 것(do not wait)"을 명시해야 합니다. 그렇지 않으면 모델이 get_job_status를 빽빽한 루프로 반복 폴링하게 됩니다. 둘째, start에서 데이터를 절대 반환하지 마십시오. 그렇지 않으면 모델은 어떤 데이터 구조가 반환되었는지 추측해야 합니다.
결과를 에이전트 루프로 다시 전달하는 방법
모델이 직접 폴링하는 것은 차선책일 뿐 이상적인 설계가 아닙니다. 더 나은 방식은 런타임이 작업을 모니터링하다가 작업 완료 이벤트를 새 메시지 형태로 대화에 밀어 넣어주는(push) 것입니다.
[event] job_completed job_id=job_8f2 tool=start_test_run status=done
summary: 412 passed, 3 failed (auth/session.test.ts)
details: get_job_result(job_8f2)
이벤트 내용은 간결하게 유지하고 전체 페이로드는 별도의 조회 툴을 통해 가져오도록 설계하여, 40,000줄에 달하는 방대한 로그가 컨텍스트에 한꺼번에 쏟아지지 않도록 하십시오.
그런 다음 배칭(batching)을 적용합니다. DeepSeek의 글에서는 한 턴이 진행되는 동안 도착하는 트리거들을 모아 프리필(prefill)에 통합함으로써, 긴 입력과 짧은 출력 형태로 다음 모델 호출에 일괄 병합하는 라우터를 설명합니다. 이들의 실험에 따르면 분당 트리거 발생 횟수가 1회에서 40회로 증가하는 동안 평균 배치 크기는 1.0에서 2.8로 증가했고, 결정당 소요 시간은 6.4초에서 1.6초로 단축되었습니다. 이는 일반적인 벤치마크가 아닌 해당 글의 실험 결과이지만, 세 개의 이벤트를 한 번의 호출로 읽는 것이 각각 한 개씩 세 번 호출하는 것보다 훨씬 효율적임은 분명합니다. 간단한 원칙은 다음과 같습니다. 모델이 응답을 생성하는 동안에는 이벤트와 사용자 메시지를 큐에 쌓아두고, 턴이 끝나는 시점에 도착 순서대로 한꺼번에 전달하는 것입니다.
순서 보장, 취소 처리, 멱등성 키
순서 보장(Ordering): 작업은 순서에 관계없이 완료될 수 있습니다. 만약 작업 B가 작업 A에 종속되어 있다면, 의존 관계를 명시적으로 만들어야 합니다. 즉, 작업 A의 완료 이벤트가 발생한 후에만 B를 시작하도록 하거나, API가 depends_on 매개변수를 지원하도록 설계하십시오.
취소 처리(Cancellation): stop은 취소 요청일 뿐 실행 보장이 아닙니다. 실제 최종 상태(cancelled, 또는 취소 전 이미 완료된 경우 done)를 반환하여 모델이 상태를 사실대로 보고할 수 있게 하십시오. MCP의 Tasks 확장 규격 역시 동일한 방식을 취합니다. 문서에서는 작업 취소를 협력적(cooperative) 취소로 정의하므로, 태스크가 cancelled가 아닌 다른 종료 상태에 도달할 수도 있습니다.
멱등성 키(Idempotency keys): 모델은 실패 시 재시도하므로 응답이 유실되면 두 번째 start가 트리거될 수 있습니다. 따라서 모든 start 요청에 idempotency_key를 필수로 요구하고, API가 동일한 키를 다시 수신하면 기존 작업을 반환하도록 해야 합니다. 그렇지 않으면 "마이그레이션 실행"과 같은 치명적인 작업이 두 번 실행될 위험이 있습니다.
중간 결과(Partial results): 전체 작업이 끝날 때까지 기다리는 대신, get_job_result(job_id, cursor)를 통해 초기 결과(예: 처음 크롤링된 50개 페이지)를 미리 조회할 수 있도록 지원하십시오.
컨텍스트 비대화 방지(Context growth): 모델이 완료된 작업에 대한 처리를 마치면 해당 작업 정보를 한 줄로 요약하십시오.
타임아웃(Timeouts): 모든 작업에 제한 시간을 설정하고, 시간이 초과되면 job_timed_out 이벤트를 발생시키십시오.
기반 API의 설계 요건
비동기 툴의 성능은 이를 뒷받침하는 작업 API의 완성도에 달려 있습니다. 작업을 수락하고, ID를 반환하며, 호출자가 상태를 확인할 수 있도록 해야 합니다. RFC 9110에서는 202 Accepted를 "요청이 처리를 위해 수락되었으나 아직 처리가 완료되지 않은 상태"로 정의하며, MDN의 202 레퍼런스에서 실질적인 사용법을 다루고 있습니다.
start() 툴을 위한 최소한의 작업 API 구성은 다음과 같습니다.
| 호출 | 응답 | 사용 주체 |
|---|---|---|
POST /jobs (Idempotency-Key 헤더 포함) |
202 + {"job_id", "status":"queued"} + Location: /jobs/{id} |
start |
GET /jobs/{id} |
200 + queued, running, done 또는 failed |
status, 작업 감시자(job watcher) |
GET /jobs/{id}/result |
200(결과 데이터 포함) 또는 409(미완료 시) |
조회(fetch) 툴 |
DELETE /jobs/{id} |
202(취소 요청됨), 이후 호출 시 404 또는 409 |
stop |
| 선택적 콜백 URL | 작업 완료 시 호출자에게 POST 전송 |
작업 감시자(job watcher) |
콜백을 활용하면 런타임이 폴링 대신 푸시 방식으로 이벤트를 전달받을 수 있습니다. 둘 사이의 선택이 고민된다면 웹훅 vs 폴링에서 각각의 장단점을 확인해 보시고, 이벤트 기반 API에 관한 내용은 AsyncAPI란 무엇인가를 참고하시기 바랍니다.
툴이 MCP를 지원한다면 이미 표준 규격이 마련되어 있습니다. MCP 사양(2026-07-28 버전)에는 선택적 확장 기능으로 Tasks가 명시되어 있습니다. 서버는 tools/call에 대해 taskId가 포함된 CreateTaskResult로 응답하고, 클라이언트는 tasks/get을 폴링하거나(또는 notifications/tasks를 수신 대기), tasks/cancel로 중지를 요청할 수 있습니다. 상태 값으로는 working, input_required, completed, failed, cancelled가 있습니다. 다만 클라이언트와 서버 모두 이를 지원해야 하며 호스트별 지원 여부가 다르므로, 도입 전 사용 중인 클라이언트를 먼저 확인하십시오.
Apidog CLI로 코딩 에이전트를 활용해 작업 API를 구축하고 테스트하기
작업 API는 에이전트가 실제로 다루기 전에 미리 검증할 수 있는 영역입니다. 설계와 테스트 요구사항을 코딩 에이전트에 넘겨주고 Apidog CLI를 직접 실행하게 해보십시오. 프롬프트 하나만 작성하면 에이전트가 명세서와 테스트 케이스를 작성하고 이를 직접 실행합니다.
설정은 세 줄의 명령어로 끝납니다.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
그런 다음 에이전트에게 프롬프트를 하나 전달합니다.
In Apidog project <projectId>, design the job API a start() tool needs:
POST /jobs returns 202 with job_id, GET /jobs/{id} returns queued|running|done|failed,
DELETE /jobs/{id} cancels. Create the endpoints, then create test cases that assert:
202 and a job_id on create, a status that reaches done within 60 seconds,
the same job_id when the Idempotency-Key repeats, and 409 or 404 on GET result after cancel.
Run them against the staging environment <envId> and summarize failures.
에이전트는 CLI에서 각 페이로드 구조를 읽어 유효성을 검증한 뒤, 다음과 같이 작성하고 실행합니다.
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file post-jobs.json
apidog endpoint create --project <projectId> --file post-jobs.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-create-202.json
apidog test-case create --project <projectId> --file case-create-202.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
cli 리포터는 터미널에 어설션별 성공 및 실패 여부를 출력하며, json 리포트는 에이전트가 결과를 다시 읽고 분석할 수 있는 정형화된 데이터를 제공합니다. 테스트 케이스를 통과하면 CI 환경에서 -r junit 옵션을 붙여 동일한 명령을 실행할 수 있습니다. 자세한 루프는 Apidog CLI 에이전트 워크플로 가이드에서 살펴볼 수 있으며, Claude Code에서의 Apidog CLI 활용법에서는 에이전트 설정 방법을 다룹니다. Apidog의 무료 플랜은 최대 4명의 사용자까지 지원합니다.
비동기 툴이 필요한 경우와 그렇지 않은 경우
비동기 방식이 적합한 경우:
- 툴 실행에 정기적으로 수 초 이상 걸리는 경우(빌드, 테스트 스위트, 크롤링, 렌더링, 배포 등)
- 작업이 진행되는 동안 사용자가 에이전트와 대화를 이어가야 하는 경우
블로킹 방식을 유지해야 하는 경우:
- 호출 결과가 1~2초 이내에 반환되는 경우
- 어차피 해당 결과가 없으면 다음 단계를 시작할 수 없는 경우
- 실제 작업 API를 뒷받침할 수 없는 경우(내부적으로 블로킹되면서 겉만 비동기 흉내를 내는 가짜 비동기 툴은 불필요한 복잡성만 가중시킵니다)
실질적인 구분 기준: 단순 읽기 작업은 블로킹으로 유지하고, 오래 걸리는 쓰기나 대규모 연산 작업은 비동기로 전환하는 것이 좋습니다.
자주 묻는 질문(FAQ)
비동기 툴 호출과 병렬 툴 호출의 차이점은 무엇인가요? 병렬 툴 호출(parallel tool calls)은 단일 턴 안에서 여러 툴을 동시에 실행하지만, 모델은 여전히 모든 툴의 응답이 끝날 때까지 대기합니다. 반면 비동기 툴 호출(async tool calls)은 즉시 반환된 후 이후의 턴에 걸쳐 완료되므로, 작업이 실행 중인 동안에도 모델이 대화를 계속 이어갈 수 있습니다.
비동기 툴을 구축하려면 반드시 MCP가 필요한가요? 아닙니다. 작업 ID를 반환하는 툴과 완료 이벤트를 주입해 주는 런타임만 있다면 어떤 방식으로든 구현할 수 있습니다. MCP의 선택적 Tasks 확장은 클라이언트와 서버가 모두 지원할 경우 핸들, 폴링, 취소 호출을 표준화해 주는 역할을 합니다.
에이전트는 작업이 언제 끝났는지 어떻게 알 수 있나요? 런타임이 알려줍니다. 작업 감시자(job watcher)가 작업 API를 폴링하거나 콜백을 수신한 뒤, 대화에 간결한 완료 이벤트를 추가합니다. 모델은 다음 턴에서 이 이벤트를 읽게 됩니다.
작업 도중 사용자가 취소하면 어떻게 되나요? 에이전트가 stop(job_id)를 호출하면 API가 요청을 기록하고, 작업은 실제 최종 상태를 보고합니다. 만약 취소 요청이 도달하기 전에 작업이 이미 완료되었다면, 에이전트는 중지되었다고 거짓 보고를 하는 대신 완료되었다고 명확히 안내해야 합니다.
DeepSeek의 전이중 모드를 바로 켜서 사용할 수 있나요? 제품 기능 형태로 즉시 켤 수 있는 것은 아닙니다. 발표된 글에 따르면 DeepSeek Harness에 구현되어 있으나 기본적으로 비활성화되어 있으며, 관련 플러그인은 공식 DeepSeek 제품이 아닌 프로토타입이라고 명시되어 있습니다. 따라서 실무에서는 참조 아키텍처로 활용하시기 바랍니다.