
빠른 답변: 엄밀한 의미에서 제한 없는 AI 비디오 생성기는 자신의 하드웨어에서만 존재합니다. Wan2.2, HunyuanVideo-1.5, LTX-2 같은 오픈 웨이트 모델은 서버 측 필터 없이 실행됩니다. 호스팅 서비스는 모두 콘텐츠 정책을 적용합니다. GPU 없이 무해한 프롬프트에 대한 오탐 거부를 줄이고 싶다면 A2E 같은 멀티 모델 플랫폼을 이용해, 한 모델이 무해한 프롬프트를 거부할 때 다른 모델로 전환할 수 있습니다.
이 가이드에서 말하는 "제한 없음"은 창작의 자유를 의미합니다. 즉, 공포 단편, 전쟁 장면, 스턴트, 의학 설명 영상 같은 정당한 프롬프트가 거부되는 경우가 줄어든다는 뜻입니다. 선정적인 콘텐츠를 의미하는 것이 아니며, 당사자의 동의 없이 실제 인물의 얼굴이나 목소리를 사용하는 것은 결코 허용되지 않습니다. 이 글은 제한 없는 AI 이미지 생성기 가이드의 비디오 버전입니다.
AI 비디오 생성기에서 "제한 없음"이 의미하는 것
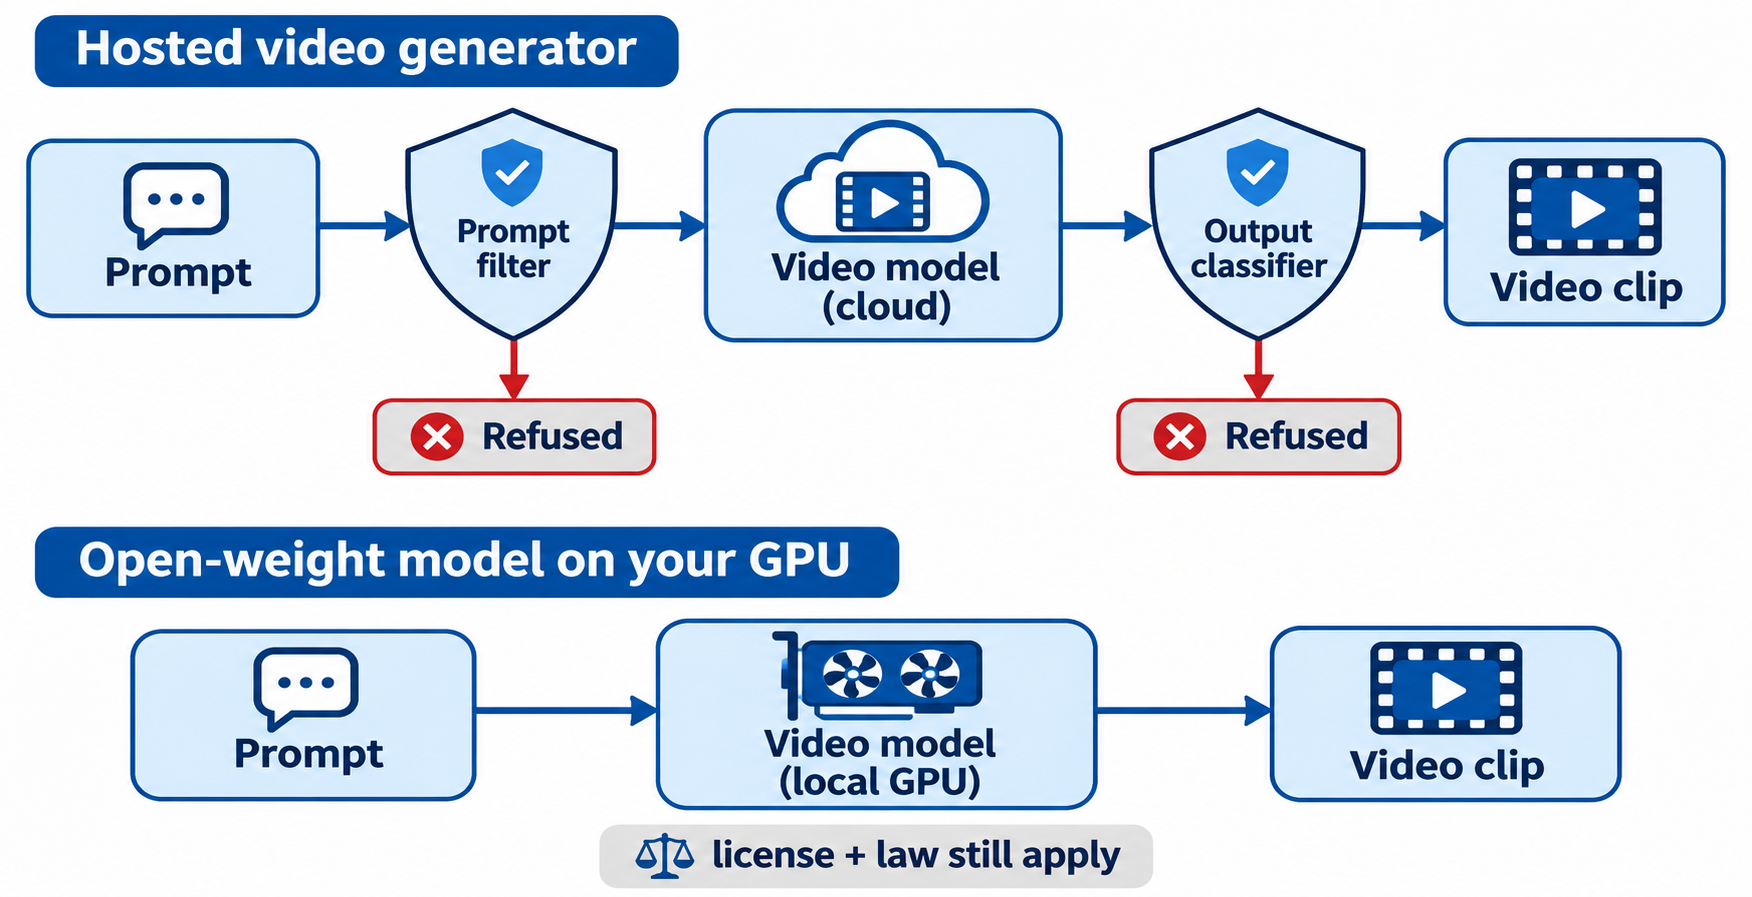
제한 없는 AI 비디오 생성기란 제공사 측 콘텐츠 필터 없이 프롬프트를 처리하는 생성기를 말합니다. 실제로 이에 해당하는 것은 직접 실행하는 오픈 웨이트 모델뿐입니다. 호스팅 도구는 모두 필터를 적용하지만, 무해한 프롬프트를 거부하는 빈도와 하나의 계정에서 시도할 수 있는 모델 수는 서비스마다 다릅니다.
호스팅 비디오 생성기는 보통 두 번 검사합니다. 먼저 프롬프트 필터가 텍스트를 읽고, 그다음 출력 분류기가 클립이 반환되기 전에 프레임을 검사합니다. 어느 쪽이든 거부할 수 있습니다. 반면 모델을 로컬에서 실행하면 이러한 검증 단계가 아예 존재하지 않습니다.
제한 없는 최고의 AI 비디오 생성기: 추천 목록
주요 옵션들의 비교 내용입니다. 가격과 크레딧은 각 공식 페이지에서 2026년 11월 13일 기준으로 확인했습니다.
| 도구 | 유형 | 필터 | 무료 이용 방법 | 가장 적합한 용도 |
|---|---|---|---|---|
| A2E | 호스팅, 멀티 모델 | 제공사 정책 | 일 30크레딧, 워터마크, 720p | 한 계정으로 여러 모델 이용, API 제공 |
| Kling 4.0 | 호스팅 | 제공사 정책 | 공식 페이지 확인 | 오디오가 포함된 대규모 모션 장면 |
| Gemini Omni Flash | 호스팅 (Google) | Google 정책 | 공식 페이지 확인 | 네이티브 오디오가 포함된 3~15초 클립 |
| Grok Imagine | 호스팅 (xAI) | xAI 정책 | 유료 API, 초 단위 과금 | 최대 15초의 짧은 클립, 1.5에서 1080p |
| Seedance 2.5 | 호스팅 (ByteDance) | ByteDance 정책 | 공식 페이지 확인 | 최대 30초의 단일 샷 |
| Wan2.2 | 오픈 웨이트 | 자신의 머신에는 필터 없음 | 무료 웨이트 | 고성능 GPU 한 대로 로컬 720p 24fps |
| HunyuanVideo-1.5 | 오픈 웨이트 | 자신의 머신에는 필터 없음 | 무료 웨이트 | 가벼운 로컬 실행 (오프로딩 시 14 GB) |
| LTX-2 | 오픈 웨이트 | 자신의 머신에는 필터 없음 | 무료 웨이트 | 동기화된 오디오가 포함된 로컬 비디오 |
1. A2E: 하나의 계정으로 여러 비디오 모델 사용
A2E는 올인원 AI 이미지 및 비디오 플랫폼입니다. 정책을 무시해서가 아니라 폭넓은 지원 때문에 이 목록에 포함되었습니다. 한 모델이 무해한 프롬프트를 거부하면, 같은 계정과 크레딧으로 다른 모델에서 다시 실행할 수 있습니다. 비디오 모델로는 Seedance 2.5, Kling 4.0, Wan 3.0, Veo 3.1, Sora 2, Grok Imagine을 제공하며, 얼굴 교환, 토킹 포토, 립싱크, 음성 복제 기능도 있습니다.
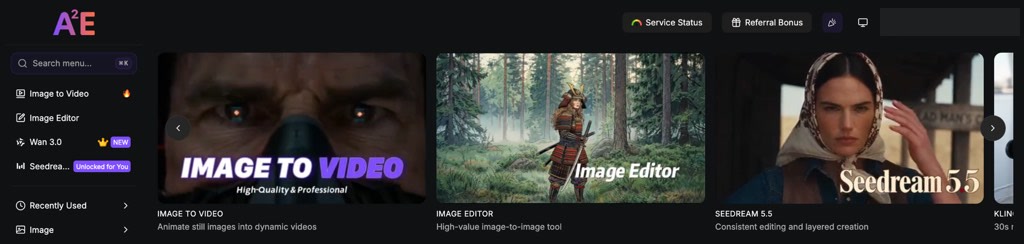
신규 계정은 무료 크레딧 100개와 출석 체크를 통한 일일 30크레딧을 받으며, 워터마크가 있는 720p 출력을 제공합니다. Pro 플랜은 한 달 14.9달러로 1,500크레딧, 워터마크 없음, API 접근이 포함됩니다. 2026년 11월 13일 테스트에서 A2E의 V2 모델로 5초 길이의 이미지-투-비디오 클립을 만드는 데 40크레딧이 소요되었고 약 2분 만에 렌더링되었습니다. 같은 클립에 얼굴 교환은 무료 할당량 내에서 실행되었고, 새 얼굴이 모든 프레임에서 일관되게 유지되었습니다.
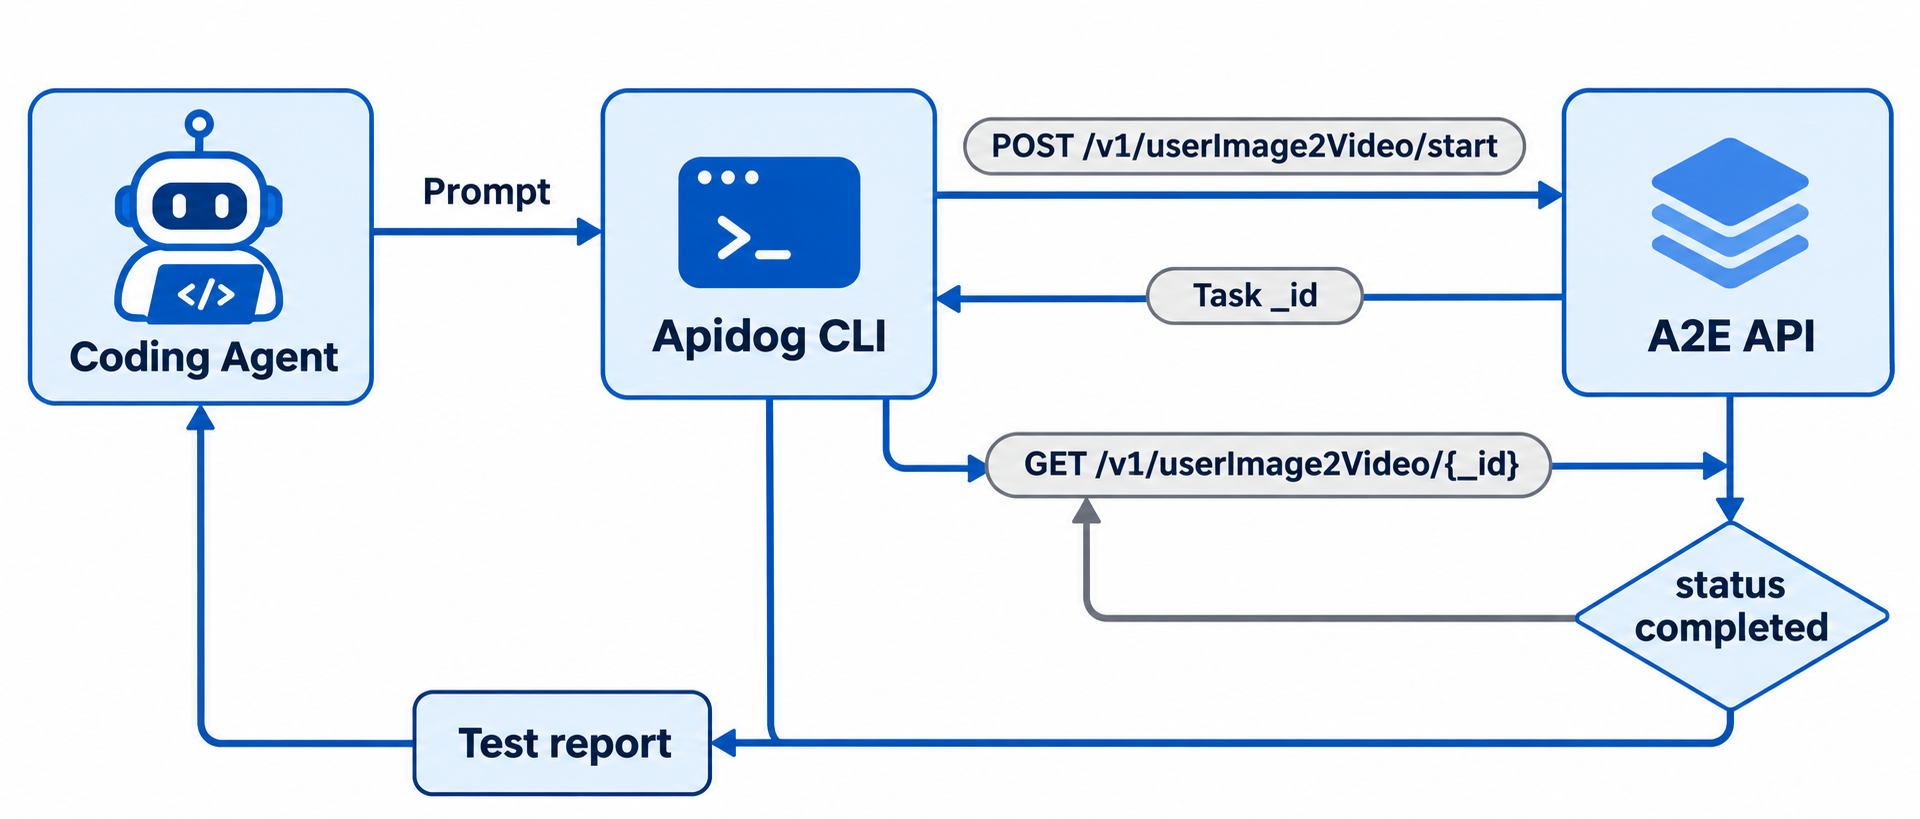
개발자에게는 https://api.a2e.ai의 REST API가 제공되며, OpenAPI 명세와 코딩 에이전트를 위한 SKILL.md가 함께 제공됩니다. 작업은 비동기 방식으로, 작업을 시작한 뒤 완료될 때까지 _id를 폴링하면 됩니다.
결론: 모델 전환이 새 구독이 아닌 드롭다운 클릭으로 가능하므로, 거부를 줄이는 가장 쉬운 호스팅 방법입니다. 다만 A2E의 이용약관은 여전히 적용되며, 사이트에 CSAM 신고 양식이 연결되어 있습니다.
2. Kling 4.0
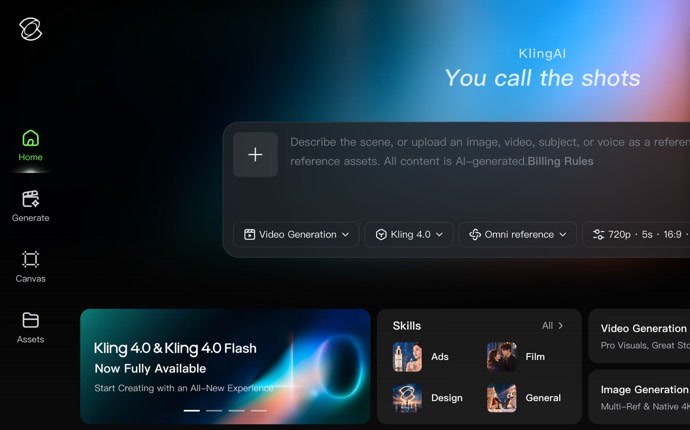
호스팅. Kling은 공식 사이트에서 Kling 4.0을 오디오-시각적 사실감과 안정적인 대규모 모션 장면으로 홍보합니다. 프롬프트 입력창은 텍스트와 함께 이미지, 비디오, 인물, 음성을 참조로 받을 수 있으며, 기본 설정은 720p, 5초, 16:9로 시작합니다. 그 주변에는 모션 컨트롤, 립싱크, 토킹 아바타, 비디오-투-오디오 기능과 노드 기반 Canvas, 대량 작업을 위한 MCP 및 API 경로가 있습니다. 유료 플랜은 6.99달러부터 시작하며, Kling은 A2E 메뉴에서도 이용할 수 있습니다.
결론: 액션이 많은 클립에 강력한 선택지입니다. 무료 제공량은 먼저 kling.ai에서 확인하세요.
3. Google Gemini Omni Flash (구 Veo)
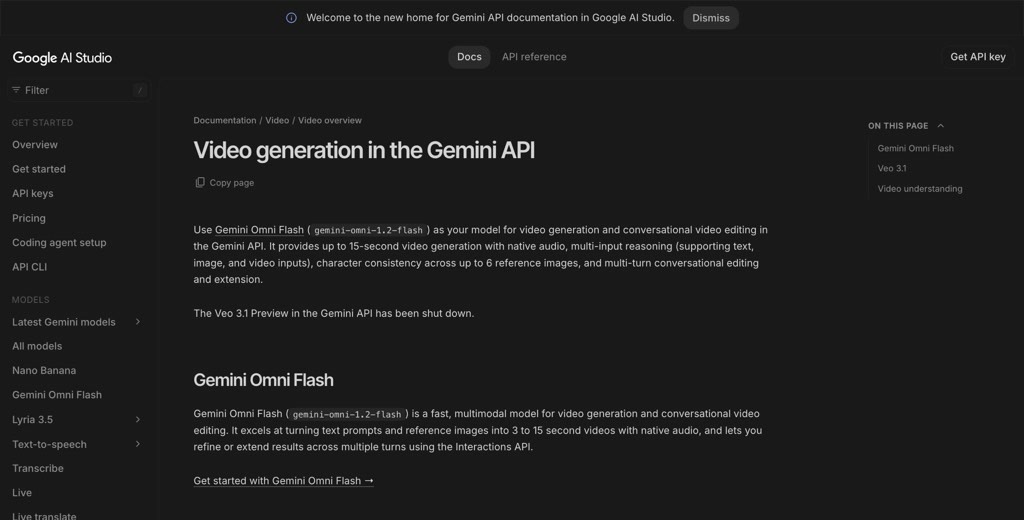
호스팅. Google은 2026년 10월 22일 Gemini API에서 Veo 3.1 미리보기 모델을 종료했으며, 비디오 문서는 이제 개발자에게 Gemini Omni Flash(gemini-omni-1.2-flash)를 안내합니다. 텍스트, 이미지, 비디오 입력으로 네이티브 오디오가 포함된 최대 15초 클립을 생성하고, 최대 6개의 참조 이미지에서 캐릭터 일관성을 유지하며, 여러 턴에 걸쳐 클립을 다듬거나 확장할 수 있습니다. 생성 가능한 콘텐츠는 Google의 생성형 AI 금지 사용 정책이 규정합니다.
결론: Google 생태계 안에서는 품질이 좋지만, 거부 문제가 주된 고민이라면 추천하지 않습니다.
4. Grok Imagine
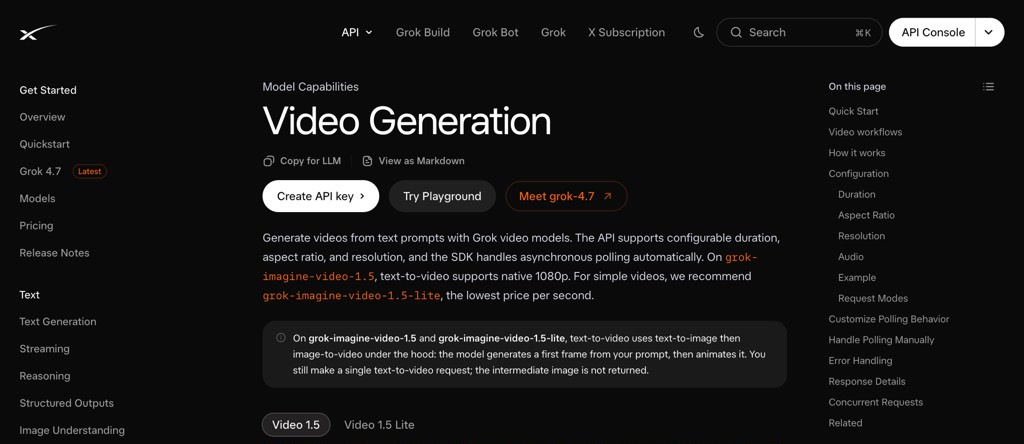
호스팅. xAI의 비디오 모델은 Grok 앱과 xAI API에서 실행됩니다. grok-imagine-video-1.5에서 텍스트-투-비디오는 네이티브 1080p로 렌더링되며, 1.5-lite 모델이 초당 비용이 가장 저렴합니다. 클립은 기본적으로 오디오가 켜진 상태로 1~15초 길이이며, xAI의 SDK가 비동기 폴링을 대신 처리해 줍니다. 모더레이션은 앱과 API에서 동일하므로 API가 더 관대하지는 않지만, 각 작업은 자체 상태를 보고합니다. A2E 메뉴에서도 이용할 수 있습니다. Grok Imagine 제한 없이 사용하기 분석 글에서 무엇이 바뀌었고 무엇이 여전히 가능한지 다룹니다.
결론: 빠르고 저렴한 짧은 클립 제작에 좋지만, 무해한 프롬프트에서도 필터가 작동할 수 있습니다.
5. Seedance 2.5
호스팅. ByteDance의 Seedance 2.5는 오디오와 비디오를 함께 생성하며, 최대 1080p에서 단일 샷으로 30초 스토리텔링을 위해 설계되었습니다. 최대 30개의 참조 이미지, 10개의 비디오, 10개의 오디오 클립을 받을 수 있습니다. ByteDance의 앱, BytePlus ModelArk API, A2E를 포함한 제3자 호스팅을 통해 이용할 수 있습니다. 모든 경로에서 참조 이미지의 실제 인물 얼굴을 차단합니다. 콘텐츠 플래그를 피하는 Seedance 2 프롬프트 가이드에서 실수로 필터를 트리거하는 표현을 다룹니다.
결론: 실제 인물 얼굴만 피한다면, 긴 단일 샷에 가장 좋은 선택입니다.
6. Wan2.2
오픈 웨이트, 로컬 실행. Wan2.2는 Apache 2.0 라이선스로 배포되며 텍스트-투-비디오, 이미지-투-비디오, 스피치-투-비디오 모델을 제공합니다. Mixture-of-Experts 설계를 사용하며, Wan2.1보다 65.6% 더 많은 이미지와 83.2% 더 많은 비디오로 학습되었습니다. TI2V-5B 모델은 텍스트와 이미지 기반 비디오를 모두 720p 24fps로 처리하며, README에 따르면 RTX 4090 같은 소비자용 카드에서 실행됩니다. 별도의 Animate-14B 모델은 캐릭터 애니메이션과 교체를 담당합니다.
결론: 고성능 GPU 한 대가 있다면 가장 좋은 로컬 시작점입니다.
7. HunyuanVideo-1.5
오픈 웨이트, 로컬 실행. HunyuanVideo-1.5는 텍스트-투-비디오와 이미지-투-비디오를 위한 8.3B 파라미터 모델로, 소비자용 GPU에서 실행되도록 설계되었습니다. README에는 모델 오프로딩 활성화 시 최소 14 GB의 GPU 메모리가 필요하다고 명시되어 있으며, 스텝 증류된 480p 이미지-투-비디오 모델은 RTX 4090 한 대에서 약 75초 만에 클립을 렌더링합니다. 학습 코드와 LoRA 튜닝 스크립트도 공개되어 있습니다. Tencent 고유의 커뮤니티 라이선스로 배포되므로 상업적 사용 전에 반드시 확인하세요.
결론: 라이선스가 용도에 맞다면, 가장 가벼운 로컬 옵션입니다.
8. LTX-2
오픈 웨이트, 로컬 실행. Lightricks의 LTX-2는 하나의 모델로 동기화된 오디오가 포함된 비디오를 생성하며, 여러 성능 모드를 제공합니다. 코드는 Apache 2.0이지만, 웨이트에는 README에 명시된 별도의 모델 라이선스가 적용되며 Hugging Face는 다운로드 전에 약관 동의를 요구합니다. 현재 퀵스타트는 약 66 GiB의 LTX-2.5 웨이트를 다운로드하므로 디스크 공간을 확보하세요. GPU 메모리가 부족할 때를 대비해 fp8 양자화와 오프로드를 지원하며, 저장소에는 LoRA 트레이너도 포함되어 있습니다.
결론: 한 번의 실행에서 사운드까지 필요할 때의 로컬 선택지입니다.
세 가지 오픈 웨이트 모델 모두 ComfyUI가 일반적인 프런트엔드입니다. 웨이트를 로드하고 워크플로를 구성한 뒤 오프라인으로 생성하면 됩니다. 제공사 필터 대신 하드웨어와 설정 시간을 투자하는 셈입니다.
호스팅 도구에서 오탐 거부를 줄이는 방법
정당한 프롬프트에서 발생하는 대부분의 거부는 의도가 아니라 표현 때문입니다:
- 장면을 문자 그대로 묘사하세요. 폭력적인 동사로 구성된 프롬프트보다 "셰프가 큰 칼로 양파를 썬다"가 효과적입니다.
- 실명을 사용하지 마세요. 대부분의 제공사는 타당한 이유로 유명인의 이름이 포함된 프롬프트를 차단합니다.
- 자신의 이미지에서 시작하세요. 모델에 동의를 받은 명확한 피사체를 제공합니다.
- 네거티브 프롬프트를 활용해 선혈, 흐림, 왜곡을 배제하세요.
- 모델을 전환하세요. 한 모델이 거부한 프롬프트가 다른 모델에서는 통과되는 경우가 많습니다.
Apidog CLI로 코딩 에이전트가 A2E API를 테스트하게 하기
비디오 API에서 위험한 부분은 failed로 반환되는 비동기 작업이나 UI가 처리하지 못하는 거부 응답입니다. Apidog CLI로 코딩 에이전트가 이러한 검증을 작성하고 실행하게 하세요.
한 번만 설정하면 됩니다:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
curl -sL https://video.a2e.ai/dev/openapi-spec -o a2e-openapi.json
apidog import --project <projectId> --format openapi --file ./a2e-openapi.json
그다음 에이전트(Claude Code, Codex, Cursor 또는 OpenCode)에 프롬프트 하나를 주세요:
In Apidog project <projectId>, create a test case for POST /v1/userImage2Video/start
with a Bearer token from the environment variable A2E_TOKEN. Assert the response
has code 0 and a data._id. Then call GET /v1/userImage2Video/{_id} until
current_status is completed or failed, and fail the test on failed with the
reason. Run it against environment <envId> and summarize the result.
실제 실행은 A2E 크레딧을 소비하므로, 에이전트가 failed 상태에 대한 목(mock) 기대값을 추가하고(apidog cli-schema get mock-create 실행 후 apidog mock create) 그에 대해 오류 처리를 테스트하게 하세요. CI에서는 apidog run --test-case <caseId> -r junit으로 JUnit 리포트를 얻을 수 있습니다. 자세한 내용은 CI/CD 파이프라인에서의 Apidog CLI를 참고하세요.
어떤 AI 비디오 생성기를 선택해야 할까?
- 제공사 필터 완전 차단, 14 GB 이상 GPU: ComfyUI에서 HunyuanVideo-1.5 또는 Wan2.2 TI2V-5B.
- 하나의 로컬 모델로 오디오와 비디오 모두: LTX-2.
- 한 계정으로 여러 호스팅 모델: A2E.
- 액션이 많은 클립: Kling 4.0.
- 긴 단일 샷: Seedance 2.5.
- 제품 개발: A2E API와 비동기 작업 수명 주기를 위한 Apidog CLI 테스트.
FAQ
정말 제한이 없는 AI 비디오 생성기가 존재하나요?
직접 실행하는 오픈 웨이트 모델뿐입니다. 예를 들어 Wan2.2, HunyuanVideo-1.5, LTX-2가 있습니다. 이들은 제공사 측 필터가 없습니다. 다만 각 라이선스와 현지 법률은 여전히 적용되며, 모든 호스팅 서비스는 일종의 콘텐츠 정책을 시행합니다.
A2E는 무료로 사용할 수 있나요?
A2E에는 무료(Free) 플랜이 있습니다. 출석 체크로 일일 보너스 30크레딧을 받으며, 워터마크와 720p 출력이 적용됩니다. API 접근은 한 달 14.9달러인 Pro 플랜부터 제공됩니다.
AI 비디오 생성기가 왜 무해한 프롬프트를 거부하나요?
프롬프트 필터와 출력 분류기는 무해한 장면이라도 폭력이나 실제 인물과 관련된 단어에 반응합니다. 장면을 문자 그대로 묘사하고 다른 모델을 시도해 보세요.
이미지-투-비디오가 텍스트-투-비디오보다 거부가 덜 되나요?
그런 경우가 많습니다. 자신의 이미지가 모델에 명확한 피사체를 제공하기 때문입니다. 다만 출력 분류기는 여전히 프레임을 검사하므로 보장되는 것은 아닙니다.