
Tim Qwen Alibaba merilis Qwen-Image-2.1 sebagai sumber terbuka pada 20 September 2026. Ini adalah satu model yang melakukan generasi teks-ke-gambar dan pengeditan gambar, dengan 7 miliar parameter dalam komponen generasi visualnya, dan dapat menghasilkan PNG transparan langsung dari sebuah prompt alih-alih memalsukannya dengan proses penghapusan latar belakang. Postingan peluncuran mencantumkan empat perubahan: arsitektur yang lebih ringan dan cepat, transparansi bawaan, pengeditan dengan hingga 10 gambar referensi, serta tipografi dan detail potret yang lebih baik. Bobot model tersedia di Hugging Face dan ModelScope, serta kodenya ada di GitHub.
Satu baris di kartu model lebih penting daripada fitur apa pun: lisensinya adalah Qwen Research License, bukan Apache 2.0. Penggunaan komersial memerlukan perjanjian terpisah. Jika Anda mengevaluasi 2.1 untuk sebuah produk, baca bagian itu sebelum melihat tolok ukur. Jika Anda ingin menjalankannya, panduan cara menggunakan Qwen-Image-2.1 memiliki kode diffusers dan pembungkus HTTP yang dapat Anda uji di Apidog. Jika Anda membandingkannya dengan API Qwen Image 3.0 yang di-host, perbandingan 2.1 vs 3.0 adalah halaman pengambilan keputusan.
Qwen-Image-2.1 Sekilas
| Item | Detail (postingan peluncuran, kartu model, README GitHub) |
|---|---|
| Tanggal rilis | 20 September 2026 |
| Fungsi | Teks-ke-gambar dan pengeditan gambar dalam satu model, termasuk keluaran transparan (RGBA) |
| Generator visual | 32 lapisan Single-Stream DiT, 7B parameter |
| Encoder teks | Qwen3-VL 8B |
| VAE | Autoencoder RGBA 64-saluran, kompresi spasial 16x |
| Output default | 2048 x 2048; tujuh rasio aspek hingga 2752 x 1536 |
| Gambar referensi | Hingga 10 per pengeditan |
| Pengeditan lokal | Lingkaran, anotasi yang digambar, atau gambar masker terpisah |
| Model pendamping | Model penulisan ulang prompt Qwen-Image-2.1-PE-T2I dan PE-I2I (fine-tune Qwen3.5-VL 9B) |
| Lisensi | Perjanjian Lisensi Penelitian Qwen; penggunaan komersial memerlukan lisensi terpisah |
| Coba di | Hugging Face Space, Qwen Chat, ComfyUI (dukungan asli sejak hari peluncuran) |
Posisi dalam lini Qwen-Image
Qwen-Image asli dirilis pada Agustus 2025 sebagai model MMDiT 20B yang dikenal untuk rendering teks, dengan Qwen-Image-Edit sebagai model pengeditan terpisah. Hingga akhir 2025, lini ini terpecah lagi: refresh 2512 untuk realisme, Edit-2511 untuk konsistensi multi-orang, dan Qwen-Image-Layered pada bulan Desember untuk lapisan transparan. Qwen-Image-2.0 pada Februari 2026 menggabungkan generasi dan pengeditan menjadi satu model 7B dengan output 2K bawaan.
Versi 2.1 mempertahankan ukuran dan desain terpadu 2.0 dan menggabungkan transparansi model Layered, sehingga satu checkpoint kini mencakup apa yang sebelumnya membutuhkan tiga model. Ini juga mendapatkan jalur inferensi baru (lebih lanjut tentang ini di bawah) dan antarmuka pengeditan yang dibangun di sekitar masker dan berbagai referensi. Secara paralel, Alibaba menjalankan lini yang di-host: Qwen Image 3.0 dan 3.0 Pro diluncurkan pada Juli 2026 sebagai model API tanpa bobot yang dipublikasikan. Jadi penamaannya adalah percabangan, bukan urutan. 2.1 adalah model terbuka yang Anda unduh; 3.0 adalah model yang Anda sewa.
Apa yang baru di 2.1
Arsitektur yang lebih ringan dan jalur pengeditan yang lebih cepat
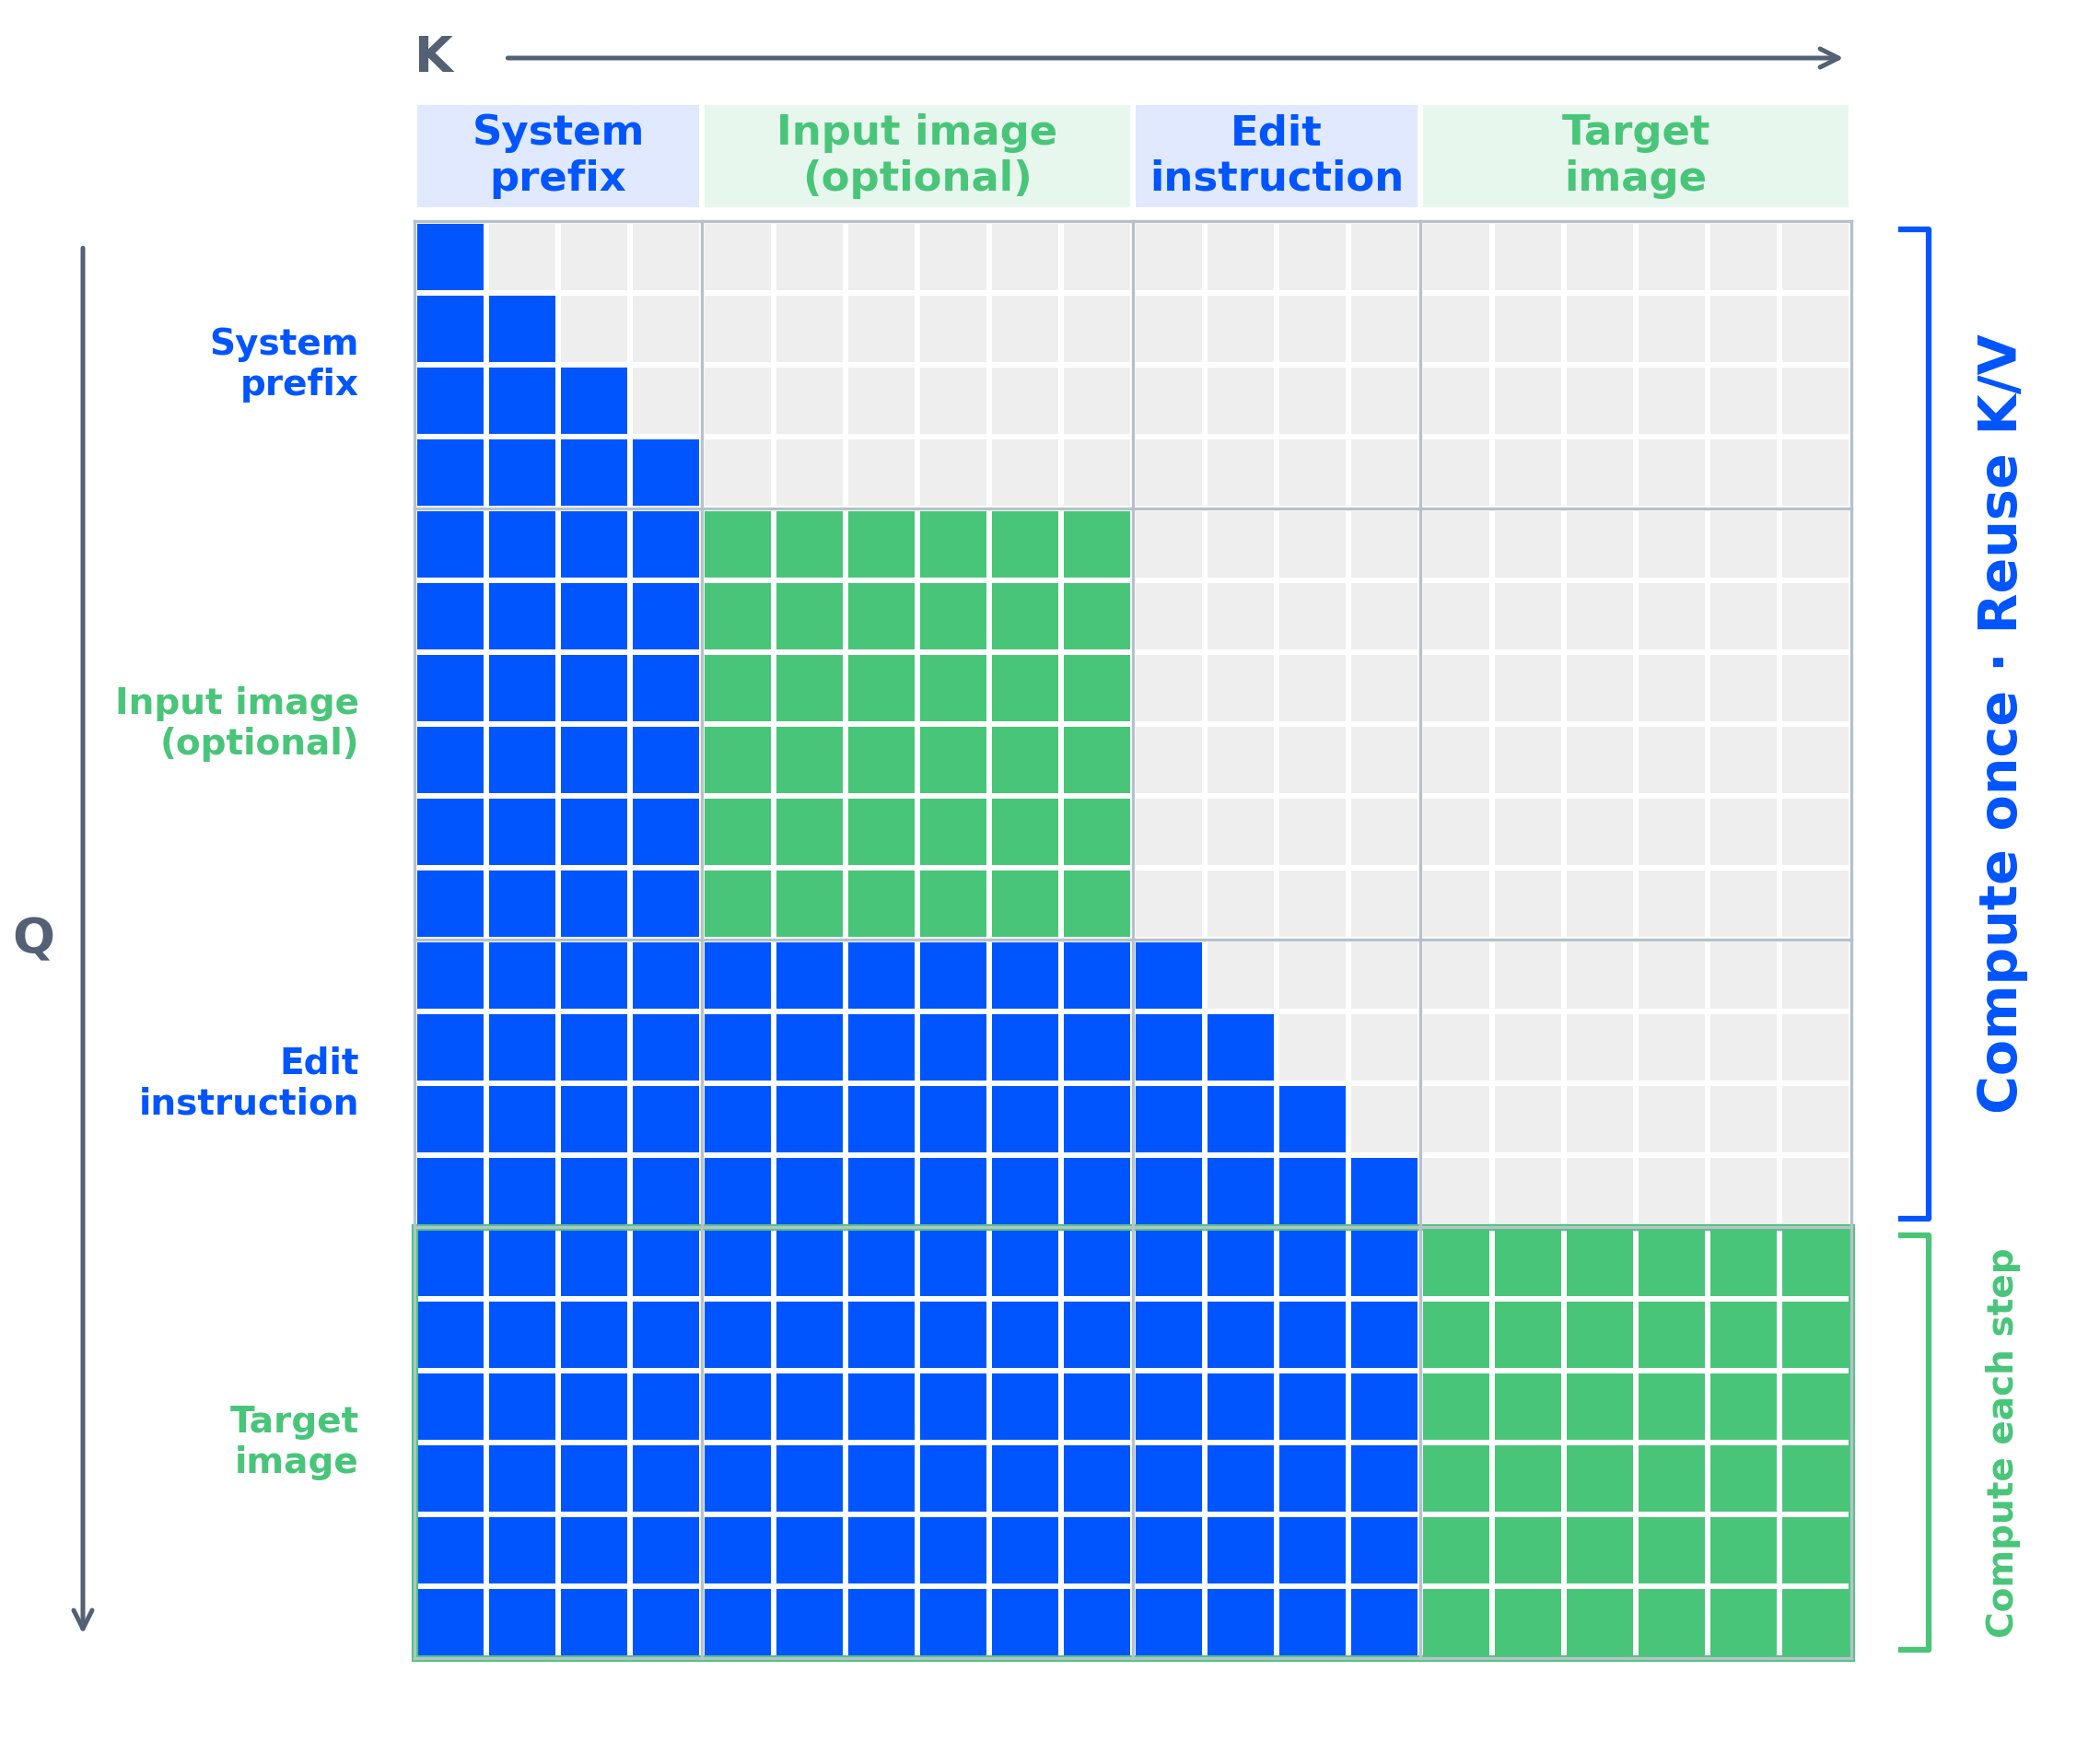
Generator visualnya adalah 32 lapisan Single-Stream DiT dengan 7B parameter, dipasangkan dengan encoder Qwen3-VL 8B dan VAE yang secara asli membawa saluran alfa. Rekayasa yang menarik ada pada perhatian (attention). Qwen menyebutnya granularitas campuran: token teks (prefiks sistem dan instruksi pengeditan Anda) menggunakan masker kausal tingkat token, sementara generasi gambar menggunakan masker tingkat chunk. Karena gambar masukan dan instruksi bersifat statis di seluruh langkah denoising, model menghitung cache nilai kunci mereka sekali pada langkah pertama dan menggunakannya kembali. Manfaat yang dinyatakan Qwen adalah latensi dan memori yang lebih rendah saat mengedit dengan beberapa gambar referensi, yang persis merupakan beban kerja yang semakin berat dengan batas 10 gambar.
Penjadwalnya adalah pencocokan aliran dengan langkah diskrit Euler, dan kode referensi berjalan 40 langkah secara default.
Transparansi bawaan dalam model yang sama
Ini adalah berita utamanya. Anda meminta gambar transparan dalam prompt dan model mengembalikan RGBA. Frasa yang direkomendasikan dari README adalah harfiah: mulailah dengan “Ini adalah gambar RGBA dengan transparansi” dan katakan latar belakangnya transparan. Postingan peluncuran menunjukkan subjek tunggal, komposisi multi-elemen, dan tiga kasus pengeditan pada masukan transparan: mengubah ekspresi subjek sambil mempertahankan alfa, mengganti teks di dalam lapisan transparan, dan mengekstraksi subjek dari foto RGB biasa sebagai potongan RGBA.
Bagi tim produk, ini menggantikan pipeline dua model (generasi, lalu matte) dengan satu panggilan. Ini juga menghilangkan artefak halo yang ditinggalkan oleh penghilang latar belakang di sekitar rambut dan kaca, karena alfa dihasilkan, bukan disimpulkan setelahnya. Apakah tepiannya bertahan dengan baik pada resolusi 2K pada aset Anda sendiri adalah sesuatu yang perlu diuji daripada diasumsikan; panduan tingkat gratis menunjukkan tempat untuk menjalankan pengujian tersebut tanpa GPU.
Mengedit dengan hingga 10 referensi dan kontrol wilayah yang nyata
Tiga fitur pengeditan menonjol dalam contoh peluncuran:
- Berbagai referensi. Enam potret menjadi satu foto grup; model, pakaian, sepatu, tas, dan topi menjadi pakaian lengkap; sepuluh foto furnitur menjadi ruangan yang dilengkapi. Batasnya adalah 10 gambar masukan.
- Pengeditan lokal tiga cara. Gambar lingkaran berwarna dan sebutkan masing-masing berdasarkan warna dalam prompt (“hapus jam tangan di lingkaran biru”), cat di atas area, atau berikan gambar asli yang tidak tersentuh ditambah masker terpisah sebagai dua masukan agar tidak ada bagian dari sumber yang tertutup.
- Fidelitas. Qwen mengatakan identitas wajah serta teks, tekstur, dan bentuk produk bertahan dari pengeditan lebih baik daripada di 2.0. Postingan tersebut menunjukkan pasangan sebelum-dan-sesudah tetapi tanpa metrik, jadi perlakukan ini sebagai klaim yang perlu diverifikasi pada SKU Anda sendiri.
Jalur pengeditan yang sama menangani panorama dari selfie, infografis dari foto produk, dan storyboard dari lembar karakter tiga tampilan. Pengeditan lokal berurutan dapat dirangkai menjadi animasi pendek, yang ditunjukkan dalam postingan dengan klip kapibara.
Kualitas tipografi dan potret
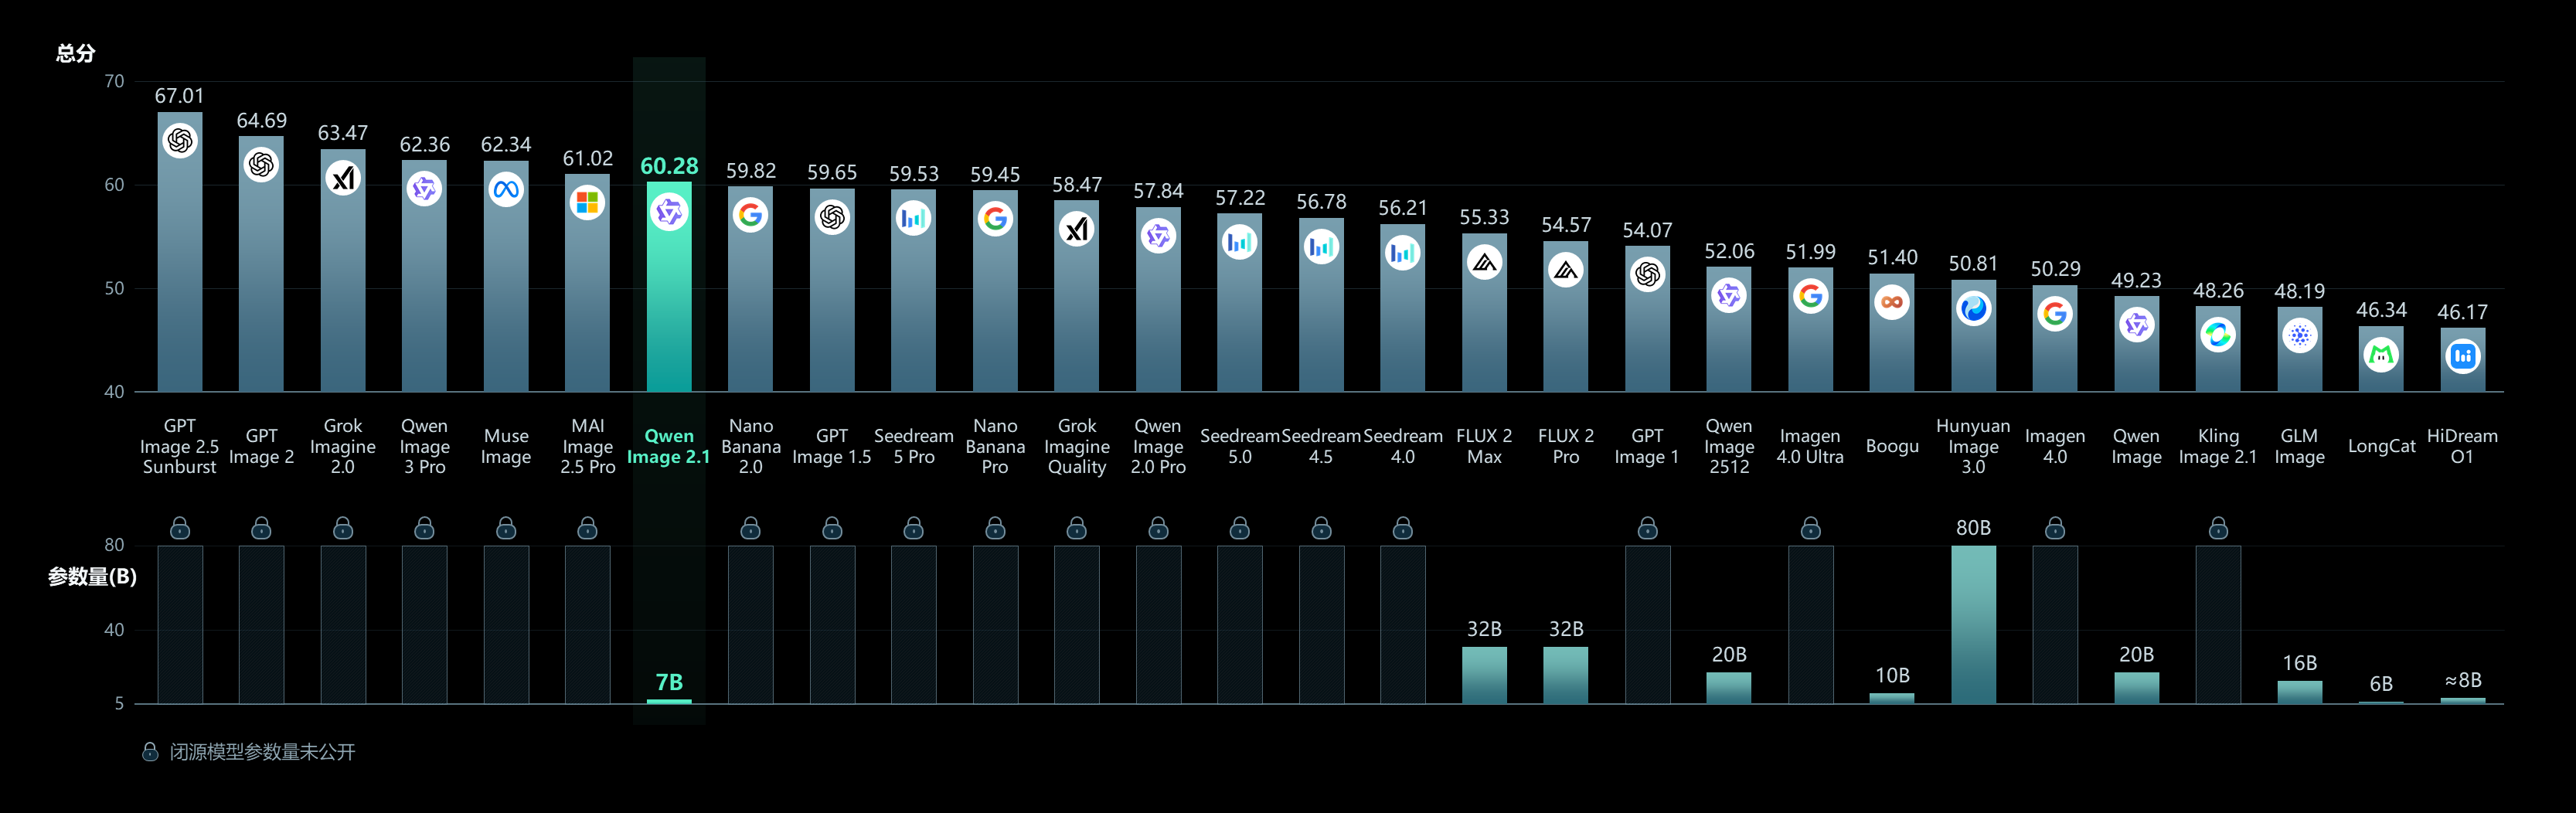
Qwen telah memimpin rendering teks terbuka sejak Qwen-Image pertama, dan 2.1 memperluasnya ke gaya jenis huruf, tata letak, dan bagaimana teks berada dalam komposisi daripada hanya ejaan. Pencahayaan potret dan detail halus juga mendapat peningkatan. Postingan peluncuran mendukung ini dengan grafik Qwen-Image-Bench terhadap model terbuka dan tertutup; grafik tersebut adalah gambar dan postingan tidak mencetak angka, jadi kami tidak mengutip apa pun di sini.
Lisensi: bobot terbuka, ketentuan penelitian
Qwen-Image asli adalah Apache 2.0. Qwen-Image-2.1 dirilis di bawah Perjanjian Lisensi Penelitian Qwen, dan teks lisensi singkat dan jelas pada poin-poin penting:
- Anda tidak boleh menggunakan model “untuk tujuan komersial apa pun tanpa memperoleh lisensi komersial terpisah,” yang diminta melalui email dari Qwen.
- Redistribusi dan turunan harus menyertakan lisensi, pemberitahuan “Dibangun dengan Qwen” atau “Ditingkatkan menggunakan Qwen”, dan baris hak cipta yang menyebutkan Hangzhou Tongyi Laboratory.
- Anda tidak dapat menggunakan “Qwen” sebagai nama utama dari turunan.
- Perjanjian ini diatur oleh hukum Tiongkok dengan yurisdiksi di Hangzhou.
Model pendamping penulisan ulang prompt dikirimkan dengan ketentuan yang sama. Untuk proyek hobi, makalah penelitian, atau evaluasi internal, ini baik-baik saja. Untuk fitur SaaS, ini berarti percakapan dengan Alibaba terlebih dahulu, atau menggunakan API 3.0 yang di-host, yang hadir dengan ketentuan komersial biasa dan harga per gambar.
Dua model penulisan ulang prompt
Di samping generator, Qwen menerbitkan Qwen-Image-2.1-PE-T2I dan Qwen-Image-2.1-PE-I2I. PE-T2I adalah Qwen3.5-VL 9B yang telah di-fine-tune yang menerima permintaan singkat dalam bahasa apa pun dan mengembalikan JSON dengan prompt Bahasa Inggris yang detail dan rasio aspek yang direkomendasikan. PE-I2I adalah pasangannya untuk pengeditan [VERIFIKASI]. Mereka opsional, dan begitulah cara Demo Space mendapatkan prompt yang panjang dan terstruktur dari masukan satu baris. Jika Anda membangun API di sekitar 2.1, ini adalah langkah “peningkatan prompt” yang dilakukan produk seperti ChatGPT Images secara tak terlihat.
Apa yang tidak disebutkan dalam peluncuran
- Tidak ada angka VRAM berdasarkan resolusi. README menunjuk ke
enable_model_cpu_offload(), vLLM-Omni dengan FP8, SGLang, dan LightX2V untuk serving yang lebih ringan atau lebih cepat, ditambah dukungan AMD, tetapi tidak ada tabel. - Tidak ada angka tolok ukur yang dipublikasikan, hanya grafik.
- Tidak ada API yang di-host untuk 2.1 di Model Studio pada saat peluncuran [VERIFIKASI]; lini yang di-host adalah 3.0.
- Tidak ada klaim kecepatan inferensi yang tetap, hanya “efisiensi yang ditingkatkan” dari penggunaan kembali cache KV.
Menerapkannya di balik API dan mengujinya
Sebagian besar tim tidak akan memanggil pipeline diffusers dari kode aplikasi. Mereka akan membungkusnya dalam layanan HTTP di perangkat GPU dan memanggilnya. Setelah menjadi endpoint, itu adalah API seperti yang lainnya, dan Apidog adalah tempat Anda merancang dan mengujinya: tentukan skema permintaan (prompt, gambar referensi opsional, rasio aspek, flag transparansi), kirim panggilan nyata, pastikan bahwa responsnya adalah PNG dengan saluran alfa, dan ubah kasus yang baik menjadi rangkaian regresi yang Anda jalankan ulang setelah setiap pembaruan model. Anda juga dapat melakukan mock endpoint sehingga tim frontend membangun berdasarkan kontrak yang stabil saat GPU sedang sibuk. Panduan cara menggunakan menjelaskan pembungkus tersebut dan pengujian Apidog langkah demi langkah.
Unduh Apidog untuk mengikuti panduan ini.
FAQ
Apakah Qwen-Image-2.1 gratis untuk penggunaan komersial? Tidak, tidak tanpa lisensi komersial terpisah dari Qwen. Bobot model gratis untuk diunduh dan digunakan untuk tujuan penelitian dan non-komersial. Lihat bagian lisensi di atas dan panduan tingkat gratis untuk cara mencoba tanpa biaya.
Bagaimana 2.1 berbeda dari Qwen-Image-2.0? Ukuran 7B yang sama dan desain generasi-plus-pengeditan yang terpadu. Baru di 2.1: keluaran dan pengeditan RGBA bawaan, hingga 10 gambar referensi, pengeditan lokal berbasis masker dan anotasi, jalur perhatian granularitas campuran dengan penggunaan kembali cache KV untuk pengeditan multi-gambar yang lebih cepat, serta tipografi dan detail potret yang ditingkatkan.
Apakah sama dengan Qwen Image 3.0? Tidak. 3.0 dan 3.0 Pro adalah model API yang di-host yang diluncurkan pada Juli 2026 tanpa bobot terbuka; 2.1 adalah model dengan bobot terbuka. Perbandingan mencakup perbedaan harga dan kapabilitas.
Perangkat keras apa yang dibutuhkan? Qwen belum mempublikasikan persyaratan VRAM. Kode referensi memuat pipeline dalam bfloat16 pada satu perangkat CUDA dan menawarkan offload CPU; stack serving komunitas menambahkan FP8. Harapkan GPU pusat data atau kelas atas untuk output 2K pada 40 langkah.
Bisakah ia mengedit gambar transparan, tidak hanya menghasilkannya? Ya. Contoh peluncuran mengubah ekspresi subjek dan mengganti teks di dalam lapisan transparan sambil mempertahankan saluran alfa, serta mengekstrak subjek RGBA dari foto RGB.
Kemana selanjutnya
Qwen-Image-2.1 adalah model pengeditan terbuka yang kuat dengan satu fitur yang tidak dimiliki model lain dalam satu checkpoint, yaitu transparansi bawaan, dan satu batasan yang menentukan apakah Anda dapat menggunakannya, yaitu lisensi penelitian. Jalankan secara lokal dengan panduan cara menggunakan, coba tanpa GPU melalui opsi gratis, dan bandingkan API 3.0 yang di-host sebelum Anda berkomitmen. Apa pun yang Anda pilih, uji endpoint tersebut di Apidog agar pertukaran model tidak pernah merusak produk Anda secara diam-diam.