
OpenAI LifeVal adalah tolok ukur berisi 169 tugas kehidupan sehari-hari, seperti mendaftarkan anak ke sekolah, mengelola anggaran rumah tangga, atau berurusan dengan kantor pemerintah, yang diselesaikan oleh agen AI dengan penggunaan browser, penggunaan komputer, dan konektor. Sebuah rubrik menilai setiap percobaan, dan skornya adalah rata-rata reward dari 0 hingga 1. GPT-6 Astra mencetak 80.6% pada effort xhigh.
Itu versi singkatnya. Di bawah ini Anda akan menemukan bagaimana OpenAI membangun LifeVal, setiap skor model yang dipublikasikannya (termasuk angka per-effort yang hanya ada di dalam grafik interaktif halaman tersebut), apa yang dikatakan angka-angka itu tentang reasoning effort, dan apa yang tidak dicakup oleh tolok ukur ini.
Apa itu OpenAI LifeVal?
LifeVal adalah tolok ukur OpenAI Research yang mengukur seberapa baik sebuah model menyelesaikan pekerjaan rumah tangga kehidupan biasa alih-alih coding atau soal ujian. 169 tugasnya bersifat agentic: model menjelajah web, mengoperasikan komputer, dan memanggil konektor, lalu rubrik khusus per skenario menilai hasilnya.
OpenAI menyebutkan tujuh area tugas:
- Pengasuhan
- Kesehatan
- Pendidikan
- Administrasi rumah tangga
- Keuangan pribadi
- Belanja
- Mengakses layanan pemerintah
Metrik utamanya adalah rata-rata reward. Setiap poin merata-ratakan percobaan dalam satu tugas, lalu merata-ratakan 169 rata-rata tugas dengan bobot yang sama. Skor 80.6% berarti reward 0.806. Catatan grafiknya menyebut "No WTP weighting", yang akan kita bahas lagi nanti.
Bagaimana OpenAI membangun kumpulan tugas LifeVal
OpenAI tidak menciptakan daftar tugas dari nol. Mereka memulai dari bagaimana orang sebenarnya menghabiskan waktu, menggunakan dua kumpulan data publik dan survei mereka sendiri:
- American Time Use Survey dari Biro Statistik Tenaga Kerja AS, yang mencatat apa yang dilakukan orang Amerika dari jam ke jam.
- Multinational Time Use Study, yang menyelaraskan catatan harian penggunaan waktu di berbagai negara.
- Survei mereka sendiri terhadap 3,995 responden yang representatif secara demografis, yang ditanya di mana mereka ingin bantuan AI.
Data penggunaan waktu memberi tahu OpenAI aktivitas apa yang mengisi hari-hari orang. Survei memberi tahu aktivitas mana yang bersedia diserahkan orang kepada agen. Irisannya menjadi 169 skenario.
Halaman itu menampilkan lima kartu contoh tugas, masing-masing dengan skornya. Ini adalah contoh yang dipilih OpenAI, bukan sampel acak:
| Contoh tugas (pilihan OpenAI) | Skor |
|---|---|
| Mendaftar ke taman kanak-kanak yang tepat setelah pindah | 93.1% |
| Mengelola relawan menjelang banjir | 98.0% |
| Mencari rumah baru untuk keluarga saya | 100% |
| Menonton pertandingan bersama nenek dari kejauhan | 96.3% |
| Menyiapkan makanan untuk orang tua yang baru didiagnosis diabetes | 90.4% |
Skor LifeVal: setiap model OpenAI
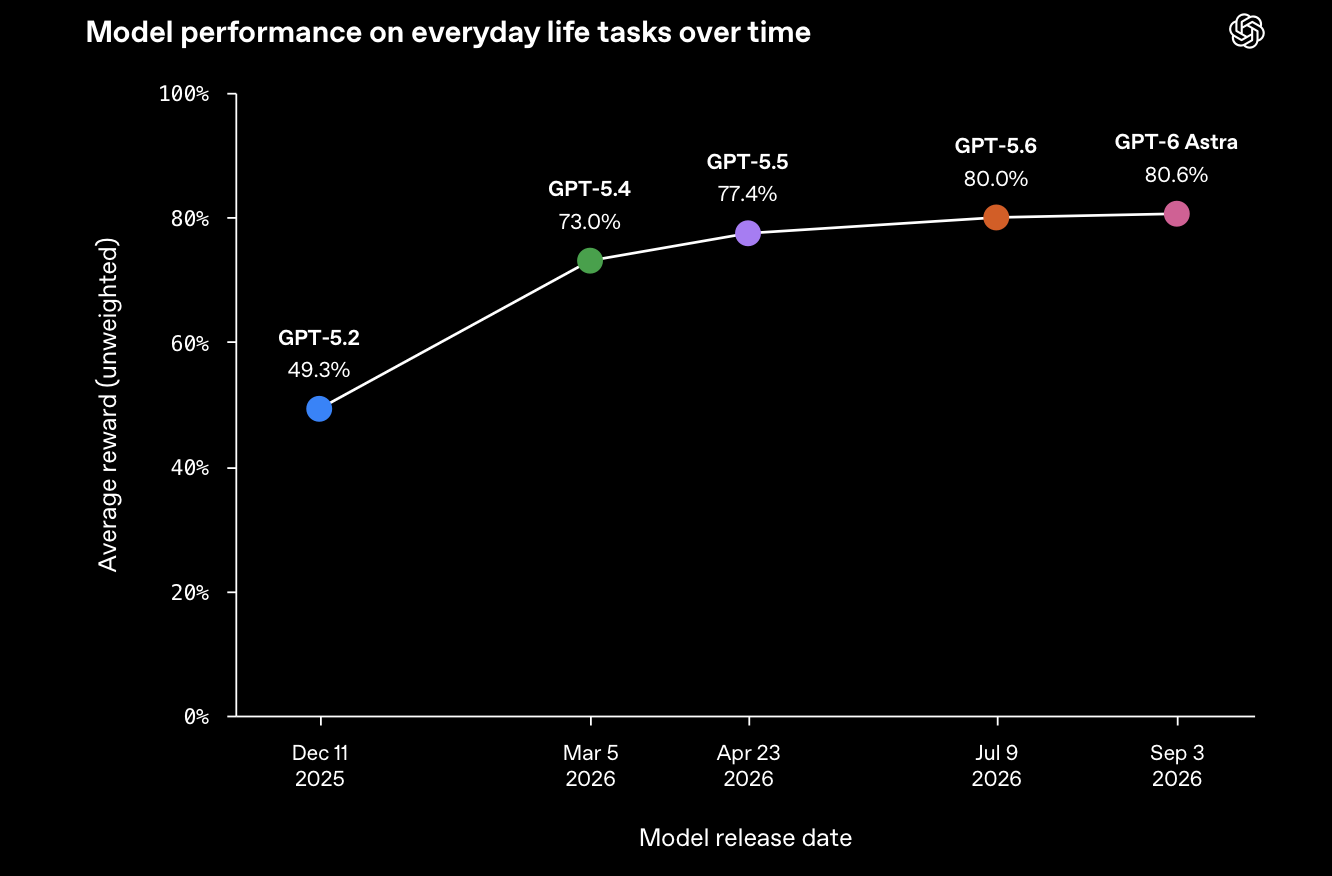
Grafik pertama OpenAI memetakan setiap model pada reasoning effort xhigh terhadap tanggal rilisnya. GPT-6 Astra menggunakan "pengaturan xhigh dari blog peluncuran".
| Model | Tanggal rilis | LifeVal rata-rata reward (xhigh) |
|---|---|---|
| GPT-5.2 | 2025-12-11 | 49.3% |
| GPT-5.4 | 2026-03-05 | 73.0% |
| GPT-5.5 | 2026-04-23 | 77.4% |
| GPT-5.6 | 2026-07-09 | 80.0% |
| GPT-6 Astra | 2026-09-03 | 80.6% |
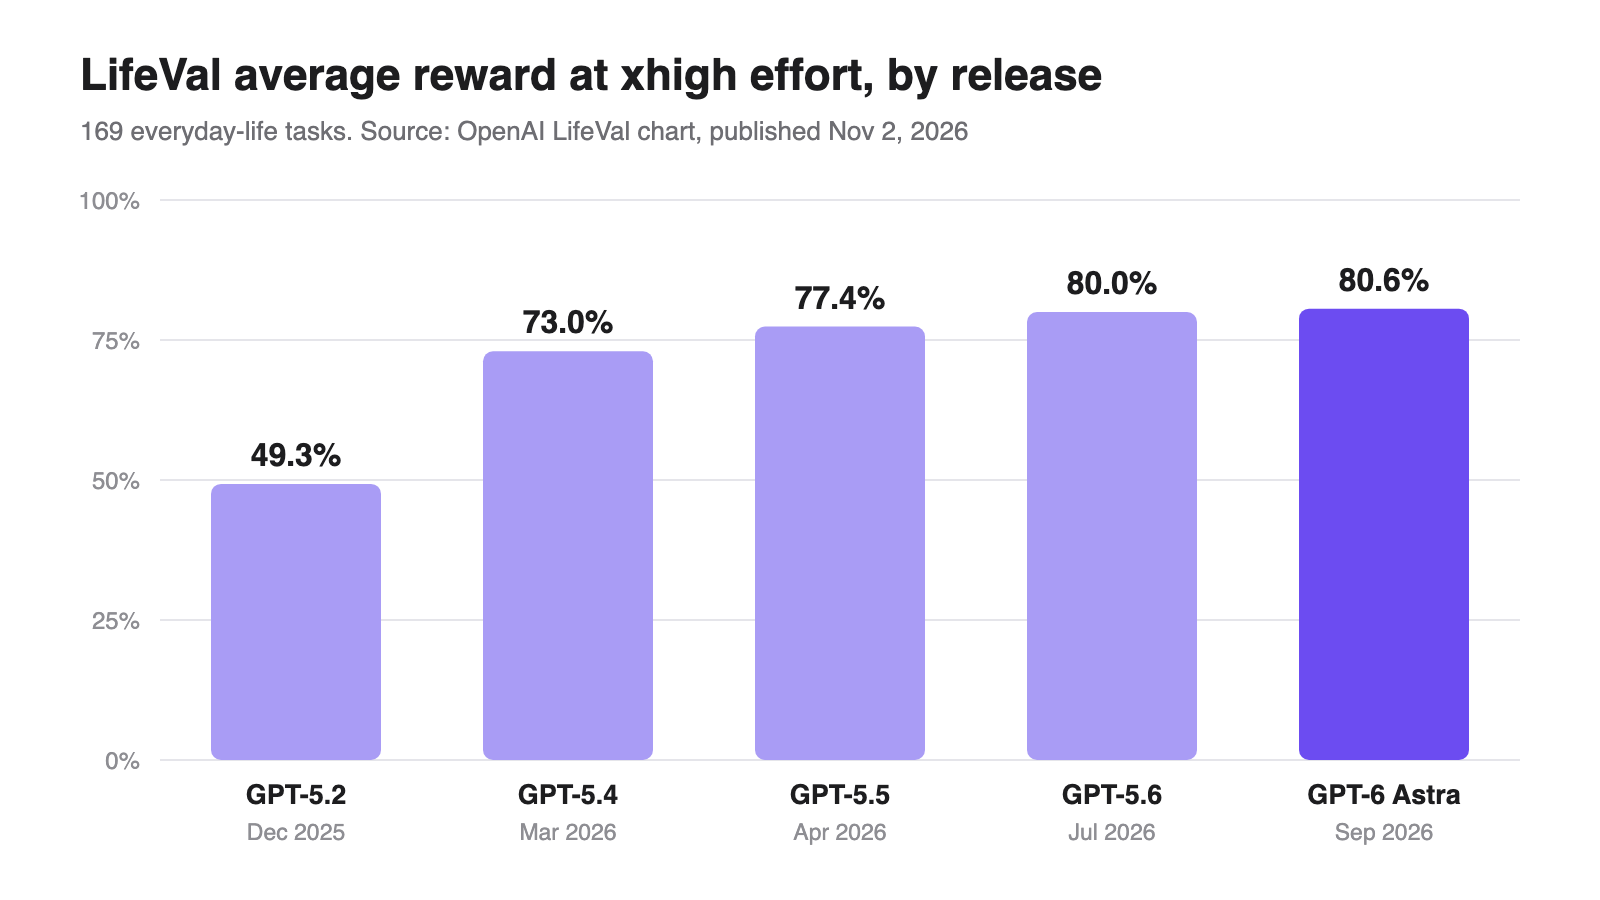
Kurvanya curam, lalu mendatar. GPT-5.2 ke GPT-5.4 menambah 23.7 poin dalam tiga bulan. Tiga rilis berikutnya bersama-sama menambah 7.6 poin, dan GPT-6 Astra mengalahkan GPT-5.6 sebesar 0.6.
Lonjakan GPT-5.4 bukan hanya soal kualitas. Pada xhigh, latensi rata-rata turun dari 121.0 detik menjadi 16.7 detik dan token yang dihasilkan dari 202.0K menjadi 30.6K per tugas. Model yang lebih baru mencapai jawaban yang jauh lebih baik dengan output sekitar sepertujuh.
GPT-6.1 Sol dan GPT-6.1 Terra tidak muncul di kedua grafik, meskipun keduanya sudah dirilis. Garis waktunya berhenti pada 3 September 2026. Jika Anda memilih antara GPT-6.1 Sol dan Astra untuk produk agen, LifeVal belum bisa membantu Anda.
LifeVal menurut reasoning effort
Grafik kedua adalah yang lebih berguna, dan Anda hanya bisa melihatnya dengan mengarahkan kursor. Grafik ini menguraikan setiap model menurut reasoning effort, dengan empat angka per titik: reward, latensi, token yang dihasilkan, dan biaya API. Berikut reward untuk setiap pengaturan:
| Model | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| GPT-5.2 | 27.7% | 37.2% | 45.2% | 49.3% | n/a |
| GPT-5.4 | 62.8% | 70.1% | 72.0% | 73.0% | n/a |
| GPT-5.5 | 57.1% | 71.3% | 75.6% | 77.4% | n/a |
| GPT-5.6 | 63.9% | 75.0% | 78.8% | 80.0% | 82.6% |
| GPT-6 Astra | 66.6% | 77.6% | 80.7% | 80.6% | 82.5% |
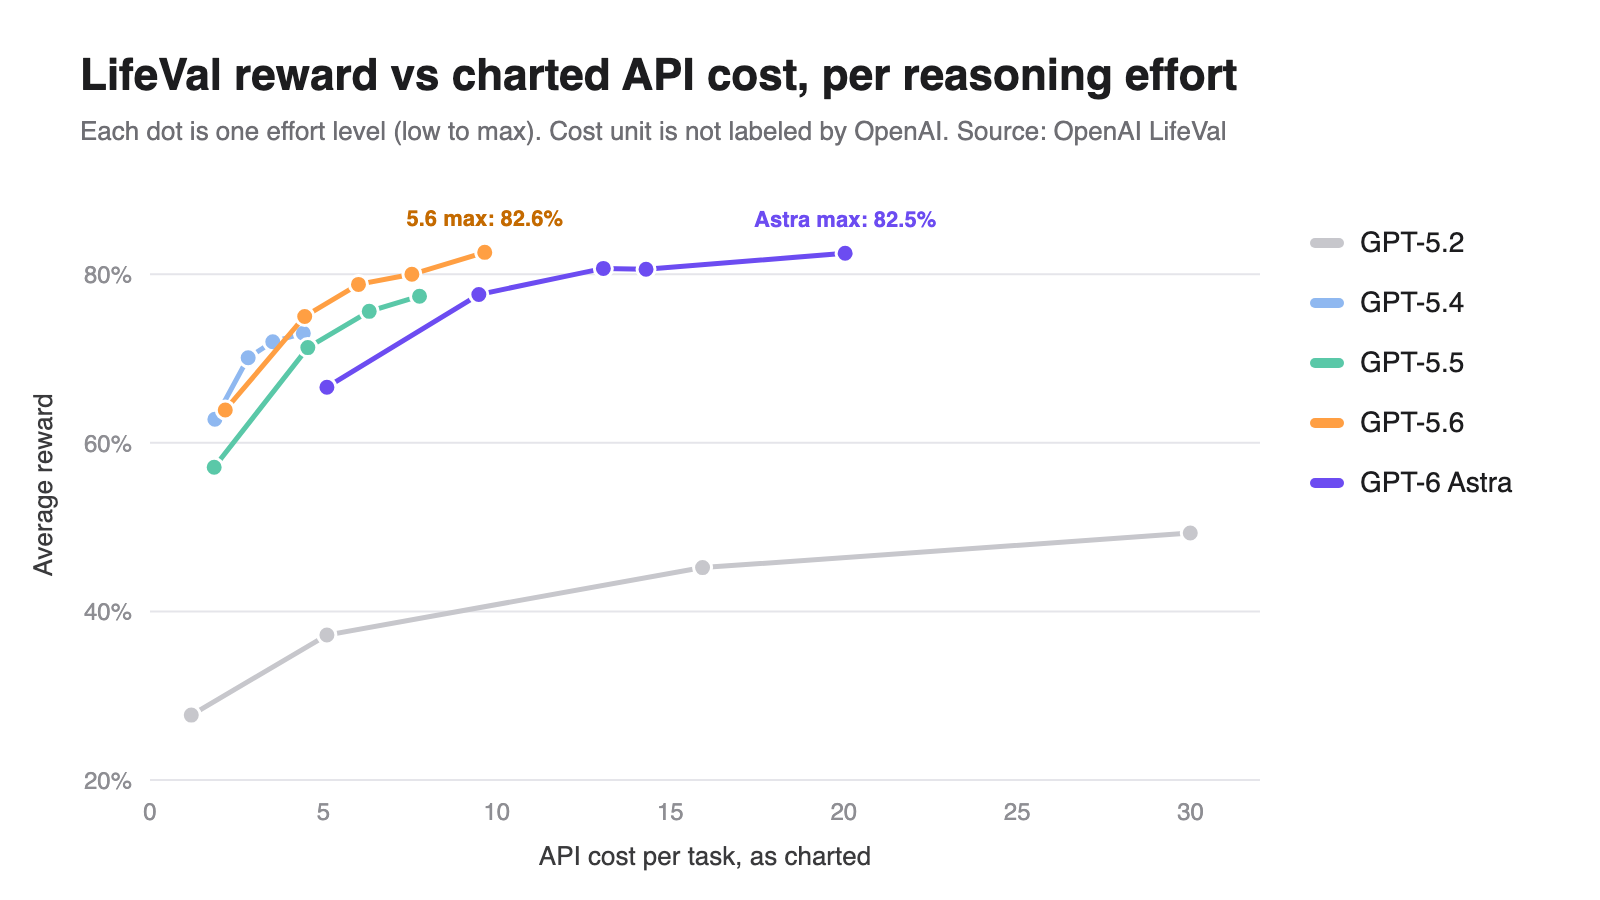
Catatan tentang kolom biaya. OpenAI menyebutnya biaya API tetapi tidak menyatakan satuannya, jadi perlakukan angka di bawah sebagai "biaya API per tugas sebagaimana digrafikkan", berguna untuk rasio, bukan sebagai dolar.
GPT-5.6 pada max setara dengan GPT-6 Astra pada max
| Pengaturan | Reward | Latensi | Token | Biaya sesuai grafik |
|---|---|---|---|---|
| GPT-5.6, max | 82.6% | 22.2 s | 29.7K | 9.65 |
| GPT-6 Astra, max | 82.5% | 20.6 s | 26.3K | 20.04 |
| GPT-5.6, xhigh | 80.0% | 17.5 s | 20.7K | 7.55 |
| GPT-6 Astra, high | 80.7% | 13.6 s | 12.4K | 13.07 |
GPT-5.6 pada max sedikit unggul atas Astra pada max dengan 0.1 poin pada sekitar setengah biaya sesuai grafik. Pada effort yang sama, keunggulan Astra atas GPT-5.6 di bawah tiga poin pada setiap pengaturan, 0.6 pada xhigh, dan hilang pada max. Astra sedikit lebih cepat dan menggunakan lebih sedikit token, tetapi untuk tugas-tugas ini Anda membayar sekitar dua kali lipat untuknya. Rincian harga GPT-5.6 dan panduan API GPT-6 Astra kami memuat tarif per token jika Anda ingin memeriksa rasio itu terhadap traffic Anda sendiri.
Menambah reasoning di atas “high” hampir tidak memberi manfaat apa pun
Pada GPT-6 Astra, high mendapat 80.7% dan xhigh mendapat 80.6%. Effort tambahan itu memakan 1.4 detik lebih lama dan 2.1K token lebih banyak untuk skor yang sedikit lebih rendah. GPT-5.4 menunjukkan pola yang sama: satu poin dari high ke xhigh.
Keuntungan besar ada di bagian bawah kurva. Menaikkan GPT-5.5 dari low ke medium menambah 14.2 poin. Menaikkannya dari high ke xhigh menambah 1.8. Jika agen Anda menjalankan tugas sehari-hari seperti ini, medium atau high adalah pengaturan yang pertama diuji. Panduan reasoning OpenAI menjelaskan cara kerja parameter effort di Responses API.
Apa yang tidak dicakup LifeVal
LifeVal adalah sinyal yang berguna, tetapi ini sinyal yang dilaporkan sendiri. Sebelum Anda mengutipnya, ketahui batasannya.
- Ini tidak publik. Tidak ada kumpulan tugas yang bisa diunduh dan tidak ada papan peringkat publik, dan OpenAI belum menerbitkan rubriknya atau bagaimana mereka mengkalibrasi penilainya. Anda tidak bisa menjalankannya ulang.
- Tolok ukur ini hanya menilai model OpenAI. Tidak ada Claude, Gemini, atau model open-weight yang muncul, jadi ini tidak mengatakan apa pun tentang bagaimana GPT-6.1 Sol dibandingkan dengan Claude Sonnet 5.5 atau perbandingan lintas vendor lainnya.
- Versi berbobot ada di suatu tempat. Grafiknya menyebut "No WTP weighting", WTP berarti willingness to pay (kesediaan membayar). Itu menyiratkan OpenAI menghitung atau mempertimbangkan varian yang dibobot berdasarkan berapa yang mau dibayar orang untuk setiap tugas, dan tidak menerbitkannya.
- Kartu contohnya dipilih secara manual. Lima kartu di halaman itu mendapat skor 90.4% hingga 100%. Rata-rata 169 tugas untuk model terbaik adalah 80.6%. Contoh-contoh itu menunjukkan hari-hari terbaik tolok ukur, bukan hari biasanya.
Semua ini tidak membuat LifeVal salah. Ini menjadikannya tolok ukur dari vendor. Bacalah seperti Anda membaca grafik peluncuran apa pun: sebagai klaim yang bisa Anda uji pada tugas Anda sendiri.
Jalankan uji reasoning effort Anda sendiri dengan Apidog CLI
Tabel per-effort LifeVal adalah kurva reward versus biaya. Anda bisa menggambar kurva yang sama untuk prompt Anda sendiri. Alih-alih mengirim permintaan secara manual, serahkan pekerjaannya kepada coding agent Anda dan biarkan ia menjalankan Apidog CLI.
Pasang CLI-nya, masuk, dan tambahkan skill Apidog ke agen Anda:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt kepada Claude Code, Codex, atau Cursor:
In Apidog project <projectId>, add a POST https://api.openai.com/v1/responses
endpoint that sends {{model}}, reasoning.effort = {{effort}} and my test prompt.
Create a test case that asserts status 200 and saves latency,
usage.output_tokens and usage.output_tokens_details.reasoning_tokens.
Add a test data set with effort = low, medium, high, xhigh, run the case
once per row against environment <envId>, and give me a table of
latency, tokens and estimated cost per effort.
Agen membaca setiap skema payload, memvalidasi JSON-nya, lalu menjalankan:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json

apidog test-case category --project <projectId>
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json

apidog cli-schema validate test-data-create --file efforts.json
apidog test-data create --project <projectId> --file efforts.json

apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d <testDataId> -r cli,json --out-dir ./effort-runs
Flag -d menjalankan satu iterasi per baris data, dan -r cli,json memberi agen laporan JSON untuk membangun tabel. Tambahkan --upload-report jika Anda ingin menelusuri hasil run di aplikasi Apidog setelahnya. Referensi perintah apidog run mencantumkan setiap flag, dan panduan penyiapan Claude Code membahas sisi agennya.
Jalankan pada lima atau sepuluh prompt asli Anda, bukan satu. LifeVal merata-ratakan 169 tugas karena suatu alasan: satu prompt akan memberi tahu Anda lebih banyak tentang varians daripada tentang effort.
Haruskah Anda mempercayai LifeVal saat memilih model?
Gunakan untuk arah, bukan keputusan. LifeVal memberi tahu Anda tiga hal yang bisa Anda tindak lanjuti: model-model OpenAI menjadi jauh lebih baik dalam tugas sehari-hari multi-langkah antara Desember 2025 dan Maret 2026, keuntungan sejak itu kecil, dan reasoning effort di atas high jarang sepadan untuk pekerjaan semacam ini.
Yang tidak bisa diberitahukannya adalah bagaimana skor model non-OpenAI, bagaimana tugas Anda dibandingkan dengan 169 tugas OpenAI, atau apa yang diberi reward oleh penilainya. Untuk itu, jalankan sweep effort Anda sendiri, seperti di atas, dan bandingkan angka yang bisa Anda lihat. Uji langsung GPT-6 Astra kami adalah titik awal untuk jenis pemeriksaan yang layak dijalankan.
FAQ
LifeVal adalah singkatan dari apa?
OpenAI tidak menjabarkan namanya di halaman itu. Ini adalah evaluasi ("Val") atas tugas kehidupan sehari-hari ("Life"): 169 skenario agentic di bidang pengasuhan, kesehatan, pendidikan, administrasi rumah tangga, keuangan pribadi, belanja, dan layanan pemerintah.
Berapa skor LifeVal GPT-6 Astra?
80.6% rata-rata reward pada effort xhigh, pengaturan yang digunakan OpenAI di blog peluncuran Astra. Pada effort max, Astra mendapat 82.5%, dan pada high mendapat 80.7%.
Bisakah saya menjalankan LifeVal sendiri?
Tidak. OpenAI belum merilis kumpulan tugas, rubrik, atau penilainya. Anda bisa meniru analisis effort-versus-cost-nya pada prompt Anda sendiri dengan test harness seperti Apidog CLI, tetapi Anda tidak bisa mereproduksi skor LifeVal.
Apakah LifeVal mencakup Claude atau Gemini?
Tidak. Kedua grafik hanya mencakup model OpenAI, dari GPT-5.2 hingga GPT-6 Astra. GPT-6.1 Sol dan GPT-6.1 Terra juga tidak ada.
Apakah kolom biaya LifeVal dalam dolar?
OpenAI menyebutnya biaya API tetapi tidak menyatakan satuannya. Gunakan untuk membandingkan pengaturan satu sama lain, misalnya GPT-5.6 max pada 9.65 versus Astra max pada 20.04, bukan sebagai angka dolar per tugas.
Reasoning effort mana yang harus saya gunakan untuk tugas agen sehari-hari?
Pada LifeVal, medium atau high menangkap sebagian besar keuntungannya. GPT-6 Astra mendapat 80.7% pada high dan 80.6% pada xhigh, jadi ujilah medium dan high pada tugas Anda sendiri sebelum membayar lebih.