
Grok 4.6 adalah model bahasa canggih xAI, yang dirilis pada 12 Agustus 2026. Ini dibangun di atas Grok 4.5 dengan fokus pada agen yang berjalan lama, pengkodean agentik, dan pekerjaan interaktif atau visual, menawarkan jendela konteks 500.000 token dengan harga $2 per juta token input dan $6 per juta token output. Pada Indeks Kecerdasan Analisis Buatan, model ini mencetak 61, menyamai GPT-5.6 Sol dari OpenAI dan selisih satu poin di belakang Claude Fable 5 dari Anthropic, menjadikannya model termurah yang saat ini berada di garis depan kecerdasan.
Itulah jawaban satu paragraf. Sisa dari postingan ini mencakup apa saja yang sebenarnya berubah dari Grok 4.5, apa arti angka tolok ukur, di mana Anda dapat menggunakan model ini hari ini, dan apa artinya bagi Anda jika Anda membangun aplikasi menggunakan API LLM. Jika bagian terakhir itu adalah Anda, Apidog memberi Anda ruang kerja gratis untuk merancang, menguji, dan mensimulasikan panggilan API LLM, berguna untuk mencoba Grok 4.6 tanpa harus menulis klien terlebih dahulu.
tombol
TL;DR
- Dirilis: 12 Agustus 2026, oleh xAI.
- Fokus: agen dengan horizon panjang, pengkodean multi-langkah, pekerjaan interaktif dan visual. xAI mengatakan model ini lebih sering melakukan pengujian mandiri dan memverifikasi pekerjaannya sendiri sebelum melanjutkan.
- Spesifikasi: jendela konteks 500K, batas pengetahuan 1 Februari 2026.
- Harga: $2 / 1 juta input, $6 / 1 juta output. Varian yang lebih cepat berharga 2x lipat. Minggu pertama dilengkapi dengan penggunaan 2x lipat yang termasuk dalam Grok Build dan Cursor.
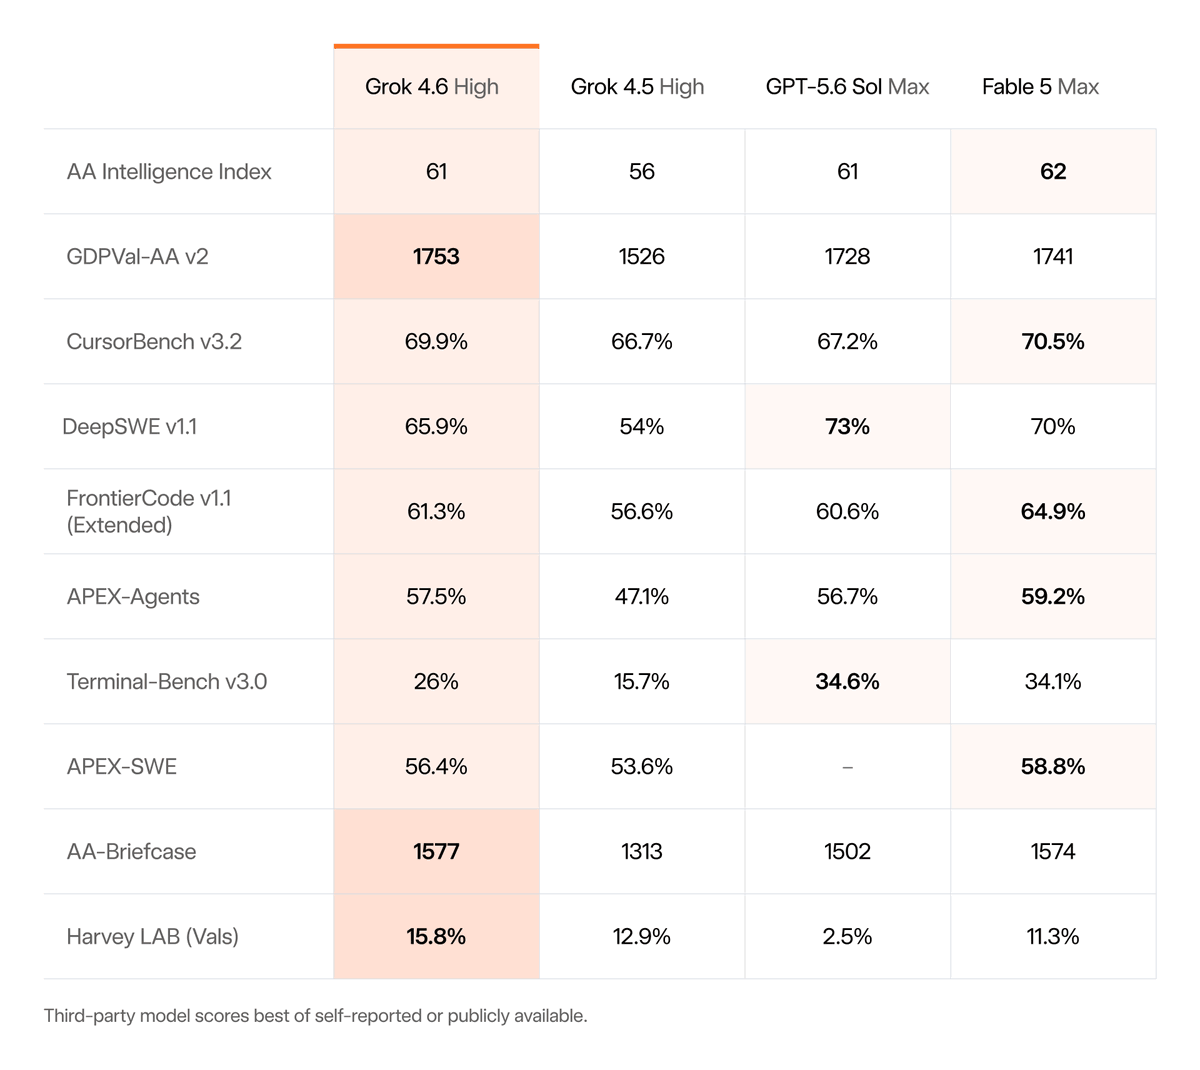
- Tolok ukur: Indeks Kecerdasan 61 (menyamai GPT-5.6 Sol), peningkatan besar dibandingkan 4.5 pada DeepSWE (54 → 65.9) dan APEX-Agents (47.1 → 57.5).
- Tempat menggunakannya: xAI API, Grok Build, Cursor, OpenRouter, Vercel, dan Cloudflare.
Grok 4.6 Sekilas
| Spesifikasi | Grok 4.6 |
|---|---|
| Pengembang | xAI |
| Tanggal rilis | 12 Agustus 2026 |
| Jendela konteks | 500.000 token |
| Batas pengetahuan | 1 Februari 2026 |
| Harga input / output | $2 / $6 per 1 juta token |
| Varian cepat | Harga 2x lipat |
| Indeks Kecerdasan | 61 (GPT-5.6 Sol: 61, Claude Fable 5: 62) |
| Ketersediaan | xAI API, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
Apa yang Sebenarnya Baru Dibandingkan Grok 4.5
Grok 4.6 bukanlah pengungkapan arsitektur, melainkan cerita pelatihan. Menurut xAI, model ini menjalani pelatihan tambahan yang lebih lama daripada Grok 4.5, dengan tiga bahan yang melakukan pekerjaan berat:
- Data yang dihasilkan model yang dikurasi menargetkan penalaran dan konsep teknis tingkat lanjut.
- Kumpulan data rekayasa berkualitas tinggi, melanjutkan diet padat pengkodean yang dimulai ketika xAI mulai melatih pada sesi pengembangan nyata.
- Optimizer dan resep pelatihan yang ditingkatkan, dengan lintasan fine-tuning yang diawasi diregenerasi di seluruh area penalaran dan domain-spesifik.
Perubahan perilaku yang akan diperhatikan pengembang adalah verifikasi mandiri. Selama menjalankan agen yang panjang, Grok 4.6 memeriksa pekerjaannya sendiri sebelum pindah ke langkah berikutnya, menjalankan tes yang baru saja ditulisnya, membaca ulang file yang baru saja dieditnya, alih-alih bergerak maju berdasarkan asumsi yang tidak diverifikasi. xAI juga melaporkan percobaan pertama yang lebih kuat pada proyek interaktif dan visual: dashboard, aplikasi kecil, dan pekerjaan UI keluar lebih dekat ke yang dapat digunakan pada percobaan pertama.
Jika pendekatan pelatihan Grok 4.5 menarik bagi Anda, analisis kami tentang apa arti pelatihan sesi Cursor bagi pengembang mencakup garis keturunan yang dibangun model ini.
Tolok Ukur, dengan Perbedaan yang Signifikan
Angka peluncuran vendor patut dicurigai, tetapi perbedaan dari 4.5 ke 4.6 cukup besar untuk menjadi berarti. Berikut adalah gambaran, termasuk posisi kompetisi:
Tiga poin penting:
- Kesenjangan agen tertutup. Lompatan 10,4 poin pada APEX-Agents memindahkan Grok dari "jelas tertinggal" menjadi dalam jarak 1,7 poin dari Fable 5 Max, dan sedikit di atas GPT-5.6 Sol Max (56,7%).
- Pengkodean skala repositori meningkat paling banyak. Kenaikan DeepSWE hampir 12 poin adalah perbedaan antara model yang tersandung pada perubahan multi-file dan model yang bersaing, meskipun Sol Max masih memimpin tolok ukur itu dengan margin yang lebar.
- Angka independen mendukung cerita tersebut. Analisis Buatan mengukur biaya rata-rata $0,84 per tugas dalam evaluasi agennya, yang terendah di antara model tingkat frontier, dan Elo 1753 pada GDPval-AA v2 untuk pekerjaan pengetahuan profesional.
Untuk konteks tentang cara membaca rilis tolok ukur xAI, dan peringatan yang berlaku pada generasi sebelumnya juga, lihat analisis tolok ukur Grok 4.5 kami.
Harga: Penawaran Nilai Terbaik dari yang Tercanggih
Grok 4.6 mempertahankan harga Grok 4.5: $2 per juta token input, $6 per juta token output. Dibandingkan dengan model yang kini menjadi tolok ukurnya, terdapat perbedaan yang mencolok:
| Model | Harga output / 1 juta token |
|---|---|
| Grok 4.6 | $6 |
| Claude Opus 4.8 | $25 |
| GPT-5.6 Sol | $30 |
Itu perbedaan 5x lipat pada sisi output dibandingkan GPT-5.6 Sol untuk model yang menyamainya pada indeks kecerdasan komposit. Token murah tidak secara otomatis berarti tugas murah, proses yang lebih lemah yang membutuhkan peninjauan dan perbaikan akan lebih mahal daripada biaya tokennya, tetapi data biaya per tugas independen menunjukkan bahwa efisiensi itu nyata, bukan hanya harga stiker yang rendah.
Varian yang lebih cepat dengan harga 2x ($4/$12) ditujukan untuk penggunaan interaktif yang sensitif terhadap latensi. Dan hingga 19 Agustus, pengguna Grok Build dan Cursor mendapatkan penggunaan 2x lipat untuk menguji model tersebut.
Di Mana Anda Bisa Menggunakan Grok 4.6 Hari Ini
- xAI API melalui console.x.ai, kompatibel dengan OpenAI. Panduan API Grok 4.5 kami berlaku langsung; cukup ubah nama modelnya.
- Cursor, tersedia sebagai opsi model; Cursor menerbitkan catatan peluncurannya sendiri bersama dengan xAI.
- Grok Build, ruang kerja agentik milik xAI, dengan bonus penggunaan 2x lipat selama minggu peluncuran.
- OpenRouter, Vercel, dan Cloudflare, untuk tim yang merutekan beberapa model melalui satu gateway; terdaftar sebagai
x-ai/grok-4.6di OpenRouter.
Tidak ada peluncuran konsumen terpisah yang perlu diuraikan di sini: ini adalah rilis yang mengutamakan pengembang, dan cara tercepat untuk mengevaluasinya adalah melalui API atau IDE yang sudah mendukungnya.
Keterbatasan dan Pertanyaan Terbuka
Penilaian minggu peluncuran berhutang kepada Anda peringatan di samping angka-angka utama:
- Tolok ukur sebagian besar dilaporkan oleh vendor. Artificial Analysis telah menerbitkan skor independen yang secara luas setuju, tetapi angka pengkodean spesifik (DeepSWE, FrontierCode, CursorBench) berasal dari tabel peluncuran xAI sendiri. Angka peluncuran Grok 4.5 hanya sebagian terbukti benar di bawah pengujian independen; asumsikan beberapa regresi ke rata-rata di sini juga.
- Jendela konteks adalah yang terkecil di garis depan. 500K token mencakup sebagian besar beban kerja nyata, tetapi GPT-5.6 Sol menawarkan 1,05M dan Claude Fable 5 menawarkan 1M. Jika Anda memproses seluruh monorepos atau kumpulan dokumen besar dalam satu panggilan, kesenjangan itu signifikan.
- Sol masih memimpin di bagian tersulit. Defisit DeepSWE 7 poin berarti pekerjaan yang sepenuhnya otonom di seluruh codebase besar yang sudah ada tetap lebih kuat pada GPT-5.6 Sol Max, dan itu adalah beban kerja agen yang paling berharga secara ekonomi.
- Kematangan ekosistem tertinggal. Pemrosesan batch, tingkatan caching prompt, dan kontrol penggunaan pada platform xAI lebih muda daripada padanan OpenAI dan Anthropic. Kompatibilitas OpenAI menutupi sebagian besar, tetapi tidak semuanya.
Tidak ada satupun dari ini yang mendiskualifikasi. Mereka mendefinisikan di mana Grok 4.6 cocok: opsi harga-kinerja yang Anda evaluasi secara serius, bukan default yang Anda adopsi berdasarkan reputasi.
Apa Artinya bagi Pengembang API
Bacaan strategisnya: garis depan kini memiliki pesaing harga yang asli. Hingga rilis ini, pencapaian output tingkat GPT-5.6 Sol berarti membayar $25–30 per juta token output. Grok 4.6 melakukannya seharga $6, yang mengubah perhitungan terutama pada loop agen; agen yang melakukan 40 panggilan model per tugas akan langsung merasakan perbedaan harga output 5x lipat.
Secara praktis, API yang kompatibel dengan OpenAI berarti mengevaluasinya membutuhkan waktu sore, bukan sprint. Arahkan klien Anda yang sudah ada ke `https://api.x.ai/v1`, jalankan beban kerja Anda yang sebenarnya melawannya, dan bandingkan. Siapkan perbandingan itu di Apidog dan Anda dapat menyimpan permintaan GPT-5.6, Claude, dan Grok 4.6 secara berdampingan dalam satu proyek, dengan lingkungan per penyedia dan asersi yang memeriksa kualitas output, penggunaan token, dan latensi di ketiga model tersebut, bukti yang berguna sebelum Anda menyerahkan beban kerja produksi ke salah satunya.
Fokus model pada agen juga meningkatkan taruhan pada kebenaran panggilan alat. Jika integrasi Grok Anda melibatkan panggilan fungsi, uji payload yang dihasilkannya, bukan hanya teks yang ditulisnya.
FAQ
Apa itu Grok 4.6 dalam satu kalimat? Model canggih xAI bulan Agustus 2026, disetel untuk agen yang berjalan lama dan pengkodean, dengan jendela konteks 500K dan skor tolok ukur tingkat canggih dengan harga sekitar seperlima dari harga output pesaing.
Apakah Grok 4.6 lebih baik dari GPT-5.6? Keduanya seri pada Indeks Kecerdasan Artificial Analysis dengan skor 61. GPT-5.6 Sol Max unggul dalam pengkodean skala repositori (DeepSWE); Grok 4.6 sedikit unggul pada APEX-Agents dan biayanya sekitar 5x lebih murah per token output.
Apa perbedaan antara Grok 4.5 dan 4.6? Harga yang sama, API yang sama, model yang secara signifikan lebih baik: +11,9 poin pada DeepSWE, +10,4 pada APEX-Agents, dan kecenderungan baru untuk melakukan verifikasi mandiri selama tugas-tugas panjang.
Bisakah saya mencoba Grok 4.6 secara gratis? Grok Build dan Cursor menyertakan penggunaan 2x lipat selama minggu peluncuran, dan metode dalam panduan kami untuk menggunakan Grok 4.5 secara gratis sebagian besar berlaku untuk 4.6.