
GPT-Live-1.1 adalah model suara full-duplex dari OpenAI, tersedia di API sejak 20 November 2026. Model ini mendengarkan sambil berbicara, menyerahkan penalaran dan pemanggilan tool ke model backend pilihan Anda, dan ditagih per menit: $0,05 per menit aktif dan $0,02 per menit standby. Anda mengaksesnya melalui satu endpoint, v1/live/sessions, bukan melalui Realtime API.
Artikel kami sebelumnya tentang apa itu GPT-Live membahas fitur suara ChatGPT sebelum pengembang bisa memanggilnya. Panduan ini membahas model API-nya: apa saja yang baru, berapa biayanya, bagaimana sesi bekerja, dan bagaimana perbandingannya dengan GPT-Realtime.
Apa itu GPT-Live-1.1?
GPT-Live-1.1 adalah model suara yang menjaga percakapan lisan berjalan secara real time sementara model backend terpisah melakukan penalaran. Model ini menerima audio dan teks, mengembalikan audio dan teks, serta terus mendengarkan sambil berbicara, sehingga penelepon bisa menyela atau menambahkan detail di tengah kalimat. ID modelnya adalah gpt-live-1.1, dan mendukung streaming serta function calling.
Halaman model GPT-Live-1.1 menyebutnya sebagai “Model suara full-duplex untuk percakapan multibahasa.” Full duplex berarti audio mengalir dua arah secara bersamaan, seperti panggilan telepon, bukan seperti walkie-talkie yang sisi lainnya harus menunggu.
Bagian lain dari desainnya adalah delegasi. GPT-Live memutuskan kapan sebuah permintaan membutuhkan pekerjaan yang sesungguhnya, mengirimkannya ke backend (model Responses dari OpenAI atau agent milik Anda sendiri), tetap berbicara selama backend berjalan, lalu menjelaskan hasilnya secara lisan.
Apa yang berubah dari GPT-Live-1
GPT-Live-1.1 mempertahankan endpoint, harga, dan set fitur yang sama seperti GPT-Live-1. Perubahannya terletak pada kualitas suara dan penanganan tugas. Berikut yang OpenAI cantumkan di dokumentasi model dan dalam pengumumannya di X:
| Area | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| Transkripsi ucapan | Dasar | Lebih akurat, menurut halaman model |
| Aksen dan suara lintas bahasa | Dasar | Lebih konsisten, menurut halaman model |
| Sesi menganggur | Tarif standby tercantum di halamannya | Standby diumumkan sebagai opsi baru, $0,02/menit |
| Penyelesaian tugas | Dasar | “Menyelesaikan tugas dengan lebih andal lagi,” menurut pengumuman OpenAI |
| Endpoint | v1/live/sessions |
v1/live/sessions |
| Harga (aktif) | $0,05/menit | $0,05/menit |
| Batas rate limit | Sesi konkuren | Batas sesi konkuren terpisah |
OpenAI belum mempublikasikan angka benchmark untuk peningkatan transkripsi maupun keandalan, jadi anggap itu sebagai klaim vendor sampai Anda mengukurnya sendiri. Selain itu, pengumuman OpenAI menyebut standby sebagai fitur baru pada rilis ini, sementara halaman GPT-Live-1 kini juga mencantumkan tarif standby $0,02 yang sama.
Kedua model berbagi endpoint dan harga yang sama, jadi beralih cukup dengan mengatur model sesi ke gpt-live-1.1. Jalankan kembali eval suara Anda sendiri setelahnya untuk memastikan peningkatan pada trafik Anda.
Harga GPT-Live-1.1
GPT-Live-1.1 menagih sesi suara berdasarkan durasi, bukan berdasarkan token. Berikut tarif yang tercantum di halaman harga OpenAI, dicek pada 20 November 2026:
| Metrik | Harga |
|---|---|
| Waktu sesi aktif | $0,05 per menit |
| Waktu sesi standby | $0,02 per menit |
| Model backend dan tool | Ditagih terpisah dengan tarif normal model tersebut |
Beberapa detail penagihan penting saat Anda memperkirakan biaya:
- Penagihan per detik. Durasi tidak dibulatkan ke menit penuh berikutnya.
- Standby hanya untuk WebRTC. Tarif lebih rendah berlaku untuk sesi WebRTC saat inferensi dijeda.
- Biaya inisialisasi. Pembuatan sesi WebRTC ditagih 15 detik selama setup, yang dikreditkan terhadap biaya durasi setelah sesi berjalan.
- Backend adalah tagihan kedua. Token Responses yang didelegasikan dan pemanggilan tool juga ditagih.
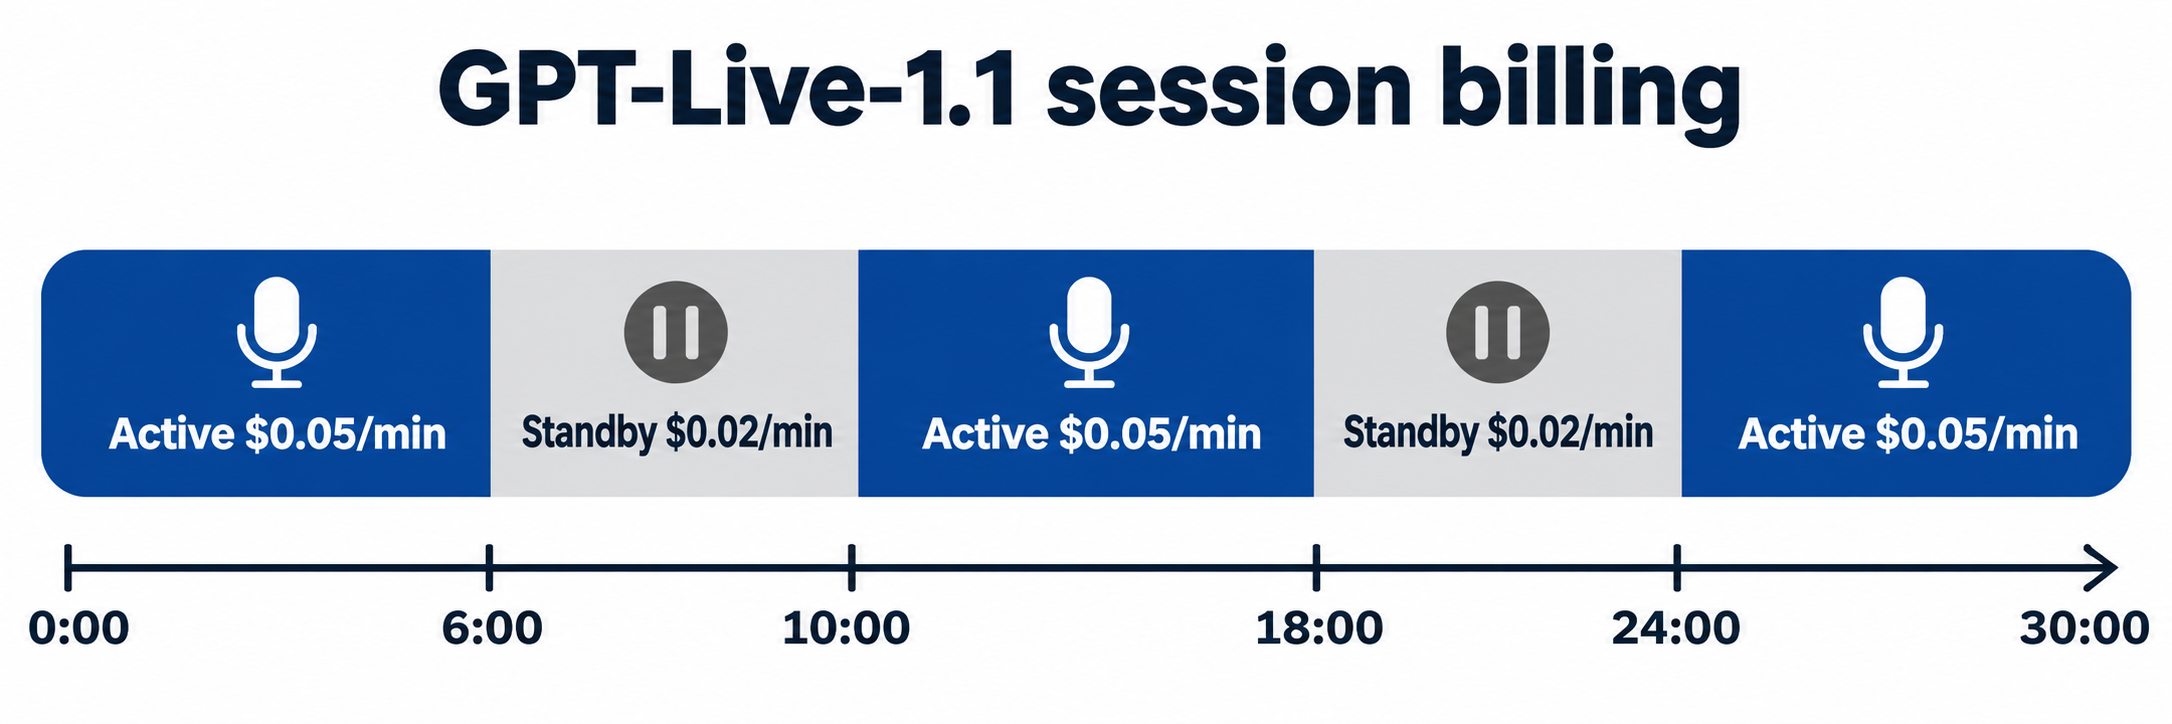
Contoh perhitungan dari timeline di atas: sesi dukungan selama 30 menit menghabiskan 20 menit dalam kondisi aktif dan 10 menit standby selagi penelepon mencari sesuatu. Biaya suara: 20 x $0,05 + 10 x $0,02 = $1,20. Tanpa standby, sesi yang sama ber biaya 30 x $0,05 = $1,50. Tambahkan apa pun yang dikeluarkan model backend untuk tugas-tugas yang didelegasikan kepadanya.
Cara kerja GPT-Live-1.1: suara plus delegasi
Aplikasi GPT-Live memiliki dua bagian. Panduan memulai membaginya seperti ini:
- GPT-Live menangani percakapan. Ia mendengarkan, berbicara, dan memutuskan kapan harus meminta bantuan backend. Anda memberinya prompt singkat tentang gaya berbicara dan kapan harus mendelegasikan.
- Backend menangani tugas yang didelegasikan. Ia menalar, memanggil tool, dan mengembalikan hasil untuk diucapkan GPT-Live. Instruksi terperinci, aturan bisnis, dan alur kerja tool berada di sini.
- Aplikasi Anda mengendalikan bagian yang berisiko. Ia memeriksa izin akses, mengumpulkan konfirmasi, menjalankan fungsi yang menyentuh sistem Anda, dan menyimpan progres tugas.
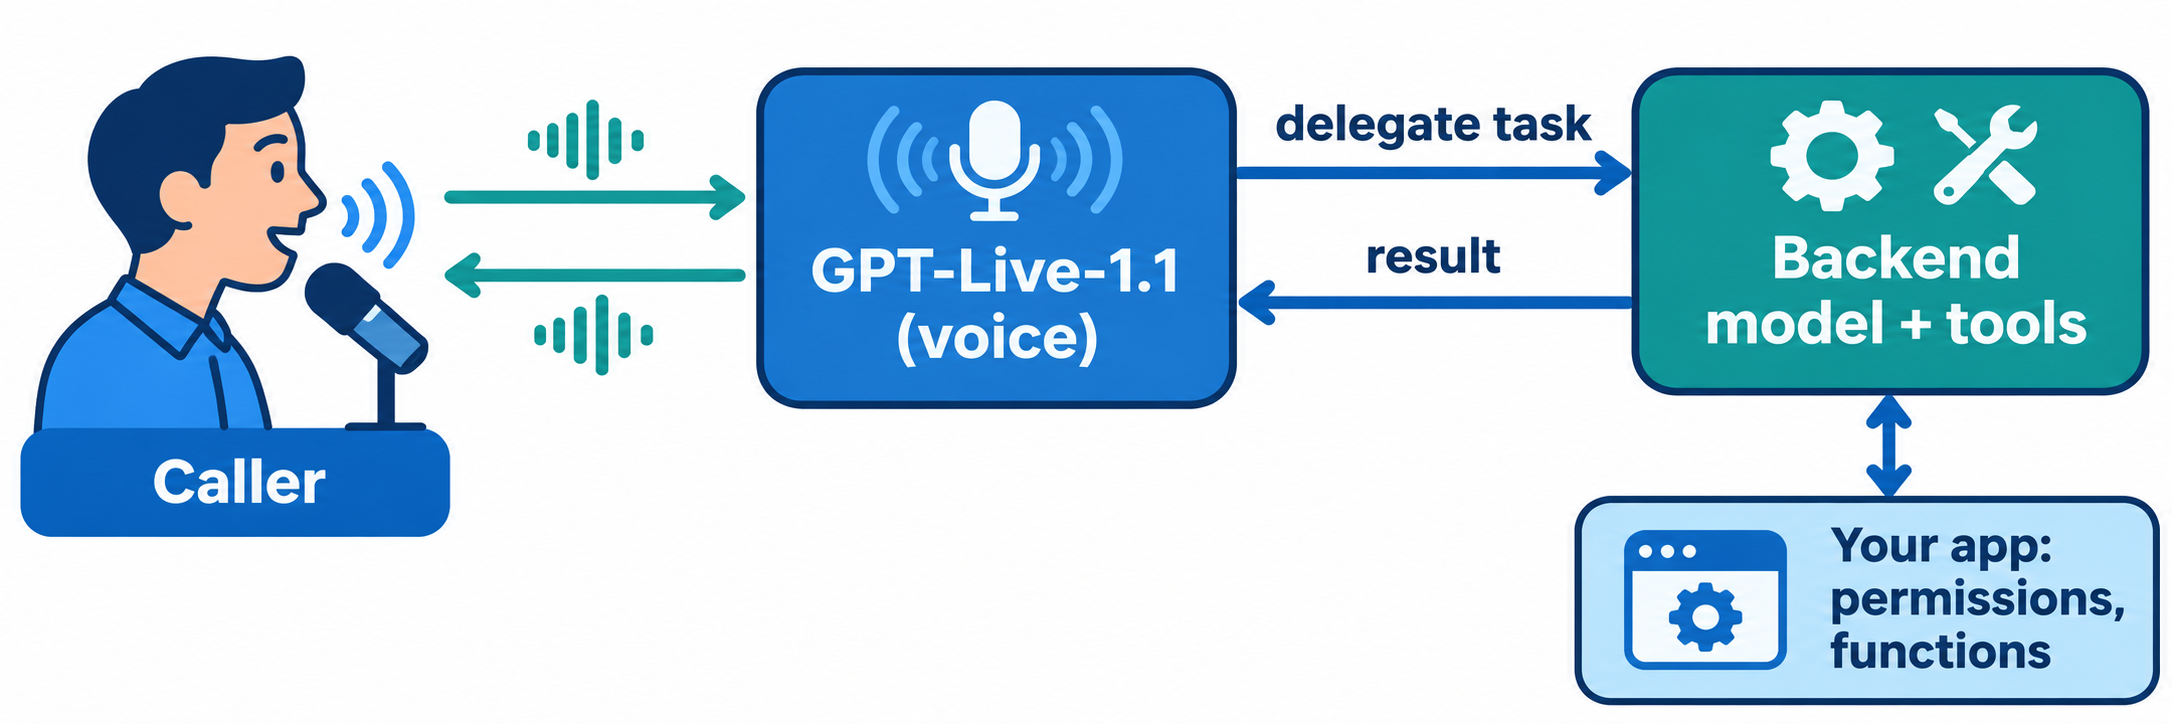
Anda memilih salah satu dari dua mode delegasi saat membuat sesi, dan tidak bisa mengganti mode di tengah sesi:
| Mode | Siapa yang menjalankan backend | Pilih ini saat |
|---|---|---|
| Delegasi Responses | OpenAI memanggil model Responses yang Anda konfigurasikan dan meneruskan konteks serta hasil | Anda ingin GPT-Live mengelola permintaan backend untuk Anda |
| Delegasi klien | Aplikasi Anda menjalankan model, agent, atau layanan apa pun dan mengirimkan hasilnya kembali | Anda perlu memvalidasi, menyensor, atau menggabungkan hasil, atau menggunakan backend non-OpenAI |
Panduan delegasi menyarankan untuk memulai dengan delegasi Responses. Delegasi klien cocok untuk tim yang menambahkan suara di depan agent teks yang sudah ada.
Buat sesi GPT-Live-1.1 pertama Anda
GPT-Live memiliki endpoint tersendiri. Halaman model mencantumkan v1/live/sessions sebagai didukung dan menandai Chat Completions, Responses, serta v1/realtime sebagai tidak didukung. OpenAI merekomendasikan WebRTC untuk audio, dengan WebSockets dan SIP sebagai alternatif.
Alur WebRTC dari quickstart berjalan dalam lima langkah:
- Browser meminta akses mikrofon dan menambahkan track-nya ke peer connection.
- Ia membuat data channel, lalu membuat SDP offer.
- Browser mengirim offer tersebut ke server Anda.
- Server Anda mengirim
sessiondantransport: { type: "webrtc", sdp }kePOST /v1/live/sessionsdengan API key Anda. - Browser menerapkan SDP answer yang dikembalikan dan menunggu
session.started.
Berikut panggilan server dari contoh TypeScript OpenAI, dipangkas ke konfigurasi sesinya:
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
Simpan API key di server, dan jangan kirim session.start melalui data channel: permintaan HTTP sudah memulai sesi. OpenAI juga menyediakan OpenAI Live Console, aplikasi contoh lokal untuk mengamati percakapan, delegasi, dan aktivitas tool backend.
Mode standby: pangkas biaya saat menganggur
Standby menjaga koneksi WebRTC tetap terbuka saat tidak ada yang berbicara, lalu melanjutkan inferensi ketika seseorang mulai berbicara. Koneksi dan ID sesi tetap sama, dan riwayat percakapan kembali saat sesi dilanjutkan.
Anda mengaktifkannya dengan dua field sesi:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"menunggu adanya ucapan sebelum memulai inferensi.idle_timeout_smenerima bilangan bulat dari 5 hingga 60. Setelah sekian detik tanpa transkrip input maupun output, sesi turun ke standby.vad_thresholdberkisar dari 0 hingga 1 dengan default 0,5. Nilai yang lebih tinggi membutuhkan bukti ucapan yang lebih kuat untuk terbangun.
Dengarkan session.paused dan session.resumed untuk melacak status, dan jaga track mikrofon tetap aktif. Satu trade-off dari panduan manajemen sesi: balasan pertama terhadap ucapan singkat setelah standby mungkin membutuhkan waktu lebih lama. Untuk jeda yang panjang, menutup sesi dan memulai sesi baru bisa lebih murah daripada standby.
GPT-Live-1.1 vs GPT-Realtime
Panduan voice agents dari OpenAI membingkai pilihan ini berdasarkan arsitektur. GPT-Live cocok untuk percakapan full-duplex dengan backend terpisah. Realtime API cocok untuk satu model yang mendengar, menalar, memanggil tool, dan berbicara dalam satu sesi.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| Desain | Frontend suara plus backend yang didelegasikan | Satu model speech-to-speech |
| Input | Audio, teks | Teks, audio, gambar |
| Penagihan | $0,05/menit aktif, $0,02/menit standby | Per token: $32 masuk, $64 keluar per 1M token audio |
| Biaya backend | Ditagih terpisah | Sudah termasuk dalam harga token |
| Paling cocok untuk | Menambahkan suara ke agent teks yang sudah ada | Voice agent yang berdiri sendiri |
Penagihan per menit membuat biaya suara GPT-Live mudah diprediksi untuk panggilan panjang. Penagihan token pada Realtime mengikuti seberapa banyak audio dan teks yang mengalir, dan menyatukan penalaran dalam satu harga. Untuk melihat lebih dalam perbandingan sebelumnya, baca GPT-Live vs GPT-Realtimepanduan GPT-Realtime-2 API kami.
Rate limit dan akses
Limit GPT-Live dihitung berdasarkan sesi konkuren, bukan token. GPT-Live-1.1 dan GPT-Live-1 memiliki limit terpisah yang berlaku di seluruh wilayah inferensi. Halaman GPT-Live-1 mencantumkan 50 sesi konkuren di tier Build, 300 di Launch, dan 500 di Grow, serta menandai tier Free sebagai tidak didukung. Halaman GPT-Live-1.1 belum mempublikasikan tabelnya sendiri, jadi periksa halaman limit organisasi Anda sebelum merencanakan beban kerja.
Uji server sesi Anda dengan Apidog CLI
Integrasi GPT-Live Anda memiliki permukaan HTTP milik Anda sendiri: endpoint /api/session yang bertukar SDP offer. Contoh OpenAI mengembalikan 403 untuk origin yang tidak diharapkan dan 400 untuk SDP offer yang hilang. Jalur-jalur tersebut tidak pernah sampai ke OpenAI, jadi Anda bisa mengujinya di setiap commit tanpa biaya suara. Biarkan coding agent Anda menulis dan menjalankan pengujian dengan Apidog CLI.
Instal CLI-nya, login, dan tambahkan skill Apidog ke agent Anda:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt ke agent Anda:
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
Agent akan membaca schema, memvalidasi payload-nya, membuat endpoint dan test case, lalu menjalankannya:
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
apidog run yang sama dengan -r junit bisa langsung dipakai di CI; lihat menjalankan Apidog CLI dalam pipeline CI/CD. Jika Anda menggunakan Claude Code, panduan Apidog CLI di Claude Code menjelaskan proses setup-nya. Paket Free Apidog mencakup tim hingga 4 pengguna.
FAQ
Apakah GPT-Live-1.1 tersedia di API? Ya. OpenAI membuat GPT-Live-1.1 tersedia di API pada 20 November 2026, dengan model ID gpt-live-1.1 di endpoint v1/live/sessions. Artikel GPT-Live API kami sebelumnya dibuat sebelum rilis tersebut.
Berapa biaya GPT-Live-1.1? $0,05 per menit aktif dan $0,02 per menit standby, ditagih per detik. Penggunaan model backend dan tool ditagih terpisah dengan tarif normalnya.
Apa perbedaan antara GPT-Live-1 dan GPT-Live-1.1? GPT-Live-1.1 mentranskripsi ucapan lebih akurat, menjaga aksen dan suara yang lebih konsisten lintas bahasa, serta menambahkan opsi standby untuk sesi yang menganggur. Harga dan endpoint-nya sama.
Apakah GPT-Live-1.1 bisa melihat gambar? Tidak secara langsung. Kirim gambar ke model backend yang mendukung vision, yang mengembalikan teks untuk digunakan GPT-Live.
Apakah GPT-Live-1.1 mendukung function calling? Ya. Halaman model mencantumkan streaming dan function calling. Dalam praktiknya, backend Anda menangani pemanggilan tool melalui delegasi, dan aplikasi Anda menjalankan fungsi kustom apa pun.