
Tingkat termurah dalam keluarga model dulunya adalah tingkat yang tidak Anda percayai. Anda mengirimkan lalu lintas klasifikasi, ringkasan, dan coba ulang ke sana, menyimpan apa pun yang bersifat agentic pada model unggulan, dan menerima bahwa model anggaran akan gagal saat tugas membutuhkan lebih dari satu langkah.
GPT-6 Luna, diumumkan pada 22 September 2026, dihargai seperti tingkat tersebut namun tidak berperilaku demikian. Harganya $0.10 per juta token input dan $0.50 per juta token output, memiliki jendela konteks 1 juta token, dan angka yang diterbitkan OpenAI menempatkannya dalam jangkauan model perbatasan pada tolok ukur pengkodean agentic dengan biaya per tugas yang sangat kecil dibandingkan model-model tersebut.
Satu hal yang perlu diselesaikan terlebih dahulu: ini bukan GPT-5.6 Luna yang mungkin sudah Anda masukkan ke dalam rantai cadangan. Nama tingkat yang sama, model baru, harga baru, jendela konteks baru. Beranggapan sebaliknya adalah cara mudah untuk mengirimkan perubahan perilaku yang senyap dan baru mengetahuinya dari tiket dukungan.
Sekilas tentang GPT-6 Luna
| Item | Nilai |
|---|---|
| ID Model API | gpt-6-luna |
| Harga input | $0.10 per juta token |
| Harga output | $0.50 per juta token |
| Pembacaan input yang di-cache | Diskon 90% |
| Jendela konteks | 1.000.000 token |
| Indeks Intelijen Analisis Buatan | 37 |
| Diumumkan | 22 September 2026, bersamaan dengan GPT-6 Sol |
| Tersedia di | ChatGPT Work dan Codex, aplikasi desktop untuk pengguna Gratis dan Go, ditambah API |
| Tidak tersedia di | Chat, sejak peluncuran |
Dalam keluarga yang sama, GPT-6 Sol berharga $2/$10 dengan jendela 872.000 token dan indeks 48, dan GPT-6 Astra berharga $10/$50. OpenAI menyatakan bahwa Astra “terus menjadi model terbaik kami secara keseluruhan,” jadi Luna tidak dijual sebagai model terpintar. Ini dijual sebagai model di mana biaya per tugas runtuh.
Ini adalah model baru, bukan tingkat yang diganti namanya
Keluarga GPT-5.6 adalah Sol, Terra, dan Luna. Keluarga GPT-6 adalah Astra, Sol, dan Luna. Dua nama dipertahankan, Terra tidak, dan Astra adalah nama baru. OpenAI menjelaskan Sol dan Luna dilatih dengan metode yang mirip dengan GPT-6 Astra, yang berarti mereka adalah model baru yang berbagi konvensi penamaan dengan model lama.
Tidak ada GPT-6 Terra. Jika Anda membangun tangga routing berdasarkan skema penamaan GPT-5.6, anak tangga tengah tidak ada lagi, dan perbandingan kami sebelumnya antara Sol versus Terra dan Luna sekarang dibaca sebagai sejarah daripada panduan saat ini.
Silsilah harga menunjukkan seberapa jauh tingkat tersebut bergerak:
| Tingkat | Daftar GPT-5.6 | Promosi GPT-5.6 | GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | tidak ada GPT-6 Terra |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
Semua angka adalah per juta token input dan per juta token output. Baris GPT-5.6 berasal dari liputan kami pada saat itu, harga GPT-5.6 dan pemotongan harga GPT-5.6.
OpenAI menjelaskan Sol dan Luna 50% lebih murah dari harga promosi GPT-5.6. Kata promosi adalah milik OpenAI sendiri dan itu mengubah arti klaim: perbandingan dilakukan terhadap tarif diskon, bukan tarif peluncuran GPT-5.6. Diukur terhadap harga daftar GPT-5.6 Luna sebesar $1/$6, GPT-6 Luna seharga $0.10/$0.50 adalah pemotongan 90% pada input dan pemotongan 92% pada output. Pengurangan sebenarnya lebih besar dari angka utama, dan angka utama diukur dari diskon. Masukkan angka kedua dalam model anggaran Anda, bukan yang pertama.
Model murah memiliki jendela konteks yang lebih besar
Inilah detail yang dilewatkan sebagian besar liputan peluncuran. Luna dilengkapi dengan jendela konteks 1.000.000 token. Sol, dengan harga dua puluh kali lipat, dilengkapi dengan 872.000.
Hal itu membalikkan asumsi yang dikodekan banyak kode routing: bahwa Anda mempromosikan permintaan ke model yang lebih mahal saat payload bertambah. Dengan GPT-6, jendela terbesar dalam keluarga berada di bagian bawah daftar harga. Dokumen 900.000 token tidak muat di Sol dan muat di Luna.
Perhitungan ini mengikuti dari dua harga. Mengisi penuh jendela Luna sekali membutuhkan biaya $0.10 dalam token input. Mengisi jendela 872.000 token Sol sekali membutuhkan biaya sekitar $1.74. Mengisi jendela 1 juta Claude Opus 5.5 dengan $4 per juta membutuhkan biaya $4.00. Jenis payload yang sama, perbedaan empat puluh kali lipat dalam apa yang Anda bayar untuk membacanya.
Tambahkan pekerjaan caching OpenAI di atasnya dan celah itu melebar lagi. GPT-6 menerapkan diskon 90% untuk pembacaan input yang di-cache, jadi awalan 1 juta token yang tetap di-cache di seluruh panggilan membutuhkan biaya sekitar $0.01 untuk dibaca ulang alih-alih $0.10. OpenAI juga mengatakan GPT-6 mendapatkan tingkat hit cache yang lebih tinggi secara default, bahwa perubahan upaya penalaran atau ketersediaan alat tidak lagi membatalkan cache, dan bahwa breakpoint eksplisit memungkinkan Anda mengontrol di mana awalan yang di-cache berakhir. GitHub melaporkan lebih dari 50% lebih sedikit token prompt yang membutuhkan pemrosesan baru di miliaran permintaan.
Apa yang diterbitkan OpenAI
Setiap angka di bawah ini berasal dari materi peluncuran OpenAI. Pengaturan upaya penalaran muncul dalam tanda kurung, karena model-model ini memiliki skor yang sangat berbeda pada tingkat upaya yang berbeda dan baris tolok ukur tanpa pengaturan upayanya bukanlah angka yang dapat digunakan.
| Tolok Ukur | GPT-6 Luna | Titik perbandingan |
|---|---|---|
| DeepSWE 1.1 | 66.6% (maks) | Setara dengan Claude Opus 5 dan Claude Fable 5 pada tingkat sedang, 93% lebih murah per tugas daripada Opus 5 dan 96% lebih murah daripada Fable 5 |
| AutomationBench 1.0.6 | Mengalahkan pendahulunya sebesar 5.4 poin (tinggi) | Dengan biaya per tugas 58% lebih rendah |
| OSWorld 2.0 offline | Mengalahkan GPT-5.6 Sol (sedang) pada upaya maksimal | Dengan biaya sekitar sepersepuluh |
| Faktualitas | Sesuai dengan GPT-5.6 Sol pada upaya yang lebih tinggi | Dengan biaya sekitar seperseratus |
Baris DeepSWE adalah yang perlu diperhatikan. Model seharga $0.10 per juta token input yang mencetak 66.6% pada tolok ukur rekayasa perangkat lunak agentic, di wilayah yang sama dengan dua model perbatasan pada upaya menengah, dengan biaya per tugas 93% lebih murah daripada salah satunya, adalah proposisi yang berbeda dari tingkat anggaran. Ini tidak berarti Luna menggantikan model perbatasan pada pekerjaan tersulit Anda. Ini berarti batas antara “arahkan ini ke model murah” dan “ini membutuhkan yang mahal” telah bergeser, dan di mana pun Anda menarik garis itu sebelum September 2026 kini ditarik di tempat yang salah.
Hasil faktualitas adalah yang paling mungkin penting untuk pekerjaan produk biasa. Menyamai tingkat menengah generasi sebelumnya dalam akurasi faktual, dengan biaya sekitar seperseratus, adalah yang membuat Luna layak untuk ringkasan dan ekstraksi yang berhadapan dengan pengguna daripada hanya pekerjaan batch internal.
Setiap perbandingan di sini adalah terhadap Claude Opus 5
Perhatikan model Claude mana yang menjadi tolok ukur baris-baris tersebut. Claude Opus 5.
Anthropic merilis Claude Opus 5.5 pada hari yang sama, seharga $4/$20 dibandingkan Opus 5 yang $5/$25, dan model ini menempati posisi teratas pada Artificial Analysis Intelligence Index dengan skor 58, menduduki peringkat pertama dari 212 model. Postingan peluncuran OpenAI ditulis sebelum Opus 5.5 ada, jadi setiap perbandingan biaya per tugas terhadap Opus 5 diukur terhadap model yang telah digantikan dalam hitungan jam setelah publikasi.
Itu tidak membuat angka OpenAI salah. Angka-angka tersebut akurat untuk perbandingan yang dilakukan. Ini berarti Anda tidak boleh membawa “93% lebih murah dari Opus 5” ke dalam dokumen pengadaan sebagai kondisi pasar saat ini tanpa menyebutkan Opus mana yang dimaksud. Belum ada vendor yang mempublikasikan perbandingan Luna dengan Opus 5.5 secara langsung, dan perbandingan yang beredar di media sosial berasal dari penguji individu, bukan dari salah satu laboratorium. Pilar perang harga kami melacak ketiga peluncuran tersebut satu sama lain dalam satu tabel.
Latensi: model murah bukan model cepat
Pengukuran pihak ketiga dari Artificial Analysis menempatkan GPT-6 Luna pada 153.9 token output per detik dengan waktu hingga token pertama 124.23 detik. Ada dua peringatan yang berlaku dan keduanya penting. Ini adalah angka pihak ketiga, bukan yang diterbitkan vendor. Dan angka-angka ini diukur pada varian penalaran maksimal, konfigurasi yang paling lambat dan paling mahal yang tersedia.
Bahkan dengan kedua peringatan tersebut, arahnya patut dicermati: Luna diukur lebih lambat untuk token pertama daripada Sol, yang diukur pada 102.15 detik. Harga dan latensi tidak berkorelasi dalam keluarga ini. Penantian dua menit sebelum token pertama tiba akan memecahkan batas waktu default klien HTTP, membuat penyeimbang beban menganggur, dan melebihi batas eksekusi pada sebagian besar runtime tanpa server. Jika Anda merutekan titik akhir sinkron ke Luna dengan upaya tinggi, pekerjaan integrasi berada di lapisan batas waktu dan streaming Anda, bukan di prompt Anda.
Uji dengan beban kerja Anda sendiri sebelum Anda merutekannya
Tabel tolok ukur adalah agregat. Prompt Anda tidak. Pertanyaan yang berguna adalah apakah Luna dapat bekerja pada lalu lintas Anda pada tingkat upaya yang Anda mampu, dan itu membutuhkan waktu sekitar sepuluh menit untuk dijawab dengan benar.
Siapkan satu permintaan per model, parameterkan ID model, dan jalankan payload yang sama di seluruh tingkat:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
Konfirmasikan nama titik akhir dan parameter terhadap referensi model OpenAI saat ini sebelum Anda membangun berdasarkan bentuk ini. ID model gpt-6-luna adalah bagian yang dikonfirmasi dari materi peluncuran.
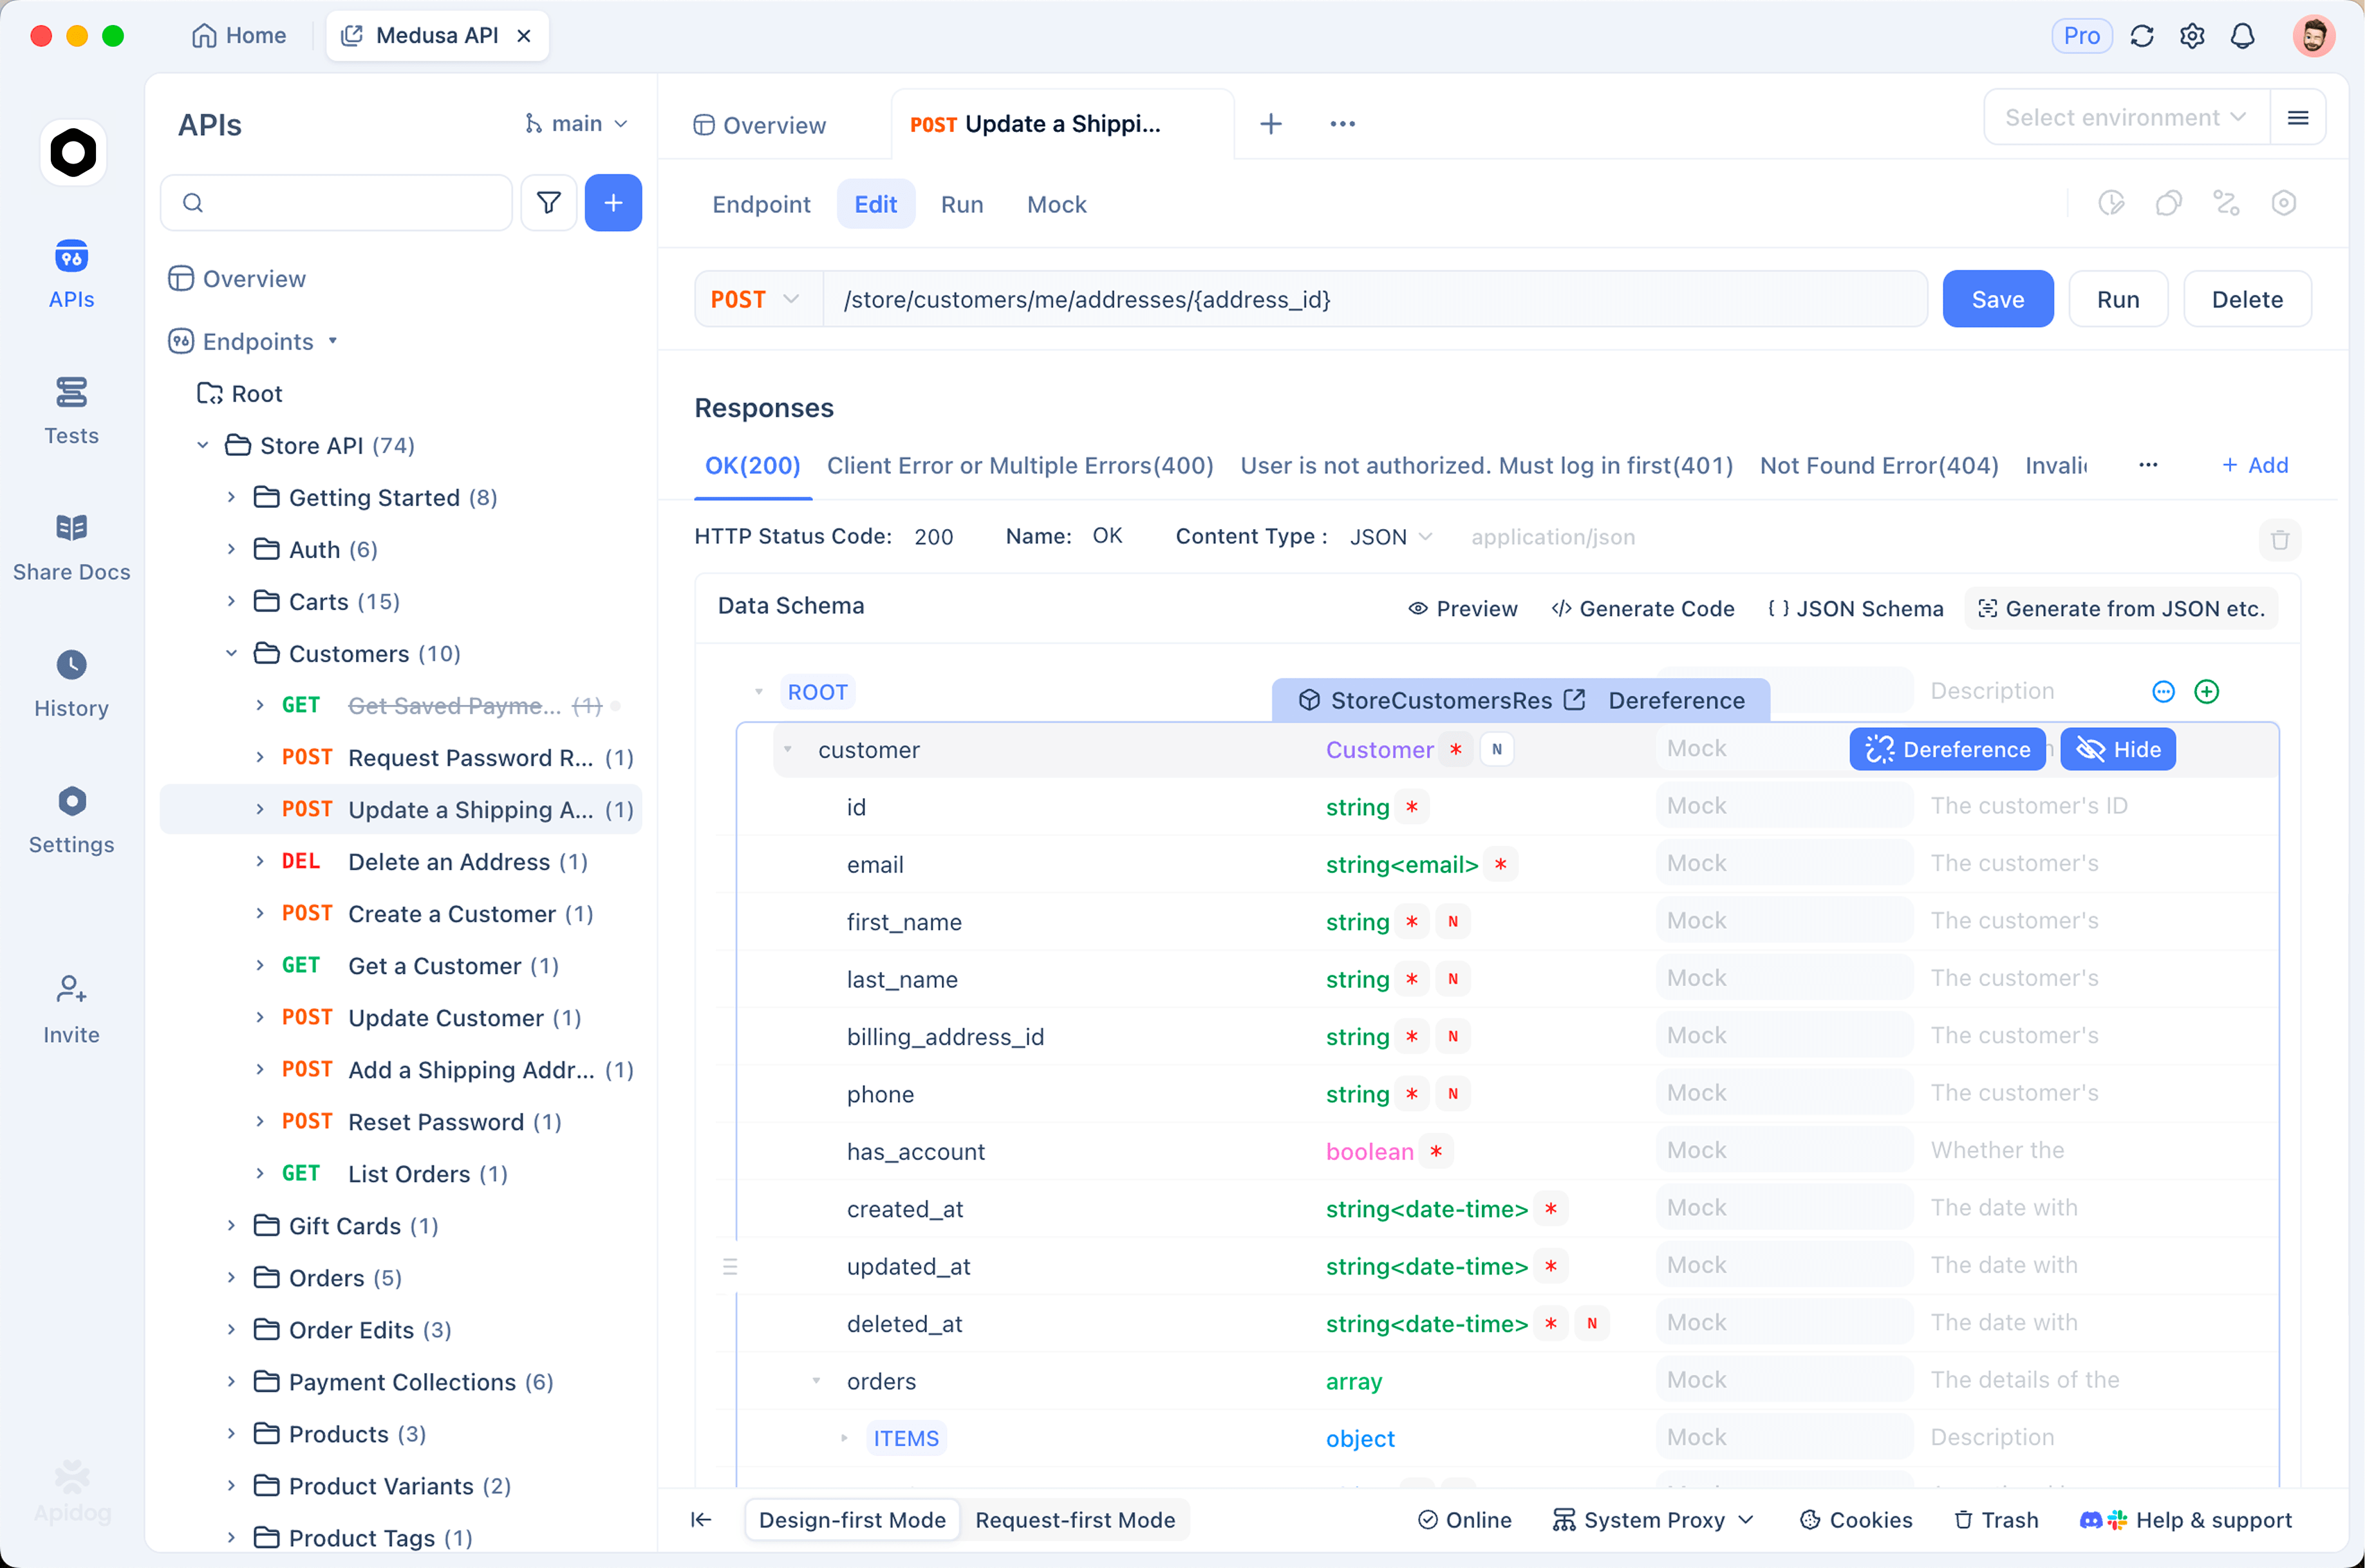
Di Apidog, permintaan yang sama menjadi titik akhir yang tersimpan dengan ID model sebagai variabel lingkungan, sehingga satu koleksi mencakup Luna, Sol, dan Astra tanpa duplikasi. Jalankan sebagai skenario pengujian dan Anda akan mendapatkan waktu respons dan penggunaan token per jalankan, ditambah pernyataan tentang bentuk respons, yang menangkap mode kegagalan sebenarnya dari model yang lebih murah: bukan jawaban yang salah, tetapi respons yang berhenti sesuai dengan skema JSON yang diharapkan parser Anda. Jalankan skenario yang sama pada tiga tingkat upaya dan Anda memiliki tabel biaya, latensi, dan keandalan untuk prompt Anda sendiri daripada untuk suite tolok ukur orang lain.
Kapan Luna adalah pilihan yang tepat
Arahkan ke Luna ketika payload besar, tugas terdefinisi dengan baik, dan Anda dapat memverifikasi output secara terprogram. Ekstraksi dokumen, penguraian spesifikasi, triase log, pembuatan pengujian, klasifikasi volume tinggi, dan pekerjaan batch apa pun di mana jendela 1 juta menghemat pipa chunking Anda, semuanya memenuhi syarat, dan diskon caching berlipat ganda ketika awalan panjang tetap stabil di seluruh panggilan.
Pertahankan tingkat mahal untuk pekerjaan di mana Anda tidak dapat memeriksa jawabannya dengan murah, dan untuk apa pun yang sensitif terhadap latensi sampai Anda mengukur waktu token pertama pada lalu lintas Anda sendiri. Luna menggeser garis. Itu tidak menghapusnya.