
DeepSeek memensiunkan produk unggulannya dengan model terkecilnya. Pada tanggal 10 September 2026, DeepSeek-V4.1-Flash dirilis secara umum (GA) di API, dan catatan rilisnya memuat baris yang kebanyakan lab akan sembunyikan: mulai 14 September, setiap permintaan ke deepseek-v4-pro akan dialihkan ke V4.1-Flash dan ditagih dengan harga Flash. Model Flash berparameter 552B, dengan 8B parameter aktif pada masukan, kini bertanggung jawab atas seluruh keluarga V4.
Itulah cerita di balik pencarian “deepseek v4.1 flash” minggu ini, dan ini penting karena dua alasan. Pertama, arsitekturnya baru. Pemisahan Causal Encoder-Decoder, caching KV FP4 sebesar 890 byte per token, dan visi native sejak langkah pretraining pertama bukanlah perubahan inkremental terhadap DeepSeek V4. Kedua, daftar harga berubah bersamanya. Jika Anda membayar tarif V4-Pro, tagihan Anda akan turun 70% atau lebih pada tanggal 14, baik Anda mengubah sesuatu atau tidak.
Panduan ini mencakup apa yang dikirimkan, bagaimana arsitektur bekerja dalam istilah pengembang, apa yang dikatakan benchmark vendor, dan perhitungan harga. Ini diakhiri dengan alur kerja untuk menguji model terhadap prompt Anda sendiri di Apidog, karena tabel benchmark adalah titik awal, bukan putusan akhir.
TL;DR
- DeepSeek-V4.1-Flash dirilis secara umum (GA) mulai 10 September 2026. ID model:
deepseek-flash. URL dasar tidak berubah dihttps://api.deepseek.com. - MoE 552B (763B dengan encoder visi), 8B aktif untuk prefill, 16B aktif untuk decode. Konteks 1M, output maksimum 384K.
- Berdasarkan angka DeepSeek sendiri, ia mengalahkan V4-Pro pada HumanEval, GSM8K, DeepSWE, dan Terminal-Bench.
- Harga puncak: $0,30 per 1M input cache-miss, $1,20 per 1M output. Harga di luar jam sibuk adalah setengahnya.
- Permintaan V4-Pro dialihkan ke V4.1-Flash pada 14 September pukul 04:00 UTC.
Apa yang dirilis pada 10 September
DeepSeek menjalankan beta internal selama dua hari mulai 8 September di bawah nama model deepseek-v4.1-flash-expires-on-0910, dibatasi hingga 20 permintaan bersamaan per akun dan dihargai sama dengan deepseek-v4-flash. TechNode melaporkan tentang beta tersebut. Dua hari kemudian model tersebut dirilis secara umum (GA), dengan entri changelog bertanggal 2026-09-10 dan pengumuman di X.
Tiga perubahan penamaan penting untuk kode Anda:
- ID model baru adalah
deepseek-flash. Gunakan untuk integrasi baru. - Nama-nama lama
deepseek-v4-flashdandeepseek-v4-flash-vision-expmasih berfungsi, tetapi dilayani oleh V4.1-Flash. V4-Flash dan V4-Flash-Vision-Exp telah dihentikan sebagai model terpisah. deepseek-v4-protetap berfungsi hingga 14 September, kemudian dialihkan ke V4.1-Flash.
URL dasar tidak berubah: https://api.deepseek.com untuk format OpenAI, https://api.deepseek.com/anthropic untuk format Anthropic. API Respons sudah didukung pada lini Flash, sehingga integrasi gaya Codex tetap berfungsi. Untuk detail parameter, termasuk masukan gambar dan upaya penalaran, lihat cara menggunakan API DeepSeek-V4.1-Flash.
Arsitektur Causal Encoder-Decoder untuk pengembang
Kartu model menjelaskan desain yang DeepSeek sebut Causal Encoder-Decoder, atau CED. Berikut adalah arti setiap angka ketika Anda yang membayar token.
Parameter 552B, 763B dengan visi. Inti bahasa adalah model mixture-of-experts berparameter 552B. Tambahkan encoder DeepSeek-ViT, yang dilatih dari awal untuk rilis ini, dan model lengkap mencapai 763B. Itu adalah parameter yang disimpan, bukan biaya sebuah permintaan.
8B aktif untuk prefill, 16B aktif untuk decode. Ini adalah perubahan utama. 40 lapisan dibagi menjadi 20 lapisan encoder dan 20 lapisan decoder. Membaca prompt Anda (prefill) mengaktifkan sekitar 8B parameter per token. Menulis jawaban (decode) mengaktifkan sekitar 16B. Model MoE DeepSeek sebelumnya menggunakan satu anggaran parameter aktif untuk kedua fase.
Mengapa pemisahan itu penting? Prefill terikat komputasi: Anda memasukkan dokumen 200K-token melalui model dalam satu lintasan. Decode terikat memori: Anda menghasilkan satu token pada satu waktu, dan biayanya adalah membaca bobot dan cache KV dari HBM. Lebih sedikit parameter pada prefill memangkas waktu-ke-token-pertama pada masukan panjang. Lebih banyak pada decode membeli kualitas jawaban di mana komputasi tambahan murah relatif terhadap lalu lintas memori. Jejak agen konteks 1M yang menghasilkan balasan 2K-token mengambil jalur murah untuk 99,8% tokennya.
384 pakar yang dialihkan ditambah 1 pakar bersama per lapisan. Router memilih beberapa dari 384 pakar per token, dan pakar bersama berjalan setiap saat. Begitulah cara parameter 552B yang disimpan menjadi 8B atau 16B aktif.
CSA2 dan cache KV FP4. Compressed Sparse Attention 2 hadir dengan tiga mode perhatian statis. Dipasangkan dengan penyimpanan FP4 untuk cache KV utama, jejak cache global adalah 890 byte per token, sekitar seperempat dari DeepSeek-V4-Flash. Catatan rilis menyatakannya sebagai 1/4 HBM dan 1/8 penyimpanan SSD dari generasi sebelumnya. Pada 890 byte per token, konteks 1M-token penuh membutuhkan sekitar 0,9 GB cache KV. Itu adalah bagian mengapa batas konkurensi berada di 2.500 untuk Flash dibandingkan 500 untuk Pro.
Konteks 1M, output 384K. Sparse attention dilatih pada 64K dan diperluas hingga 1M pada tanda 34T-token dari korpus multimodal 45T-token. Upaya penalaran digambarkan dapat dikontrol secara berkelanjutan pada skala 1 hingga 100; bentuk parameter API yang tepat untuk skala tersebut adalah [VERIFIKASI] terhadap dokumen.
Benchmark: apa yang DeepSeek laporkan
Setiap angka di bagian ini dilaporkan oleh DeepSeek dari kartu model. Belum ada evaluasi independen yang dipublikasikan per 10 September. Bacalah sebagai klaim vendor, lalu jalankan sendiri.
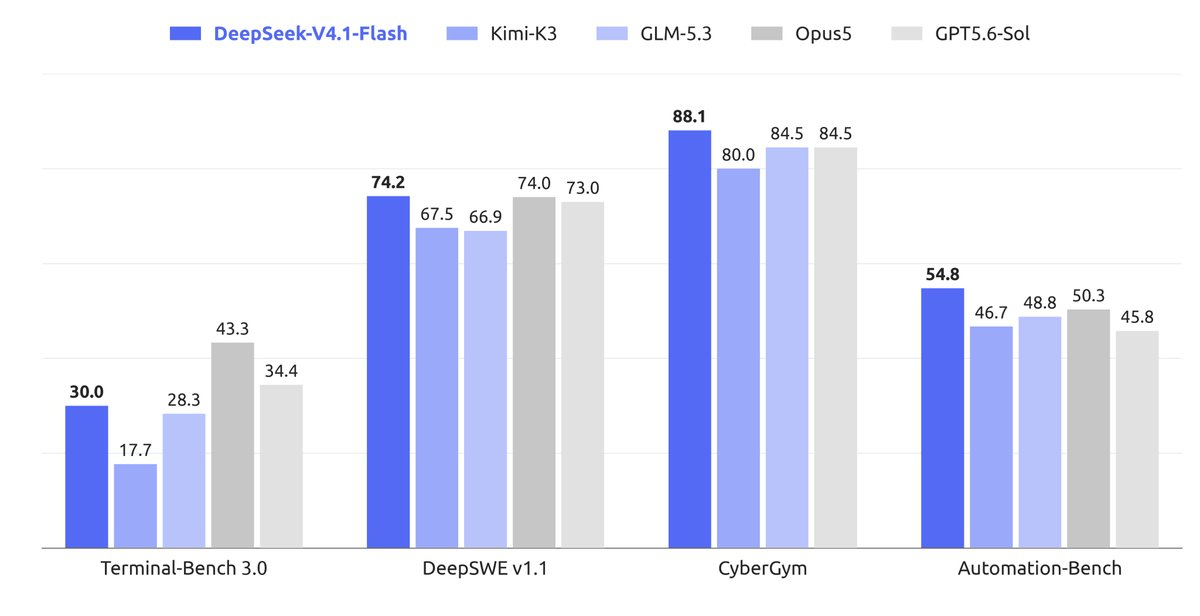
Polanya konsisten: V4.1-Flash berada di atas V4-Pro pada setiap baris, dengan selisih terlebar pada coding agentic. DeepSWE melonjak 11,5 poin di atas Pro dan hampir 20 poin di atas Flash lama. GSM8K sudah jenuh, jadi keunggulan 0,4 poin tidak banyak memberi tahu.
Skor visi, juga dilaporkan vendor: MMMU-Pro 56.5, CVBench 77.9, DocVQA 95.6, RefCOCO 86.0. DocVQA adalah angka yang patut diperhatikan, karena penguraian dokumen adalah tempat sebagian besar lalu lintas visi produksi mengalir.
DeepSeek membingkai pengalihan V4-Pro dengan menyatakan bahwa V4.1-Flash “telah melampaui V4 Pro secara komprehensif dalam kinerja, biaya, kecepatan, dan waktu total”, mengutip pengujian oleh berbagai pihak. Pihak-pihak tersebut tidak disebutkan namanya. Perlakukan kalimat itu sebagai klaim yang dapat Anda periksa.
Harga dan pengalihan V4-Pro
Tarif di bawah ini berasal dari halaman harga, berlaku mulai 10 September pukul 04:00 UTC, dalam USD per 1 juta token.
| deepseek-flash di luar jam sibuk | deepseek-flash jam sibuk | deepseek-v4-pro di luar jam sibuk | deepseek-v4-pro jam sibuk | |
|---|---|---|---|---|
| Input, cache hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Input, cache miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Output | $0.60 | $1.20 | $1.98 | $3.96 |
Jam sibuk adalah 01:00 hingga 04:00 dan 06:00 hingga 10:00 UTC pada hari kerja; di luar jam sibuk adalah 50% dari jam sibuk. Caching konteks otomatis, dan cache hit berharga 50 kali lebih murah daripada cache miss di kedua tingkatan.
Dibandingkan tarif V4-Flash bulan Agustus, V4.1-Flash memangkas input cache-hit sekitar 57%, input cache-miss sekitar 32%, dan output sekitar 9%.
Kolom V4-Pro adalah yang patut diperhatikan. Setelah 14 September, permintaan yang dikirim ke deepseek-v4-pro akan dikenakan biaya kolom Flash. Pada jam sibuk, itu adalah $0,30 bukan $1,32 per 1M input cache-miss (77% lebih murah) dan $1,20 bukan $3,96 per 1M output (70% lebih murah). Anda mendapatkan potongan harga tanpa menyentuh kode, meskipun Anda tetap harus memperbarui ID model daripada bergantung pada alias yang sudah dihentikan. Panduan migrasi menjelaskan daftar periksa, dan penjelasan mendalam harga mencakup perhitungan cache-hit untuk sesi agen yang panjang.
Evaluasi V4.1-Flash terhadap prompt Anda sendiri di Apidog
Tabel vendor mengatakan model ini bagus di DeepSWE. Namun, tidak disebutkan apakah model ini menangani skema ekstraksi Anda, format panggilan alat Anda, atau transkrip dukungan 300K-token Anda. Berikut adalah alur kerja di Apidog yang menjawab pertanyaan-pertanyaan tersebut dalam waktu singkat dan terus menjawabnya setelah setiap pembaruan model tanpa pemberitahuan.
- Simpan kunci sebagai variabel lingkungan. Buat lingkungan Apidog dan tambahkan
DEEPSEEK_API_KEYdari platform DeepSeek. Referensikan dalam header Otorisasi sebagaiBearer {{DEEPSEEK_API_KEY}}. - Tambahkan endpoint. Buat
POST https://api.deepseek.com/chat/completions, atau impor spesifikasi OpenAPI. - Simpan satu permintaan per prompt nyata. Ambil lima hingga sepuluh prompt dari log produksi dan simpan masing-masing sebagai permintaannya sendiri dengan
"model": "deepseek-flash". Simpan salinan yang diarahkan kedeepseek-v4-prohingga tanggal 14 sehingga Anda dapat membandingkan output secara berdampingan. - Streaming dan pantau peristiwa. Atur
"stream": true. Apidog merender respons SSE peristiwa demi peristiwa, sehingga delta penalaran dan delta jawaban muncul secara terpisah, bukan sebagai dinding barisdata:. Ini adalah cara tercepat untuk melihat waktu-ke-token-pertama pada prefill yang panjang. - Tambahkan pernyataan dan bangun skenario pengujian. Lakukan pernyataan pada kode status, pada bidang
tool_callsdi mana Anda mengharapkannya, dan pada validitas JSON dari output. Rangkai permintaan yang disimpan ke dalam skenario pengujian. - Jalankan ulang pada setiap pembaruan model. Ketika DeepSeek mendorong perubahan berikutnya di balik
deepseek-flash, jalankan skenario tersebut. Hubungkan ke CI denganapidog-cliagar berjalan pada setiap deployment.
Berikut adalah isi salah satu prompt yang disimpan tersebut, menggunakan OpenAI SDK:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "Ekstrak ID pesanan, daftar SKU, dan jumlah pengembalian dana sebagai JSON."},
        {"role": "user", "content": "Tiket #48213: pelanggan menginginkan pengembalian dana sebesar $42.90 untuk SKU KB-220 dan MS-114 dari pesanan ORD-99117."},
    ],
    stream=True,
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
Unduh Apidog dan tempelkan isi tersebut ke permintaan yang disimpan. Apidog menguji lapisan API, bukan host model, jadi apa yang Anda lihat adalah respons yang akan didapatkan pengguna Anda.
FAQ
Apakah DeepSeek-V4.1-Flash pengganti V4-Pro? Ya, berdasarkan keputusan DeepSeek. Mulai 14 September pukul 04:00 UTC, permintaan deepseek-v4-pro akan dilayani oleh V4.1-Flash dengan harga Flash. Tidak ada lagi model yang lebih besar dalam jajaran API V4.
Apakah saya perlu mengubah ID model saya? Tidak segera. deepseek-v4-flash, deepseek-v4-flash-vision-exp, dan (setelah tanggal 14) deepseek-v4-pro semuanya akan mengarah ke V4.1-Flash. Beralihlah ke deepseek-flash saat Anda berikutnya menyentuh integrasi. Panduan API memiliki referensi parameter lengkap.
Apa arti 8B prefill / 16B decode untuk latensi? Lebih sedikit parameter aktif pada input berarti waktu-ke-token-pertama yang lebih cepat pada prompt panjang. Lebih banyak pada output berarti komputasi diarahkan ke tempat kualitas generasi ditentukan. Cache KV 890 byte per token menjaga sesi panjang tetap murah untuk disimpan dalam memori.
Bisakah saya menjalankannya secara lokal? Bobotnya berlisensi MIT di Hugging Face. Inti model saja sekitar 552 GB pada 8-bit atau 280 GB pada 4-bit, jadi ini adalah proyek multi-GPU atau streaming SSD, bukan proyek laptop. Dukungan mesin inferensi hari-nol adalah [VERIFIKASI].
Apakah benchmarknya independen? Tidak. Setiap skor di atas berasal dari kartu model DeepSeek. Laporan teknis memiliki metodologinya.
Implikasi ini terhadap lini V4
DeepSeek menggabungkan API dua model menjadi satu. Taruhannya adalah bahwa model 552B dengan anggaran decode 16B, cache KV berukuran seperempat, dan 2.500 sesi bersamaan per akun melayani beban kerja agen lebih baik daripada model yang lebih besar dengan harga tiga hingga empat kali lipat. Angka vendor mendukung taruhan ini; beban kerja Anda yang akan memutuskan apakah itu berlaku.
Arahkan SDK Anda ke deepseek-flash, jalankan prompt Anda sendiri melaluinya sebelum tanggal 14, dan simpan skenario pengujian. Jika Anda membangun di atas API V4-Flash asli, integrasi Anda sudah berfungsi. Yang berubah adalah model di belakangnya, dan itulah bagian yang layak diukur.