
Together AI, Fireworks AI, dan Groq menjual tawaran yang sama: arahkan klien OpenAI Anda yang sudah ada ke base URL baru, tukar kuncinya, dan dapatkan model open-weight dengan biaya yang jauh lebih murah. Tawaran itu benar. Yang tidak benar adalah bahwa membandingkan tier gratis mereka sesederhana menyandingkan tiga angka, karena dua dari tiga penyedia sama sekali tidak menerbitkan angka tetap.
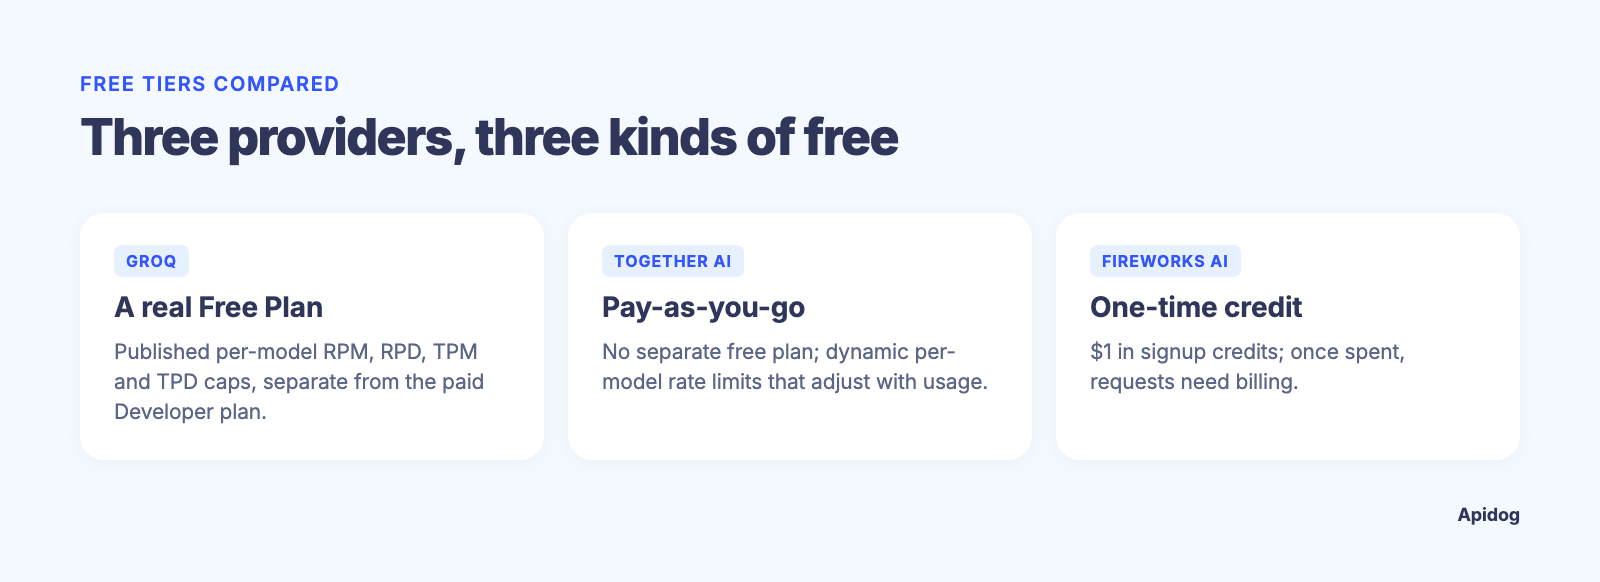
Groq adalah pengecualian: halaman rate-limit-nya benar-benar menerbitkan angka Free Plan yang nyata, per model, di tab yang dilewati sebagian besar pembaca dalam perjalanan menuju tab Developer Plan di sebelahnya. Together AI mengatakan terus terang, di dokumentasinya sendiri, bahwa tidak ada batas per-model tetap yang bisa diterbitkan; plafon Anda bergerak mengikuti penggunaan Anda. Fireworks AI mengaitkan akses gratisnya dengan saldo kredit sekali pakai, bukan dengan tingkatan paket. Tiga desain berbeda, dan artikel “tier gratis mana yang lebih besar” tetap tidak bisa mereduksinya menjadi satu angka.
TL;DR
Groq, Together AI, dan Fireworks AI semuanya menyediakan endpoint yang kompatibel dengan OpenAI, jadi berpindah di antara mereka hanya soal base URL dan API key, bukan menulis ulang kode. Groq membagi akses menjadi Free Plan dan Developer Plan berbayar, dan tidak seperti dua lainnya, ia menerbitkan angka Free Plan per model yang nyata, misalnya 30 RPM / 1K RPD / 8K TPM / 200K TPD pada gpt-oss-120b dan gpt-oss-20b. Together AI tidak menerbitkan angka tier gratis yang tetap; dokumentasinya menyatakan batas bergerak secara dinamis mengikuti kapasitas aktif dan penggunaan sukses terkini Anda. Fireworks AI memberikan akun baru saldo kredit sekali pakai ($1, menurut halaman harganya) alih-alih jatah gratis berulang. Keputusan yang lebih penting daripada angka utama adalah model mana yang sebenarnya Anda butuhkan dan bagaimana plafon tiap penyedia berperilaku begitu Anda mencapainya. Apidog memungkinkan Anda menyimpan satu request dan menukar base URL serta key per environment, sehingga Anda bisa mengukur ketiganya sendiri alih-alih memercayai sebuah tabel.
Satu bentuk API, tiga kunci
Ketiga penyedia sengaja meniru skema OpenAI Chat Completions. Itulah sebabnya panduan migrasi untuk alat-alat ini selalu terdengar sama: ubah base_url, ubah header Authorization, sisanya biarkan seperti semula. Base yang kompatibel dengan OpenAI milik Groq adalah https://api.groq.com/openai/v1/. Milik Together AI adalah https://api.together.ai/v1, yang dikonfirmasi langsung di dokumentasi quickstart-nya. Milik Fireworks AI adalah https://api.fireworks.ai/inference/v1, menurut panduan kompatibilitas OpenAI-nya.
Bentuk yang sama itulah alasan uji adu langsung layak dilakukan: menambahkan penyedia keempat atau kelima hanya memakan waktu beberapa menit, bukan perancangan ulang. Kami membahas mekanisme pengelolaan setup multi-penyedia semacam itu di cara mengelola base URL antar environment di Apidog, dan jika Anda mempertimbangkan opsi routing secara lebih luas, ulasan kami tentang alternatif OpenRouter membahas di mana ketiga penyedia ini masuk dalam gambaran tersebut.
Apa yang sebenarnya bisa Anda verifikasi tentang tiap tier gratis
Berikut perbandingan yang disusun hanya dari apa yang dinyatakan secara publik oleh tiap penyedia per September 2026. Jika suatu penyedia tidak mengungkapkan angkanya, tabel akan mengatakan demikian alih-alih menebak.
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| Model akses gratis | Free Plan (terpisah dari Developer Plan berbayar) | Pay-as-you-go sejak pendaftaran; tidak ada nama “free plan” terpisah | Kredit pendaftaran sekali pakai |
| Jatah gratis yang didokumentasikan | Diterbitkan per model: gpt-oss-120b/gpt-oss-20b 30 RPM, 1K RPD, 8K TPM, 200K TPD; compound 30 RPM, 250 RPD, 70K TPM (menurut rate limit Groq, dibaca 2026-09-15) |
Tidak diterbitkan sebagai angka tetap; dijelaskan sebagai dinamis per organisasi | $1 dalam kredit gratis menurut harga Fireworks |
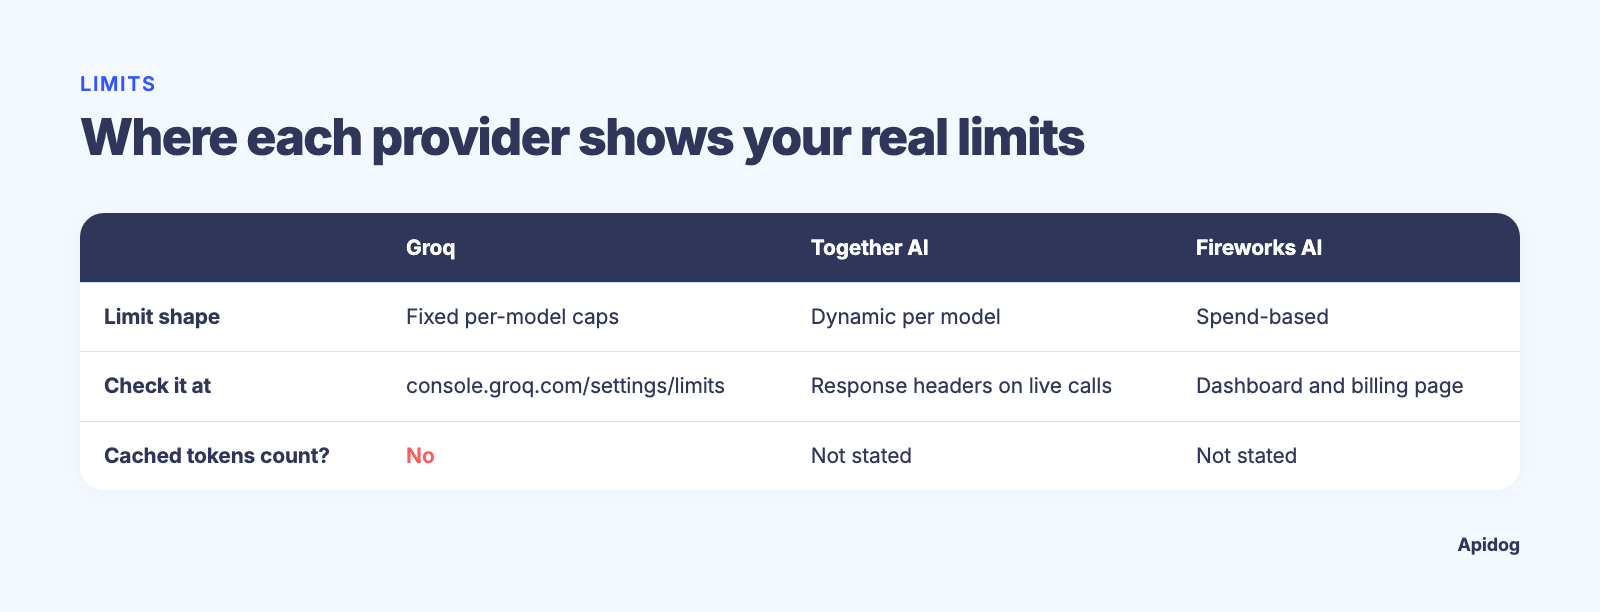
| Bagaimana batas dibentuk | Batas RPM/RPD/TPM/TPD per model, diberlakukan di tingkat organisasi | Rate dinamis per model, menyesuaikan dengan kapasitas aktif dan penggunaan sukses terkini Anda | Berbasis pengeluaran; setelah kredit habis, request memerlukan penagihan yang diaktifkan |
| Di mana memeriksa angka Anda sendiri | console.groq.com/settings/limits |
Header respons pada panggilan langsung, mis. x-ratelimit-reset |
Dashboard akun dan halaman penagihan |
| Apakah token yang di-cache dihitung terhadap batas? | Tidak, menurut dokumentasi Groq sendiri | Tidak disebutkan di halaman yang kami periksa | Tidak disebutkan di halaman yang kami periksa |
Ada dua hal yang menonjol begitu Anda benar-benar membaca halaman sumbernya alih-alih ringkasan lembar spesifikasi. Pertama, angka Free Plan Groq di atas adalah default yang diterbitkan; halaman yang sama juga memuat tab Developer Plan dengan plafon yang lebih tinggi, dan console.groq.com/settings/limits adalah acuan jika angka Anda berbeda. Kedua, pembatasan rate Together AI sama sekali bukan tabel. Halaman rate-limit-nya sendiri menyatakan dengan jelas bahwa “tidak ada batas per-model tetap yang diterbitkan,” dan bahwa plafon Anda naik seiring “trafik yang stabil dan sukses.” Itu model yang secara signifikan berbeda dari baris tier gratis yang statis, dan itu berarti jawaban jujur untuk “berapa RPM gratis Together” adalah “periksa header respons Anda,” bukan angka yang diambil dari tabel.
Jika Anda menginginkan pembahasan mendalam satu penyedia dengan angka yang bisa diverifikasi untuk satu produk pada satu waktu, lihat artikel pendamping kami tentang tier gratis Groq API dan tier gratis Cerebras API. Artikel ini adalah hub-nya; dua artikel itu melakukan penggalian per penyedia secara lengkap.
Request vs token, tetap vs dinamis
Perbedaan desain yang sebenarnya di antara ketiganya bukanlah besarnya jatah gratis, melainkan bentuk plafonnya.
Model Groq adalah yang sudah dikenal sebagian besar developer dari bekerja dengan rate limit di tempat lain: batas tetap per jendela waktu, dibagi menjadi RPM, RPD, TPM, dan TPD, dan berlaku di tingkat organisasi, bukan per API key. Artinya, jika Anda membuat tiga key untuk tiga layanan di bawah satu akun Groq, ketiganya berbagi satu pool yang sama. Panduan umum kami tentang rate limit GPT API membahas struktur RPM/TPM yang sama ini lebih dalam jika Anda belum pernah bekerja dengan batas berbasis token sebelumnya.
Model Together AI memberi imbalan atas trafik yang stabil dan sukses alih-alih menghukum trafik burst dengan dinding keras. Akun yang sepi dan akun yang berat namun berperilaku baik tidak mendapatkan plafon yang sama, karena plafon menyesuaikan dengan riwayat terkini akun Anda sendiri dan dengan kapasitas aktif model pada saat itu. Itu kabar baik jika beban kerja Anda dapat diandalkan, dan benar-benar tidak diketahui jika trafik Anda sifatnya burst.
Fireworks AI hampir sepenuhnya menghindari desain rate-limit bagi pengguna baru dengan mengaitkan periode gratis ke saldo dolar alih-alih jendela laju request. Anda tidak dibatasi oleh seberapa cepat Anda memanggil API; Anda dibatasi oleh seberapa besar biaya panggilan Anda sebelum saldo habis. Itu mengubah pertanyaan perencanaan dari “berapa request per menit” menjadi “berapa token yang bisa dibeli $1 pada harga per token model ini,” yang sepenuhnya bergantung pada model mana yang Anda pilih.
Ketiganya adalah taruhan berbeda tentang jenis penggunaan apa yang seharusnya dilindungi oleh tier “gratis”: volume berkelanjutan, lonjakan burst, atau total pengeluaran. Apa pun yang Anda bangun, cepat atau lambat Anda akan menemui 429, dan bagaimana penyedia menandai momen itu sama pentingnya dengan angka yang memicunya. Panduan pemecahan masalah rate limit terlampaui kami membahas cara membaca header respons tersebut dan membangun logika retry yang tidak memperburuk masalah.
Buktikan sendiri dalam lima menit
Mengingat banyaknya data ini yang berada di balik layar login atau header respons langsung, jalur tercepat menuju jawaban nyata bukanlah artikel lembar spesifikasi lain, melainkan satu pengujian yang dijalankan coding agent Anda terhadap ketiganya. Dengan Apidog CLI, itu hanya satu prompt. Siapkan sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Token diambil dari Apidog di bawah Account Settings, API Access Token. Lalu berikan satu prompt ke agent:
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
Perintah yang dijalankannya, diperiksa terhadap Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
Berganti penyedia kini hanya soal ID environment, bukan menulis ulang kode. Header adalah tempat plafon dinamis Together AI muncul secara real time dan tempat Anda dapat mengonfirmasi bahwa organisasi Groq Anda sesuai dengan tabel Free Plan yang diterbitkan. Sertakan juga latensi dalam perbandingan: model yang secara teknis gratis tetapi lambat sebenarnya tidak lebih murah setelah Anda menghitung waktu yang dihabiskan untuk mengakalinya. Ini mengubah tiga halaman pemasaran menjadi satu kumpulan data yang bisa dibandingkan dari akun Anda sendiri. Menjalankan perbandingan secara berkelanjutan di dalam build agent yang lebih besar? Panduan kami tentang alat pengujian API untuk AI agent membahasnya, dan Apidog CLI di Cursor menunjukkan setup agent-nya.
Tier gratis mana yang cocok untuk kasus penggunaan Anda
Berdasarkan hanya pada apa yang bisa diverifikasi saat ini, beberapa rekomendasi yang jujur:
- Batas per model yang dapat diprediksi dan bisa dibaca tanpa login: Groq menerbitkan angka Free Plan yang nyata (30 RPM / 1K RPD / 8K TPM / 200K TPD pada model
gpt-oss), dan jendela konteks 131.072 token-nya di seluruhllama-3.1-8b-instant,llama-3.3-70b-versatile, dan modelopenai/gpt-ossmencakup beragam beban kerja open-weight pada satu endpoint. - Trafik yang stabil dan berperilaku baik, tidak tertarik melacak rate limit: Model dinamis Together AI cocok untuk pola itu; penggunaan sukses yang berkelanjutan menaikkan plafon Anda sendiri seiring waktu alih-alih membatasi Anda pada angka yang ditetapkan di hari pertama.
- Tanpa hambatan setup, nyaman menghadapi dinding pengeluaran: Akses gratis berbasis kredit Fireworks AI menguji harga per token yang sebenarnya sejak panggilan pertama, berguna ketika pertanyaan sebenarnya adalah biaya dalam skala besar alih-alih jumlah request.
Ketiganya menghosting subset model open-weight yang berbeda, dan model yang cocok untuk tugas Anda di satu penyedia mungkin tidak ada di penyedia lain.
FAQ
Apakah Together AI, Fireworks AI, dan Groq semuanya menggunakan OpenAI SDK? Ya. Ketiganya mendokumentasikan endpoint yang kompatibel dengan OpenAI, jadi pustaka klien openai standar berfungsi pada salah satunya begitu Anda mengubah base URL dan key.
Penyedia mana yang punya tier gratis terbesar? Tidak dengan cara yang bisa Anda bandingkan secara langsung. Groq menerbitkan angka Free Plan nyata per model (30 RPM / 1K RPD / 8K TPM / 200K TPD pada gpt-oss-120b/gpt-oss-20b), Together AI sama sekali tidak menetapkan angka tetap, dan Fireworks AI mengaitkan akses gratis ke saldo kredit sekali pakai alih-alih jatah. Periksa console.groq.com/settings/limits jika angka Anda berbeda.
Apakah rate limit berlaku per API key atau per akun? Untuk Groq, batas berlaku di tingkat organisasi, jadi beberapa key di bawah satu akun berbagi pool yang sama, menurut dokumentasi rate-limit-nya sendiri. Together AI dan Fireworks AI tidak menyatakan ini secara eksplisit di halaman yang kami periksa; verifikasi di dashboard Anda sendiri sebelum berasumsi sebaliknya.
Apa yang terjadi ketika saya mencapai rate limit di salah satu penyedia ini? Anda akan menerima respons HTTP 429. Detailnya berbeda-beda; lihat panduan rate limit terlampaui kami untuk cara membaca header retry yang dikembalikan sebagian besar API yang kompatibel dengan OpenAI, dan bangun logika backoff alih-alih menebak.
Apakah ada cara yang lebih cepat untuk membandingkan ini daripada membaca sendiri setiap halaman dokumentasi? Minta coding agent Anda menjalankan satu test case Apidog CLI terhadap tiga environment, seperti dijelaskan di atas. Dua puluh menit dengan Apidog CLI akan memberi tahu Anda lebih banyak tentang beban kerja aktual Anda daripada tabel perbandingan apa pun, termasuk yang ini.