
Untuk menjalankan Qwen 3.8 27B secara lokal, instal Ollama dan jalankan ollama pull qwen3.8:27b, lalu ollama run qwen3.8:27b. Build defaultnya adalah unduhan 4-bit sebesar 18 GB, jadi Anda membutuhkan GPU dengan VRAM 24 GB atau Mac dengan unified memory 32 GB. Bobot modelnya berlisensi Apache-2.0, sehingga modelnya sendiri tidak berbiaya apa pun. Satu-satunya biaya Anda hanyalah perangkat keras dan listrik.
Itulah versi singkatnya. Sisa panduan ini membahas empat runner yang layak digunakan (Ollama, LM Studio, llama.cpp, dan MLX), berapa kebutuhan memori setiap kuantisasi, kecepatan apa yang bisa diharapkan di perangkat keras nyata, dan cara membuat coding agent Anda menguji endpoint lokal dengan Apidog CLI setelah server berjalan.
Baru mengenal keluarga model ini? Apa itu Qwen 3.8 membahas model flagship Max berparameter 2,4T. Panduan ini berfokus pada saudara kandungnya yang kecil dan dense, yang cukup ringan untuk berjalan di meja kerja Anda.
Apa itu Qwen 3.8 27B?
Qwen 3.8 27B adalah model vision-language dense berparameter 27 miliar dari tim Qwen milik Alibaba, dirilis pada Agustus 2026 di bawah lisensi Apache-2.0. Model ini membaca teks, gambar, dan video, berpikir sebelum menjawab secara default, serta memiliki jendela konteks native 262.144 token yang bisa diperluas hingga 1 juta token dengan penskalaan YaRN.
Kartu model resminya mencantumkan spesifikasi berikut:
| Spesifikasi | Qwen 3.8 27B |
|---|---|
| Parameter | 27B dense (Hub mencantumkan 28B termasuk vision encoder) |
| Layer | 64, campuran blok Gated DeltaNet dan Gated Attention |
| Konteks | 262.144 native, hingga 1.000.000 dengan YaRN |
| Input | Teks, gambar, video |
| Thinking | Aktif secara default, reasoning_effort berupa xhigh, medium, atau low |
| Fitur tambahan | Layer multi-token prediction (MTP) |
| Lisensi | Apache-2.0 |
Pada tabel benchmark milik Qwen sendiri, model ini mencatat skor 61,7 di SWE-bench Pro, 73,0 di Terminal Bench 2.1, dan 89,2 di GPQA Diamond. Itu adalah angka dari vendor. Artikel rincian benchmark Qwen 3.8 kami menjelaskan cara membaca tabel tersebut, termasuk baris mana saja yang Qwen uji sendiri secara internal.
Mengapa hal ini penting untuk penggunaan lokal: model dense 27B pada kuantisasi 4-bit cukup muat di satu GPU konsumen, dengan tool calling, vision, dan thinking dalam satu file yang sama.
Berapa RAM dan VRAM yang dibutuhkan untuk Qwen 3.8 27B?
Rencanakan berdasarkan ukuran file kuantisasi Anda ditambah 3 hingga 6 GB untuk KV cache dan runtime. Untuk Q4_K_M default, itu berarti VRAM 24 GB pada GPU atau Mac 32 GB.
Berikut ukuran file GGUF dari repo kuantisasi unsloth, diperiksa pada 9 November 2026:
| Kuantisasi | Ukuran file | Perangkat keras yang realistis |
|---|---|---|
| UD-IQ2_XXS | 7,27 GB | Mac 16 GB atau GPU 12 GB, penurunan kualitas terasa |
| UD-Q3_K_XL | 13,1 GB | GPU 16 GB, Mac 24 GB |
| UD-Q4_K_M | 16,5 GB | GPU 24 GB, Mac 32 GB (pilihan paling ideal) |
| UD-Q5_K_M | 19,8 GB | GPU 24 GB dengan konteks pendek, Mac 32 GB |
| UD-Q6_K | 22 GB | GPU 32 GB, Mac 48 GB |
| Q8_0 | 29 GB | GPU 48 GB, Mac 64 GB |
Vision projector (mmproj-F16.gguf) menambahkan 928 MB jika Anda ingin input gambar. Tag default qwen3.8:27b milik Ollama berukuran 18 GB karena sudah menyertakan vision.
Panjang konteks adalah biaya tersembunyinya. perhitungan perencanaan llm-speed menempatkan Q4_K_M di sekitar 21,9 GB dengan konteks 32.000 token. Itulah alasan kartu 24 GB menjadi batas praktis minimum untuk Q4, dan mengapa Anda sebaiknya tidak memuat jendela konteks penuh 262K kecuali memorinya sangat berlebih.
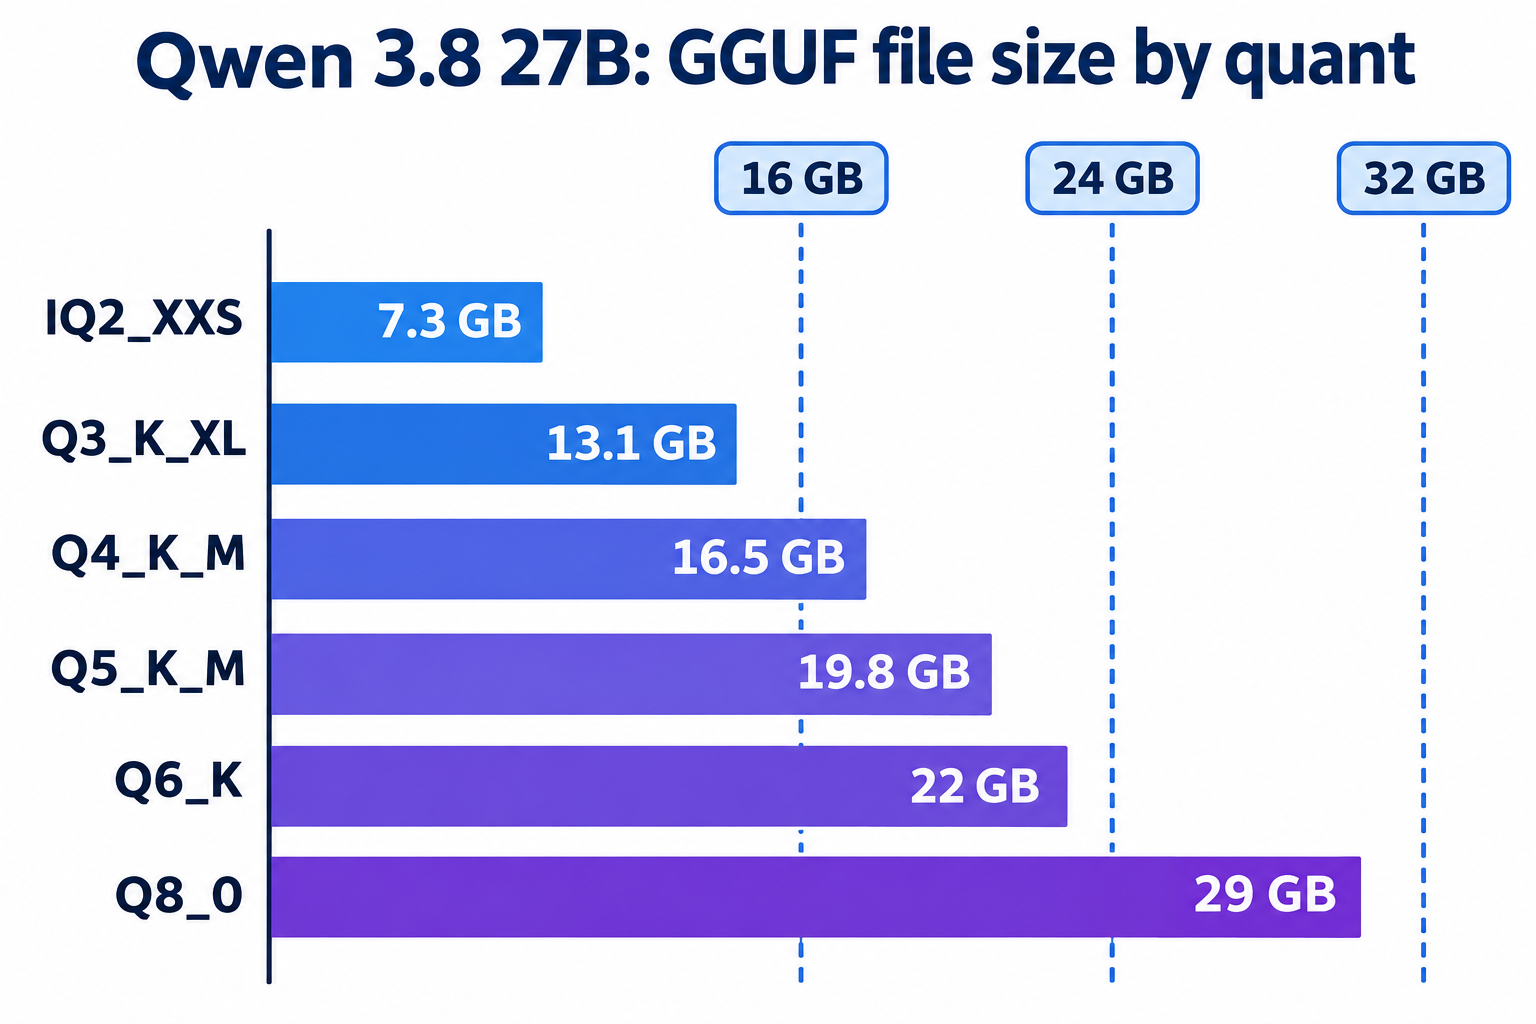
Di Mac, ingatlah bahwa macOS menyisihkan sebagian unified memory untuk sistem. Mac 24 GB secara teknis bisa memuat Q4_K_M, tetapi sisa ruangnya akan sangat sedikit untuk konteks atau browser Anda. Untuk Mac 24 GB, kami menyarankan Q3_K_XL.
Seberapa cepat Qwen 3.8 27B berjalan secara lokal?
Perkirakan sekitar 38 hingga 44 token per detik di RTX 3090 atau 4090 pada Q4_K_M dengan llama.cpp, dan 65 hingga 75 di RTX 5090. Mac Studio dengan M3 Ultra mendekode sekitar 25 hingga 27 token per detik.
Kami tidak melakukan benchmark ini sendiri. Angka-angka ini berasal dari pengujian terukur yang dipublikasikan oleh llm-speed, dengan perangkat keras dan runtime yang mereka sebutkan:
| Perangkat keras | Kuantisasi / runtime | Decode tok/s | Prefill tok/s |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38,6 (chat pendek, ctx 4K) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43,4 (chat pendek, ctx 4K) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75,2 (chat pendek, ctx 4K) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34,3 (chat pendek) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25,2 (chat pendek) | 45 |
| M3 Ultra 96 GB | 4-bit, MLX 0.31.3 | 27,3 (chat pendek) | 12 |
Kecepatan decode hampir tidak turun dengan bertambahnya konteks di GPU: 4090 masih mencapai 39,0 tok/s setelah prompt 33.133 token. Prefill adalah titik di mana Mac tertinggal. Pada prompt 11.827 token, M3 Ultra memproses sekitar 283 tok/s, dibandingkan sekitar 2.000 hingga 3.000 di 4090, sehingga basis kode besar berarti puluhan detik menunggu sebelum token pertama muncul.
Mode thinking juga memakan anggaran waktu Anda. Ketika Simon Willison meminta Qwen 3.8 27B lokal mengidentifikasi game dari bobot model mentah, satu jawaban memakan waktu 46 menit dengan 43.506 token reasoning. Untuk tugas sehari-hari, turunkan reasoning_effort ke low atau matikan thinking.
Menjalankan Qwen 3.8 27B dengan Ollama
Ollama adalah jalur tercepat di OS apa pun. Instal dari ollama.com, lalu:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
Di Apple Silicon, coba tag qwen3.8:27b-mlx, yang menggunakan backend MLX dengan ukuran sama, 18 GB.
Konteks default Ollama kecil, yang bisa merusak sesi agent yang panjang. Naikkan sebelum memulai server:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
Ollama juga menyediakan API yang kompatibel dengan OpenAI di http://localhost:11434/v1, sehingga SDK OpenAI apa pun bisa langsung bekerja hanya dengan mengganti base URL:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
Ingin menjalankannya di dalam coding agent? Ollama menyediakan shortcut peluncuran: ollama launch claude --model qwen3.8 menjalankan Claude Code terhadap model lokal, dan ollama launch opencode --model qwen3.8 melakukan hal yang sama untuk OpenCode.
Menjalankannya dengan LM Studio
LM Studio adalah pilihan terbaik jika Anda menginginkan GUI dan pengaturan pemuatan per model. Cari Qwen 3.8 27B, unduh build lmstudio-community/Qwen3.8-27B-GGUF pada Q4_K_M (16,8 GB), lalu muat.
Satu pengaturan yang penting: naikkan panjang konteks saat memuat model. Simon Willison menemukan bahwa konteks default 8.192 token gagal dengan error pada prompt panjangnya, dan ia harus memuat jendela konteks yang lebih besar.
Lalu buka tab Developer dan mulai server lokalnya, atau jalankan lms server start dari terminal. Endpoint yang kompatibel dengan OpenAI berada di http://localhost:1234/v1.
Menjalankannya dengan llama.cpp
llama.cpp memberi Anda kontrol paling luas dan menjadi mesin di balik sebagian besar pengujian benchmark di atas. Di macOS atau Linux:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf mengunduh kuantisasi langsung dari Hugging Face, --jinja menerapkan chat template model (diperlukan untuk tool call dan thinking), -c mengatur konteks, dan -ngl 99 menempatkan seluruh layer di GPU. Nilai sampling tersebut adalah rekomendasi Qwen untuk mode thinking. Untuk mode non-thinking, kartu model menyarankan temperature 0,7, top_p 0,8, top_k 20, dan presence_penalty 1,5.
Untuk mematikan thinking pada satu permintaan, kirimkan "chat_template_kwargs": {"enable_thinking": false} di body.
Menjalankannya dengan MLX di Mac
MLX adalah framework array milik Apple sendiri dan biasanya menjadi runtime tercepat di Apple Silicon untuk decode. Instal mlx-lm dan gunakan konversi 4-bit mlx-community:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server menyediakan rute /v1/chat/completions yang kompatibel dengan OpenAI. Organisasi mlx-community juga menerbitkan varian 8-bit, mxfp4, dan MTP jika Anda ingin menukar memori dengan kualitas atau kecepatan.
Biar coding agent Anda menguji endpoint lokal dengan Apidog CLI
Semua runner menyajikan format yang sama dan kompatibel dengan OpenAI, tetapi masing-masing menangani blok thinking, tool call, dan timeout secara berbeda. Sebelum Anda mengarahkan aplikasi ke localhost, mintalah coding agent Anda membangun pengujian yang dapat diulang dengan Apidog CLI, sehingga chat template yang rusak atau batas konteksi ketat terlihat dalam hitungan detik, bukan di tengah pekerjaan.
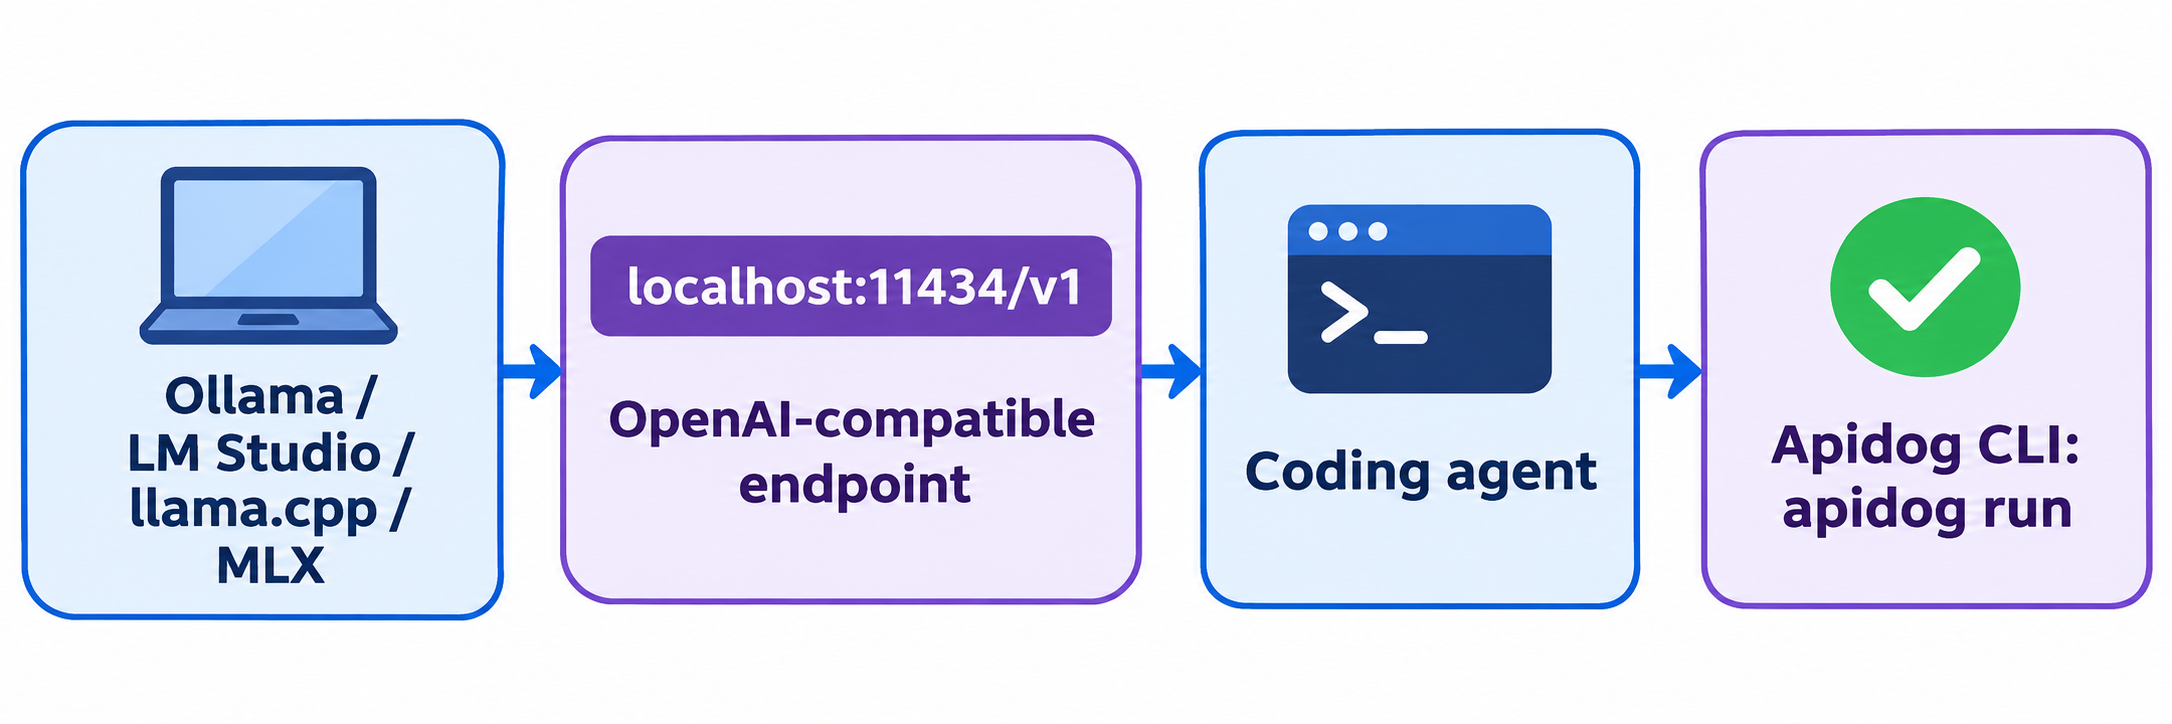
Siapkan sekali saja:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan Claude Code, Codex, atau Cursor satu prompt:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
Agent akan membaca skema setiap payload, memvalidasi JSON-nya, membuat resource-nya, dan menjalankan test case:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
--timeout-request yang panjang penting di sini: model 27B dalam mode thinking bisa membutuhkan waktu beberapa menit di Mac. Ganti base URL ke http://localhost:1234/v1 atau :8080/v1 dan test case yang sama akan memeriksa LM Studio, llama.cpp, atau MLX. Untuk konfigurasi agent lainnya, lihat Apidog CLI di Claude Code dan referensi perintah apidog run. Paket Free Apidog mencakup hingga 4 pengguna.
Lokal vs API Qwen 3.8 berbasis cloud
Menjalankan secara lokal menjaga prompt tetap di mesin Anda, bekerja offline, dan tidak berbiaya apa pun per token. Trade-off-nya adalah kecepatan dan skala: endpoint berbasis cloud menyajikan Qwen 3.8-Max yang jauh lebih besar dengan konteks 1M dan tanpa waktu tunggu prefill. Jika Anda butuh model flagshipnya, baca panduan API Qwen 3.8 kami atau cara akses gratisnya. Untuk coding agentic dengan salah satu ukuran, Qwen 3.8 untuk coding membandingkan berbagai setup harness.
FAQ
Apakah Qwen 3.8 27B gratis untuk dijalankan secara lokal? Ya. Bobotnya berlisensi Apache-2.0 di Hugging Face, dan Ollama, LM Studio, llama.cpp, serta MLX semuanya gratis. Anda hanya membayar perangkat keras dan listrik.
Bisakah saya menjalankan Qwen 3.8 27B di Mac 16 GB? Hanya pada kuantisasi 2-bit seperti UD-IQ2_XXS (7,27 GB) dengan konteks pendek, dan kualitasnya turun cukup terasa. Mac 32 GB yang menjalankan Q4_K_M adalah setup yang nyaman.
Apakah Qwen 3.8 27B bisa berjalan di RTX 3090? Ya. Q4_K_M cukup muat di 24 GB dengan ruang tersisa untuk konteks 16K hingga 32K, dan llm-speed mengukur sekitar 38 token per detik di llama.cpp.
Bagaimana cara mematikan mode thinking? Kirimkan "chat_template_kwargs": {"enable_thinking": false} di llama.cpp atau vLLM, atau turunkan reasoning_effort ke low. Qwen merekomendasikan temperature 0,7 dan top_p 0,8 untuk mode non-thinking.
Apakah model lokal mendukung gambar? Ya. Tag 18 GB milik Ollama sudah termasuk vision. Dengan llama.cpp, unduh file mmproj-F16.gguf bersama modelnya.
Apa perbedaan antara Qwen 3.8 27B dan Qwen 3.8-Max? Max adalah flagship mixture-of-experts berparameter 2,4T yang disajikan melalui API Alibaba. 27B adalah model dense yang cukup kecil untuk satu GPU atau Mac 32 GB.