
Anda dapat menjalankan Nemotron 3.5 Transcribe terbaru dari NVIDIA di satu GPU dan mentranskripsikan rekaman berdurasi satu jam dalam 40 bahasa tanpa membayar per menit atau mengirim audio ke siapa pun. Ini adalah model berbobot terbuka terbaik di Hugging Face Open ASR Leaderboard, dirilis di bawah lisensi OpenMDW-1.1 yang ramah komersial, dan NVIDIA menerbitkan bobot BF16, FP8, serta NVFP4 pada hari peluncurannya, 28 Oktober 2026.
Panduan ini membahas perangkat keras yang Anda butuhkan, tiga cara menjalankannya (vLLM, SGLang-Omni, dan Transformers), perintah persis dari kartu model resmi, serta pengaturan yang sering membuat orang tersandung. Semua perintah disalin dari kartu tersebut pada 29 Oktober 2026.
Baru mengenal model ini? Panduan gratis kami menjelaskan apa fungsinya dan bagaimana peringkatnya. Tidak punya GPU? API terkelola berbiaya $0,002 per menit.
Mengapa menjalankannya secara lokal
- Tanpa tagihan per menit. Dengan tarif DeepInfra $0,002 per menit, 10.000 jam berbiaya $1.200. Di GPU Anda sendiri, biayanya hanya listrik.
- Privasi. Panggilan pelanggan, dikte medis, dan rekaman hukum tidak pernah keluar dari jaringan Anda.
- Fitur lengkap. Jalur vLLM mendukung timestamp per kata, diarisasi pembicara, penerjemahan, dan prompt konteks. Beberapa endpoint terkelola hanya mengekspos sebagian dari itu.
- Fine-tuning. Postingan peluncuran NVIDIA menunjukkan fine-tune medis yang menurunkan WER dari 30,8% menjadi 11,8%. Anda hanya bisa melakukannya dengan bobot modelnya.
Perangkat keras: apa yang bisa menjalankannya
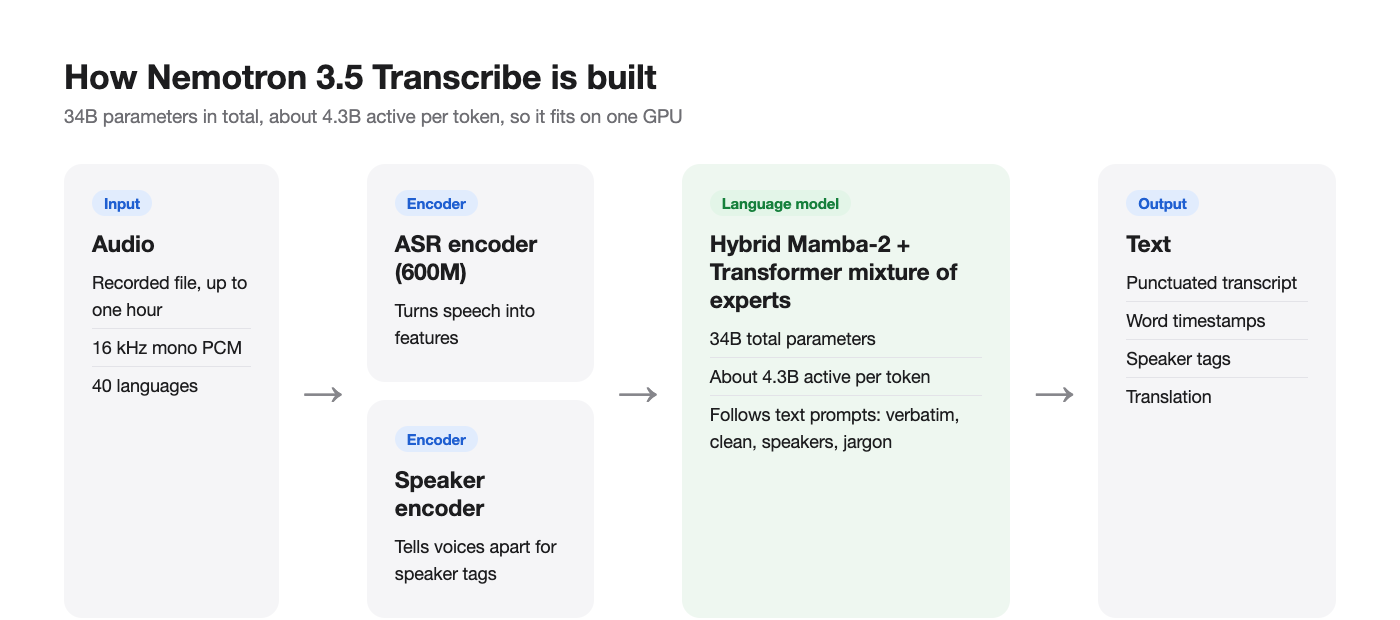
Model ini memiliki total 34B parameter dengan sekitar 4,3B aktif, sehingga bobotnya besar meskipun komputasi per token kecil. Target referensi NVIDIA adalah satu H100 80 GB dalam BF16. Tabel kompatibilitas pada kartu model:
| GPU | Presisi | Runtime |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | NVFP4 saja | vLLM 0.32.0, Transformers, GGML |
Pilih checkpoint sesuai kartu Anda:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
Kartu 24 GB seperti RTX 4090 tidak ada dalam daftar, dan Apple Silicon tidak didukung. Sistem operasinya adalah Linux, atau Windows melalui WSL2. GGML juga berjalan di Windows native, tetapi postingan peluncuran NVIDIA menyebut build lokal NeMo-Speech.cpp masih “segera hadir.”
Opsi 1: server vLLM (direkomendasikan)
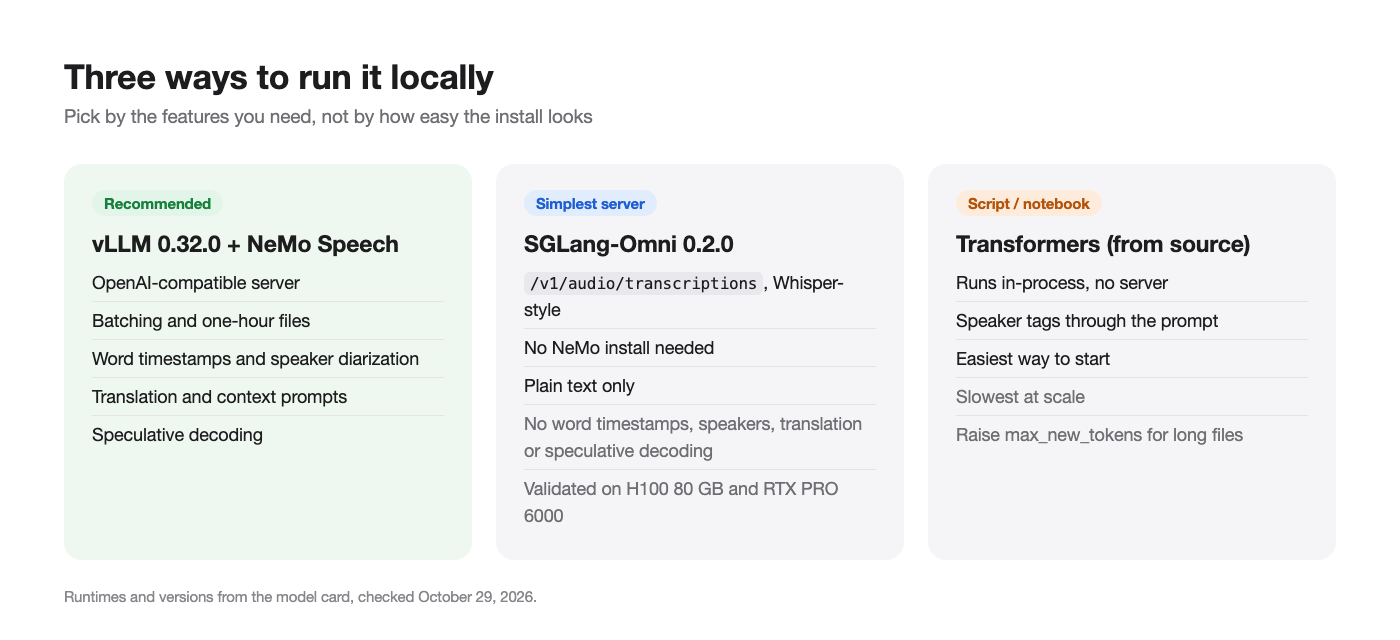
vLLM memberi Anda endpoint yang kompatibel dengan OpenAI dengan batching, file berdurasi satu jam, speculative decoding, dan timestamp per kata. Ini membutuhkan vLLM 0.32.0 plus branch main NeMo Speech terbaru, yang menyediakan plugin vLLM untuk model tersebut.
Instalasi
Kartu model menggunakan uv dan Python 3.13:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV (av) memungkinkannya mendekode M4A dan format terkompresi lain tanpa FFmpeg sistem. OpenCV ada di sana karena vLLM membutuhkannya dan pengaturan dependensi NeMo tidak menyertakannya.
Jalankan server
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
Flag yang perlu dipahami:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600menaikkan batas audio vLLM dari 600 detik menjadi satu jam. Lupakan ini dan file panjang akan gagal.VLLM_USE_V2_MODEL_RUNNER=0mempertahankan runner V1, yang dibutuhkan timestamp per kata.--speculative-configmengaktifkan prediksi multi-token dengan delapan token draf (MTP8). Di H100, NVIDIA mengukur RTFx bahasa Inggris secara batch sebesar 270 dengan MTP8 dan 410 dengan MTP2, jadi cobalah"num_speculative_tokens":2jika Anda lebih mementingkan throughput daripada latensi.--middleware ... ctc_timestamp_middlewaredan--trust-request-mm-kwargsmemungkinkan permintaan meminta timestamp per kata.- Pengaturan ini menyasar H100 80 GB. Pada kartu lain, turunkan
--gpu-memory-utilization,--max-model-len, atau--max-num-seqs.
Server mendengarkan di 127.0.0.1:8000. Tambahkan --host 0.0.0.0 agar bisa diakses dari mesin lain di jaringan Anda.
Kirim file
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
Ganti instruksi teks dengan prompt tugas apa pun. Untuk rapat dengan beberapa suara:
Transkripsikan secara verbatim, termasuk kata pengisi. Tulis angka seperti yang diucapkan, tanpa tanda baca atau huruf kapital. Awali setiap giliran pembicara dengan <spk:0>, <spk:1>, dst. Pertahankan satu tag yang stabil untuk setiap pembicara. Keluarkan hanya transkrip yang ditandai pembicara.
Permintaan timestamp per kata memiliki aturan: satu rekaman per permintaan, stream=false dan n=1. Responsnya kemudian menyertakan objek ctc_timestamps berisi kata, waktu mulai dan selesai dalam detik, serta tag pembicara.
Opsi 2: SGLang-Omni untuk transkripsi biasa
Jika Anda hanya butuh teks dari file utuh, SGLang-Omni 0.2.0 lebih sederhana dan tidak memerlukan NeMo. Ini tervalidasi pada satu H100 80 GB dan satu RTX PRO 6000 Blackwell dengan checkpoint BF16 atau FP8.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
Rute /v1/audio/transcriptions tersebut cocok dengan bentuk yang digunakan Whisper API milik OpenAI, sehingga kode klien Whisper yang ada sering kali hanya perlu base URL baru. Komprominya: tidak ada timestamp per kata, label pembicara, penerjemahan, atau speculative decoding dalam integrasi ini.
Opsi 3: Transformers dalam skrip
Untuk notebook dan pekerjaan sekali jalan, jalankan secara in-process dengan Hugging Face Transformers yang dipasang dari sumber:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
Ini cara termudah untuk memulai dan cara paling lambat untuk menjalankan dalam skala besar. Naikkan max_new_tokens untuk file panjang: satu jam audio padat dapat menghasilkan sekitar 20.000 token.
Seberapa cepat di GPU Anda sendiri?
Angka utama NVIDIA adalah 2.238 detik audio per detik pada satu RTX PRO 6000 Blackwell, dengan bobot NVFP4 dan speculative decoding DFlash2, serta 0,13 detik untuk mengembalikan klip 30 detik. Baca catatan kakinya: angka-angka itu berasal dari NIM yang dioptimalkan, yang perubahan penyajiannya belum open source. Kartu model menyebut integrasi vLLM terbuka diperkirakan sekitar dua kali lebih lambat.
Untuk transkripsi bahasa Inggris secara batch di H100 dalam BF16, kartu model mencantumkan angka RTFx berikut (detik audio per detik komputasi):
| Speculative decoding | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
Bahkan baris paling lambat menyelesaikan satu jam audio dalam waktu kurang dari 15 detik waktu GPU pada pekerjaan batch. Jika Anda menginginkan model draf DFlash2, perhatikan bahwa vLLM 0.32.0 memerlukan patch kecil dari kartu model, DFlash2 menonaktifkan timestamp per kata, dan Anda tidak boleh menggabungkannya dengan MTP.
Masalah umum dan solusinya
- File panjang terpotong di menit ke-10. Anda melewatkan
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600. - Tidak ada timestamp dalam respons. Periksa
VLLM_USE_V2_MODEL_RUNNER=0, flag--middleware, dan pastikan permintaan memilikistream=falseserta satu rekaman. - Kehabisan memori pada kartu yang lebih kecil. Beralihlah ke checkpoint FP8 atau NVFP4 dan turunkan
--max-num-seqs. - Frasa berulang di akhir transkrip. Kartu model merekomendasikan pengaman loop generasi pada keluaran akhir. Batasi
max_tokensdan potong pengulangan. - Ejaan nama salah. Tambahkan
Context terms: <names>ke prompt. - Suara latar muncul di transkrip. Coba prompt near-field eksperimental dari kartu model, yang menurunkan WER pada audio campuran dari 27,32% menjadi 4,78% dalam pengujian NVIDIA.
Jika Anda baru mengenal vLLM sendiri, penjelasan vLLM kami membahas cara ia melakukan batching permintaan dan mengelola memori GPU.
Biarkan agen coding Anda menguji server lokal dengan Apidog CLI
Model lokal hanya berguna jika endpoint-nya tetap benar di seluruh peningkatan versi vLLM, penyesuaian prompt, dan penggantian checkpoint. Biarkan agen coding Anda menanganinya dengan Apidog CLI, yang menjalankan pemeriksaan terhadap http://127.0.0.1:8000 dari mesin yang sama.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt kepada agen Anda:
Di proyek Apidog <id>, tambahkan POST {{baseUrl}}/v1/chat/completions untuk server
Nemotron 3.5 Transcribe lokal saya. Buat test case yang mengirim samples/en.wav dan
samples/two-speakers.wav sebagai konten audio_url base64 dengan temperature 0, dan pastikan
status 200, choices[0].message.content tidak kosong, dan setidaknya ada dua tag <spk:N>
yang berbeda untuk file dua pembicara. Jalankan semuanya terhadap lingkungan lokal dan laporkan kegagalannya.
Agen membaca skema, memvalidasi payload-nya, menulis test case, dan menjalankannya:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Jalankan setelah setiap peningkatan server, atau sambungkan apidog run ... -r junit ke CI seperti yang ditunjukkan di Apidog CLI dalam pipeline CI/CD. Untuk penyiapan agen, lihat Apidog CLI di Claude Code.
FAQ
Bisakah saya menjalankan Nemotron 3.5 Transcribe di RTX 4090? Kartu itu tidak ada dalam daftar kompatibilitas NVIDIA. Kartu konsumen terkecil yang terdaftar adalah RTX 5090 dengan checkpoint NVFP4.
Apakah bisa berjalan di Mac? Tidak ada runtime resmi yang mendukung Apple Silicon per 29 Oktober 2026.
Apakah penggunaan lokal gratis untuk produk komersial? Lisensi OpenMDW-1.1 mengizinkan penggunaan komersial dan non-komersial. Bacalah teks lisensinya untuk ketentuan atribusi sebelum merilis produk.
Bisakah ia mentranskripsikan audio langsung? Tidak. Ini adalah model offline untuk file rekaman. NVIDIA menawarkan model terpisah, Nemotron 3.5 ASR Streaming, untuk penggunaan langsung.
Mana yang lebih cepat, vLLM atau SGLang-Omni? NVIDIA tidak menerbitkan perbandingan langsung. Gunakan vLLM saat Anda membutuhkan timestamp, pembicara, atau penerjemahan, dan SGLang-Omni untuk server teks-saja yang paling sederhana.
Bagaimana peringkatnya dibandingkan model lokal lain? Ia memimpin semua model berbobot terbuka pada Open ASR Leaderboard 28 Oktober. Daftar model speech-to-text open source terbaik kami membandingkannya dengan Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral, dan Whisper.
Jalankan
Unduh checkpoint yang sesuai dengan GPU Anda, jalankan vLLM dengan batas audio satu jam dan middleware timestamp, lalu kirim file WAV melalui klien OpenAI. Setelah itu biarkan agen Anda menjalankan pemeriksaan Apidog terhadap endpoint lokal sehingga setiap peningkatan versi membuktikan bahwa model masih bisa mentranskripsikan sebelum Anda mempercayakannya dengan rekaman nyata.