
Mencari model bahasa AI ringkas yang memberikan kinerja kuat pada perangkat keras lokal? Google Gemma 3 270M adalah yang terkecil dalam seri Gemma, menawarkan 270 juta parameter dan kemampuan yang tangguh—tanpa permintaan sumber daya yang besar dari model yang lebih besar. Sempurna untuk pengembang yang membangun fitur AI yang aman dan latensi rendah, Gemma 3 270M mendukung pembuatan teks, Tanya Jawab, ringkasan, dan banyak lagi—semuanya di perangkat Anda sendiri.
Tips: Integrasikan Gemma 3 270M dengan mulus ke dalam aplikasi berbasis API Anda dengan Apidog—platform terpadu untuk merancang, menguji, membuat mock, dan mendokumentasikan API yang terhubung ke model AI lokal Anda. Apidog mempercepat pengembangan dan memastikan fitur AI Anda dapat diandalkan mulai dari prototipe hingga produksi.
Mengapa Menggunakan Gemma 3 270M untuk Tugas AI Lokal?
Gemma 3 270M dirancang untuk pengembang yang memprioritaskan:
- Privasi di perangkat: Data tidak pernah meninggalkan perangkat keras Anda.
- Latensi rendah: Respons instan, ideal untuk fitur real-time.
- Efisiensi sumber daya: Berjalan di laptop, desktop, atau bahkan perangkat seluler.
Dengan jendela konteks hingga 32.000 token dan opsi kuantisasi seperti Q4_0 QAT, Gemma 3 270M menyeimbangkan akurasi dengan persyaratan memori dan komputasi yang minimal. Capai hasil presisi mendekati penuh sambil menggunakan memori kurang dari 200MB dalam mode INT4—keuntungan signifikan untuk penerapan edge dan seluler.
Arsitektur Gemma 3 270M: Apa yang Membuatnya Efisien?
Google Gemma 3 270M dibangun di atas kerangka kerja berbasis transformator dengan:
- 170 juta parameter untuk embeddings (mendukung kosakata 256.000 token)
- 100 juta parameter untuk blok transformator
- Dukungan multibahasa dan kemampuan beradaptasi untuk tugas khusus
- Kuantisasi INT4, rotary position embeddings, dan group query attention untuk kecepatan dan efisiensi
Model ini unggul dalam mengikuti instruksi, ekstraksi data, dan tugas kreatif seperti peringkasan atau pemeriksaan kepatuhan. Tolok ukur menunjukkan Gemma 3 270M mencapai skor F1 yang tinggi pada IFEval, menjadikannya pilihan yang kuat untuk proyek teknis dan kreatif—terutama di mana memori dan penggunaan baterai menjadi perhatian utama.
Manfaat Utama Menjalankan Gemma 3 270M Secara Lokal
- Privasi Data: Semua pemrosesan tetap di perangkat Anda, mengurangi risiko paparan.
- Latensi Rendah: Waktu respons milidetik, bahkan untuk tugas yang kompleks.
- Tanpa Biaya Cloud: Hilangkan biaya berulang untuk API AI berbasis cloud.
- Efisiensi Energi: Hanya menggunakan 0,75% baterai Pixel 9 Pro untuk 25 percakapan terkuantisasi INT4.
- Penyetelan Mudah: Adaptasi model ke dataset Anda menggunakan metode ringan seperti LoRA.
- Tim yang Berdaya: Tim kecil dan pengembang tunggal dapat bereksperimen dan berulang tanpa ketergantungan cloud.
Persyaratan Sistem: Perangkat Keras Apa yang Anda Butuhkan?
Gemma 3 270M dapat diakses oleh sebagian besar pengembang:
- Inferensi hanya CPU: RAM 4GB dan prosesor modern (misalnya, Intel Core i5)
- Akselerasi GPU: VRAM 2GB pada kartu NVIDIA (untuk model terkuantisasi)
- Apple Silicon: Kinerja tinggi melalui MLX-LM (650+ token/dtk pada M4 Max)
- Penyetelan: RAM 8GB dan GPU dengan VRAM 4GB direkomendasikan untuk dataset kecil
- OS: Windows, macOS, atau Linux
- Perangkat Lunak: Python 3.10+ untuk kompatibilitas pustaka
- Penyimpanan: ~1GB untuk file model
Memilih Alat Inferensi Lokal Anda: Perbandingan Singkat
Beberapa kerangka kerja membuat menjalankan Gemma 3 270M secara lokal menjadi mudah:
- Hugging Face Transformers: Fleksibilitas maksimum, scripting Python, dan opsi integrasi.
- LM Studio: GUI intuitif untuk manajemen model yang mudah—ideal untuk non-coder.
- llama.cpp: Berbasis C++, dioptimalkan untuk kinerja dan kustomisasi tingkat rendah.
- MLX (Apple): Dioptimalkan untuk chip Apple M-series.
Paling cocok:
- Pemula: LM Studio
- Pengembang/Insinyur: Transformers atau llama.cpp
Langkah demi Langkah: Menjalankan Gemma 3 270M dengan Hugging Face Transformers
1. Instal Pustaka yang Diperlukan
pip install transformers torch
2. Muat Model di Python
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "google/gemma-3-270m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
3. Jalankan Inferensi
input_text = "Explain quantum computing in simple terms."
inputs = tokenizer(input_text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(response)
4. Aktifkan Kuantisasi (Kurangi Penggunaan Memori)
from transformers import BitsAndBytesConfig
quant_config = BitsAndBytesConfig(load_in_4bit=True)
model = AutoModelForCausalLM.from_pretrained(model_name, quantization_config=quant_config)
5. Akses Model Tertutup (jika diperlukan)
from huggingface_hub import login
login(token="your_hf_token")
Dapatkan token Anda dari akun Hugging Face Anda.
Langkah demi Langkah: Menjalankan Gemma 3 270M dengan LM Studio
LM Studio menawarkan pendekatan visual untuk mengelola model AI lokal.
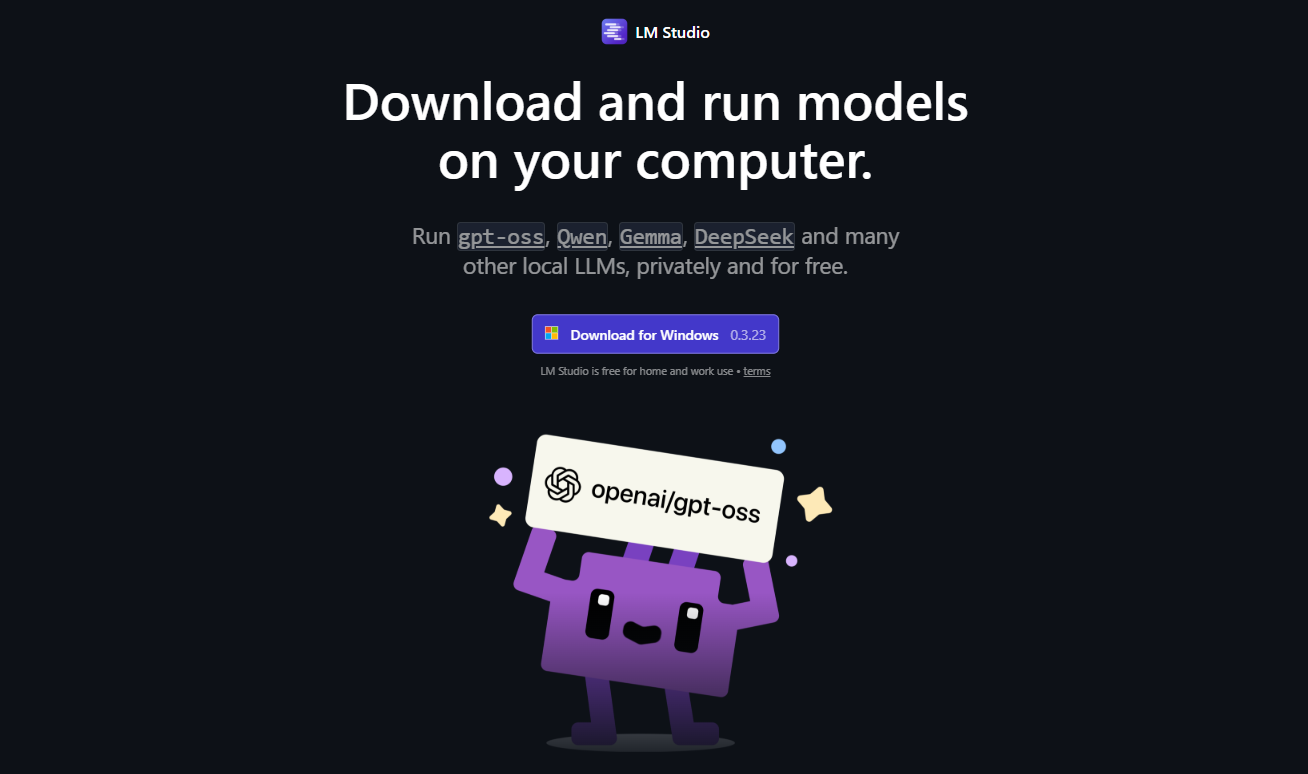
1. Unduh LM Studio dari lmstudio.ai dan instal.
2. Cari "gemma-3-270m" di hub model.
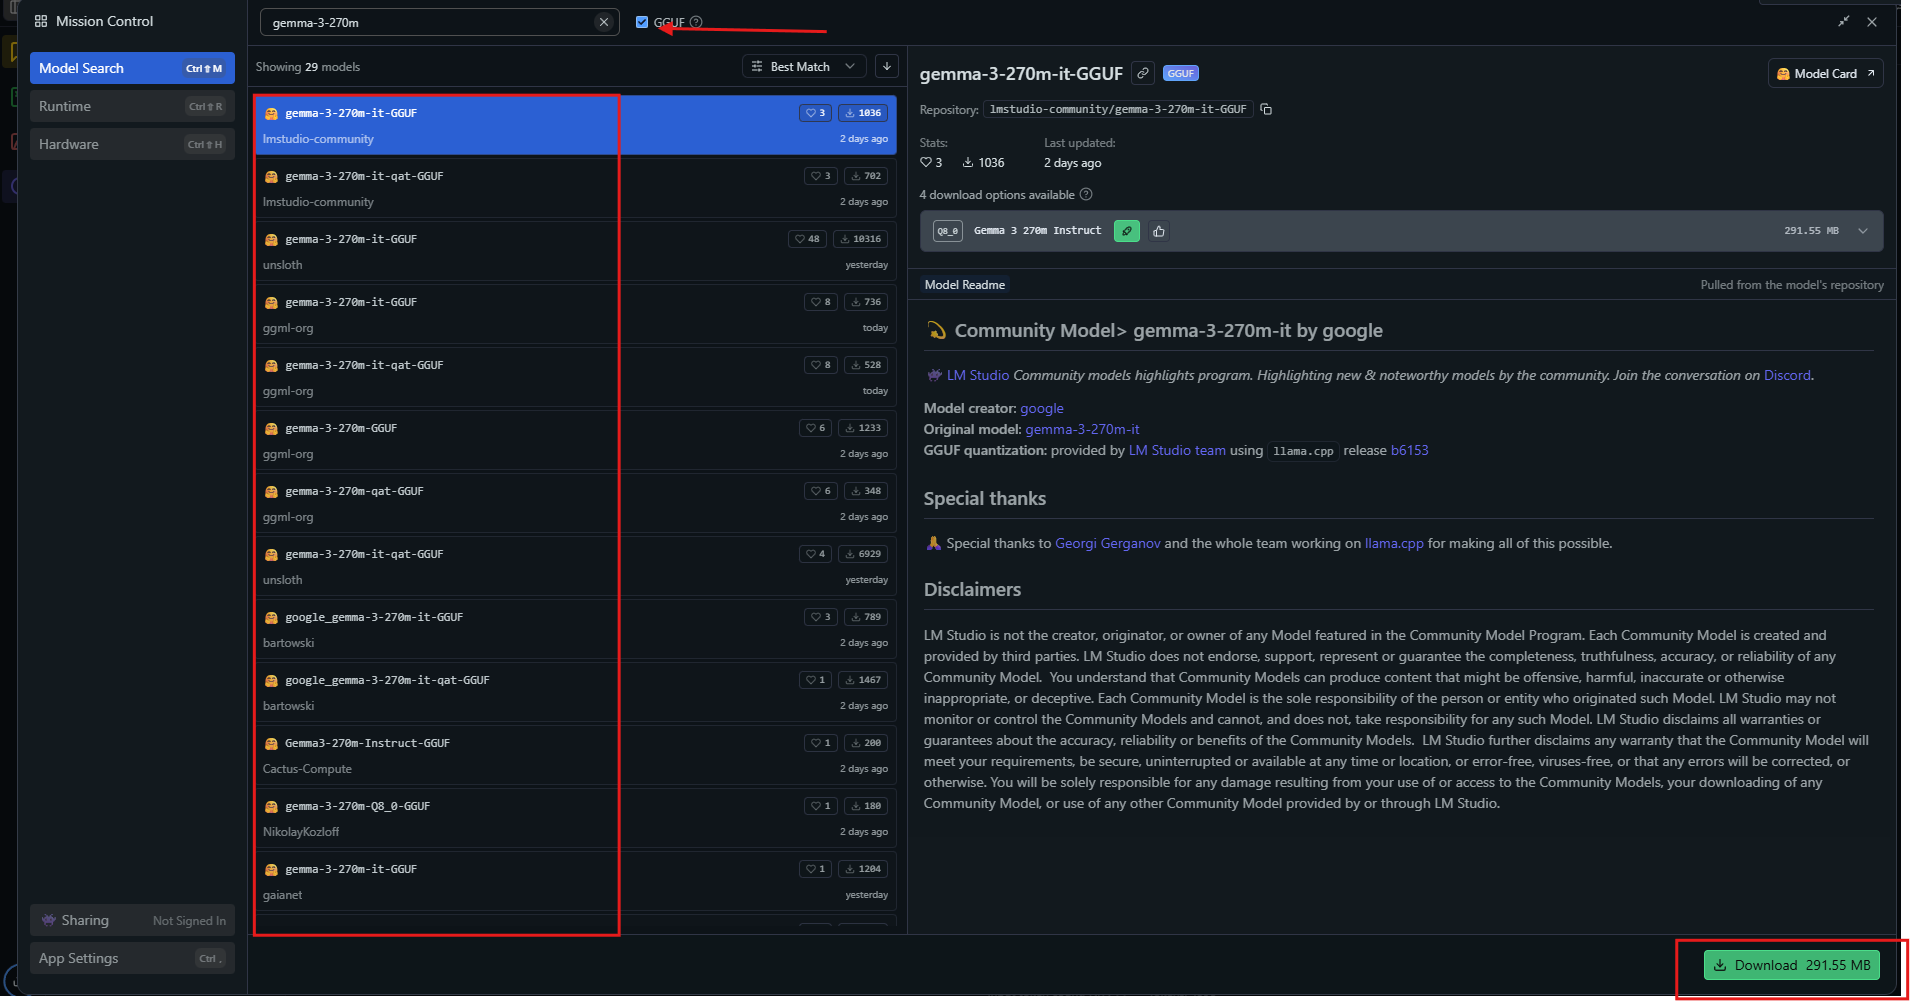
3. Unduh varian terkuantisasi (misalnya, Q4_0).
4. Muat model, atur parameter (konteks: 32k, suhu: 1.0), dan mulai mengobrol.
5. Aktifkan offloading GPU untuk kecepatan yang lebih baik jika tersedia.
LM Studio ideal untuk prototyping cepat atau tim yang mencari antarmuka tanpa kode.
Langkah demi Langkah: Menjalankan Gemma 3 270M dengan llama.cpp
Untuk efisiensi optimal, terutama pada sistem tertanam atau terbatas sumber daya, coba llama.cpp.
1. Kloning repositori llama.cpp:
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make -j
2. Unduh file GGUF dari Hugging Face:
huggingface-cli download unsloth/gemma-3-270m-it-GGUF --include "*.gguf"
3. Jalankan Model:
./llama-cli -m gemma-3-270m-it-Q4_K_M.gguf -p "Build a simple AI app."
4. (Opsional) Kompilasi dengan CUDA untuk GPU NVIDIA:
make GGML_CUDA=1
Atur parameter seperti --n-gpu-layers 999 untuk pemanfaatan GPU penuh.
Contoh Dunia Nyata: Gemma 3 270M dalam Alur Kerja API
Integrasikan Gemma 3 270M ke dalam tumpukan API Anda untuk:
1. Analisis Sentimen
prompt = "Classify: This product is amazing!"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
print(tokenizer.decode(outputs[0]))
# Output: Positive.
2. Ringkasan
text = "Long article here..."
prompt = f"Summarize: {text}"
# Gunakan model untuk membuat ringkasan
3. Tanya Jawab
Prompt:Apa penyebab perubahan iklim?
Model mengembalikan penjelasan singkat yang cocok untuk chatbot atau API basis pengetahuan.
4. Ekstraksi Entitas Kesehatan
Masukkan catatan klinis dan ekstrak entitas kunci untuk analisis terstruktur—ideal untuk pemrosesan lokal yang sesuai dengan HIPAA.
Tips Pro: Gunakan Apidog untuk merancang, membuat mock, dan menguji API yang menghubungkan endpoint model ini, memastikan integrasi AI yang kuat dan siap produksi.
Penyetelan Gemma 3 270M untuk Tugas Kustom
Adaptasi Gemma 3 270M ke domain khusus melalui fine-tuning efisien parameter (LoRA):
pip install peft
from peft import LoraConfig, get_peft_model
lora_config = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)

from transformers import Trainer, TrainingArguments
trainer = Trainer(model=model, args=TrainingArguments(output_dir="./results"))
trainer.train()
- Latih dengan dataset kecil pada perangkat keras sederhana
- Simpan dan muat ulang adapter untuk perpindahan tugas yang cepat
- Cegah overfitting dengan memantau kerugian dan akurasi validasi
Tips Optimasi Kinerja
- Kuantisasi ke 4-bit atau 8-bit untuk trade-off kecepatan/memori terbaik
- Batch inferensi untuk memaksimalkan throughput
- Sesuaikan parameter generasi: temperature=1.0, top_k=64, top_p=0.95
- Aktifkan presisi campuran pada GPU yang kompatibel
- Pantau penggunaan VRAM (
nvidia-smi) - Perbarui pustaka secara teratur untuk peningkatan kinerja terbaru
Hindari jebakan: Jangan memasukkan token BOS dua kali dalam prompt; kelola jendela konteks untuk mencegah pemotongan.
Kesimpulan: Bangun Aplikasi AI yang Cepat dan Aman Secara Lokal
Dengan Gemma 3 270M, Anda mendapatkan kebebasan untuk menerapkan AI canggih sesuai keinginan Anda—tanpa penguncian cloud, tanpa kompromi privasi. Baik Anda menggerakkan chatbot, mengekstrak data, atau mempercepat alur kerja internal, Gemma 3 270M memberikan pemahaman bahasa yang efisien dan andal pada perangkat keras lokal.
Jelajahi bagaimana Apidog dapat lebih merampingkan siklus hidup pengembangan API Anda—menghubungkan model AI lokal Anda dengan mulus ke backend, frontend, atau integrasi pihak ketiga Anda.