
Pengembang dan penggemar AI terus-menerus mencari model efisien yang berkinerja baik tanpa menuntut sumber daya besar. Google memperkenalkan Gemma 3 270M, model bahasa ringkas dengan 270 juta parameter. Model ini menonjol sebagai yang terkecil dalam keluarga Gemma 3, dioptimalkan untuk tugas-tugas di perangkat. Anda mendapatkan kemampuan dalam pembuatan teks, menjawab pertanyaan, peringkasan, dan penalaran, semuanya sambil menjaga operasi tetap lokal.
Gemma 3 270M mendukung panjang konteks 32.000 token, yang memungkinkannya menangani input yang substansial secara efektif. Selain itu, ia menggabungkan teknik kuantisasi seperti Q4_0 Quantization Aware Training (QAT), mengurangi kebutuhan sumber daya tanpa mengorbankan kualitas. Hasilnya, Anda mencapai kinerja yang mendekati model presisi penuh tetapi dengan kebutuhan memori dan komputasi yang lebih rendah.
Namun, yang membuat Gemma 3 270M sangat menarik terletak pada aksesibilitasnya. Anda dapat menjalankannya pada perangkat keras standar, termasuk laptop atau bahkan perangkat seluler, mempromosikan privasi dan aplikasi latensi rendah. Selanjutnya, pertimbangkan bagaimana model ini cocok dengan tren pengembangan AI yang lebih luas, di mana efisiensi mendorong inovasi.
Memahami Arsitektur Gemma 3 270M
Google membangun Gemma 3 270M di atas arsitektur berbasis transformer, menampilkan 170 juta parameter untuk embedding dengan kosakata 256.000 token dan 100 juta untuk blok transformer. Pengaturan ini memungkinkan dukungan multibahasa dan penanganan tugas khusus. Anda mendapatkan manfaat dari teknik seperti kuantisasi INT4, embedding posisi putar (rotary position embeddings), dan perhatian kueri kelompok (group query attention), yang meningkatkan kecepatan dan keringanan inferensi.
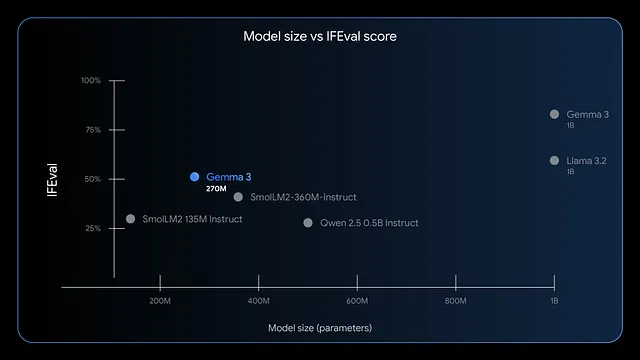
Selain itu, model ini unggul dalam mengikuti instruksi dan ekstraksi data. Tolok ukur menunjukkan skor F1 yang tinggi pada IFEval, menunjukkan kinerja yang kuat dalam tugas evaluasi. Dibandingkan dengan model yang lebih besar seperti GPT-4 atau Phi-3 Mini, Gemma 3 270M memprioritaskan efisiensi, menggunakan kurang dari 200MB dalam mode 4-bit pada perangkat seperti Apple M4 Max.
Akibatnya, Anda dapat menerapkannya untuk skenario yang menuntut respons cepat, seperti analisis sentimen real-time atau ekstraksi entitas perawatan kesehatan. Namun, ukurannya yang kecil tidak membatasi kreativitas; Anda dapat menerapkannya untuk penulisan kreatif atau pemeriksaan kepatuhan keuangan. Ke depan, evaluasi keuntungan menjalankan model ini secara lokal.
Manfaat Menjalankan Gemma 3 270M Secara Lokal
Anda meningkatkan privasi dengan menjaga data tetap di perangkat Anda, menghindari transmisi cloud yang berisiko terpapar. Gemma 3 270M mengurangi latensi, memberikan respons dalam milidetik daripada detik. Selain itu, ini memangkas biaya karena Anda menghindari biaya langganan untuk API berbasis cloud.
Selain itu, efisiensi energi model ini menonjol. Ini hanya mengonsumsi 0,75% baterai Pixel 9 Pro untuk 25 percakapan dalam mode terkuantisasi INT4. Karakteristik ini cocok untuk komputasi seluler dan edge, di mana daya menjadi penting. Anda juga dapat menyesuaikan model dengan mudah melalui fine-tuning dengan alat seperti LoRA, hanya membutuhkan data minimal.
Meskipun demikian, eksekusi lokal memberdayakan tim kecil atau pengembang individu. Anda dapat bereksperimen dengan bebas, mengulang aplikasi seperti perutean kueri e-commerce atau penataan teks hukum. Saat Anda melanjutkan, periksa apakah sistem Anda memenuhi persyaratan.
Persyaratan Sistem untuk Inferensi Gemma 3 270M
Gemma 3 270M membutuhkan perangkat keras yang sederhana, membuatnya mudah diakses. Untuk inferensi hanya CPU, Anda memerlukan setidaknya 4GB RAM dan prosesor modern seperti Intel Core i5 atau yang setara. Namun, akselerasi GPU meningkatkan kecepatan; kartu NVIDIA dengan 2GB VRAM sudah cukup untuk versi terkuantisasi.
Secara khusus, dalam mode 4-bit, model ini muat dalam memori 200MB, memungkinkan dijalankan pada perangkat dengan sumber daya terbatas. Pengguna Apple silicon mendapatkan manfaat dari MLX-LM, mencapai lebih dari 650 token per detik pada M4 Max. Untuk fine-tuning, alokasikan 8GB RAM dan GPU dengan 4GB VRAM untuk menangani kumpulan data kecil secara efisien.
Yang penting, sistem operasi seperti Windows, macOS, atau Linux berfungsi, tetapi pastikan Python 3.10+ untuk kompatibilitas pustaka. Penyimpanan membutuhkan sekitar 1GB untuk file model. Dengan ini, Anda dapat menginstal dan menjalankan tanpa masalah. Sekarang, jelajahi metode instalasi.
Memilih Alat yang Tepat untuk Menjalankan Gemma 3 270M Secara Lokal
Beberapa kerangka kerja mendukung Gemma 3 270M, masing-masing menawarkan kekuatan unik. Hugging Face Transformers menyediakan fleksibilitas untuk skrip Python dan integrasi. LM Studio menawarkan antarmuka yang ramah pengguna untuk manajemen model.
Selain itu, llama.cpp memungkinkan inferensi berbasis C++ yang efisien, sempurna untuk optimasi tingkat rendah. Untuk perangkat Apple, MLX mengoptimalkan kinerja pada chip seri-M. Anda memilih berdasarkan keahlian Anda; pemula lebih memilih LM Studio, sementara pengembang cenderung memilih Transformers.
Dengan demikian, alat-alat ini mendemokratisasi akses. Di bagian-bagian berikut, ikuti panduan langkah demi langkah untuk metode populer.
Panduan Langkah demi Langkah: Menjalankan Gemma 3 270M dengan Hugging Face Transformers
Anda mulai dengan menginstal pustaka yang diperlukan. Buka terminal Anda dan jalankan:
pip install transformers torch
Perintah ini mengambil Transformers dan PyTorch. Selanjutnya, impor komponen dalam skrip Python:
from transformers import AutoTokenizer, AutoModelForCausalLM
Muat model dan tokenizer:
model_name = "google/gemma-3-270m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
The device_map="auto" menempatkan model di GPU jika tersedia. Siapkan input Anda:
input_text = "Explain quantum computing in simple terms."
inputs = tokenizer(input_text, return_tensors="pt").to(model.device)
Hasilkan output:
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(response)
Ini menghasilkan penjelasan yang koheren. Untuk mengoptimalkan, tambahkan kuantisasi:
from transformers import BitsAndBytesConfig
quant_config = BitsAndBytesConfig(load_in_4bit=True)
model = AutoModelForCausalLM.from_pretrained(model_name, quantization_config=quant_config)
Kuantisasi mengurangi penggunaan memori. Anda menangani kesalahan dengan memastikan login Hugging Face untuk model yang dibatasi aksesnya:
from huggingface_hub import login
login(token="your_hf_token")
Dapatkan token dari akun Hugging Face Anda. Dengan pengaturan ini, Anda dapat menjalankan inferensi berulang kali. Namun, untuk pengguna non-Python, pertimbangkan LM Studio selanjutnya.
Panduan Langkah demi Langkah: Menjalankan Gemma 3 270M dengan LM Studio
LM Studio menyediakan antarmuka yang intuitif. Unduh dari lmstudio.ai dan instal.
Luncurkan aplikasi, lalu cari "gemma-3-270m" di hub model.
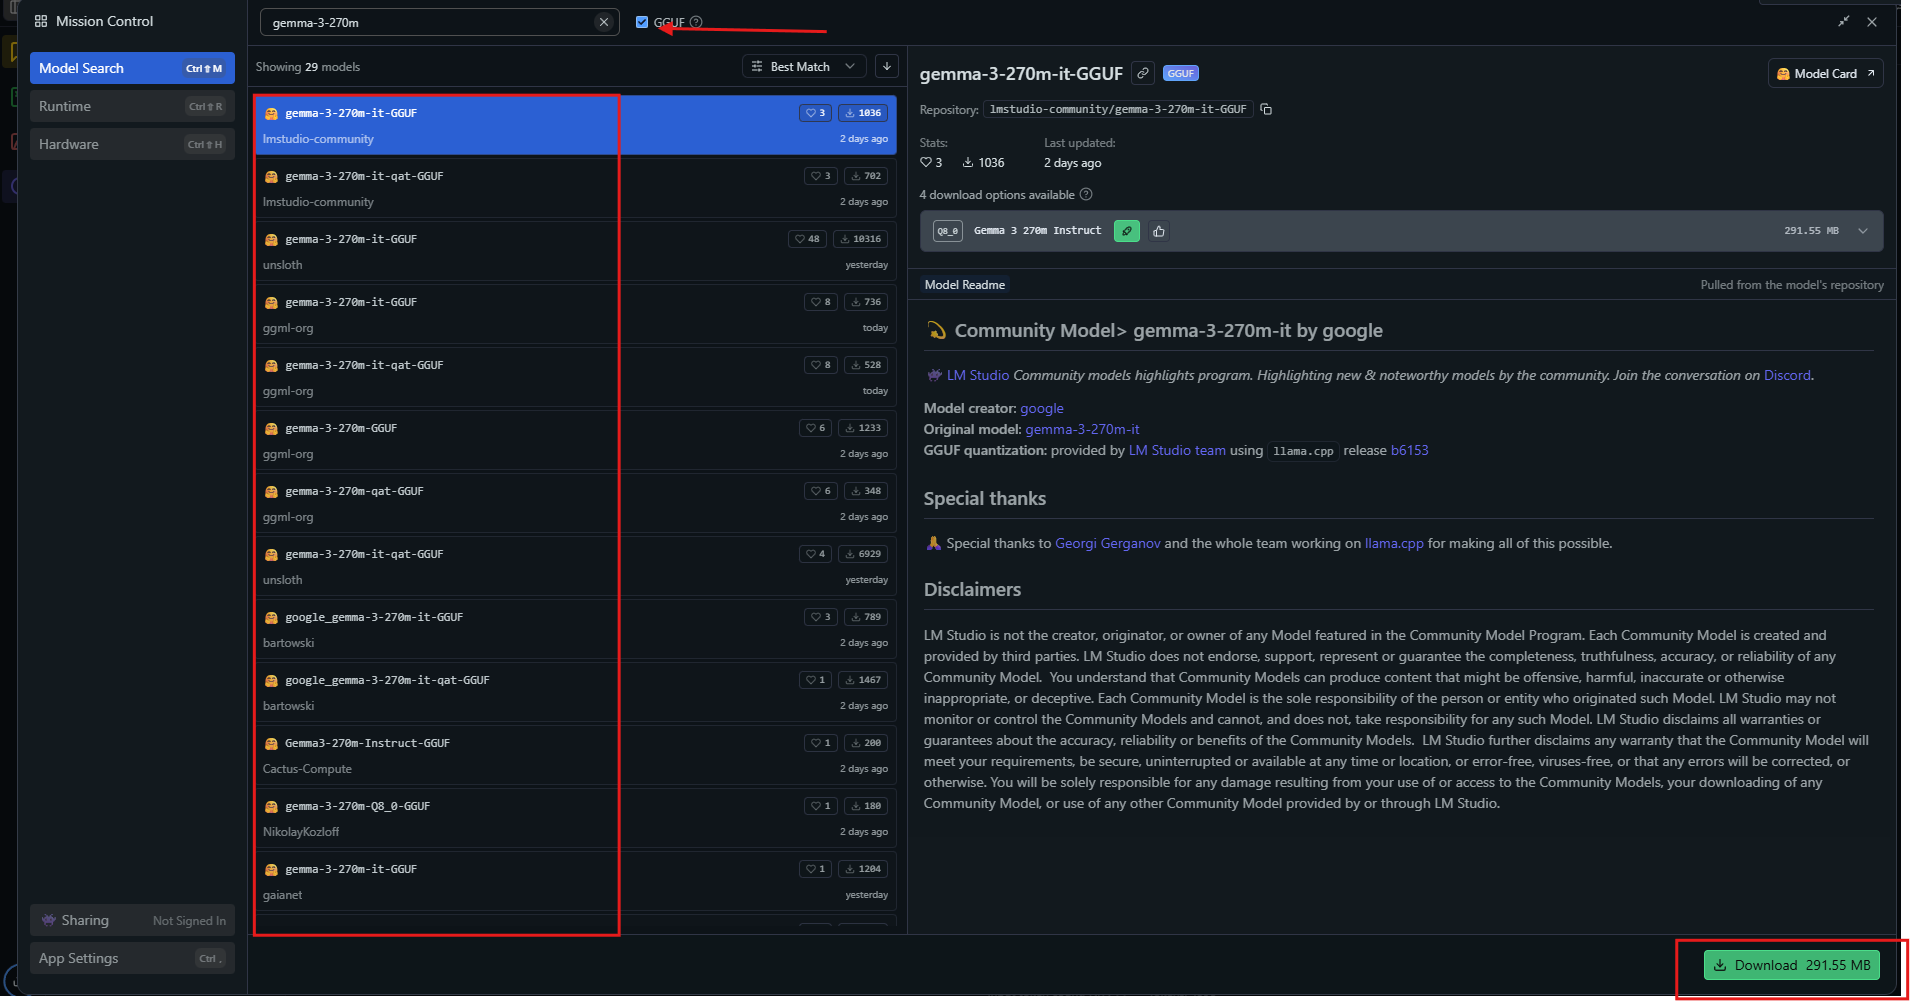
Pilih varian terkuantisasi seperti Q4_0 dan unduh. Setelah siap, muat model dari bilah samping. Sesuaikan pengaturan: atur konteks ke 32k, suhu ke 1.0.
Masukkan prompt di jendela obrolan dan tekan kirim. LM Studio menampilkan respons dengan kecepatan token. Ekspor obrolan atau lakukan fine-tune melalui alat terintegrasi.
Untuk penggunaan lanjutan, aktifkan offloading GPU di pengaturan. LM Studio secara otomatis memilih sumber optimal, memastikan kompatibilitas. Metode ini cocok untuk pembelajar visual. Selain itu, jelajahi llama.cpp untuk penyesuaian kinerja.
Panduan Langkah demi Langkah: Menjalankan Gemma 3 270M dengan llama.cpp
llama.cpp menawarkan inferensi efisiensi tinggi. Kloning repositori:
git clone https://github.com/ggerganov/llama.cpp
Bangun:
make -j
Unduh file GGUF dari Hugging Face:
huggingface-cli download unsloth/gemma-3-270m-it-GGUF --include "*.gguf"
Jalankan inferensi:
./llama-cli -m gemma-3-270m-it-Q4_K_M.gguf -p "Build a simple AI app."
Tentukan parameter seperti --n-gpu-layers 999 untuk penggunaan GPU penuh. llama.cpp mendukung tingkat kuantisasi, menyeimbangkan kecepatan dan akurasi. Anda mengompilasi dengan CUDA untuk GPU NVIDIA:
make GGML_CUDA=1
Ini mempercepat pemrosesan. llama.cpp unggul dalam sistem tertanam. Sekarang, terapkan model dalam contoh praktis.
Contoh Praktis Penggunaan Gemma 3 270M Secara Lokal
Anda membuat penganalisis sentimen. Masukkan ulasan pelanggan, dan model mengklasifikasikannya sebagai positif atau negatif. Buat skripnya di Python:
prompt = "Classify: This product is amazing!"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
print(tokenizer.decode(outputs[0]))
Gemma 3 270M menghasilkan "Positif." Perluas ke peringkasan:
text = "Long article here..."
prompt = f"Summarize: {text}"
# Generate summary
Ini memadatkan konten secara efektif. Untuk menjawab pertanyaan, tanyakan:
"Apa penyebab perubahan iklim?"
Model ini menjelaskan gas rumah kaca. Dalam perawatan kesehatan, ekstrak entitas dari catatan. Penggunaan ini menunjukkan keserbagunaan. Selanjutnya, lakukan fine-tune untuk spesialisasi.
Fine-Tuning Gemma 3 270M Secara Lokal
Fine-tuning mengadaptasi model. Gunakan pustaka PEFT Hugging Face:
pip install peft
Muat dengan konfigurasi LoRA:
from peft import LoraConfig, get_peft_model
lora_config = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)
Siapkan kumpulan data, lalu latih:
from transformers import Trainer, TrainingArguments
trainer = Trainer(model=model, args=TrainingArguments(output_dir="./results"))
trainer.train()
LoRA membutuhkan sedikit data, selesai dengan cepat pada perangkat keras yang sederhana. Simpan dan muat ulang adaptor. Ini meningkatkan kinerja pada tugas khusus seperti prediksi langkah catur. Namun, pantau overfitting.
Tips Optimasi Kinerja untuk Gemma 3 270M
Anda memaksimalkan kecepatan dengan mengkuantisasi ke 4-bit atau 8-bit. Gunakan batching untuk beberapa inferensi. Atur suhu ke 1.0, top_k=64, top_p=0.95 seperti yang direkomendasikan.
Pada GPU, aktifkan presisi campuran. Untuk konteks yang panjang, kelola cache KV dengan hati-hati. Pantau VRAM dengan alat seperti nvidia-smi. Perbarui pustaka secara teratur untuk optimasi.
Akibatnya, penyesuaian ini menghasilkan lebih dari 130 token per detik pada perangkat keras yang sesuai. Hindari kesalahan umum seperti token BOS ganda dalam prompt. Dengan latihan, Anda mencapai eksekusi yang efisien.
Kesimpulan
Anda kini memiliki pengetahuan untuk menjalankan Gemma 3 270M secara lokal. Dari pengaturan hingga optimasi, setiap langkah membangun kemampuan. Bereksperimen, melakukan fine-tune, dan menyebarkan untuk mewujudkan potensinya. Model kecil seperti ini memberikan dampak besar dalam aksesibilitas AI.