
Untuk menjalankan ERNIE 5.5 Flash secara lokal, instal vLLM 0.32.0 beserta plugin vLLM-ERNIE dari Baidu, lalu jalankan vllm serve baidu/ERNIE-5.5-Flash-Base dengan data dan expert parallelism di node multi-GPU. Anda akan mendapatkan server yang kompatibel dengan OpenAI di port 8000. Kendalanya: bobot terbuka yang tersedia saat ini adalah model Base, checkpoint pretraining yang melanjutkan teks, bukan model chat.
Di bawah ini: apa saja yang bisa diunduh, spesifikasi hardware yang tercantum oleh Baidu, perintah serve yang tepat, dan cara menguji endpoint-nya. Setiap perintah dan angka di bawah berasal dari model card Hugging Face milik Baidu dan repositori vLLM-ERNIE, diverifikasi pada 12 November 2026.
Baru mengenal model ini? Mulailah dengan apa itu ERNIE 5.5 Flash. Jika Anda menginginkan model chat tanpa cluster GPU, panduan API ERNIE 5.5 Flash adalah jalur yang lebih cepat.
Apa yang bisa Anda jalankan secara lokal saat ini?
Anda bisa menjalankan ERNIE 5.5 Flash Base, yang dirilis di Hugging Face dalam format FP8 dan BF16. Ini adalah model sparse mixture-of-experts dengan 280 miliar parameter, 14 miliar parameter aktif per token, yang dilatih pada 33,5 triliun token. ERNIE 5.5 Flash Preview yang telah di-tune untuk chat untuk saat ini hanya tersedia lewat API; Baidu mengatakan bobotnya akan segera dirilis "soon" di bawah lisensi Apache 2.0.
Berikut perbandingan kedua rilis tersebut untuk self-hosting:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| Apa itu | Checkpoint di akhir pretraining | Model pertama pasca-training (chat, reasoning, agent) |
| Bobot | Hugging Face dan ModelScope, FP8 dan BF16 | Belum dirilis per 12 November 2026 |
| Endpoint yang dipanggil | /v1/completions (kelanjutan teks) |
Chat completions dengan reasoning dan tools |
| Lisensi | ERNIE 5.5 Flash Base Model License v1.0 | Apache 2.0 dijanjikan saat rilis |
| Tempat penggunaan saat ini | GPU milik Anda sendiri | Qianfan API, OpenRouter |
Saat ini, koleksi ERNIE-5.5-Flash milik Baidu hanya berisi dua checkpoint Base, dan README vLLM-ERNIE menandai model chat sebagai "Coming soon". Posting rilis Preview tidak memberikan tanggal.
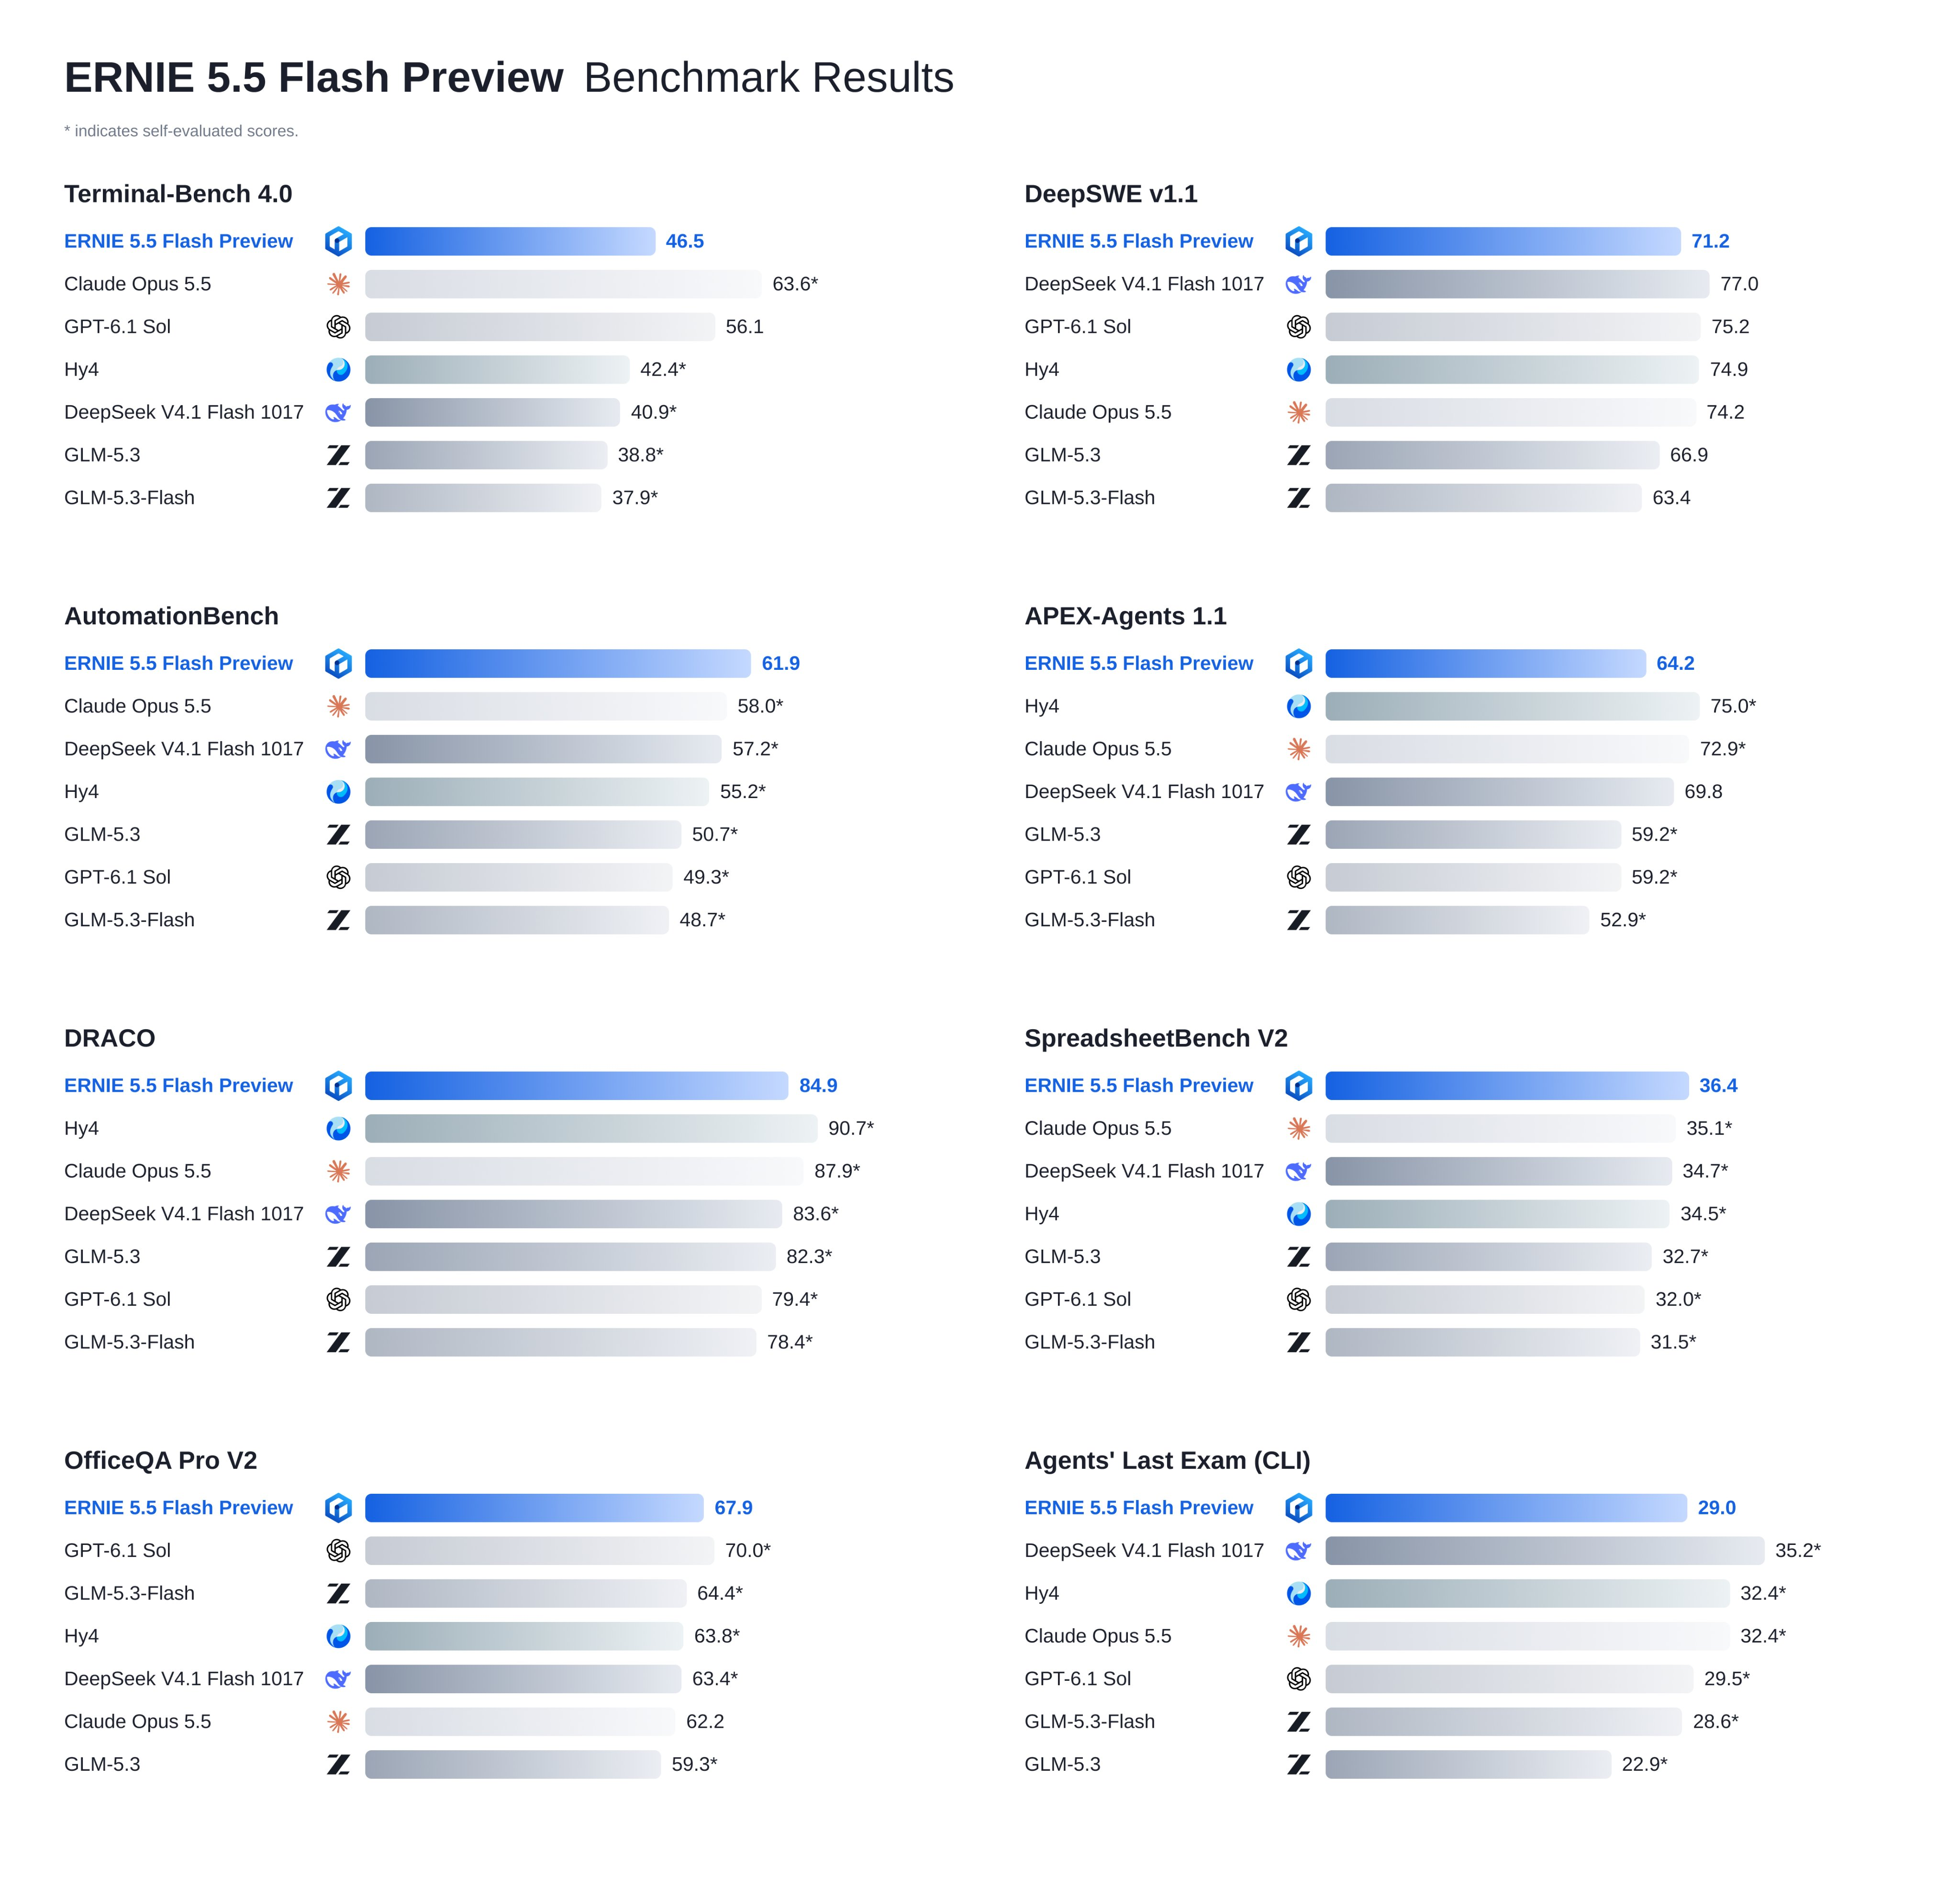
Jika Anda menginginkan asisten coding hari ini, model Base lokal tidak akan memberikannya. Jika Anda menginginkan titik awal untuk fine-tuning atau penelitian few-shot, Base memang dibuat untuk itu.
Kebutuhan hardware ERNIE 5.5 Flash
Bobot FP8 membutuhkan sekitar 280 GB memori GPU dan bobot BF16 sekitar 560 GB, jadi ini adalah pekerjaan server multi-GPU, bukan laptop. README vLLM-ERNIE mencantumkan jumlah GPU minimum yang cukup untuk menampung bobot tersebut, dan plugin hanya berjalan di GPU NVIDIA.
| Memori GPU per kartu | FP8 (~280 GB bobot) | BF16 (~560 GB bobot) |
|---|---|---|
| 288 GB | 2 GPU | 4 GPU |
| 192 GB | 4 GPU | 8 GPU (atau 2 node x 4 GPU) |
| 80 GB | 8 GPU | 2 node x 8 GPU |
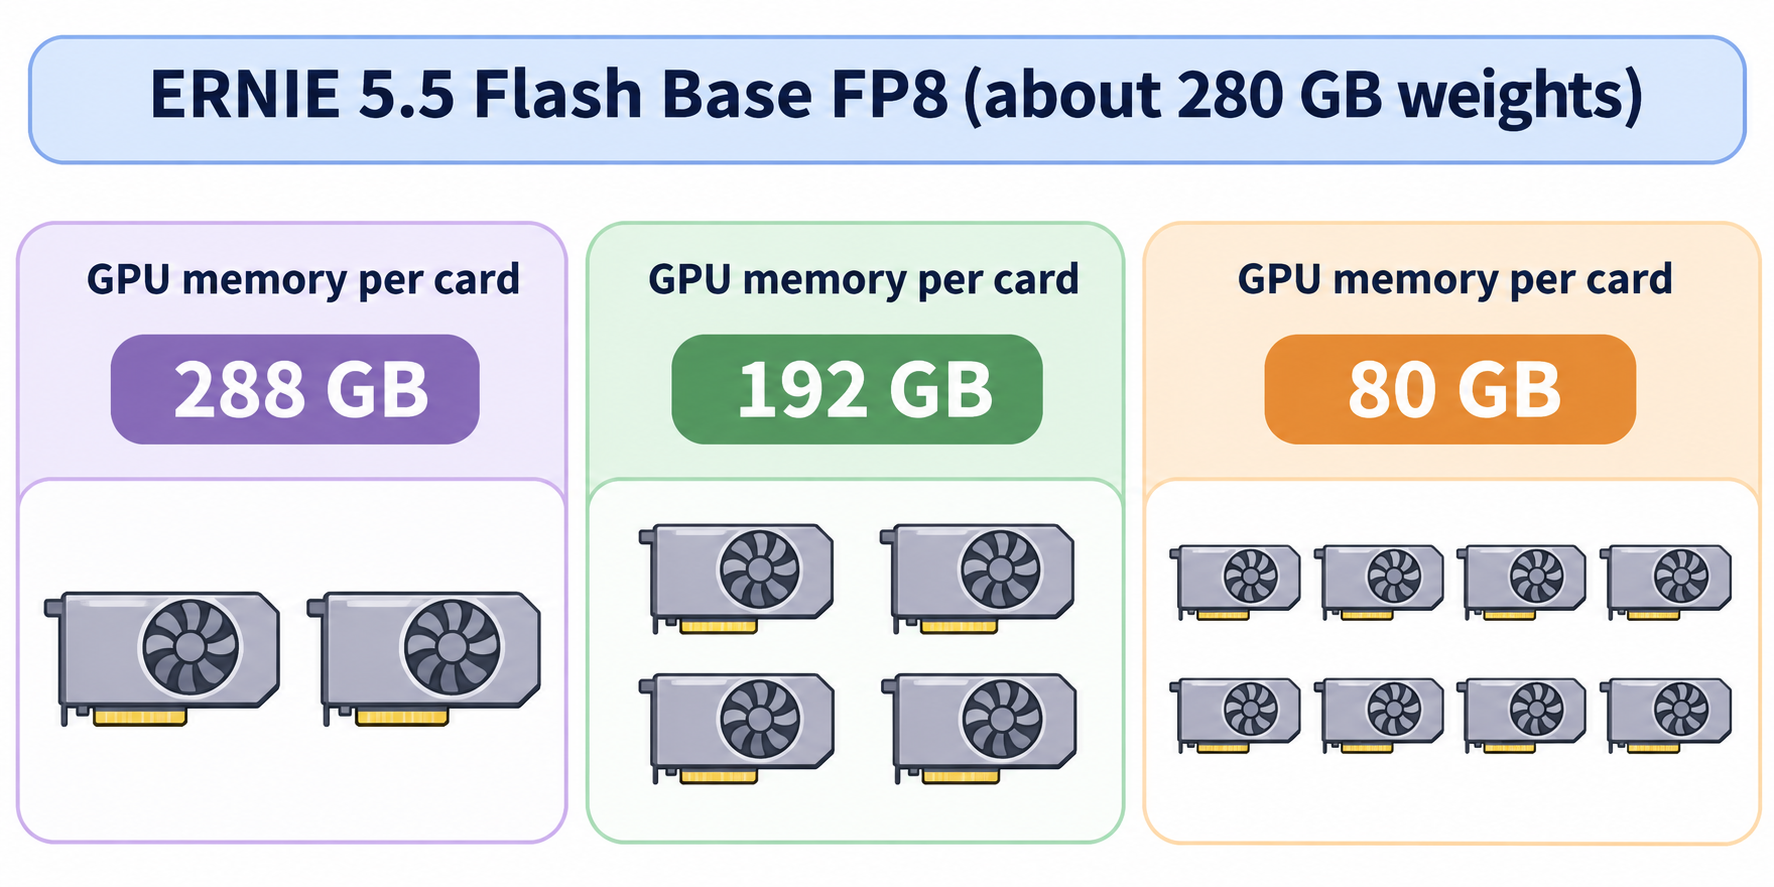
Itu adalah jumlah minimum untuk memuat bobot. KV cache juga butruh ruang tambahan, itulah sebabnya panjang konteks yang bisa Anda layankan bergantung pada kartu Anda:
- GPU 80 GB: layankan FP8 di 8 GPU dengan
--data-parallel-size 8dan--gpu-memory-utilization 0.93. Konteks hingga 262.144 token muat; 1 juta tidak. - Konteks 1 juta token: nilai dari Baidu ditujukan untuk GPU dengan memori 184 GiB, dengan utilization diturunkan ke 0,85 karena prefill 1 juta token membutuhkan puluhan GB memori sementara.
- Arsitektur penting: perintah FP8 menggunakan
--moe-backend humming, yang mendukung aktivasi SiTU milik model dengan bobot FP8 di GPU Blackwell. Di GPU Hopper, hapus flag tersebut dan biarkan kernel MoE default vLLM.
"Lokal" di sini berarti hardware yang Anda kendalikan: node 8-GPU yang disewa, server on-prem, atau cluster lab.
Instal vLLM dan plugin ERNIE
vLLM tidak mendukung arsitektur ERNIE 5.5 (Ernie5_5_MoeForCausalLM) secara bawaan. Baidu menyediakannya sebagai plugin yang berjalan di wheel vLLM 0.32.0 yang dirilis, tanpa modifikasi. Buat environment Python 3.12 dan instal keduanya:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
Plugin dimuat melalui entry point vllm.general_plugins milik vLLM di setiap proses vLLM. Jika vllm serve nanti menampilkan Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported, berarti plugin tidak terinstal di environment yang menjalankan vllm, atau VLLM_PLUGINS diatur tanpa memuat ernie.
Untuk mengunduh bobot dari ModelScope alih-alih Hugging Face, atur VLLM_USE_MODELSCOPE=True. Nama repositorinya sama di kedua hub. Jika Anda baru mengenal vLLM sendiri, tinjauan vLLM kami menjelaskan server dan API-nya yang kompatibel dengan OpenAI.
Perintah vLLM serve untuk ERNIE 5.5 Flash
Berikut perintah FP8 dari README vLLM-ERNIE, untuk satu node 4-GPU pada konteks training 128K dengan ECHO speculative decoding aktif:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Apa fungsi setiap pilihan, sesuai catatan Baidu:
- Attention data parallel plus MoE expert parallel (
--data-parallel-size 4 --enable-expert-parallel) menampung KV cache paling banyak dan memberikan throughput tertinggi. Tensor parallelism (--tensor-parallel-size2, 4 atau 8) menurunkan latensi pada konkurensi rendah tetapi menampung lebih sedikit KV cache. - FP8 KV cache (
--kv-cache-dtype fp8) menyimpan cache dalam FP8;automenyimpannya dalam BF16. - ECHO speculative decoding memanfaatkan layer terakhir milik model sendiri sebagai draft bawaan. Di sini draftnya 2 langkah; 1 atau 3 juga bisa. Hapus
--speculative-configuntuk serve tanpa draft.
Model card menunjukkan varian yang lebih pendek di port 30000 tanpa konfigurasi speculative.
Amankan server Anda. Perintah-perintah ini melakukan bind ke 0.0.0.0 tanpa autentikasi. README Baidu menyarankan menambahkan --api-key <key> atau bind ke 127.0.0.1 kecuali jaringannya terpercaya. Lakukan salah satu dari keduanya sebelum mengekspos portnya.
BF16 dan konteks 1 juta
BF16 berjalan di dua node 4-GPU (DP8 plus EP8) dengan --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP} dan --data-parallel-hybrid-lb; node kedua menambahkan --data-parallel-start-rank 4. Salin perintah lengkapnya dari README; perintah tersebut juga mengatur antarmuka jaringan antar node.
Untuk jendela penuh 1.048.576 token, gunakan --max-model-len 1048576 dan --gpu-memory-utilization 0.85, serta turunkan --max-num-seqs agar KV cache setiap rank dapat menampung request 1 juta token secara utuh.
Memanggil endpoint yang kompatibel dengan OpenAI
vLLM menyediakan rute bergaya OpenAI, tetapi model base tidak memiliki chat template, jadi Anda memanggil /v1/completions dengan prompt mentah. Untuk penggunaan few-shot, masukkan contoh-contohnya ke dalam prompt dan hentikan di akhir satu jawaban:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
README Baidu menyatakan teks completion yang kembali adalah 36. Tiga detail yang sering membuat orang tersandung:
- Gunakan
"temperature": 0untuk greedy decoding.generation_config.jsonmilik model mengaturdo_sample=false,temperature=1.0dantop_p=0.95. vLLM menerapkan temperature dan top_p tetapi mengabaikando_sample, jadi sampling tetap terjadi kecuali Anda meng-override-nya. - Jangan menambahkan
<|ERNIE_MASK|>sendiri. Tokenizer akan menambahkannya secara otomatis (token id 2) di awal prompt completion. - Sesuaikan nama model. Gunakan
baidu/ERNIE-5.5-Flash-Base-BF16saat Anda melayankan bobot BF16.
SDK OpenAI apa pun bisa digunakan asalkan Anda mengarahkan base_url ke http://<host>:8000/v1 dan memanggil completions, bukan chat completions.
Base vs Preview: mana yang sebaiknya Anda gunakan?
Gunakan Base jika Anda berencana melakukan training di atasnya; gunakan Preview jika Anda butuh asisten yang berfungsi sekarang. Base memberi Anda kontrol penuh dan data yang tidak pernah keluar dari server Anda. Preview memberi Anda chat, reasoning, dan tool calling, hanya melalui Qianfan atau OpenRouter.
Saat bobot Preview tersedia, plugin sudah siap mendukungnya. README mendokumentasikan flag tambahan, ditandai "Coming soon": --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice, ditambah model draft DSpark untuk speculative decoding. Thinking akan kembali di reasoning_content dan tool calls di message.tool_calls, sehingga server yang sama yang Anda bangun hari ini berubah menjadi backend chat hanya dengan mengganti bobot dan menambahkan tiga flag.
Lisensi adalah perbedaan lainnya. Base dirilis di bawah ERNIE 5.5 Flash Base Model License Agreement v1.0, bukan Apache 2.0. Baca lisensi lengkapnya sebelum membangun produk di atasnya. Per 12 November 2026, isinya menyebutkan:
- Penggunaan non-komersial gratis, tanpa perlu pemberitahuan.
- Penggunaan komersial di mana produk terkait menghasilkan hingga US$50 juta per tahun bebas dari biaya lisensi, tetapi Anda wajib menampilkan "Powered by ERNIE" dan mengirimkan pemberitahuan sekali kepada Baidu.
- Di atas US$50 juta per tahun, Anda memerlukan otorisasi tertulis terpisah dari Baidu terlebih dahulu.
- "Territory" dalam lisensi mengecualikan Uni Eropa, Inggris, dan Korea Selatan.
Untuk model open-weights yang lebih kecil yang bisa Anda host sendiri dengan GPU lebih sedikit, lihat panduan kami tentang self-hosting GLM-5.3.
Biarkan coding agent Anda menguji endpoint dengan Apidog CLI
Deployment vLLM yang baru membutuhkan smoke test yang bisa dijalankan ulang setiap kali ada perubahan flag: status, skema respons, dan token per detik. Serahkan tugas itu kepada coding agent Anda dan Apidog CLI daripada mengetik ulang curl.
Siapkan CLI sekali saja:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt ke Claude Code, Codex, atau Cursor:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
Agent akan membaca skema payload, memvalidasinya, menulis test case, dan menjalankannya:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
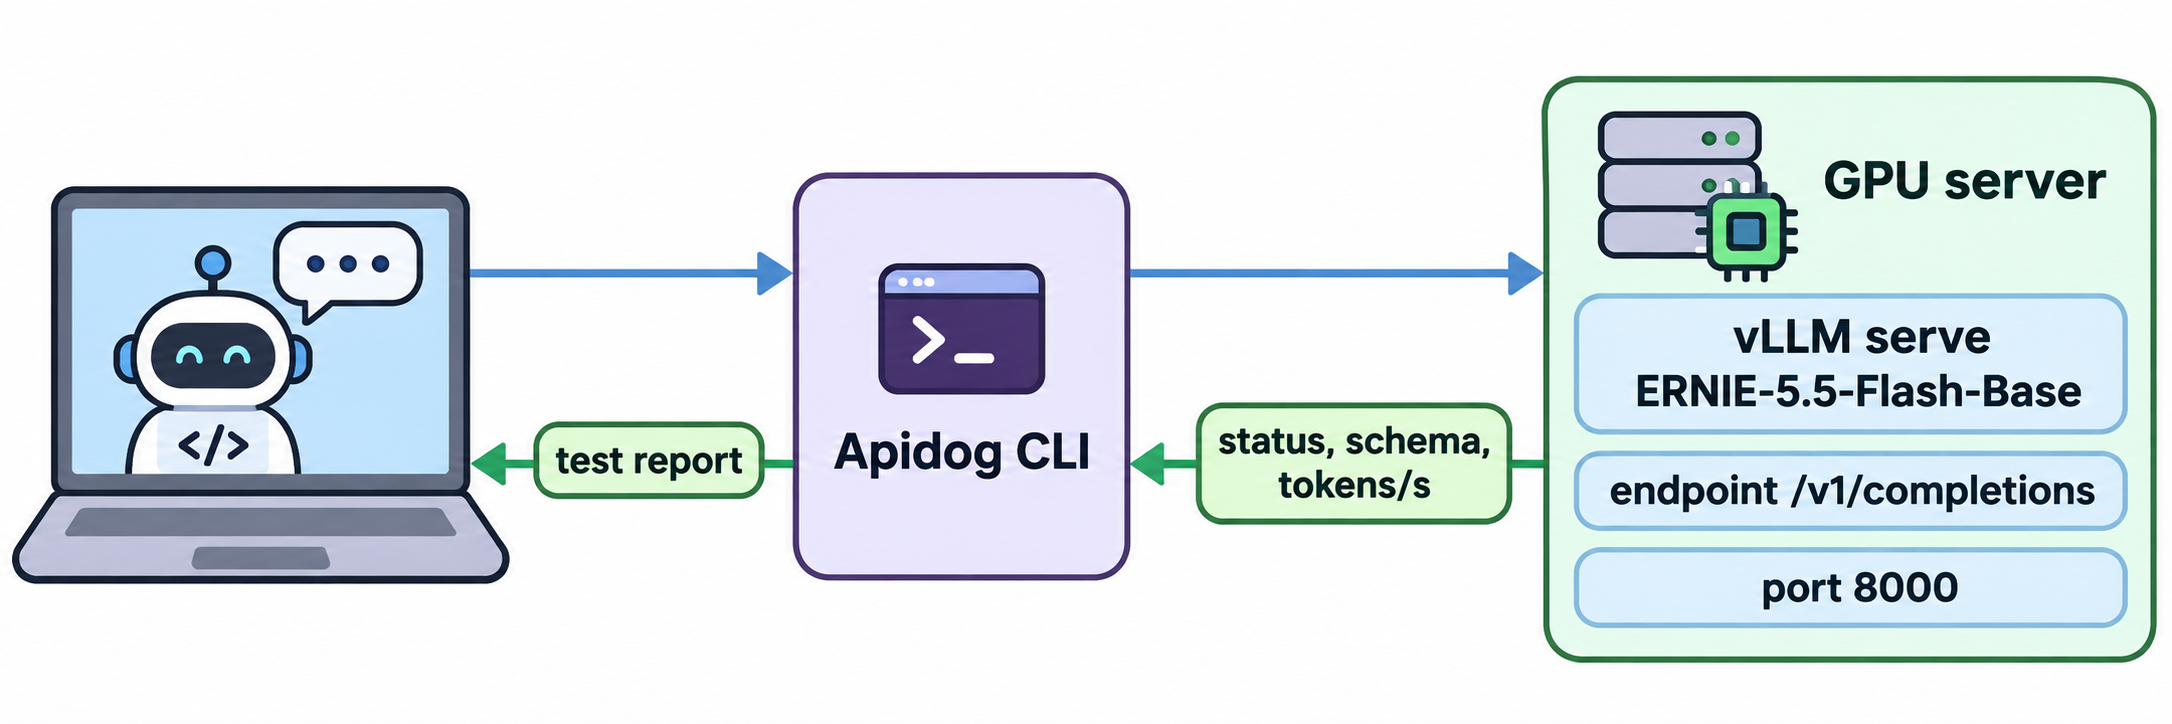
Jalankan CLI dari mesin yang bisa mengakses port 8000. Jika Anda mengatur --api-key di server, minta agent untuk menyimpannya sebagai environment variable dan mengirimkannya sebagai Bearer token. Jalankan ulang test case yang sama setelah Anda mengganti --tensor-parallel-size, menghapus speculative decoding, atau menaikkan --max-model-len, dan Anda mendapatkan perbandingan yang setara. Tambahkan -r junit dan run yang sama bisa dimasukkan ke dalam CI. Untuk langkah setup agent satu per satu, lihat Apidog CLI di Claude Code. Paket Apidog Free mencakup hingga 4 pengguna.
FAQ
Bisakah saya menjalankan ERNIE 5.5 Flash di satu GPU konsumen? Tidak. Bobot FP8 berukuran sekitar 280 GB, dan setup terkecil yang tercantum Baidu adalah 2 GPU berkapasitas 288 GB masing-masing. Dengan kartu 80 GB, Anda membutuhkan 8 kartu. Gunakan Preview melalui API jika Anda tidak memiliki hardware tersebut.
Apakah bobot ERNIE 5.5 Flash Preview sudah tersedia? Belum per 12 November 2026. Baidu mengatakan bobotnya akan segera di-open-source-kan di bawah Apache 2.0, dan plugin vLLM-ERNIE mencantumkan model chat sebagai "Coming soon". Hanya bobot Base (FP8 dan BF16) yang ada di Hugging Face.
Mengapa /v1/chat/completions gagal di model Base? Base tidak memiliki training chat maupun chat template. Baidu melayankannya melalui /v1/completions dengan prompt teks mentah. Masukkan contoh few-shot ke dalam prompt dan gunakan stop sequence.
Apakah vLLM mendukung ERNIE 5.5 secara native? Tidak di vLLM core. Anda membutuhkan plugin vLLM-ERNIE dari Baidu di atas vLLM 0.32.0. Plugin ini hanya berjalan di GPU NVIDIA. SGLang juga dapat melayankan model ini melalui Docker image khusus yang disebutkan di model card.
Bisakah saya menggunakan ERNIE 5.5 Flash Base secara komersial? Bisa, dengan syarat tertentu. Produk dengan pendapatan hingga US$50 juta per tahun dapat menggunakannya tanpa biaya lisensi dengan atribusi "Powered by ERNIE" dan pemberitahuan sekali kepada Baidu. Di atas itu, Anda memerlukan otorisasi tertulis, dan territory lisensi mengecualikan Uni Eropa, Inggris, dan Korea Selatan.