
Anda bisa menjalankan DeepSeek V4 Flash secara lokal tanpa GPU dengan menggunakan llama-modchip, sebuah kumpulan patch llama.cpp open-source yang memperkecil model 284B menjadi file GGUF berukuran 56,56 GiB pada 1,71 bit per bobot. Pada chip laptop AMD Zen 5 16-core dengan RAM 64 GB, prefill berjalan sekitar 44 token per detik dan decode 9 hingga 15 token per detik, tanpa swap sama sekali.
Panduan ini mencakup perangkat keras, perintah, trade-off kualitas, dan cara agen coding Anda menguji endpoint lokal.
Apa yang sebenarnya dilakukan llama-modchip
llama-modchip adalah kumpulan patch kernel ggml dan llama.cpp, transcoder kuantisasi, serta alat runtime untuk menjalankan model sparse Mixture-of-Experts sepenuhnya di RAM sistem. Rilis v2.4.0-nya menargetkan dua ukuran model: DeepSeek-V4-Flash 284B pada mesin 64 GB dan model MoE 30B pada mesin 16 hingga 32 GB.
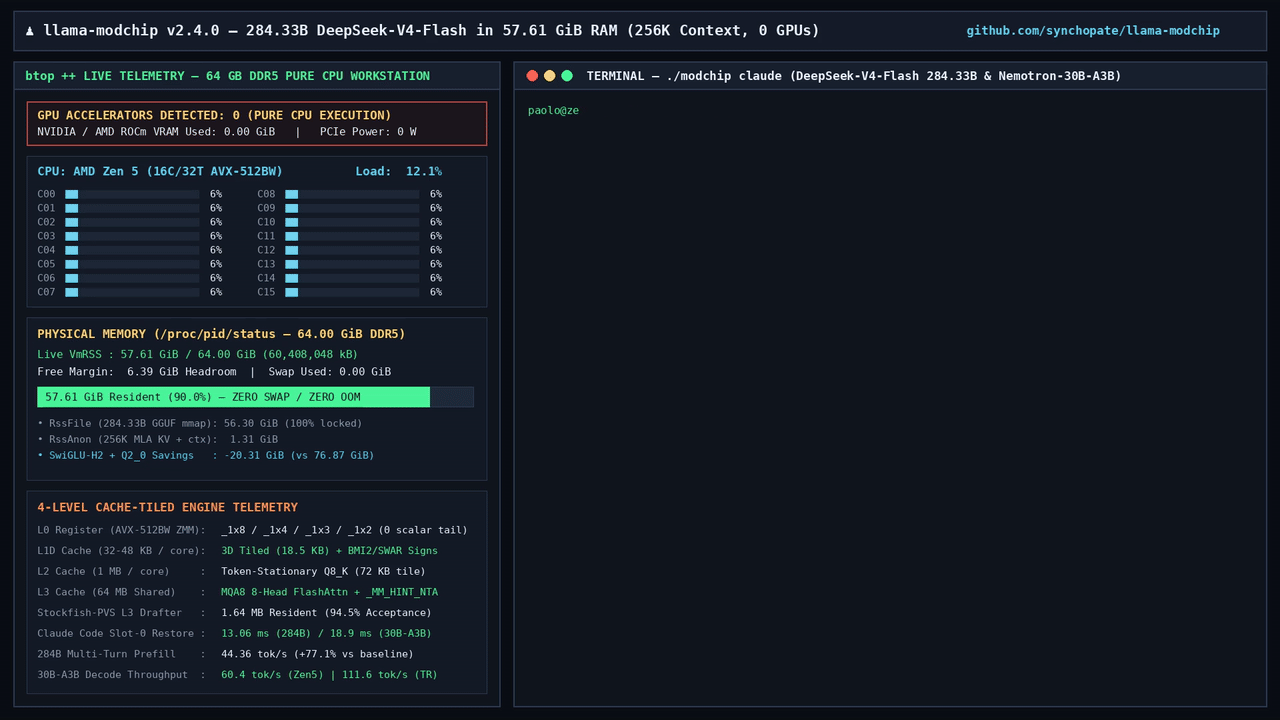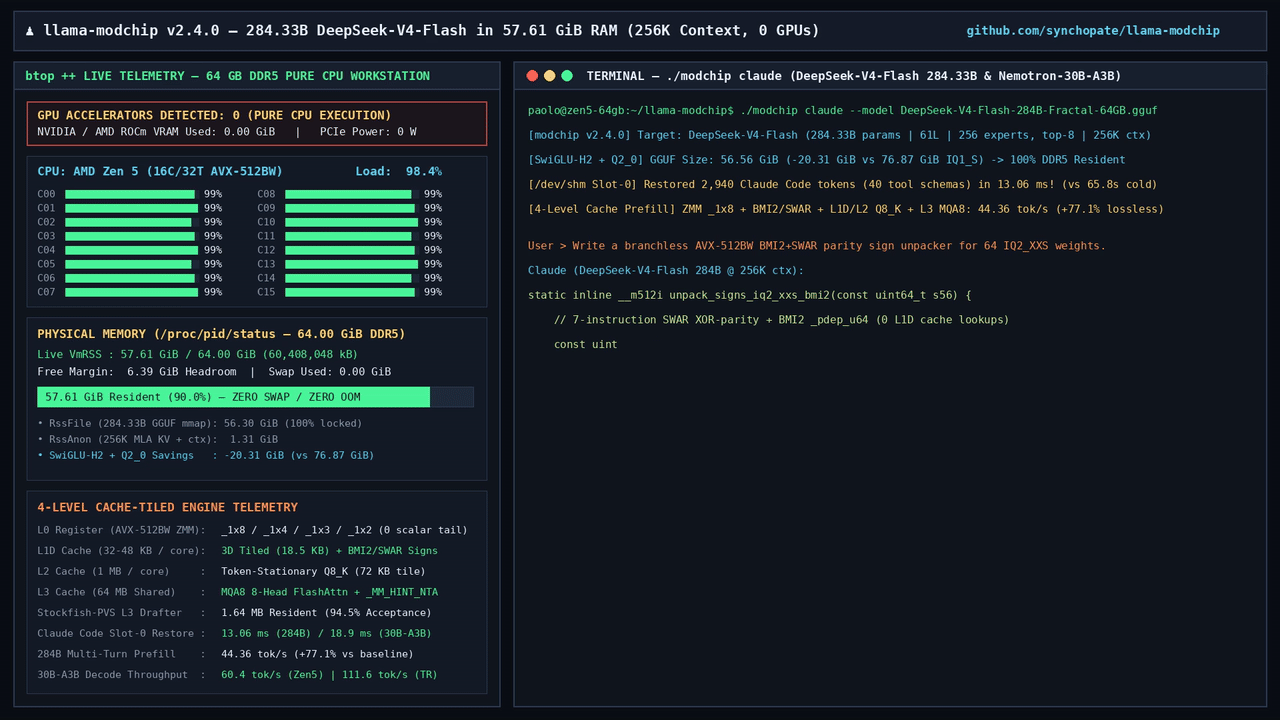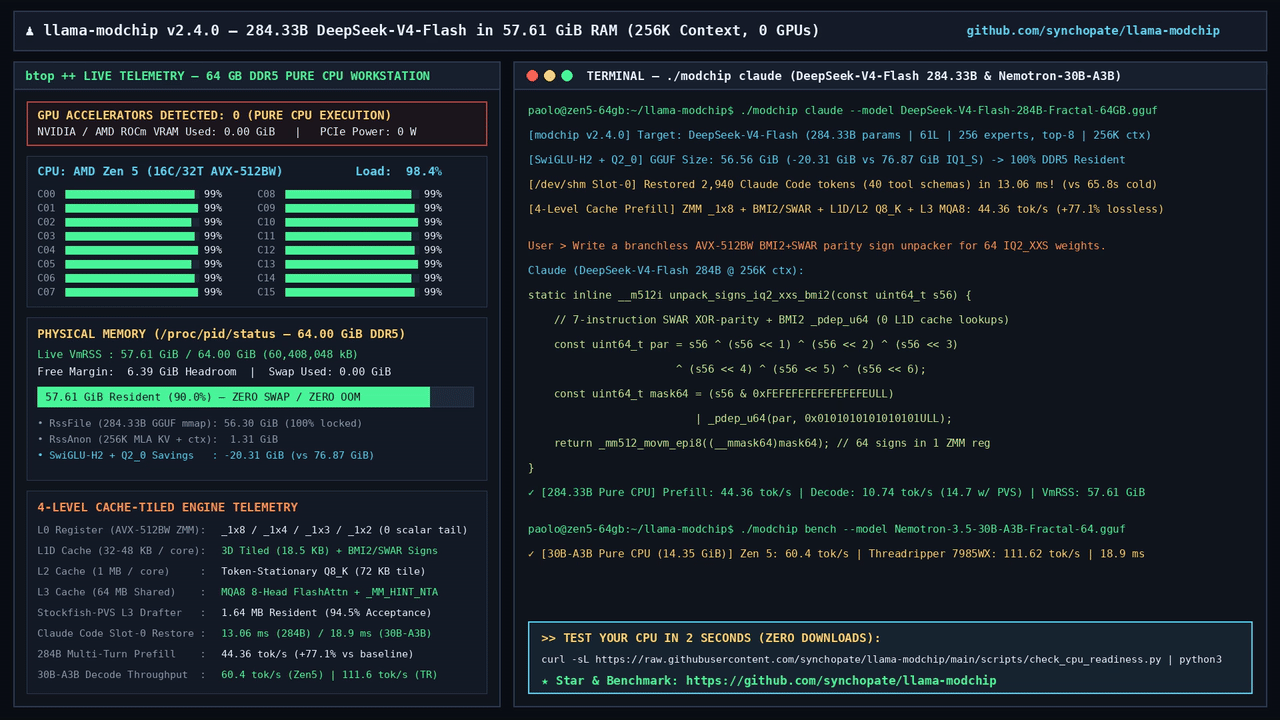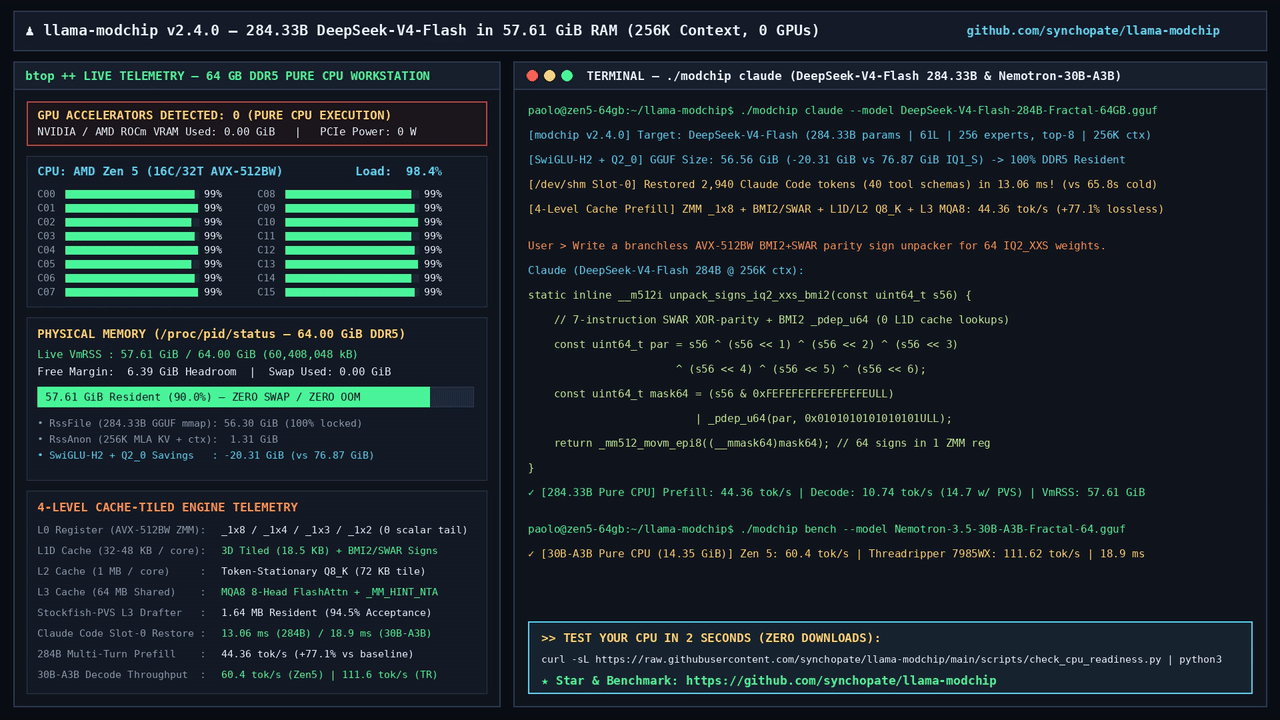
Proyek ini diposting di Hacker News pada 8 November 2026 dan mencapai 370 poin. Repositorinya dilisensikan di bawah Apache 2.0.
Tiga hal membuat model 284B bisa muat:
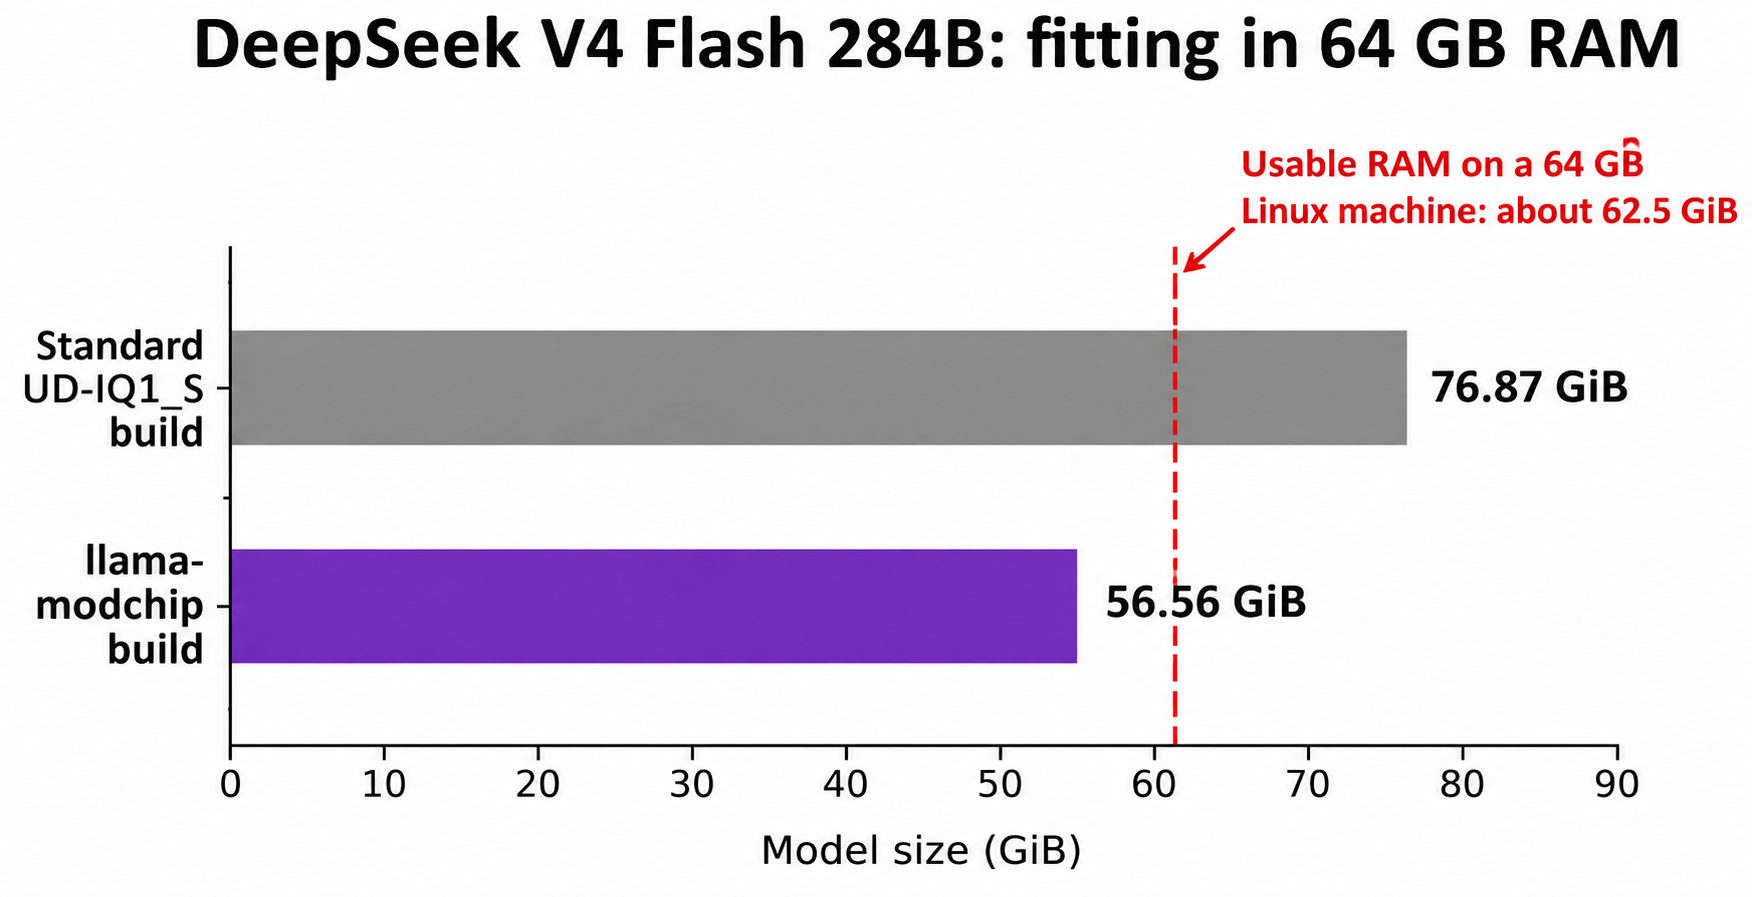
- Checkpoint yang lebih kecil. Build standar Unsloth
UD-IQ1_Sberukuran 76,87 GiB, melebihi sekitar 62,5 GiB yang bisa dipakai mesin Linux 64 GB. llama-modchip mentranskodenya menjadi 56,56 GiB. - CPU cache tiling. Kernel prefill membagi pekerjaan di antara register dan cache L1 hingga L3: 25,0 hingga 44,36 token per detik pada Zen 5 16-core, peningkatan 77%.
- Self-speculative drafting. Drafter n-gram berukuran 1,64 MB menaikkan kecepatan decode dari sekitar 9 hingga maksimal 14,7 token per detik.
Secara default, semua 6 routed expert ditambah shared expert berjalan di setiap layer, jadi tidak ada yang dipangkas.
Perangkat keras yang dibutuhkan untuk menjalankan DeepSeek V4 Flash secara lokal
Anda membutuhkan RAM sistem 64 GB dan CPU x86_64 terbaru, idealnya dengan AVX-512. Semua angka 284B dalam panduan ini diukur oleh maintainer di satu mesin: AMD Ryzen 9 9955HX (16 core, 32 thread, 64 MB L3) dengan 64 GB DDR5 di Linux, tanpa GPU.
| Mesin Anda | RAM | Yang dipasangkan README dengannya | Kecepatan yang dilaporkan (0 GPU) |
|---|---|---|---|
| Laptop atau mini PC | 16 hingga 32 GB | Nemotron-3.5-30B-A3B, 14,35 GiB | 25,0 hingga 60,4 tok/s |
| Desktop atau server | 64 GB | DeepSeek-V4-Flash 284B, 56,56 GiB | 44,4 tok/s prefill, 9,1 hingga 14,7 tok/s decode |
| Workstation 8-channel | 128 GB+ | DeepSeek 284B atau Nemotron 30B | 111,62 tok/s (hanya 30B) |
- Penggunaan memori memuncak di 57,61 hingga 58,9 GiB pada konteks 256K, di bawah batas atas 62,5 GiB yang bisa dipakai. Tutup semua aplikasi lain sebelum memuatnya.
- Binary prebuilt hanya untuk Linux x86_64 (
llama-server-modchip-linux-x86_64). Skrip setup./modchipmendukung Linux dan macOS. Hasil Apple Silicon di README adalah untuk model 30B, bukan 284B. [VERIFY] apakah 284B bisa berjalan di Mac 64 GB. - Bandwidth memori adalah batas atasnya. FAQ menyebutkan board server 8 atau 12-channel dapat meningkatkan decode sekitar 3x hingga 4x dibanding DDR5 dual-channel.
Repositori ini menyertakan pemeriksaan kesiapan yang tidak mengunduh model apa pun:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
Baca skripnya sebelum menyalurkannya ke Python.
Cara menjalankan DeepSeek V4 Flash tanpa GPU, langkah demi langkah
Jalur 1: setup terpandu
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat membuka chat terminal dengan token per detik secara langsung. Subperintah lainnya:
| Perintah | Fungsinya |
|---|---|
./modchip web |
Web chat dan telemetri di http://127.0.0.1:8787 |
./modchip bench |
Uji kecepatan 30 detik dengan scorecard yang bisa dibagikan |
./modchip claude |
Menjalankan Claude Code yang terhubung ke engine lokal |
./modchip status / stop |
Mengecek kesiapan atau menghentikan layanan latar belakang |
Jalur 2: server langsung
Ini mengunduh GGUF dan server prebuilt dari repositori Hugging Face lalu menjalankannya di port 8080:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
Atur -t sesuai jumlah core fisik Anda. Contoh menggunakan konteks 32K; angka 256K menggunakan -c 262144.
Satu jebakan: llama.cpp versi standar, Ollama, dan LM Studio tidak bisa memuat file ini. Checkpoint menggunakan tipe tensor kustom (ID 40), sehingga build tanpa patch gagal dengan unknown tensor type 40. Gunakan skrip ./modchip atau binary bawaan.
Server ini adalah llama-server llama.cpp yang dipatch, jadi ia mendukung route bergaya OpenAI /v1/chat/completions:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
Gateway di port 8787
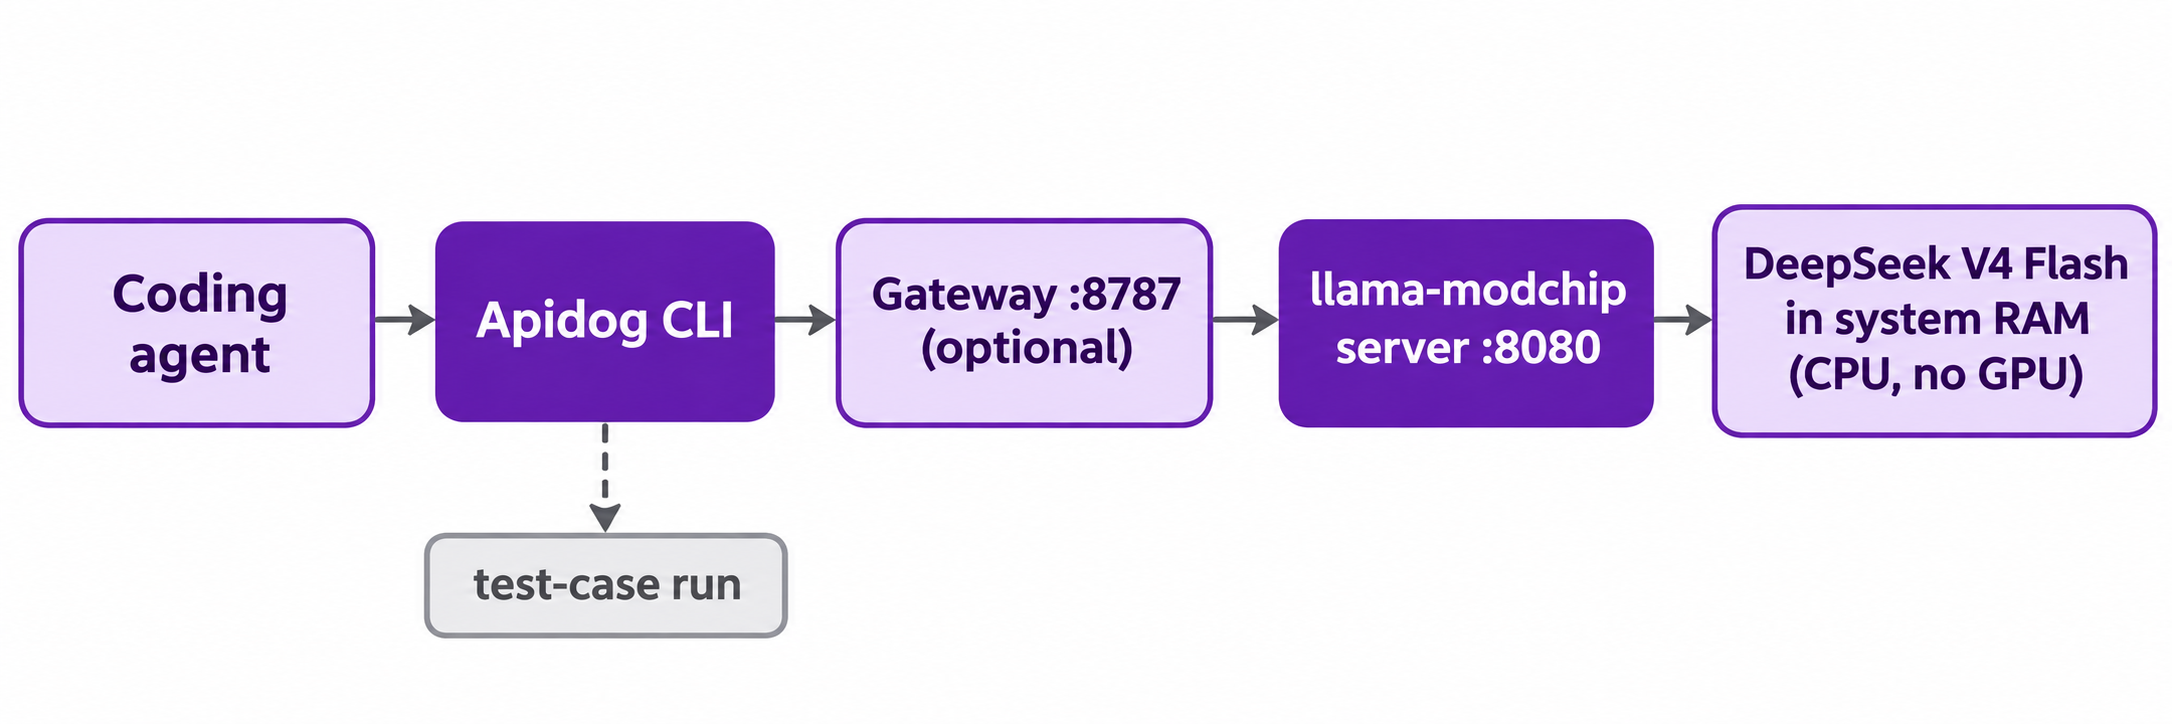
gateway/sse_gateway.py adalah proxy di 127.0.0.1:8787 yang meneruskan ke engine (atur upstream dengan LLAMA_BACKEND_URL). Ia mengekspos /v1/chat/completions, /v1/messages, /v1/models, dan /health. Jika GATEWAY_API_KEY diatur, ia mewajibkan bearer token. ./modchip claude mengarahkan Claude Code ke sini.
Kecepatan dan kualitas: apa yang Anda bayar dengan 1,71 bit per bobot
Angka kecepatannya nyata tapi spesifik. Berikut tabel maintainer untuk DeepSeek-V4-Flash pada konteks 256K di Ryzen 9 9955HX:
| Konfigurasi | Prefill | Decode | Decode dengan drafter |
|---|---|---|---|
UD-IQ1_S tanpa patch (76,87 GiB) |
OOM atau swap di 64 GB | 5,91 tok/s | N/A |
| Default v2.4.0 (Top-6, 56,56 GiB) | 43,16 hingga 44,36 tok/s | 9,06 hingga 9,95 tok/s | 11,5 hingga 14,7 tok/s |
| Top-5 di layer selanjutnya | 43,16 hingga 44,36 tok/s | 9,68 hingga 9,87 tok/s | 12,2 hingga 15,1 tok/s |
| Top-4 plus gate-first SwiGLU | 43,16 hingga 44,36 tok/s | 10,12 hingga 10,74 tok/s | 13,0 hingga 16,0 tok/s |
Anda beralih ke baris yang lebih cepat dengan LLAMA_MOE_TOP_K=5 atau 4. README menyatakan Top-5 menambah sekitar 0,42% perplexity dibandingkan default-nya sendiri.
Dua catatan penting terus muncul di Hacker News:
- "Lossless" berarti lossless terhadap file 1,71 bpw, bukan terhadap bobot asli. Kosinus similarity 1,00000 membandingkan runtime yang dipatch dan tidak dipatch pada checkpoint yang dimampatkan sama, di mana sebagian besar routed expert berada di
IQ1_S(sekitar 1,56 bit). Para komentator menyebut kualitas biasanya turun di bawah 4 bit, dan README tidak memiliki perbandingan terhadap output presisi penuh. - Prefill adalah bottleneck untuk agen. Pada 44 token per detik, prompt 10.000 token membutuhkan sekitar 225 detik sebelum token output pertama muncul. Snapshot KV (pemulihan 13,1 hingga 32,6 ms untuk prompt Claude Code dengan 40 tool) membantu pada giliran berulang, bukan pada konteks baru.
Satu lagi: ini adalah checkpoint V4-Flash 0731 dari bulan Juli. DeepSeek sejak itu merilis V4.1 Flash. Jika Anda peduli dengan bobot terbaru, baca dulu bagaimana DeepSeek V4.1 Flash dibandingkan dengan V4 Pro dan V4 Flash.
Perlakukan 284B lokal sebagai model privat dan offline untuk draf, pekerjaan batch, dan eksperimen, serta uji dulu dengan prompt Anda sendiri.
Minta agen coding Anda menguji endpoint lokal dengan Apidog CLI
Model lokal tetaplah sebuah API: apakah ia menjawab, apakah JSON-nya valid, apakah perubahan flag terakhir merusak sesuatu? Agen coding Anda bisa menjalankan pemeriksaan tersebut dengan Apidog CLI, yang berjalan di mesin Anda dan mengakses 127.0.0.1 secara langsung. Setup sekali saja:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install menambahkan skill Apidog sehingga agen Anda mengetahui perintahnya. Lalu beri agen, misalnya Claude Code, satu prompt:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
Agen membaca skema, memvalidasi payload-nya, lalu menulis dan menjalankan:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request (milidetik) itu penting: model 284B yang terikat CPU cukup lambat untuk memicu timeout default.
Keuntungannya adalah perbandingan: arahkan environment kedua ke API hosted DeepSeek, jalankan test case yang sama, dan lihat di mana kuantisasi lokal mulai melenceng. Tambahkan --upload-report untuk melihat hasil run di aplikasi. Lihat Apidog CLI di Claude Code dan panduan instalasi Apidog CLI. Paket Free Apidog mencakup hingga 4 pengguna.
CPU lokal vs GPU vs API hosted
| Opsi | Yang Anda butuhkan | Paling cocok untuk |
|---|---|---|
| llama-modchip di CPU | RAM 64 GB, CPU x86_64 modern | Pekerjaan privat dan offline tanpa biaya API, jika Anda menerima prefill yang lambat |
| Serving GPU dengan vLLM atau SGLang | VRAM besar atau mesin multi-GPU | Self-hosting yang cepat dengan presisi lebih tinggi |
| API hosted DeepSeek | API key | Output kualitas penuh dengan kecepatan produksi |
Untuk jalur GPU, ikuti cara menjalankan DeepSeek V4 secara lokal, yang membahas vLLM dan SGLang. Untuk perhitungan memori checkpoint yang lebih baru, lihat cara menjalankan DeepSeek V4.1 Flash secara lokal. Untuk menguji model lokal apa pun sebagai API, lihat menguji LLM lokal sebagai API.
FAQ
Apakah saya benar-benar bisa menjalankan DeepSeek V4 Flash tanpa GPU?
Ya, dengan llama-modchip dan RAM 64 GB. Maintainer melaporkan 44,36 token per detik prefill dan 9 hingga 15 token per detik decode pada Ryzen 9 9955HX 16-core, dengan seluruh model 56,56 GiB berada di RAM dan tanpa swap.
Apakah bisa berjalan dengan Ollama atau LM Studio?
Tidak. Checkpoint menggunakan tipe tensor kustom, dan llama.cpp, Ollama, serta LM Studio tanpa patch menolaknya dengan unknown tensor type 40. Gunakan skrip ./modchip dari repositori atau binary llama-server-modchip-linux-x86_64 bawaan.
Bagaimana jika saya hanya punya RAM 16 atau 32 GB?
Jalankan model MoE 30B sebagai gantinya. README memasangkan tier tersebut dengan Nemotron-3.5-30B-A3B dalam file 14,35 GiB dan melaporkan 25,0 hingga 60,4 token per detik di CPU.
Seberapa baik output pada 1,71 bit per bobot?
Proyek ini tidak membandingkan dengan DeepSeek presisi penuh, dan komentator Hacker News skeptis pada ukuran ini. Uji prompt Anda terhadap API hosted sebelum mengandalkannya.
Apakah server lokal ini kompatibel dengan OpenAI?
Ya. Ini adalah llama-server llama.cpp yang dipatch, jadi /v1/chat/completions berfungsi di port 8080. Gateway opsional di port 8787 juga menyajikan /v1/messages, route bergaya Anthropic yang digunakan Claude Code.
Apakah agen coding saya bisa menguji model lokal secara otomatis?
Ya. Instal Apidog CLI, jalankan apidog skill install, lalu minta agen Anda membuat environment yang mengarah ke http://127.0.0.1:8080 dan test case untuk /v1/chat/completions. Setelah itu ia menjalankan apidog test-case run dan melaporkan kegagalannya.