Tim Qwen di Alibaba Cloud telah merilis dua tambahan canggih pada jajaran model bahasa besar (LLM) mereka: Qwen3-4B-Instruct-2507 dan Qwen3-4B-Thinking-2507. Model-model ini membawa kemajuan signifikan dalam penalaran, mengikuti instruksi, dan pemahaman konteks panjang, dengan dukungan asli untuk panjang konteks 256K token. Dirancang untuk pengembang, peneliti, dan penggemar AI, model-model ini menawarkan kemampuan yang kuat untuk tugas-tugas mulai dari pengkodean hingga pemecahan masalah yang kompleks. Selain itu, alat seperti Apidog, platform manajemen API gratis, dapat menyederhanakan pengujian dan integrasi model-model ini ke dalam aplikasi Anda.
Memahami Model Qwen3-4B
Seri Qwen3 mewakili evolusi terbaru dalam keluarga model bahasa besar Alibaba Cloud, menggantikan seri Qwen2.5. Secara khusus, Qwen3-4B-Instruct-2507 dan Qwen3-4B-Thinking-2507 disesuaikan untuk kasus penggunaan yang berbeda: yang pertama unggul dalam dialog tujuan umum dan mengikuti instruksi, sementara yang terakhir dioptimalkan untuk tugas penalaran yang kompleks. Kedua model mendukung panjang konteks asli 262.144 token, memungkinkan mereka memproses kumpulan data yang luas, dokumen panjang, atau percakapan multi-giliran dengan mudah. Selain itu, kompatibilitasnya dengan kerangka kerja seperti Hugging Face Transformers dan alat penyebaran seperti Apidog membuatnya dapat diakses untuk aplikasi lokal maupun berbasis cloud.
Qwen3-4B-Instruct-2507: Dioptimalkan untuk Efisiensi
Model Qwen3-4B-Instruct-2507 beroperasi dalam mode non-berpikir, berfokus pada respons yang efisien dan berkualitas tinggi untuk tugas-tugas tujuan umum. Model ini telah disetel dengan baik untuk meningkatkan kemampuan mengikuti instruksi, penalaran logis, pemahaman teks, dan multibahasa. Khususnya, model ini tidak menghasilkan blok <think></think>, menjadikannya ideal untuk skenario di mana jawaban cepat dan langsung lebih disukai daripada penalaran langkah demi langkah.
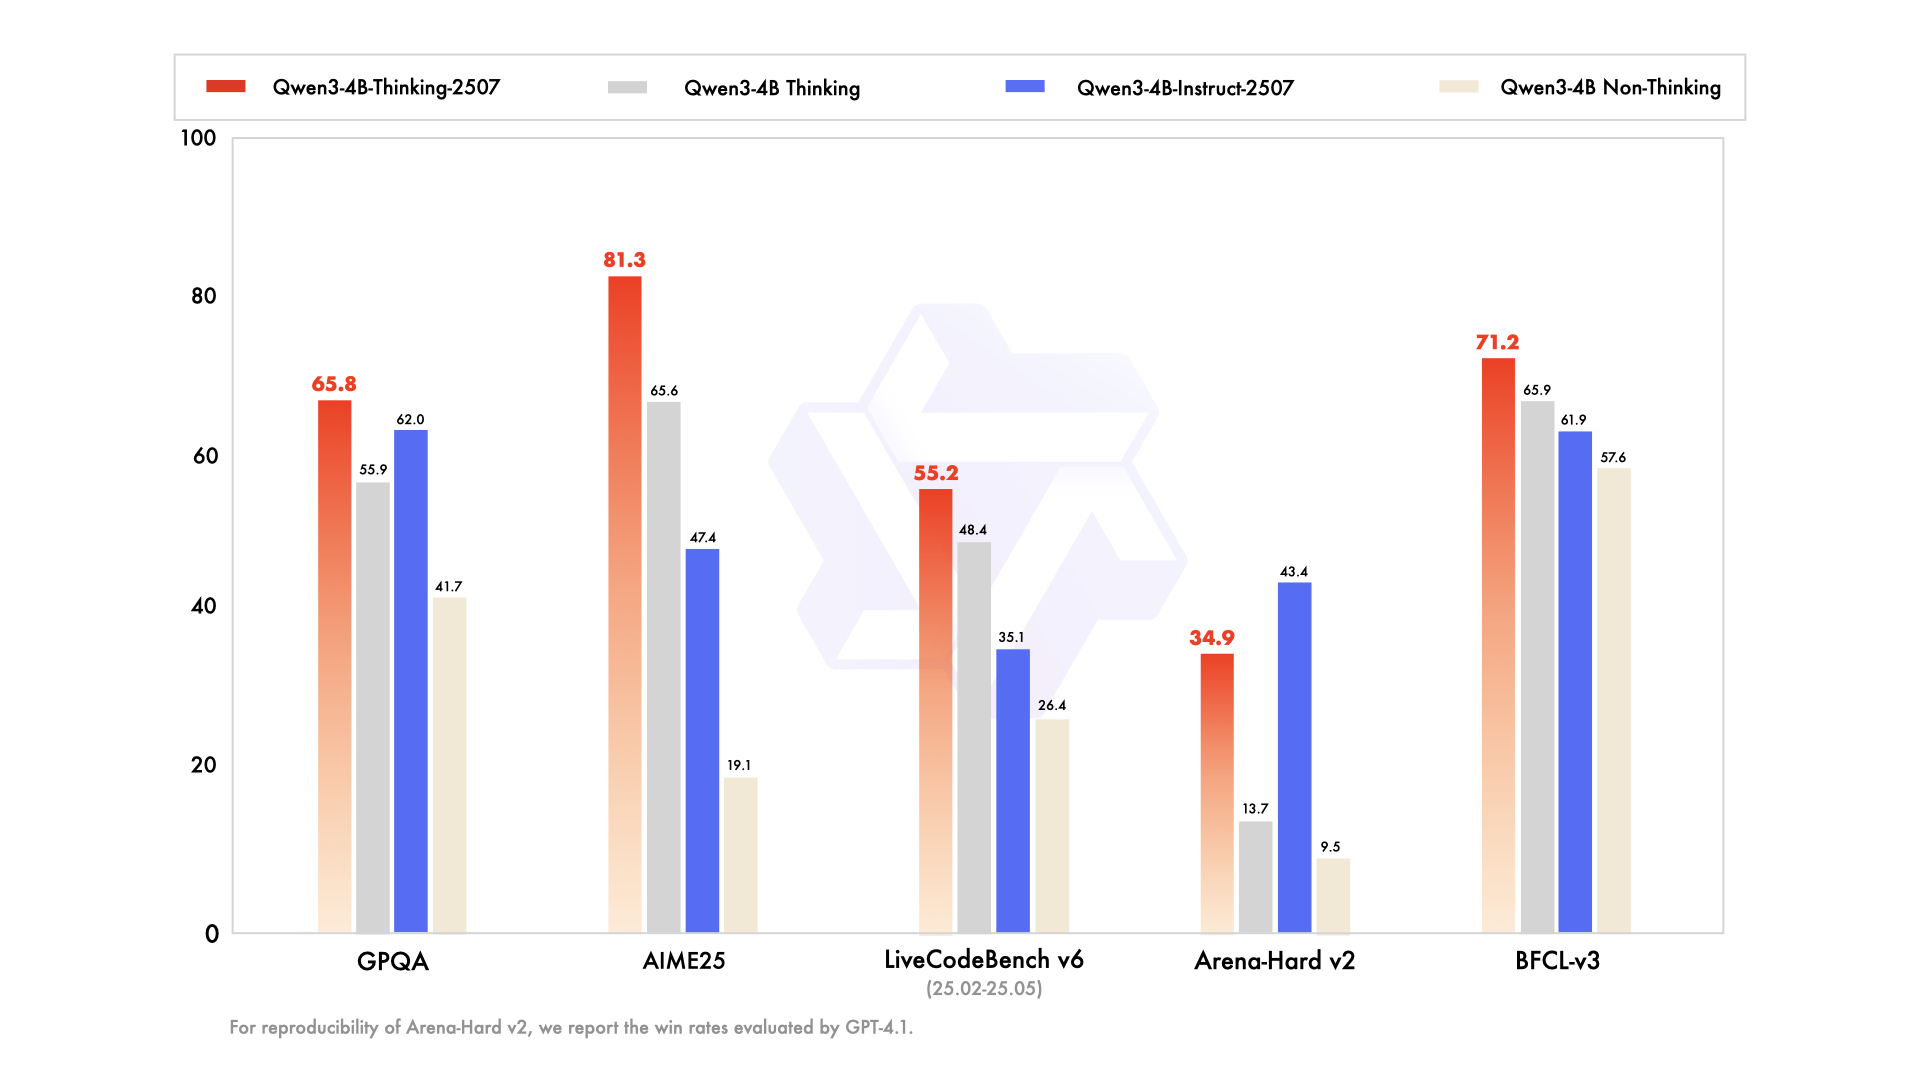
Peningkatan utama meliputi:
- Peningkatan Kemampuan Umum: Model ini menunjukkan kinerja superior dalam matematika, sains, pengkodean, dan penggunaan alat, menjadikannya serbaguna untuk aplikasi teknis.
- Dukungan Multibahasa: Model ini mencakup lebih dari 100 bahasa dan dialek, memastikan kinerja yang kuat dalam aplikasi global.
- Pemahaman Konteks Panjang: Dengan panjang konteks 256K token, model ini menangani masukan yang diperluas, seperti dokumen hukum atau basis kode yang panjang, tanpa pemotongan.
- Penyelarasan dengan Preferensi Pengguna: Model ini memberikan respons yang lebih alami dan menarik, unggul dalam penulisan kreatif dan dialog multi-giliran.
Untuk pengembang yang mengintegrasikan model ini ke dalam API, Apidog menyediakan antarmuka yang ramah pengguna untuk menguji dan mengelola titik akhir API, memastikan penyebaran yang mulus. Efisiensi ini menjadikan Qwen3-4B-Instruct-2507 pilihan utama untuk aplikasi yang membutuhkan respons cepat dan akurat.
Qwen3-4B-Thinking-2507: Dibangun untuk Penalaran Mendalam
Sebaliknya, Qwen3-4B-Thinking-2507 dirancang untuk tugas-tugas yang menuntut penalaran intensif, seperti pemecahan masalah logis, matematika, dan tolok ukur akademis. Model ini beroperasi secara eksklusif dalam mode berpikir, secara otomatis menggabungkan proses chain-of-thought (CoT) untuk memecah masalah kompleks. Outputnya mungkin menyertakan tag penutup </think> tanpa tag pembuka <think>, karena templat obrolan default menyematkan perilaku berpikir.
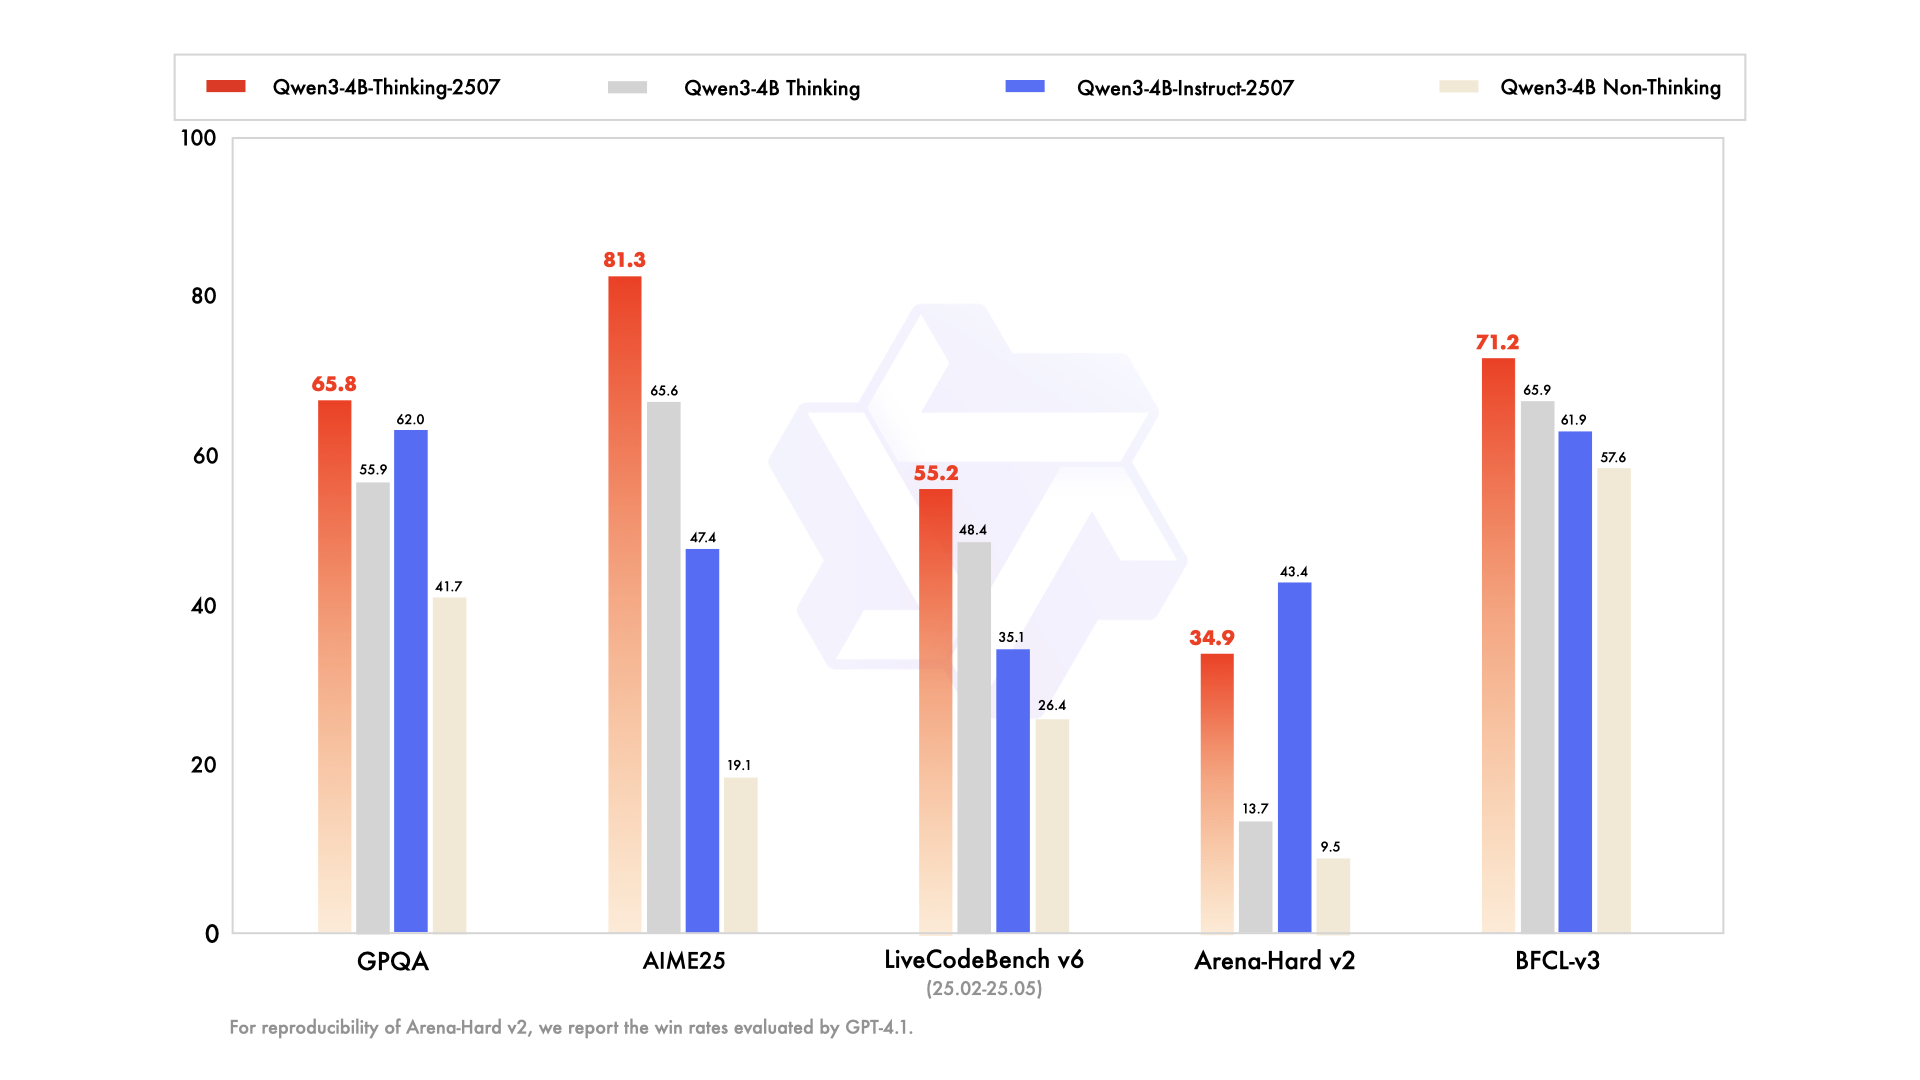
Peningkatan utama meliputi:
- Kemampuan Penalaran Tingkat Lanjut: Model ini mencapai hasil canggih di antara model berpikir sumber terbuka, terutama di bidang STEM dan pengkodean.
- Peningkatan Kedalaman Berpikir: Model ini unggul dalam tugas-tugas yang membutuhkan penalaran tingkat ahli manusia, dengan panjang berpikir yang diperpanjang untuk analisis menyeluruh.
- Panjang Konteks 256K: Seperti rekannya yang bersifat instruksi, model ini mendukung jendela konteks besar, ideal untuk memproses kumpulan data besar atau kueri yang rumit.
- Integrasi Alat: Model ini memanfaatkan alat seperti Qwen-Agent untuk alur kerja agen yang disederhanakan, meningkatkan utilitasnya dalam sistem otomatis.
Untuk pengembang yang bekerja dengan aplikasi yang intensif penalaran, Apidog dapat memfasilitasi pengujian API, memastikan bahwa keluaran model selaras dengan hasil yang diharapkan. Model ini sangat cocok untuk lingkungan penelitian dan skenario pemecahan masalah yang kompleks.
Spesifikasi Teknis dan Arsitektur
Kedua model Qwen3-4B adalah bagian dari keluarga Qwen3, yang mencakup arsitektur dense dan mixture-of-experts (MoE). Penunjukan 4B mengacu pada 4 miliar parameternya, menyeimbangkan efisiensi komputasi dan kinerja. Oleh karena itu, model-model ini dapat diakses pada perangkat keras tingkat konsumen, tidak seperti model yang lebih besar seperti Qwen3-235B-A22B, yang membutuhkan sumber daya yang besar.
Sorotan Arsitektur
- Desain Model Dense: Tidak seperti model MoE, model Qwen3-4B menggunakan arsitektur dense, memastikan kinerja yang konsisten di seluruh tugas tanpa memerlukan aktivasi parameter selektif.
- YaRN untuk Ekstensi Konteks: Model ini memanfaatkan YaRN untuk memperpanjang panjang konteksnya dari 32.768 menjadi 262.144 token, memungkinkan pemrosesan konteks panjang tanpa degradasi kinerja yang signifikan.
- Pipeline Pelatihan: Tim Qwen menggunakan proses pelatihan empat tahap, termasuk cold start chain-of-thought panjang, pembelajaran penguatan berbasis penalaran, fusi mode berpikir, dan pembelajaran penguatan umum. Pendekatan ini meningkatkan kemampuan penalaran dan dialog.
- Dukungan Kuantisasi: Kedua model mendukung kuantisasi FP8, mengurangi persyaratan memori sambil mempertahankan akurasi. Misalnya, Qwen3-4B-Thinking-2507-FP8 tersedia untuk lingkungan yang terbatas sumber daya.
Persyaratan Perangkat Keras
Untuk menjalankan model-model ini secara efisien, pertimbangkan hal berikut:
- Memori GPU: Minimal 8GB VRAM direkomendasikan untuk model yang dikuantisasi FP8, sementara model bfloat16 mungkin memerlukan 16GB atau lebih.
- RAM: Untuk kinerja optimal, 16GB memori terpadu (VRAM + RAM) cukup untuk sebagian besar tugas.
- Kerangka Kerja Inferensi: Kedua model kompatibel dengan Hugging Face Transformers (versi ≥4.51.0), vLLM (≥0.8.5), dan SGLang (≥0.4.6.post1). Alat lokal seperti Ollama dan LMStudio juga mendukung Qwen3.
Untuk pengembang yang menyebarkan model-model ini, Apidog menyederhanakan proses dengan menyediakan alat untuk memantau dan menguji kinerja API, memastikan integrasi yang efisien dengan kerangka kerja inferensi.
Integrasi dengan Hugging Face dan ModelScope
Model Qwen3-4B tersedia di Hugging Face dan ModelScope, menawarkan fleksibilitas bagi pengembang. Di bawah ini, kami menyediakan cuplikan kode untuk menunjukkan cara menggunakan Qwen3-4B-Instruct-2507 dengan Hugging Face Transformers.

from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen3-4B-Instruct-2507"tokenizer = AutoTokenizer.from_pretrained(model_name)model = AutoModelForCausalLM.from_pretrained(model_name, torch_dtype="auto", device_map="auto")
prompt = "Write a Python function to calculate Fibonacci numbers."messages = [{"role": "user", "content": prompt}]text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
generated_ids = model.generate(**model_inputs, max_new_tokens=16384)output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()content = tokenizer.decode(output_ids, skip_special_tokens=True)print("Generated Code:\n", content)
Untuk Qwen3-4B-Thinking-2507, diperlukan penguraian tambahan untuk menangani konten berpikir:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen3-4B-Thinking-2507"tokenizer = AutoTokenizer.from_pretrained(model_name)model = AutoModelForCausalLM.from_pretrained(model_name, torch_dtype="auto", device_map="auto")
prompt = "Solve the equation 2x^2 + 3x - 5 = 0."messages = [{"role": "user", "content": prompt}]text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
generated_ids = model.generate(**model_inputs, max_new_tokens=32768)output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()
try:index = len(output_ids) - output_ids[::-1].index(151668)  #  tokenexcept ValueError:index = 0thinking_content = tokenizer.decode(output_ids[:index], skip_special_tokens=True).strip("\n")content = tokenizer.decode(output_ids[index:], skip_special_tokens=True).strip("\n")print("Thinking Process:\n", thinking_content)print("Solution:\n", content)
Cuplikan ini menunjukkan kemudahan mengintegrasikan model Qwen ke dalam alur kerja Python. Untuk penyebaran berbasis API, Apidog dapat membantu menguji titik akhir ini, memastikan kinerja yang andal.
Optimasi Kinerja dan Praktik Terbaik
Untuk memaksimalkan kinerja model Qwen3-4B, pertimbangkan rekomendasi berikut:
- Parameter Sampling: Untuk Qwen3-4B-Instruct-2507, gunakan
temperature=0.7,top_p=0.8,top_k=20, danmin_p=0. Untuk Qwen3-4B-Thinking-2507, gunakantemperature=0.6,top_p=0.95,top_k=20, danmin_p=0. Hindari decoding serakah untuk mencegah penurunan kinerja. - Manajemen Panjang Konteks: Jika mengalami masalah kehabisan memori, kurangi panjang konteks menjadi 32.768 token. Namun, untuk tugas penalaran, pertahankan panjang konteks di atas 131.072 token.
- Penalti Kehadiran: Atur
presence_penaltyantara 0 dan 2 untuk mengurangi pengulangan, tetapi hindari nilai tinggi untuk mencegah pencampuran bahasa. - Kerangka Kerja Inferensi: Gunakan vLLM atau SGLang untuk inferensi throughput tinggi, dan manfaatkan Apidog untuk memantau kinerja API.
Membandingkan Qwen3-4B-Instruct-2507 dan Qwen3-4B-Thinking-2507
Meskipun kedua model berbagi arsitektur 4 miliar parameter yang sama, filosofi desainnya berbeda:
- Qwen3-4B-Instruct-2507: Memprioritaskan kecepatan dan efisiensi, sehingga cocok untuk chatbot, dukungan pelanggan, dan aplikasi tujuan umum.
- Qwen3-4B-Thinking-2507: Berfokus pada penalaran mendalam, ideal untuk penelitian akademis, pemecahan masalah kompleks, dan tugas yang membutuhkan proses chain-of-thought.
Pengembang dapat beralih antara mode menggunakan prompt /think dan /no_think, memungkinkan fleksibilitas berdasarkan persyaratan tugas. Apidog dapat membantu dalam menguji peralihan mode ini dalam aplikasi berbasis API.
Dukungan Komunitas dan Ekosistem
Model Qwen3-4B mendapat manfaat dari ekosistem yang kuat, dengan dukungan dari Hugging Face, ModelScope, dan alat seperti Ollama, LMStudio, dan llama.cpp. Sifat sumber terbuka dari model-model ini, yang dilisensikan di bawah Apache 2.0, mendorong kontribusi komunitas dan fine-tuning. Misalnya, Unsloth menyediakan alat untuk fine-tuning 2x lebih cepat dengan VRAM 70% lebih sedikit, membuat model-model ini dapat diakses oleh audiens yang lebih luas.
Kesimpulan
Model Qwen3-4B-Instruct-2507 dan Qwen3-4B-Thinking-2507 menandai lompatan signifikan dalam seri Qwen Alibaba Cloud, menawarkan kemampuan yang tak tertandingi dalam mengikuti instruksi, penalaran, dan pemrosesan konteks panjang. Dengan panjang konteks 256K token, dukungan multibahasa, dan kompatibilitas dengan alat seperti Apidog, model-model ini memberdayakan pengembang untuk membangun aplikasi cerdas dan skalabel. Baik Anda membuat kode, memecahkan persamaan, atau membuat chatbot multibahasa, model-model ini memberikan kinerja yang luar biasa. Mulailah menjelajahi potensinya hari ini, dan gunakan Apidog untuk menyederhanakan integrasi API Anda untuk pengalaman pengembangan yang mulus.