
Harga Qwen4-Max pada API pay-per-token QwenCloud adalah $1,50 per 1M token input dan $4,50 per 1M token output di wilayah Singapura, dengan input cache seharga $0,075 per 1M. Mode thinking dan non-thinking harganya sama, dan tidak ada tingkatan panjang input. Jika Anda lebih suka membayar biaya bulanan tetap untuk alat coding, model yang sama tersedia di Token Plan, mulai dari $6 per bulan.
Di bawah ini: kartu tarif, biaya tugas nyata, penghematan cache, Token Plan vs pay-per-token, dan harga pesaing. Baru mengenal model ini? Mulailah dengan apa itu Qwen4-Max.
Harga API Qwen4-Max per 1M token
Qwen4-Max ditagih per juta token, dengan tarif terpisah untuk input, output, penulisan cache, dan pembacaan cache. Output mencakup token reasoning ("thinking") dan jawabannya. Alibaba menyediakan kolom Singapura (Internasional) dan kolom Beijing/Global yang lebih murah.
| Item tagihan (per 1M token) | Singapura (Internasional) | Beijing / Global |
|---|---|---|
| Input | $1,50 | $1,413 |
| Output (thinking + jawaban) | $4,50 | $4,24 |
| Penulisan cache, TTL 5 menit | $1,875 | $1,767 |
| Penulisan cache, TTL 1 jam | $3,00 | $2,827 |
| Pembacaan cache (hit eksplisit atau implisit) | $0,075 | $0,071 |
Sumber: dokumentasi harga QwenCloud dan halaman model Qwen4-Max, keduanya diperiksa pada 16 November 2026. Dokumentasi mencantumkan deployment Global di Frankfurt, Hong Kong, Tokyo, dan US (Virginia).
Beberapa aturan yang memengaruhi tagihan:
- Token thinking dihitung sebagai output. Aktifkan
enable_thinkingdan setiap token reasoning ditagih seharga $4,50 per 1M. - Tidak ada biaya tambahan konteks panjang. Permintaan 900K token berbiaya sama per token dengan permintaan 9K.
- Pembacaan cache hanya 5% dari harga input. $0,075 dibanding $1,50 adalah diskon 95% untuk prefix yang berulang.
- Batasan: konteks 1M token, hingga 991K input (983K dengan thinking), hingga 393K output, dan 5.000.000 token per menit.
ID modelnya adalah qwen4-max. Jika Anda belum pernah melakukan panggilan, panduan API Qwen4-Max kami membahas kunci API, base URL, dan permintaan pertama.
Berapa biaya tugas nyata dengan Qwen4-Max
Harga per token sulit dibayangkan. Alibaba memberikan satu angka konkret di postingan peluncurannya: pada benchmark agen Work360, biaya rata-rata per tugas turun dari $4,43 dengan Qwen3.8-Max menjadi $1,67 dengan Qwen4-Max, 62% lebih murah. Alibaba juga melaporkan bahwa Qwen4-Max menggunakan sekitar 24% lebih sedikit token pada tingkat effort Xhigh dan sekitar 35% lebih sedikit pada High di Work360. Itu adalah angka dari vendor, jadi anggap sebagai arah tren, bukan kutipan biaya untuk beban kerja Anda.
Anda bisa mengestimasi biaya sendiri dengan aritmetika sederhana. Berikut tiga contoh perhitungan dengan harga resmi Singapura:
- Panggilan chat singkat. 2.000 token input dan 500 token output: 2.000 x $1,50/1M + 500 x $4,50/1M = $0,003 + $0,00225 = $0,0053. Sekitar $5,25 per 1.000 panggilan.
- Panggilan yang sama dengan thinking aktif. Katakanlah model melakukan reasoning sebanyak 6.000 token sebelum jawaban 500 token. Output menjadi 6.500 token, sehingga panggilan berbiaya $0,003 + $0,02925 = $0,032, sekitar enam kali lebih mahal.
- Pertanyaan dokumen panjang. 300.000 token input dan 2.000 token output: $0,45 + $0,009 = $0,459 tanpa cache, atau sekitar $0,032 jika dokumen 300K tersebut merupakan cache hit.
Contoh 2 sering mengejutkan orang: thinking bisa mendominasi tagihan meskipun jawabannya pendek. Untuk angka lebih mendalam tentang kualitas per dolar, lihat rincian benchmark Qwen4-Max.
Bagaimana tarif cache mengubah tagihan Qwen4-Max
Context caching adalah tempat harga Qwen4-Max benar-benar berubah drastis. QwenCloud menawarkan dua mode untuk qwen4-max pada API pay-per-token, dan pada API Chat Completions, DashScope, serta yang kompatibel dengan Anthropic, keduanya saling eksklusif per permintaan.
| Mode | Cara kerja | Harga | Hit dijamin? |
|---|---|---|---|
| Cache implisit | Otomatis, tidak bisa dinonaktifkan, menggunakan ulang prefix umum sebanyak 1.024+ token | $0,075 per 1M saat hit | Tidak. Validitasnya tidak pasti |
| Cache eksplisit | Anda menandai breakpoint dengan cache_control |
$1,875 (5 menit) atau $3 (1 jam) untuk menulis, $0,075 untuk membaca | Ya, selama cache masih valid |
Dokumentasi context cache menyatakan bahwa cache eksplisit 5 menit mengatur ulang pewaktunya setiap kali ada hit, sehingga loop agen yang sibuk menjaga agar tetap hangat.
Sekarang ambil contoh sesi agen: system prompt 200K token ditambah definisi tool dan konten repositori, digunakan ulang selama 50 giliran, dengan 2K input baru dan 3K output per giliran.
- Tanpa cache hit: 10,1M token input x $1,50 + 150K output x $4,50 = $15,83.
- Cache implisit mulai hit dari giliran ke-2: 202K pertama dengan harga penuh ($0,30), 9,8M token ter-cache dengan $0,075 ($0,74), 98K token baru ($0,15), dan output ($0,68) = $1,86.
- Cache eksplisit 5 menit: penulisan $0,375 menggantikan prefix harga penuh pertama, pembacaan dan output yang sama = sekitar $1,94, dengan hit yang dijamin.
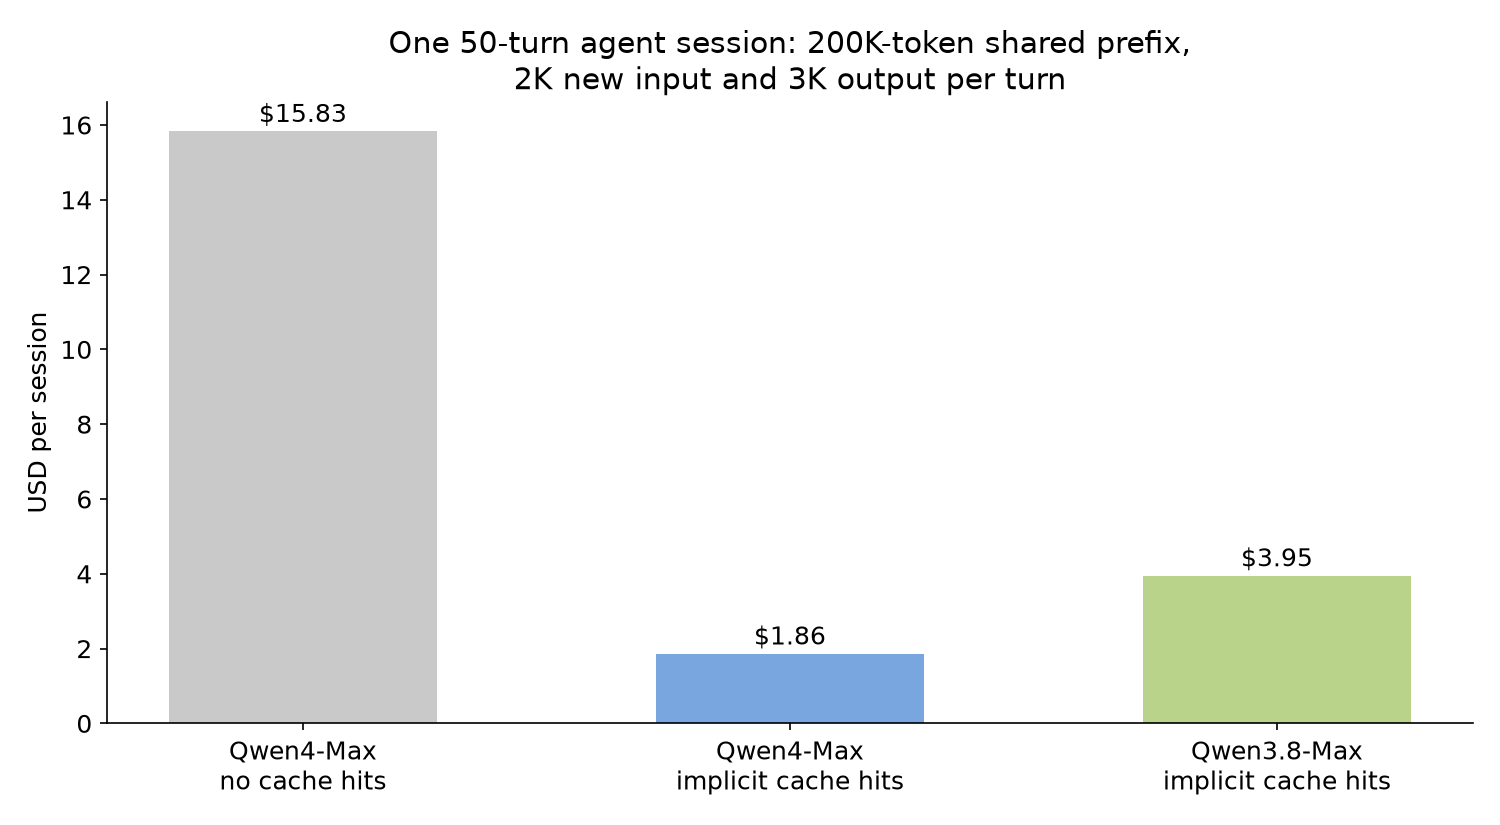
Sesi yang sama di Qwen3.8-Max, dengan tarif $2 input, $0,25 cache implisit, dan $6 output, totalnya $3,95. Di situlah klaim Alibaba tentang "pemotongan terbesar pada input ter-cache" terlihat: Qwen3.8-Max mengenakan $0,25 untuk hit implisit, sedangkan Qwen4-Max hanya $0,075.
Gunakan caching eksplisit saat Anda membutuhkan hit yang dapat diprediksi, dan caching implisit untuk lainnya. Periksa hasilnya di usage.prompt_tokens_details.cached_tokens dan cache_creation_input_tokens. Jika Anda mempertimbangkan ekonomi caching antar vendor, perhitungan prompt caching Claude Opus 5.5 kami menggunakan metode yang sama.
Apakah ada diskon batch untuk Qwen4-Max?
Ada, tetapi hanya di satu wilayah. API Batch QwenCloud biasanya menagih input dan output sebesar 50% dari harga real-time. Untuk qwen4-max, dokumentasi batch mencantumkannya hanya di bawah China North 2 (Beijing), dengan harga $0,707 input dan $2,12 output per 1M token untuk Batch File. Batch Chat di Beijing tercantum seharga $1,413 / $4,24.
Batch tidak mendukung context caching, tidak bisa digabung dengan diskon lain, dan tidak termasuk kuota gratis. Dengan tingkat cache hit yang tinggi, API real-time bisa lebih murah daripada batch.
Qwen4-Max pay-per-token vs Token Plan
Token Plan adalah langganan bulanan QwenCloud untuk alat coding dan agen seperti Claude Code, Cursor, Qwen Code, Codex, dan Qoder. Penagihannya menggunakan Kredit, bukan token, dan menggunakan kunci API sk-sp- tersendiri. qwen4-max ada dalam daftar model yang didukung. Paket perorangan, sesuai dokumentasi Token Plan per 16 November 2026:
| Paket | Harga per bulan | Kredit per bulan | Agen konkuren |
|---|---|---|---|
| Lite | $6 ($3 harga pengguna baru terbatas) | 20.000 | 1-2 |
| Essential | $10 ($5 harga pengguna baru terbatas) | 45.000 | 2-3 |
| Standard | $18 | 80.000 | 3-4 |
| Pro | $43 | 200.000 | 6-8 |
Paket Kredit Tambahan berharga $15 untuk 20.000 Kredit (maksimal 5 sekaligus). Saat Kredit habis, panggilan diblokir; tidak ada fallback ke pay-per-token.
Cara memilih:
- Pilih Token Plan jika satu orang menggunakan model melalui agen coding setiap hari dan menginginkan biaya bulanan tetap.
- Pilih pay-per-token untuk produk, pekerjaan backend, batch, fine-tuning, atau trafik yang tidak stabil. Anda hanya membayar sesuai pemakaian dan tetap mendapatkan batas 5.000.000 TPM.
Kredit per permintaan Qwen4-Max bukan rasio token yang tetap, jadi periksa konsol setelah sehari pemakaian nyata. Kami membahas paket ini secara mendalam, termasuk seberapa jauh Kredit mencukupi, di Qwen4-Max Token Plan: berapa harganya dan apakah sepadan.
Harga Qwen4-Max vs Qwen3.8-Max dan model flagship pesaing
Qwen4-Max lebih murah dari pendahulunya pada input, output, pembacaan cache, dan penulisan cache 5 menit (Qwen3.8-Max mencantumkan satu harga penulisan cache $2,50; penulisan 1 jam Qwen4-Max adalah $3). Berikut posisinya dibanding model flagship lain pada harga standar, masing-masing dibaca dari halaman vendor sendiri pada 16 November 2026.
| Model | Input / 1M | Input ter-cache / 1M | Output / 1M |
|---|---|---|---|
| Qwen4-Max (Singapura) | $1,50 | $0,075 | $4,50 |
| Qwen3.8-Max | $2,00 | $0,25 (implisit), $0,17 (pembacaan eksplisit) | $6,00 |
| DeepSeek V4 Pro (jam sibuk / luar sibuk) | $1,32 / $0,66 | $0,044 / $0,022 | $3,96 / $1,98 |
| OpenAI gpt-5.6-sol | $4,00 | $0,40 | $20,00 |
| Claude Opus 5.5 | $4,00 | $0,20 | $20,00 |
Sumber: halaman model Qwen3.8-Max, harga DeepSeek, harga OpenAI API dan harga Claude.
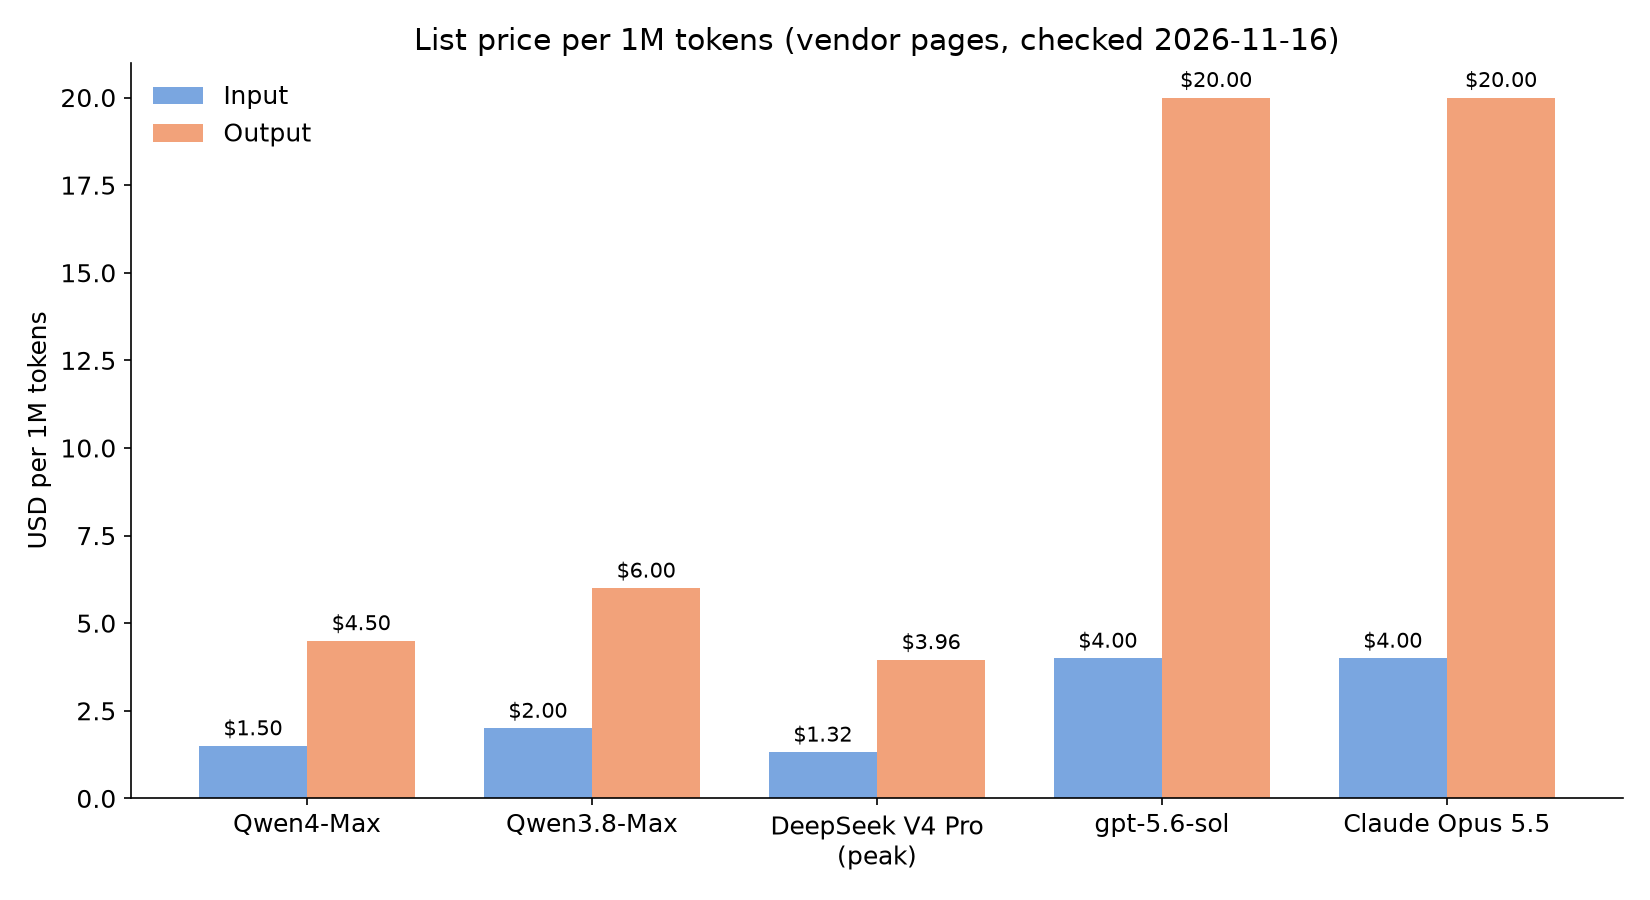
Untuk agen, output sering kali menjadi komponen biaya terbesar, dan output Qwen4-Max seharga $4,50 jauh di bawah $20 yang ditagih gpt-5.6-sol dan Claude Opus 5.5. DeepSeek V4 Pro lebih murah per token, terutama di luar jam sibuk. Biaya per tugas yang selesai bergantung pada berapa banyak token yang dihabiskan setiap model untuk beban kerja Anda. Untuk detail sisi Qwen3.8-Max, lihat panduan harga Qwen 3.8 kami dan perbandingan Qwen4-Max vs Qwen 3.8.
Ukur biaya Qwen4-Max dengan agen coding Anda menggunakan Apidog CLI
Satu-satunya estimasi biaya yang andal adalah usage yang diukur dari prompt Anda sendiri. Biarkan agen coding Anda (Claude Code, Codex, Cursor, atau sejenisnya) membangun dan menjalankan pemeriksaan itu dengan Apidog CLI. Lakukan pengaturan sekali saja:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Lalu berikan satu prompt ke agen Anda:
In Apidog project <projectId>, create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable for my DashScope API key. Add a POST /chat/completions endpoint for model
qwen4-max and two test cases: one with enable_thinking true, one false. Assert
status 200, a non-empty choices array and a usage object. Run both and report
prompt_tokens, completion_tokens and cached_tokens side by side.
Agen akan memeriksa setiap bentuk payload terhadap skema CLI sebelum menulis apa pun, lalu menjalankan kasus uji:
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-thinking.json
apidog test-case create --project <projectId> --file case-thinking.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Bandingkan kedua angka completion_tokens dan kalikan dengan $4,50 per 1M: itulah biaya tambahan thinking Anda, di prompt Anda sendiri. Tambahkan --upload-report pada perintah apidog run untuk melihat hasil run di aplikasi Apidog, atau masukkan perintah yang sama ke CI dengan -r junit seperti dijelaskan di menjalankan Apidog CLI di CI/CD. Baru mengenal CLI? Panduan instalasi Apidog CLI dan Apidog CLI di Codex akan membuat Anda siap dalam hitungan menit. Paket gratis Apidog mencakup hingga 4 pengguna.
FAQ
Berapa biaya Qwen4-Max per 1M token? $1,50 untuk input dan $4,50 untuk output di wilayah Singapura, dengan pembacaan cache seharga $0,075. Kolom Beijing/Global sedikit lebih murah, yaitu $1,413 dan $4,24.
Apakah mode thinking lebih mahal di Qwen4-Max? Tarifnya sama, tetapi token reasoning ditagih sebagai output seharga $4,50 per 1M, sehingga reasoning yang panjang melipatgandakan biaya panggilan.
Apakah Qwen4-Max lebih murah dari Qwen3.8-Max? Ya. Input turun dari $2 menjadi $1,50, output dari $6 menjadi $4,50, dan hit cache implisit dari $0,25 menjadi $0,075 per 1M token. Alibaba juga melaporkan biaya per tugas Work360 turun dari $4,43 menjadi $1,67.
Bisakah saya menggunakan Qwen4-Max secara gratis? QwenCloud memberikan kuota gratis untuk model baru di wilayah Singapura, biasanya 1M token berlaku 90 hari, setelah Anda menambahkan detail pembayaran. Periksa halaman Free Tier di konsol untuk qwen4-max, dan lihat panduan akses gratis Qwen4-Max kami untuk semua jalur $0.
Apakah Qwen4-Max mendukung harga batch? Hanya di wilayah Beijing: Batch File seharga $0,707 input dan $2,12 output per 1M token, tanpa context caching.
Haruskah saya memilih Token Plan atau pay-per-token untuk Qwen4-Max? Token Plan cocok untuk satu orang yang menggunakan alat coding setiap hari, mulai dari $6 per bulan. Pay-per-token cocok untuk aplikasi, pekerjaan backend, dan batch.