
Rangkuman benchmark Qwen4-Max dalam satu kalimat: grafik Alibaba menempatkan Qwen4-Max di atas Qwen3.8-Max di seluruh 15 tes yang diikuti keduanya, dan di posisi pertama secara keseluruhan pada 4 dari 16 tes, tetapi sebagian besar angka tersebut berasal dari pengujian Alibaba sendiri. Di Work360, skornya 52,69 dibanding 47,74, dan biaya rata-rata per tugas turun dari $4,43 menjadi $1,67.
Sebuah benchmark hanya berguna jika kita tahu jawaban atas pertanyaan "siapa yang menjalankannya, dan bagaimana caranya?" Panduan ini mencakup semua skor yang dipublikasikan Alibaba pada 16 November 2026, mengelompokkannya menjadi hasil yang dilaporkan sendiri dan hasil pihak ketiga, serta diakhiri dengan cara menjalankan pengujian sendiri terhadap API Qwen4-Max. Untuk dasar-dasarnya, mulailah dengan apa itu Qwen4-Max dan cara mendapatkan aksesnya.
Sekilas skor benchmark Qwen4-Max
Postingan peluncuran Alibaba membandingkan Qwen4-Max dengan Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra, dan Kimi K3.1 pada 16 benchmark.
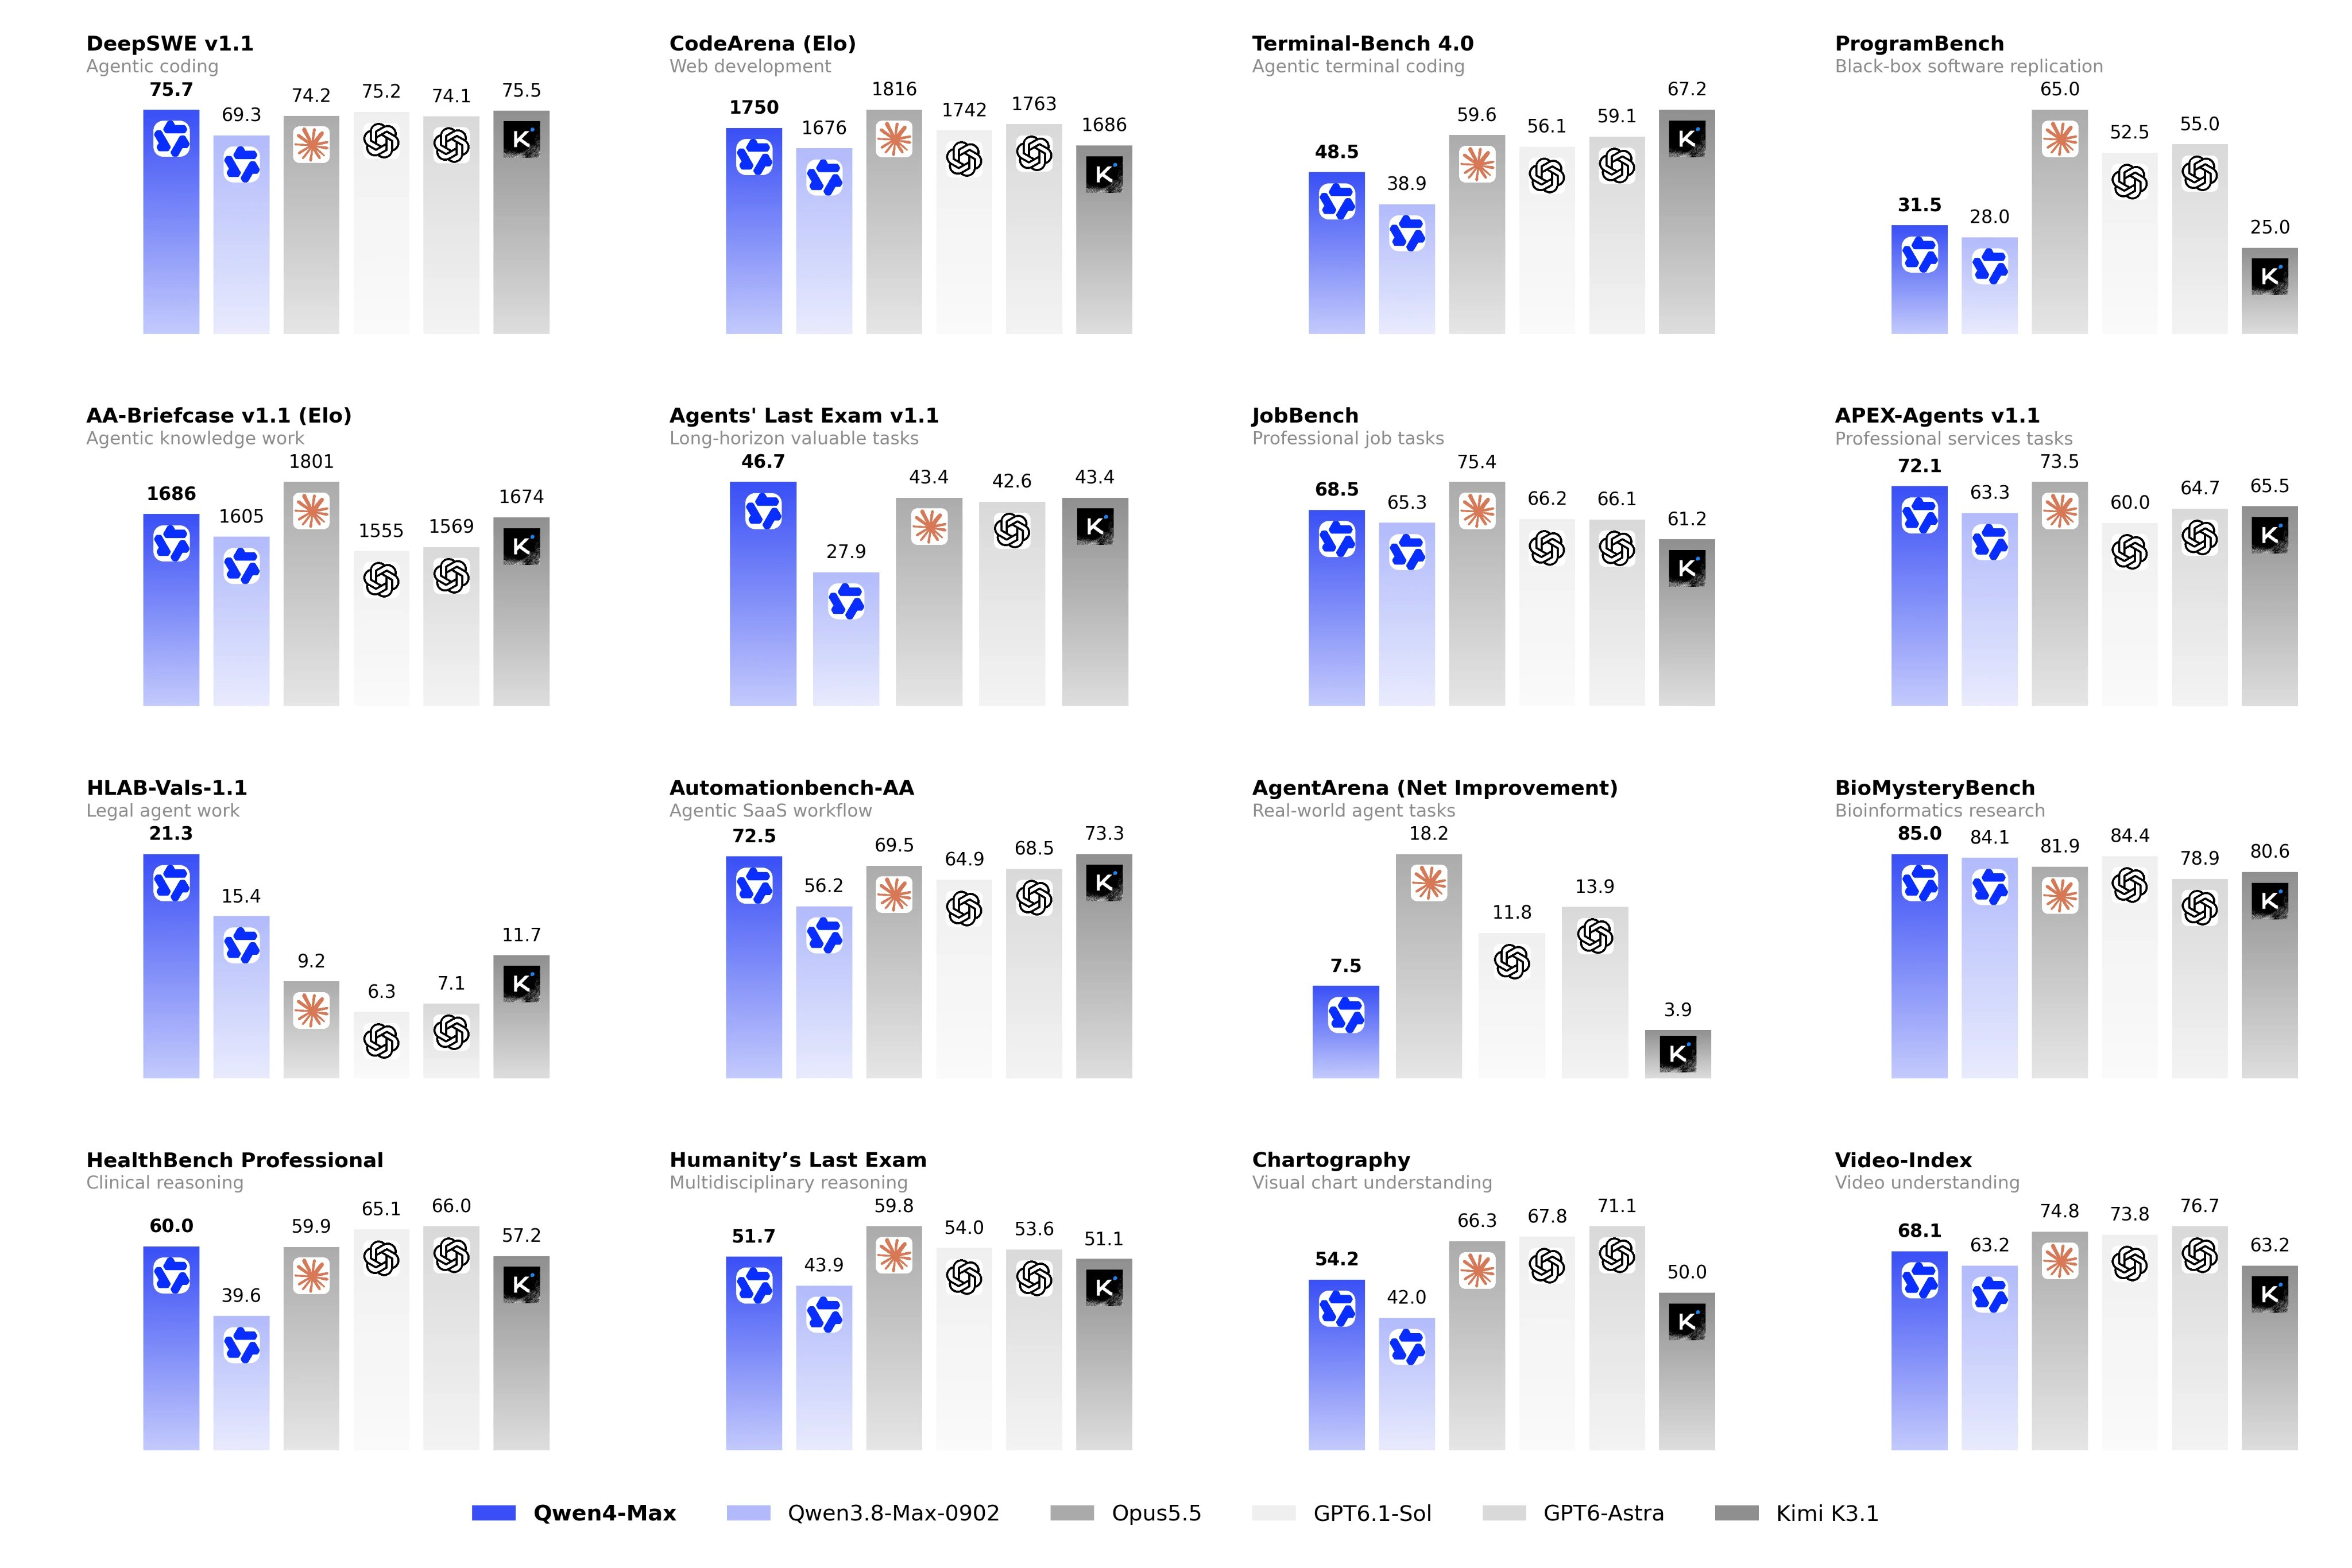
Huruf tebal menandai skor tertinggi dalam grafik. Tulisan "Alibaba" berarti catatan kaki tidak menyebutkan leaderboard eksternal untuk tes tersebut, jadi anggap saja itu hasil pengujian Alibaba sendiri (catatan kaki JobBench dan Chartography hanya menjelaskan pengaturan Alibaba).
Laporan sendiri vs pihak ketiga: siapa yang menjalankan setiap tes
Sepuluh dari 16 skor dilaporkan sendiri oleh Alibaba. Enam dikutip dari leaderboard publik yang dikelola pihak lain. Pembagian inilah filter paling berguna yang bisa Anda gunakan.
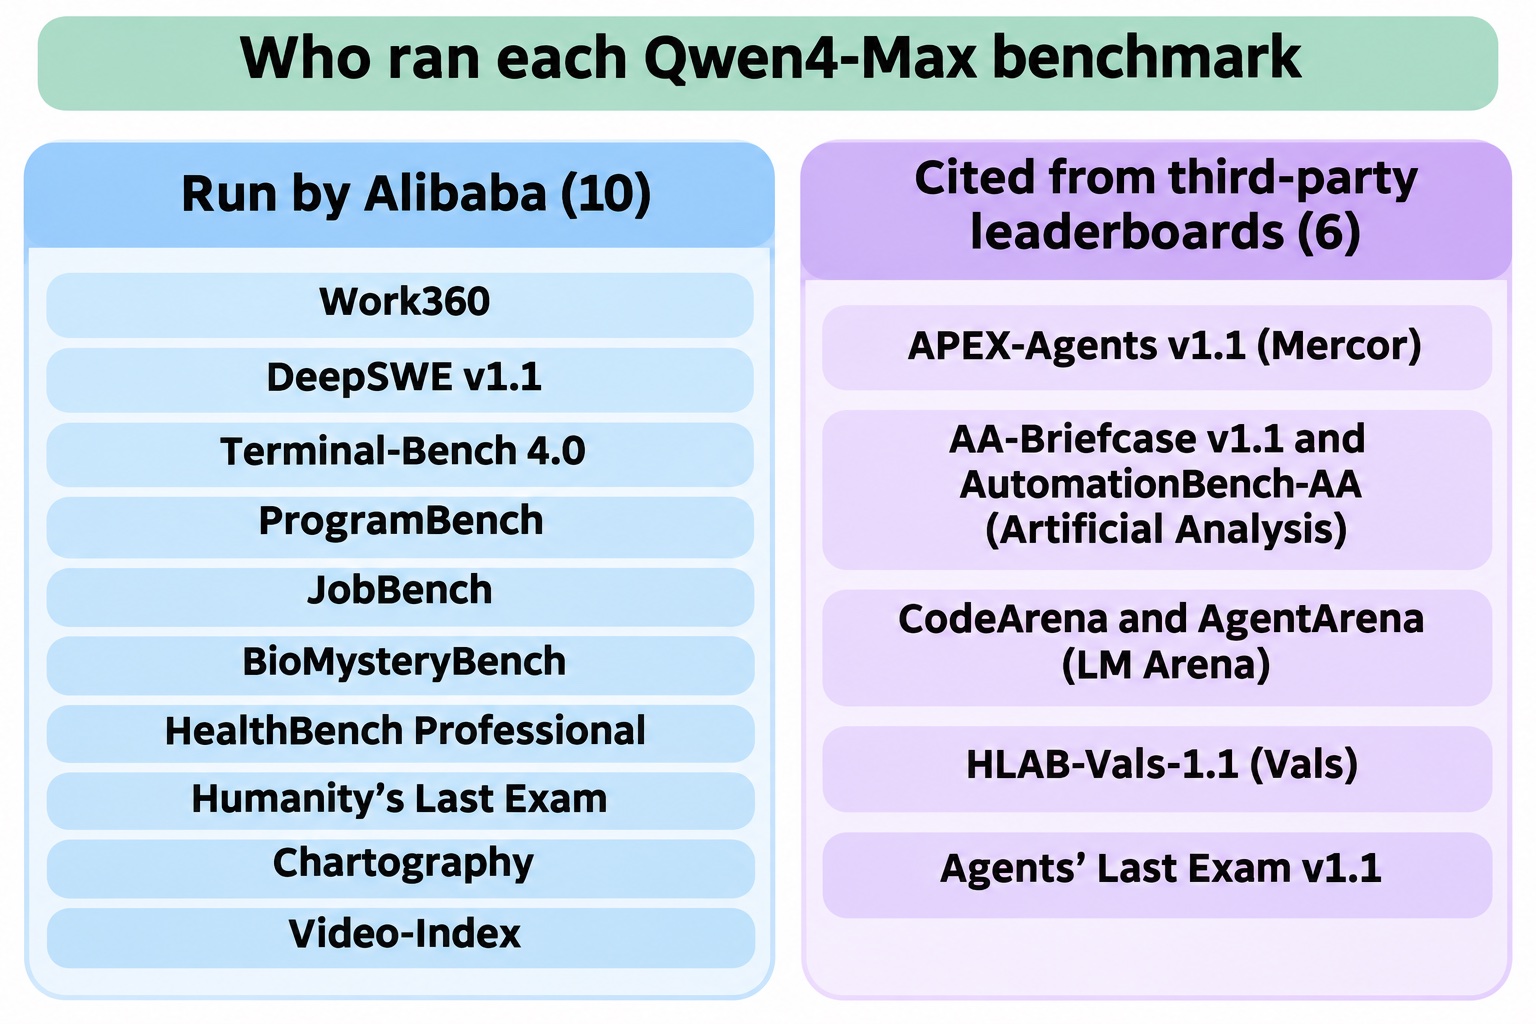
Kelompok pihak ketiga, menurut catatan kaki postingan peluncuran:
- APEX-Agents v1.1: dikutip dari leaderboard Mercor APEX-Agents
- AA-Briefcase v1.1 dan AutomationBench-AA: dikutip dari Artificial Analysis
- CodeArena dan AgentArena: dikutip dari LM Arena
- HLAB-Vals-1.1: dikutip dari Vals Index
- Agents' Last Exam v1.1: dikutip dari leaderboard miliknya sendiri
Satu angka independen yang bisa Anda periksa hari ini: Vals Index (versi 2.2, diperbarui 15 November 2026) mencantumkan Qwen 4 Max di 63,20% secara keseluruhan, peringkat 11, dengan harga $9,33 per tes. Ini menempatkannya di bawah sepuluh model, dipimpin Claude Fable 5.2 dengan 71,31%, dan tepat di atas Kimi K3.1 Pro (62,52%) serta Qwen 3.8 Max 0902 (59,05%). Gambarnya lebih sederhana daripada grafik utamanya.
Work360: benchmark pekerjaan milik Alibaba sendiri
Work360 adalah benchmark Alibaba untuk tugas industri kompleks, mencakup 26 domain, 182 subdomain, dan 721 bidang spesialisasi. Qwen4-Max mencatat skor 52,69, naik dari 47,74 milik Qwen3.8-Max.
Bacalah dengan hati-hati: Alibaba yang merancang benchmark dan menjalankan modelnya, perbandingan yang dipublikasikan hanya mencakup Qwen4-Max dan Qwen3.8-Max, dan belum ada leaderboard publik untuk itu. Ini adalah angka antar-generasi, bukan peringkat dibanding laboratorium lain.
Yang benar-benar diberikan Work360 adalah angka biaya: biaya rata-rata per tugas turun dari $4,43 menjadi $1,67, penurunan 62%, berkat kombinasi lebih sedikit token per tugas dan harga yang lebih murah. Qwen4-Max dihargai $1,50 per 1 juta token input dan $4,50 per 1 juta token output di halaman model QwenCloud. Rincian lengkapnya ada di panduan harga Qwen4-Max kami.
Terminal-Bench 4.0 dan efisiensi token
Terminal-Bench mengukur kemampuan agen menyelesaikan tugas nyata di terminal. Alibaba melaporkan 48,5 untuk Qwen4-Max pada versi 4.0, naik dari 38,9 milik Qwen3.8-Max. Di grafik Alibaba sendiri, keempat model non-Qwen berada di kisaran 56,1 hingga 67,2, semuanya di atasnya.
Klaim yang lebih besar adalah efisiensi. Alibaba mengatakan penggunaan token turun sekitar 48% pada tingkat upaya Xhigh dan 49% pada tingkat High di Terminal-Bench 4.0, serta sekitar 24% (Xhigh) dan 35% (High) di Work360. Grafik skor-vs-token mereka menunjukkan polanya:
- Di Work360, Qwen4-Max pada tingkat High sudah sedikit melampaui Qwen3.8-Max pada tingkat Xhigh, dengan sekitar 96K token per tugas dibanding sekitar 165K (dibaca dari grafik, jadi perkiraan).
- Di Terminal-Bench 4.0, Qwen4-Max pada tingkat Xhigh mencapai 48,5 dengan sekitar 150K token per tugas, sementara Qwen3.8-Max pada tingkat Xhigh mencapai sekitar 38 dengan sekitar 290K.
Lebih sedikit token untuk skor yang lebih baik adalah arah yang tepat jika Anda membayar per token. Tapi ini juga hasil laporan sendiri.
Satu hal yang perlu diketahui: leaderboard Terminal-Bench publik saat ini secara default menggunakan versi 4.1, dan Qwen4-Max belum tercantum di sana per 16 November. Qwen3.8-Max-0902 menunjukkan 27,0% di 4.1 (dijalankan dengan Claude Code pada upaya maksimal), dibandingkan 38,9 di grafik 4.0 milik Alibaba. Versi dan harness-nya berbeda, jadi jangan saling mengurangkan, tapi ini menunjukkan seberapa besar skor bisa berubah tergantung pengaturannya.
Di mana Qwen4-Max unggul, dan di mana ia tertinggal
Dibanding model-model frontier lain dalam grafik, hasilnya beragam:
Unggul (4 dari 16): DeepSWE v1.1 (75,7, unggul 0,2 poin atas Kimi K3.1), Agents' Last Exam v1.1 (46,7), HLAB-Vals-1.1 (21,3), dan BioMysteryBench (85,0, unggul kurang dari satu poin atas GPT-6.1 Sol).
Kedua sangat dekat: APEX-Agents v1.1 (72,1 vs 73,5), AutomationBench-AA (72,5 vs 73,3), dan AA-Briefcase (1686 vs 1801 Elo).
Jelas tertinggal: ProgramBench (31,5 vs 65,0), Terminal-Bench 4.0 (48,5 vs 67,2), AgentArena (7,5 vs 18,2), Chartography (54,2 vs 71,1), dan Humanity's Last Exam (51,7 vs 59,8).
Dua dari empat keunggulan tersebut, yaitu Agents' Last Exam dan HLAB-Vals, berasal dari leaderboard pihak ketiga, menjadikannya klaim terkuat dalam grafik. Soal coding: unggul tipis di DeepSWE, tapi tertinggal jauh di ProgramBench dan Terminal-Bench. Jika Anda menjalankan agen terminal jangka panjang, uji dulu sebelum berpindah. Untuk apa yang berubah sejak generasi terakhir, lihat Qwen4-Max vs Qwen 3.8.
Angka secure coding dan pre-training
Secure coding. Di Last Secure Code Bench, dalam skenario "rekonstruksi kode tanpa petunjuk keamanan" dengan fungsionalitas dan kerentanan keduanya diperiksa, tingkat kelulusan tingkat fungsi naik dari 22,0% milik Qwen3.8-Max menjadi 31,8%. Persentase kode yang lolos di ketiga tingkat (fungsi, berkas, dan repositori) naik dari 8% menjadi 14,7%. Sekitar dua pertiga keluaran tingkat fungsi masih gagal pemeriksaan, jadi tinjauan keamanan tetap menjadi tanggung jawab Anda.
Pre-training. Pada evaluasi internal di bidang pengetahuan, kode, QA, dan STEM, Qwen4-Max-Base menunjukkan bits per byte sekitar 5% hingga 13% lebih rendah daripada Qwen3.8-Max-Base sambil mengaktifkan 25% lebih sedikit parameter. Alibaba mencatat bahwa dua checkpoint dalam perbandingan itu (GLM-5.3 dan Kimi-K3.1-Pro) telah melalui post-training, yang bisa memengaruhi hasilnya.
Yang masih belum tersedia
- Pengaturan evaluasi untuk sebagian besar tes. Postingan peluncuran tidak menyebutkan tingkat upaya (High atau Xhigh) apa atau harness agen mana yang menghasilkan setiap batang grafik.
- Varians. Tidak ada error bar atau jumlah percobaan. Leaderboard seperti Terminal-Bench melaporkan margin sekitar 3 hingga 4 poin, lebih besar dari beberapa selisih di atas.
- Percobaan independen Terminal-Bench dan Work360. Keduanya belum ada di leaderboard publik mana pun.
Jalankan benchmark Qwen4-Max sendiri dengan Apidog CLI
Tidak ada benchmark publik yang menggunakan prompt atau skema Anda. Pemeriksaan paling jujur dan tercepat adalah serangkaian kecil permintaan Anda sendiri, dijalankan dengan cara yang sama setiap saat, dengan pencatatan penggunaan token agar Anda bisa menghitung biaya per tugas Anda sendiri.
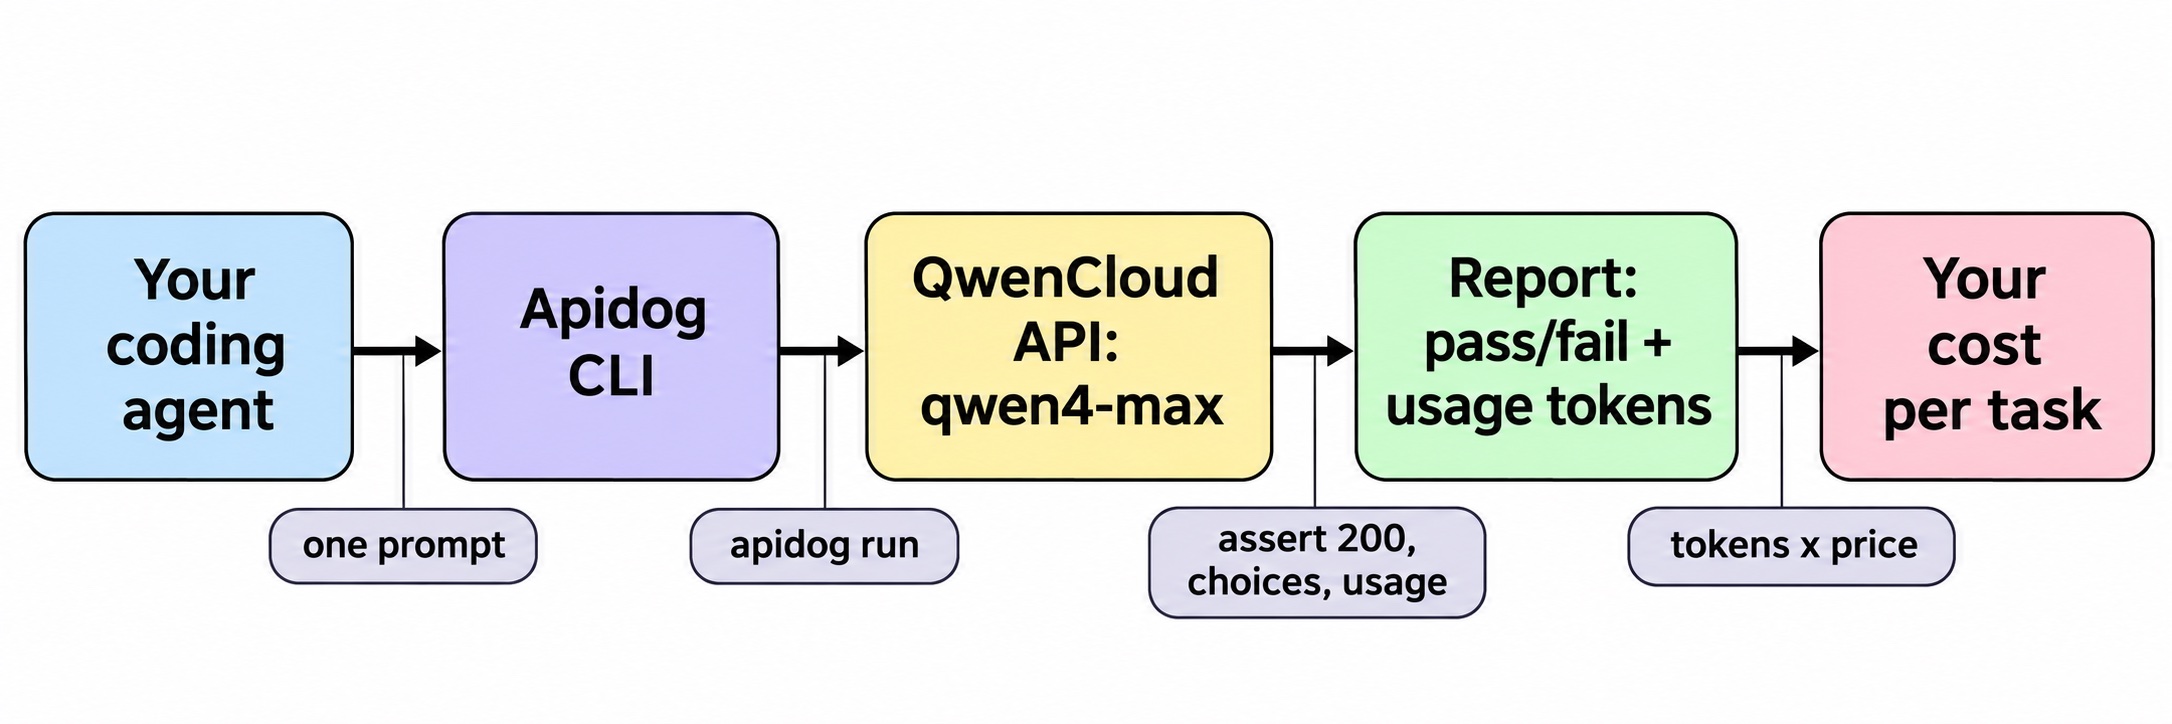
Biarkan agen coding Anda yang melakukan penyiapan dengan Apidog CLI. Instal sekali:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install mengajarkan CLI kepada agen Anda; panduan instalasi menjelaskan soal token. Lalu berikan satu prompt:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
Agen memeriksa bentuk setiap payload sebelum menulis apa pun. Semua flag di bawah berasal dari apidog <command> --help pada Apidog CLI 2.2.12:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-d menjalankan satu iterasi per baris berkas prompt Anda, dan --env-var meneruskan kunci saat runtime sehingga tidak pernah tersimpan di proyek. Agen membaca setiap blok usage dari laporan JSON di apidog-reports. Kalikan token prompt dengan $1,50 dan token completion dengan $4,50 per juta, dan Anda mendapatkan biaya per tugas versi sendiri untuk dibandingkan dengan $1,67 milik Alibaba.
Ganti environment untuk menjalankan rangkaian yang sama terhadap model Anda saat ini, dan ulangi dua atau tiga kali untuk melihat varians yang tidak ditampilkan grafik peluncuran. Baris apidog run yang sama bisa dimasukkan ke CI dengan -r junit; lihat panduan CI/CD. Untuk penyiapan agen langkah demi langkah, lihat Apidog CLI di Claude Code. Paket Gratis Apidog mencakup hingga 4 pengguna.
FAQ
Apakah benchmark Qwen4-Max independen? Sebagian besar tidak. Sepuluh dari 16 skor dalam grafik Alibaba adalah hasil pengujian mereka sendiri. Enam dikutip dari leaderboard pihak ketiga: APEX-Agents (Mercor), AA-Briefcase dan AutomationBench-AA (Artificial Analysis), CodeArena dan AgentArena (LM Arena), HLAB-Vals (Vals), serta Agents' Last Exam.
Apa itu Work360? Benchmark milik Alibaba sendiri untuk tugas industri kompleks yang mencakup 26 domain. Qwen4-Max mencatat skor 52,69 dibanding 47,74 milik Qwen3.8-Max; hanya dua model itu yang muncul dalam perbandingan yang dipublikasikan.
Bagaimana performa Qwen4-Max di Terminal-Bench 4.0? Alibaba melaporkan 48,5, naik dari 38,9, dengan sekitar setengah jumlah token. Model frontier lain dalam grafik mencatat skor 56,1 hingga 67,2.
Apakah Qwen4-Max lebih murah dijalankan daripada Qwen3.8-Max? Pada evaluasi Work360 Alibaba, biaya rata-rata per tugas turun dari $4,43 menjadi $1,67. Harga daftar adalah $1,50 input dan $4,50 output per 1 juta token. Lihat panduan Token Plan untuk opsi langganan dan Qwen4-Max gratis untuk cara tanpa biaya.
Apa itu Live Delivery dalam peluncuran Qwen4-Max? Alur kerja agen yang mengirimkan versi pertama yang bisa dipakai lebih awal dan terus memperbaikinya selagi Anda mengarahkannya. Ini bukan benchmark. Panduan plugin Qwen Live Delivery kami membahasnya lebih lanjut.