
API Qwen4-Max kini tersedia di QwenCloud sebagai model bayar-per-token dengan ID qwen4-max. Buat kunci bayar sesuai pemakaian (pay-as-you-go) di wilayah Anda, arahkan OpenAI SDK ke https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 (Singapura), lalu panggil. Harganya $1,50 per juta token input dan $4,50 per juta token output, dengan konteks 1 juta token.
Panduan ini membahas kunci, base URL, thinking, vision, tools, structured outputs, caching, jalur Anthropic, batasan, dan error. Setiap cuplikan kode mengikuti dokumentasi QwenCloud sebagaimana dibaca pada 16 November 2026.
Untuk latar belakang, baca apa itu Qwen4-Max. Untuk akses berbasis langganan alih-alih bayar-per-token, lihat semua cara menggunakan Qwen4-Max dan panduan Token Plan.
Apa yang ditawarkan API Qwen4-Max
API Qwen4-Max adalah model unggulan Alibaba yang disajikan melalui QwenCloud dengan endpoint yang kompatibel dengan OpenAI, Anthropic, dan DashScope. Model ini menerima input teks, gambar, dan video, mengembalikan teks, berpikir (thinking) sebelum menjawab secara default, serta mendukung function calling, structured outputs, context caching, batch jobs, web search, dan fine-tuning.
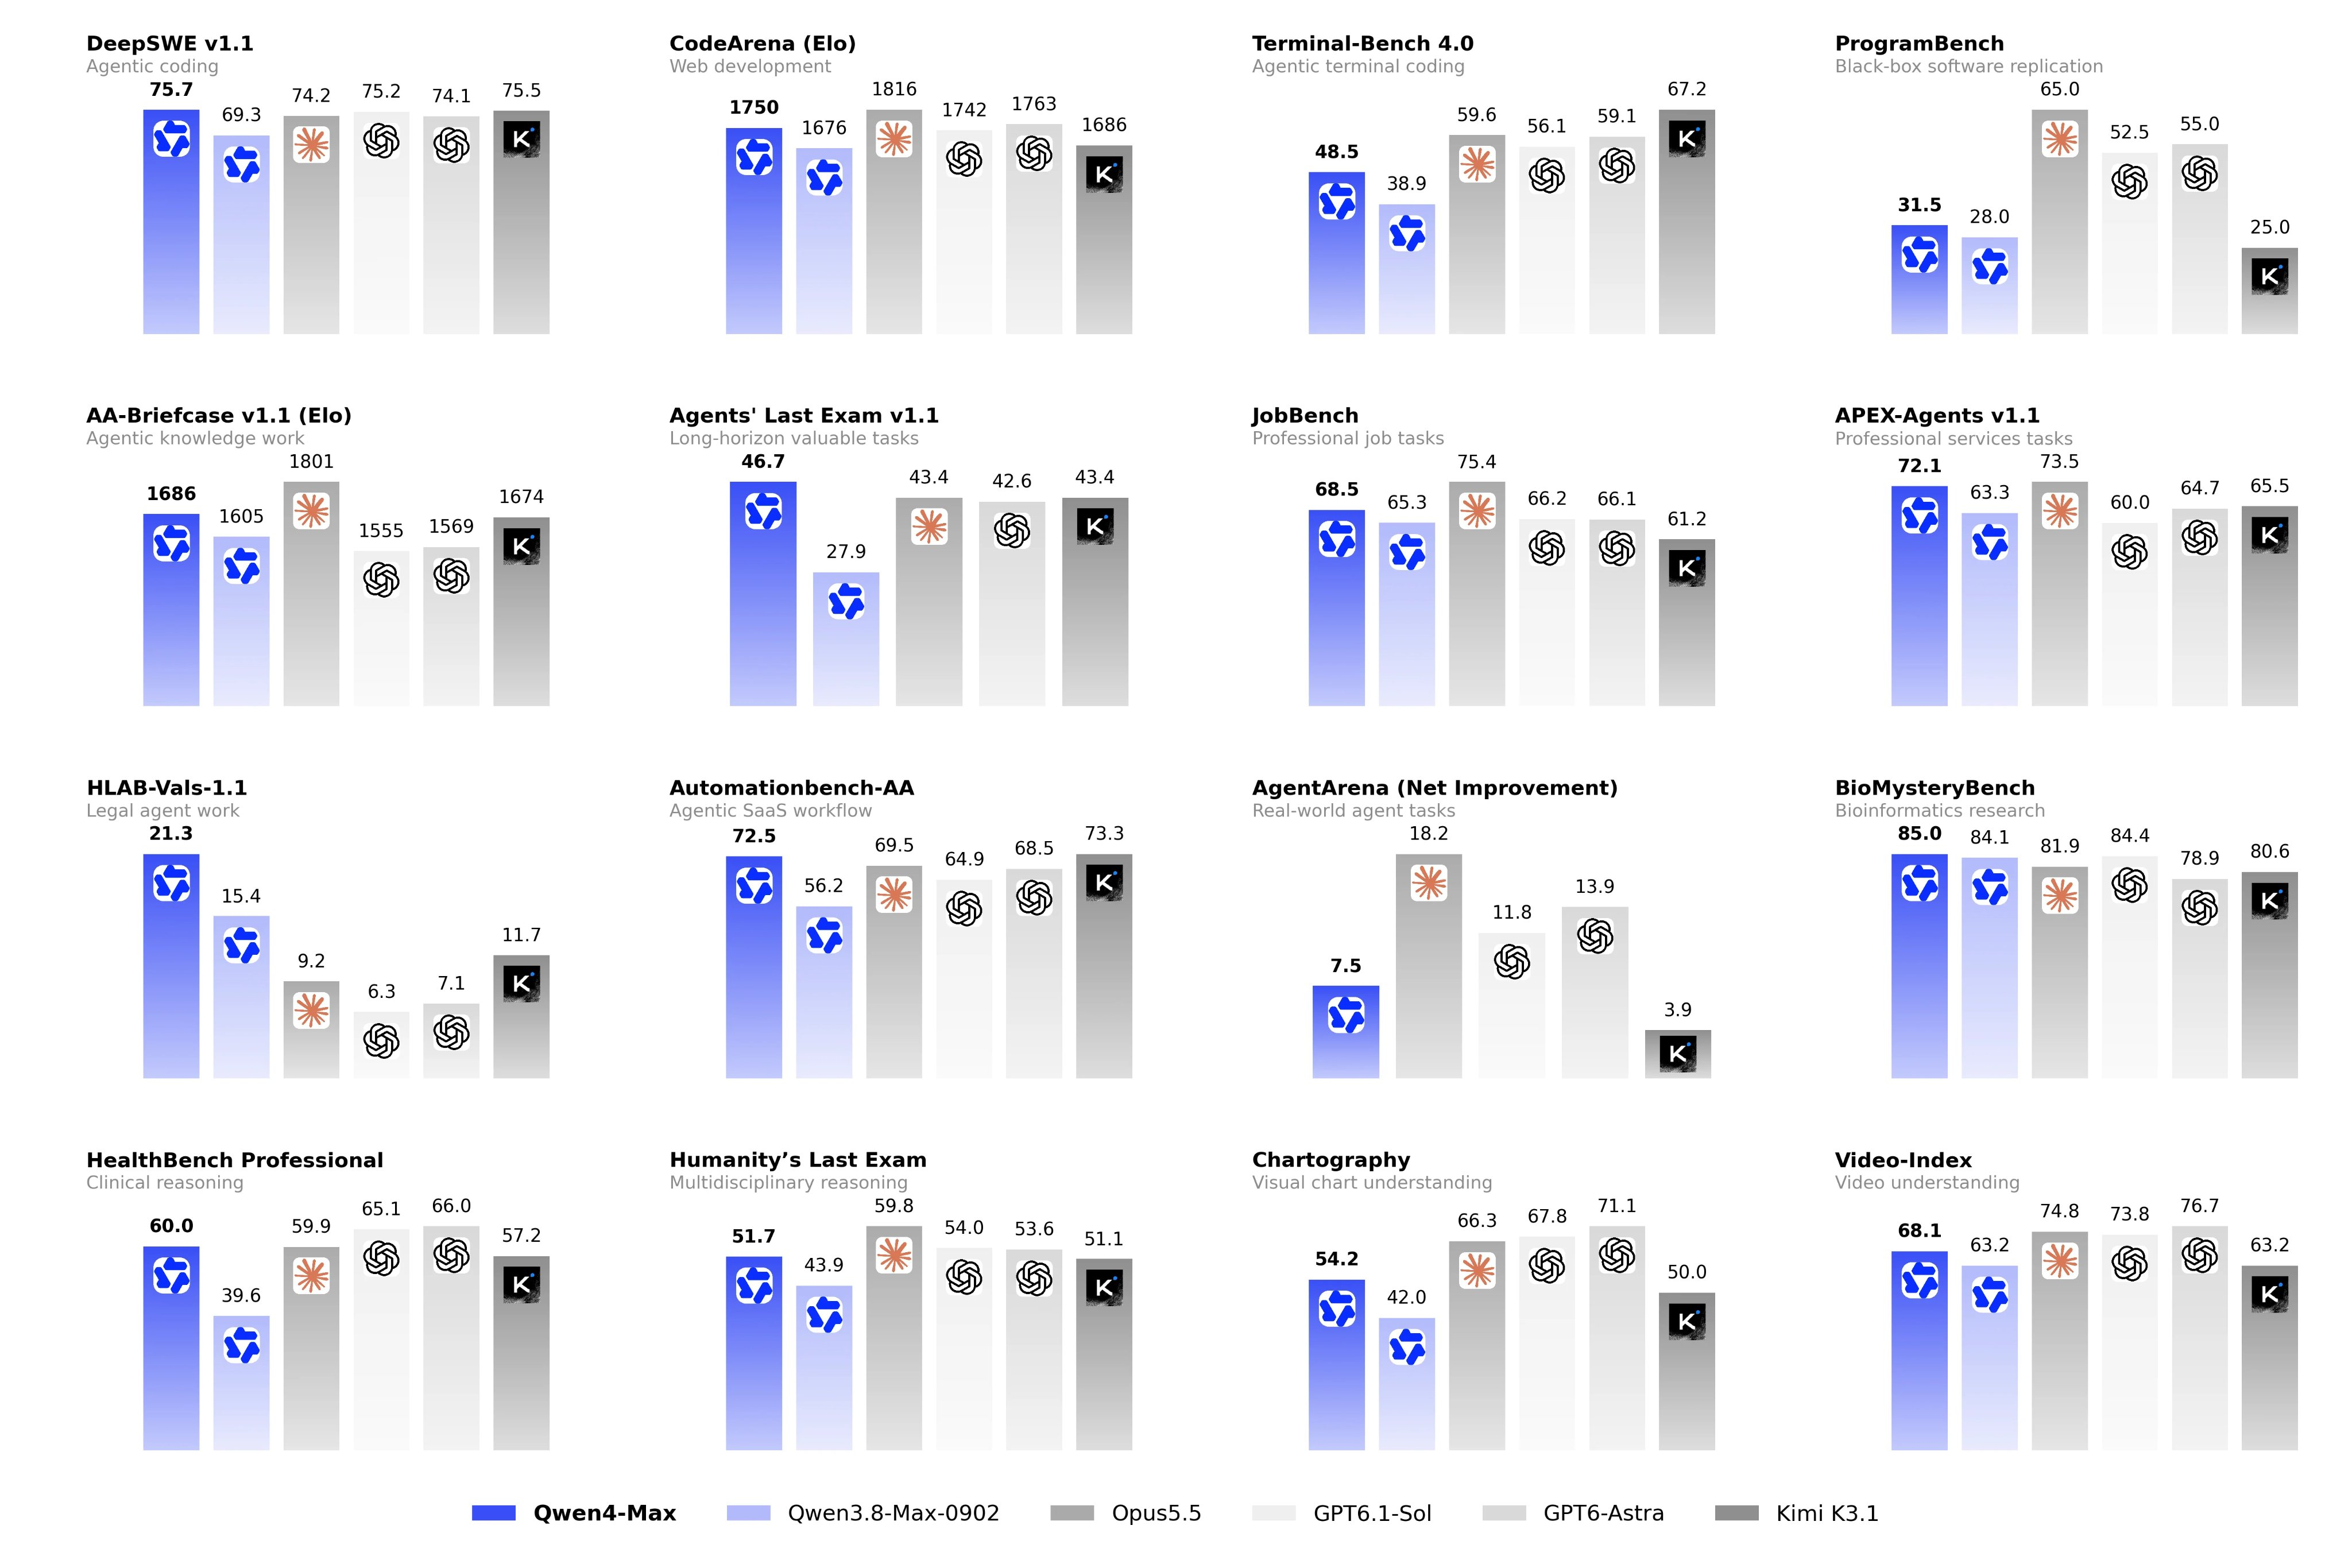
Berikut angka-angka dari halaman model qwen4-max:
| Item | Nilai |
|---|---|
| ID Model | qwen4-max |
| Harga input | $1,50 per 1 juta token |
| Harga output | $4,50 per 1 juta token |
| Implicit cache input / explicit cache read | $0,075 per 1 juta token |
| Pembuatan explicit cache | $1,875 (5 menit) atau $3 (1 jam) per 1 juta token |
| Jendela konteks | 1 juta token |
| Maksimum input | 991K (983K dengan thinking) |
| Maksimum output | 393K |
| Maksimum reasoning | 262K |
| Throughput | 5.000.000 TPM |
Token thinking ditagih sebagai token output. Untuk rincian biaya lengkap, lihat panduan harga Qwen4-Max.
Dapatkan kunci dan pilih base URL yang tepat
Kunci terikat pada wilayah, dan jenis kunci harus sesuai dengan endpoint.
- Buka konsol QwenCloud dan pilih wilayah di pemilih bagian kanan atas.
- Buka API Keys, klik Create API key, tambahkan deskripsi, lalu klik Generate Key.
- Salin kuncinya segera. Kunci hanya ditampilkan sekali. Kunci bayar sesuai pemakaian baru dimulai dengan
sk-ws-. - Ekspor kuncinya:
export DASHSCOPE_API_KEY="sk-ws-...".
Setiap wilayah menggunakan domain {region}.maas.qwencloudapi.com. Singapura adalah ap-southeast-1; Frankfurt adalah eu-central-1, Tokyo adalah ap-northeast-1, dan AS (Virginia) adalah us-east-1. Kemudian tambahkan jalur protokolnya:
| Protokol | Base URL (Singapura) |
|---|---|
| Kompatibel OpenAI (Chat Completions, Responses) | https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 |
| Kompatibel Anthropic | https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic |
| DashScope HTTP | https://ap-southeast-1.maas.qwencloudapi.com/api/v1 |
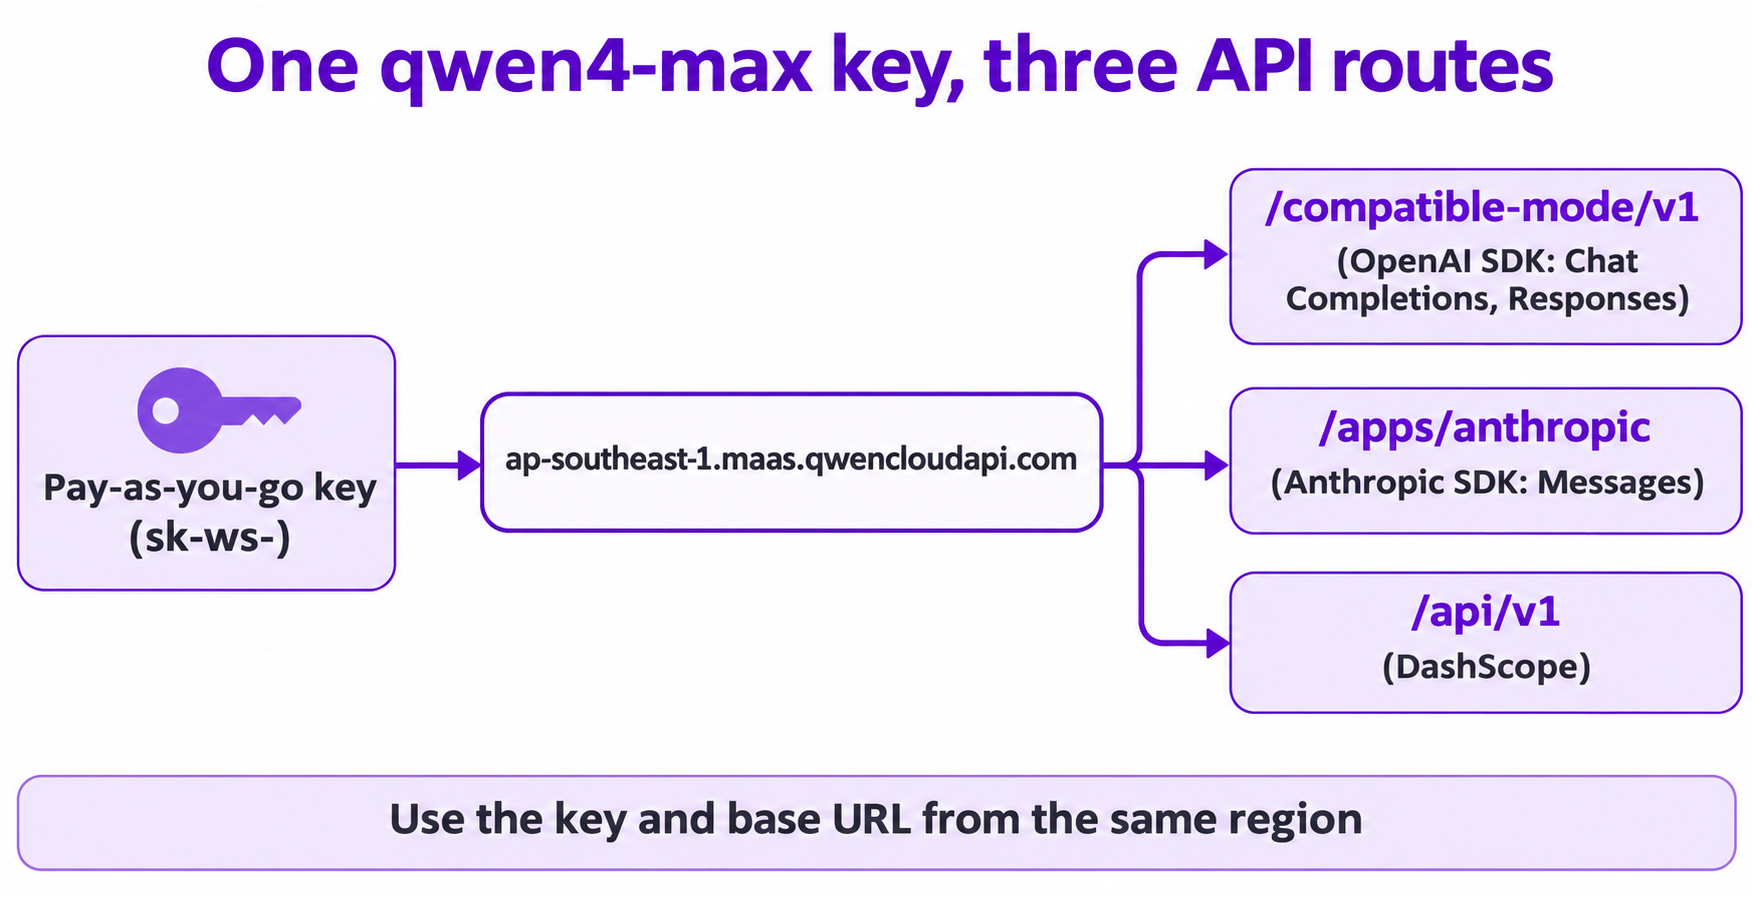
Kunci Token Plan (sk-sp-) hanya berfungsi di token-plan.maas.qwencloudapi.com, dan kunci bayar sesuai pemakaian hanya berfungsi di domain wilayahnya sendiri. Mencampur keduanya menyebabkan error 401. Lihat wilayah dan endpoint.
Panggilan API Qwen4-Max pertama Anda
Instal OpenAI SDK (pip install openai) dan jalankan quickstart dari dokumentasi:
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.getenv("DASHSCOPE_API_KEY"),
  base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1"
)
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Summarize the benefits of solar energy in three bullet points."}]
)
print(completion.choices[0].message.content)
Thinking aktif secara default untuk qwen4-max, jadi panggilan ini juga menghabiskan token reasoning. Untuk prompt yang panjang, gunakan streaming atau atur timeout klien minimal 180 detik.
Mode thinking dan streaming reasoning_content
Qwen4-Max adalah model hybrid thinking. Default yang tercantum di dokumentasi adalah enable_thinking=true, reasoning_effort=high, dan thinking_budget=131072. Level effort adalah low, high, dan xhigh; none mematikan thinking.
Streaming reasoning dan jawaban sebagai dua fase (diadaptasi dari contoh di halaman model):
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
messages = [{"role": "user", "content": "Who are you"}]
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True)  # phase 1: thinking
    if delta.content:
        print(delta.content, end="", flush=True)            # phase 2: answer
Tiga aturan penting:
- Batasi output dengan
max_completion_tokens. Dengan thinking aktif,max_tokenshanya menerima nilai 1 hingga 32.768 (selain itu muncul error 400).max_completion_tokensmencakup reasoning plus balasan tanpa batas tersebut. - Atur kedalaman dengan
extra_body. Gunakan{"enable_thinking": True, "reasoning_effort": "xhigh"}untuk masalah yang sulit, atau"low"untuk masalah yang sederhana. - Pertahankan reasoning dalam percakapan multi-turn.
qwen4-maxmemilikipreserve_thinkingaktif secara default, jadi kirim reasoning sebelumnya kembali melalui fieldreasoning_contentpada setiap pesan assistant, jangan di dalamcontent.
Untuk melewati thinking, kirim {"enable_thinking": False}.
Input gambar dan video
Kirim gambar sebagai bagian image_url dan video sebagai bagian video_url. Ini mengikuti contoh vision dari dokumentasi dengan model disetel ke qwen4-max:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{
    "role": "user",
    "content": [
      {"type": "image_url", "image_url": {"url": "https://example.com/invoice.jpg"}},
      {"type": "text", "text": "Describe what you see in this image"},
    ],
  }],
)
Untuk video, gunakan {"type": "video_url", "video_url": {"url": "..."}, "fps": 2}. File lokal dimasukkan sebagai Data URI Base64.
Panduan vision mengizinkan hingga 2.048 gambar URL berukuran 20 MB masing-masing, 250 gambar Base64, dan 64 MB per permintaan. Detail gambar secara default bernilai high, yang menghabiskan lebih banyak token input.
Function calling
Kirim array tools seperti model yang kompatibel dengan OpenAI pada umumnya:
tools = [{
  "type": "function",
  "function": {
    "name": "get_current_weather",
    "description": "Useful when you want to check the weather for a specific city.",
    "parameters": {
      "type": "object",
      "properties": {"location": {"type": "string", "description": "City or county, such as Singapore or New York."}},
      "required": ["location"],
    },
  },
}]
completion = client.chat.completions.create(model="qwen4-max", messages=messages, tools=tools)
Baca message.tool_calls, jalankan fungsi tersebut, tambahkan pesan tool, lalu panggil lagi.
Dalam mode thinking, tool_choice hanya menerima "auto" atau "none"; untuk memaksa fungsi tertentu, matikan thinking terlebih dahulu. Dengan thinking aktif, kirim kembali reasoning_content bersama hasil tool, jika tidak akurasinya akan menurun.
Structured outputs
qwen4-max mendukung mode JSON Schema ketat (strict):
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Extract the name and age: Ana is 31."}],
  response_format={
    "type": "json_schema",
    "json_schema": {
      "name": "user_info",
      "strict": True,
      "schema": {
        "type": "object",
        "properties": {"name": {"type": "string"}, "age": {"type": "integer"}},
        "required": ["name", "age"],
        "additionalProperties": False,
      },
    },
  },
)
Dengan mode yang lebih longgar {"type": "json_object"}, kata "JSON" harus muncul di salah satu pesan, atau API akan menolak permintaan tersebut. Input gambar atau video akan beralih ke json_object, sehingga schema tidak ditegakkan pada panggilan multimodal.
Context cache dan batch
Cache. Tanpa pengaturan apa pun, implicit cache mencocokkan prefix tetapi tidak menjamin kecocokan (hit). Untuk hasil yang deterministik, gunakan explicit cache Qwen4: tandai blok konten dengan "prompt_cache_breakpoint": {"mode": "explicit"} (pesan content harus berupa array), dan atur TTL dengan extra_body={"prompt_cache_options": {"mode": "explicit", "ttl": "5m"}}. TTL-nya 5m atau 1h, dan prefix yang di-cache membutuhkan setidaknya 1.024 token. Pembacaan cache berharga $0,075 per juta token, 95% lebih murah daripada input baru.
Batch. Panduan batch menagih input dan output sebesar 50% dari harga real-time dan mengembalikan hasil dalam 24 jam. Untuk qwen4-max, Batch File berjalan di satu wilayah di luar Singapura dan tidak mendukung context caching, jadi periksa panduan batch sebelum merancang pipeline di sekitarnya.
Jalur yang kompatibel dengan Anthropic
Sudah membangun dengan Anthropic SDK? Cukup ubah base URL dan kuncinya:
import anthropic
import os

client = anthropic.Anthropic(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic",
)
message = client.messages.create(
    model="qwen4-max",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Who are you?"}],
    thinking={"type": "disabled"},
)
print(message.content)
Contoh ini mematikan thinking, sama seperti contoh di dokumentasi. Akhiri base URL di /apps/anthropic. Menambahkan /v1/ akan menghasilkan /v1/v1/... dan error 404. Thinking juga aktif secara default di sini, dan dengan thinking diaktifkan, max_tokens harus lebih besar dari thinking budget. Effort menggunakan output_config.effort (low, high, xhigh), dan tool bawaan web_search serta web_fetch tersedia di jalur ini.
Batasan rate limit API Qwen4-Max
Dari halaman rate limits:
| Wilayah | RPM | TPM |
|---|---|---|
| Singapura | Dinamis | Tingkatan dinamis: 5M, 10M, 20M |
| Frankfurt, Tokyo, AS (Virginia), dan wilayah Global-scope lainnya | 30.000 | 5.000.000 |
Batasan berlaku per akun per wilayah dan juga per detik (RPS = RPM / 60), jadi lonjakan permintaan tiba-tiba bisa membuat Anda dibatasi meskipun masih di bawah total per menit.
Halaman kuota gratis menyatakan bahwa kuota gratis hanya tersedia di Singapura, berlaku per model (umumnya 1.000.000 token), berlangsung 90 hari, dan membutuhkan data pembayaran yang terdaftar. Halaman tersebut tidak menyebutkan qwen4-max, jadi periksa halaman Free Tier di konsol, atau baca cara menggunakan Qwen4-Max secara gratis.
Error umum pada API Qwen4-Max
| Kode | Artinya | Solusi |
|---|---|---|
401 InvalidApiKey |
Kunci dan base URL berasal dari wilayah yang berbeda, atau kunci Token Plan dipakai di endpoint bayar sesuai pemakaian | Gunakan kunci yang dibuat di wilayah yang sama dengan URL |
400 InvalidParameter |
Sering kali max_tokens di luar rentang 1 hingga 32.768 dengan thinking aktif |
Beralih ke max_completion_tokens |
403 AllocationQuota.FreeTierOnly |
Kuota gratis habis sebelum pengaturan pembayaran | Tambahkan data pembayaran di halaman Free Tier |
404 ModelNotFound |
qwen4-max tidak tersedia di wilayah yang Anda panggil |
Periksa harga Model untuk wilayah tersebut |
429 Throttling |
Batas RPM atau TPM tercapai | Kurangi beban lalu coba lagi, atau sebar beban dalam beberapa detik |
Biarkan coding agent Anda menguji API Qwen4-Max dengan Apidog CLI
Coding agent Anda yang menulis integrasinya, jadi biarkan ia juga menulis regresi testnya. Apidog CLI memungkinkannya menyimpan endpoint, menyimpan kunci, dan menjalankan assertions.
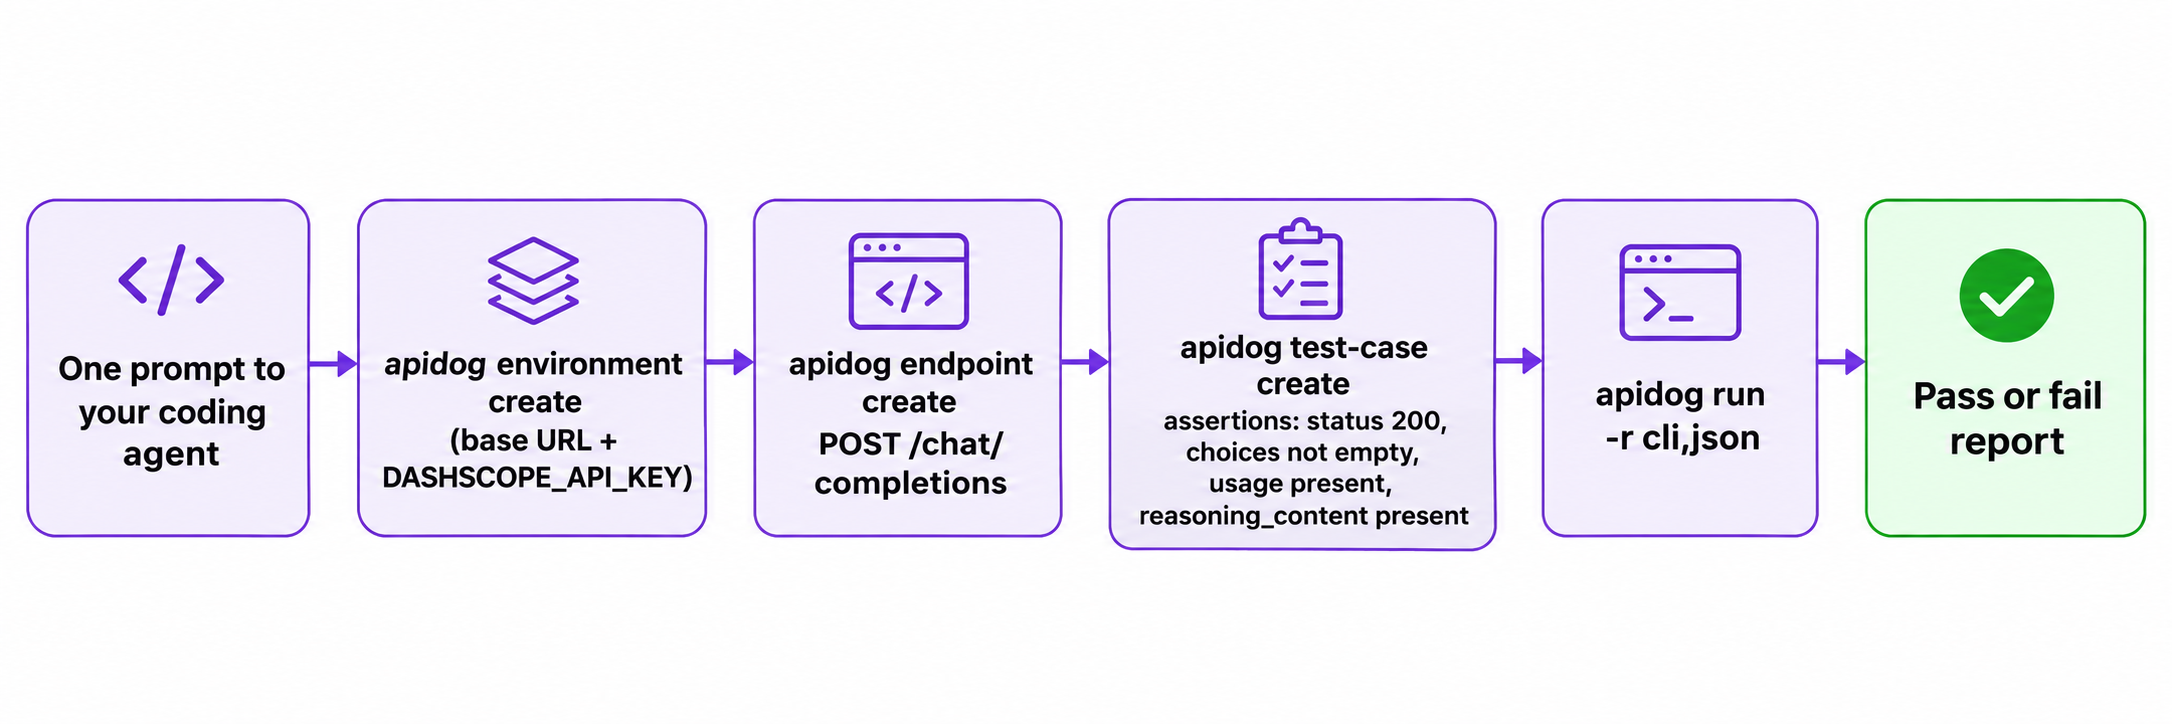
Atur sekali saja:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt kepada agent Anda:
In Apidog project <projectId>, create an environment "Qwen Singapore" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable DASHSCOPE_API_KEY. Add POST /chat/completions with a Bearer auth header,
model qwen4-max and enable_thinking true. Create a test case asserting status 200,
a non-empty choices array, a usage object, and reasoning_content present on the
first choice's message. Run it and summarize any failures.
Agent membaca schema setiap payload sebelum menulis, lalu menjalankan test case-nya:
apidog environment create "Qwen Singapore" --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Reporter cli mencetak lulus atau gagal; json menulis laporan yang dibaca oleh agent. Pindahkan perintah apidog run ... -r junit yang sama ke CI dengan panduan CI/CD Apidog CLI, dan lihat Apidog CLI di Claude Code untuk lebih banyak prompt. Paket Free Apidog mencakup hingga 4 pengguna.
FAQ
Apa ID model dari API Qwen4-Max?
ID yang stabil adalah qwen4-max. ID qwen4-max-preview sebelumnya hanya untuk Token Plan selama masa pratinjau yang dimulai pada 11 November 2026.
Apakah API Qwen4-Max kompatibel dengan OpenAI?
Ya. Gunakan OpenAI SDK dengan base URL /compatible-mode/v1 untuk Chat Completions dan Responses API. Endpoint yang kompatibel dengan Anthropic dan API DashScope juga tersedia.
Bagaimana cara mematikan thinking di API Qwen4-Max?
Kirim extra_body={"enable_thinking": False}. Anda kehilangan reasoning_content, tetapi latensi dan token output berkurang. Ingin membandingkan model? Lihat Qwen4-Max vs Qwen3.8.
Berapa biaya API Qwen4-Max?
$1,50 per juta token input dan $4,50 per juta token output, dengan pembacaan cache seharga $0,075 per juta token.
Bisakah saya menggunakan kunci Token Plan saya dengan API bayar-per-token?
Tidak. Kunci Token Plan (sk-sp-) hanya berfungsi di token-plan.maas.qwencloudapi.com, dan kunci bayar sesuai pemakaian hanya berfungsi di domain wilayahnya sendiri.