
Alibaba merilis Qwen 3.8-Max pada awal Agustus 2026, dan jika Anda sudah menjalankan qwen3.7-max dalam produksi, Anda memiliki keputusan penting yang harus dibuat. Model baru ini menunjukkan peningkatan besar pada benchmark agen dan penelitian, menambahkan input gambar, diluncurkan dengan harga daftar yang lebih rendah, dan hadir dengan janji yang belum pernah dibuat Alibaba untuk pendahulunya: bobot terbuka.
Namun, keputusan itu tidak sesederhana "model baru menang." Qwen 3.7-Max saat ini sedang menjalankan diskon 50% terbatas waktu yang membuatnya lebih murah daripada 3.8-Max secara absolut. Beberapa perbedaan benchmark sangat dramatis. Yang lain secara efektif nol. Artikel ini akan membahas setiap perubahan yang penting, sehingga Anda dapat memutuskan apakah akan beralih sekarang, menunggu, atau sepenuhnya turun ke tingkat yang lebih rendah.
Jika Anda ingin gambaran lengkap tentang model baru ini terlebih dahulu, mulailah dengan penjelasan Qwen 3.8-Max kami. Untuk latar belakang tentang _flagship_ yang akan digantikan, lihat apa yang ditawarkan Qwen 3.7.
Satu catatan tentang metodologi sebelum melihat angka-angkanya. Setiap angka benchmark di bawah ini berasal dari tabel Alibaba sendiri dalam postingan rilis resmi Qwen 3.8. Ini sebenarnya berguna di sini: kedua model dievaluasi dalam uji coba vendor yang sama, sehingga perbedaan-perbedaannya konsisten secara internal, meskipun verifikasi independen masih tertunda. Sebagian besar baris pengkodean dijalankan pada _harness_ Claude Code, dan beberapa benchmark adalah internal Qwen.
Versi singkatnya
| Apa yang berubah | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| Terminal Bench 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQA Diamond | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| Harga daftar (per 1 Juta token) | $2.5 masuk / $7.5 keluar | $2 masuk / $6 keluar |
| Harga saat ini (promo) | $1.25 masuk / $3.75 keluar | $2 masuk / $6 keluar |
| Input gambar | Tidak | Ya |
| Arsitektur yang diungkapkan | Tidak diungkapkan | Total 2.4T, 95B MoE aktif |
| Bobot terbuka | Tidak pernah dirilis | Dijanjikan "minggu depan" (~10 Agustus) |
| Jendela konteks | 1 Juta token | 1 Juta token |
Sekarang detailnya.
Perbedaan benchmark: di mana peningkatannya nyata
Peningkatan utama terkumpul di sekitar pekerjaan agen: tugas berjangka panjang di mana model merencanakan, melaksanakan, dan mengoreksi diri.
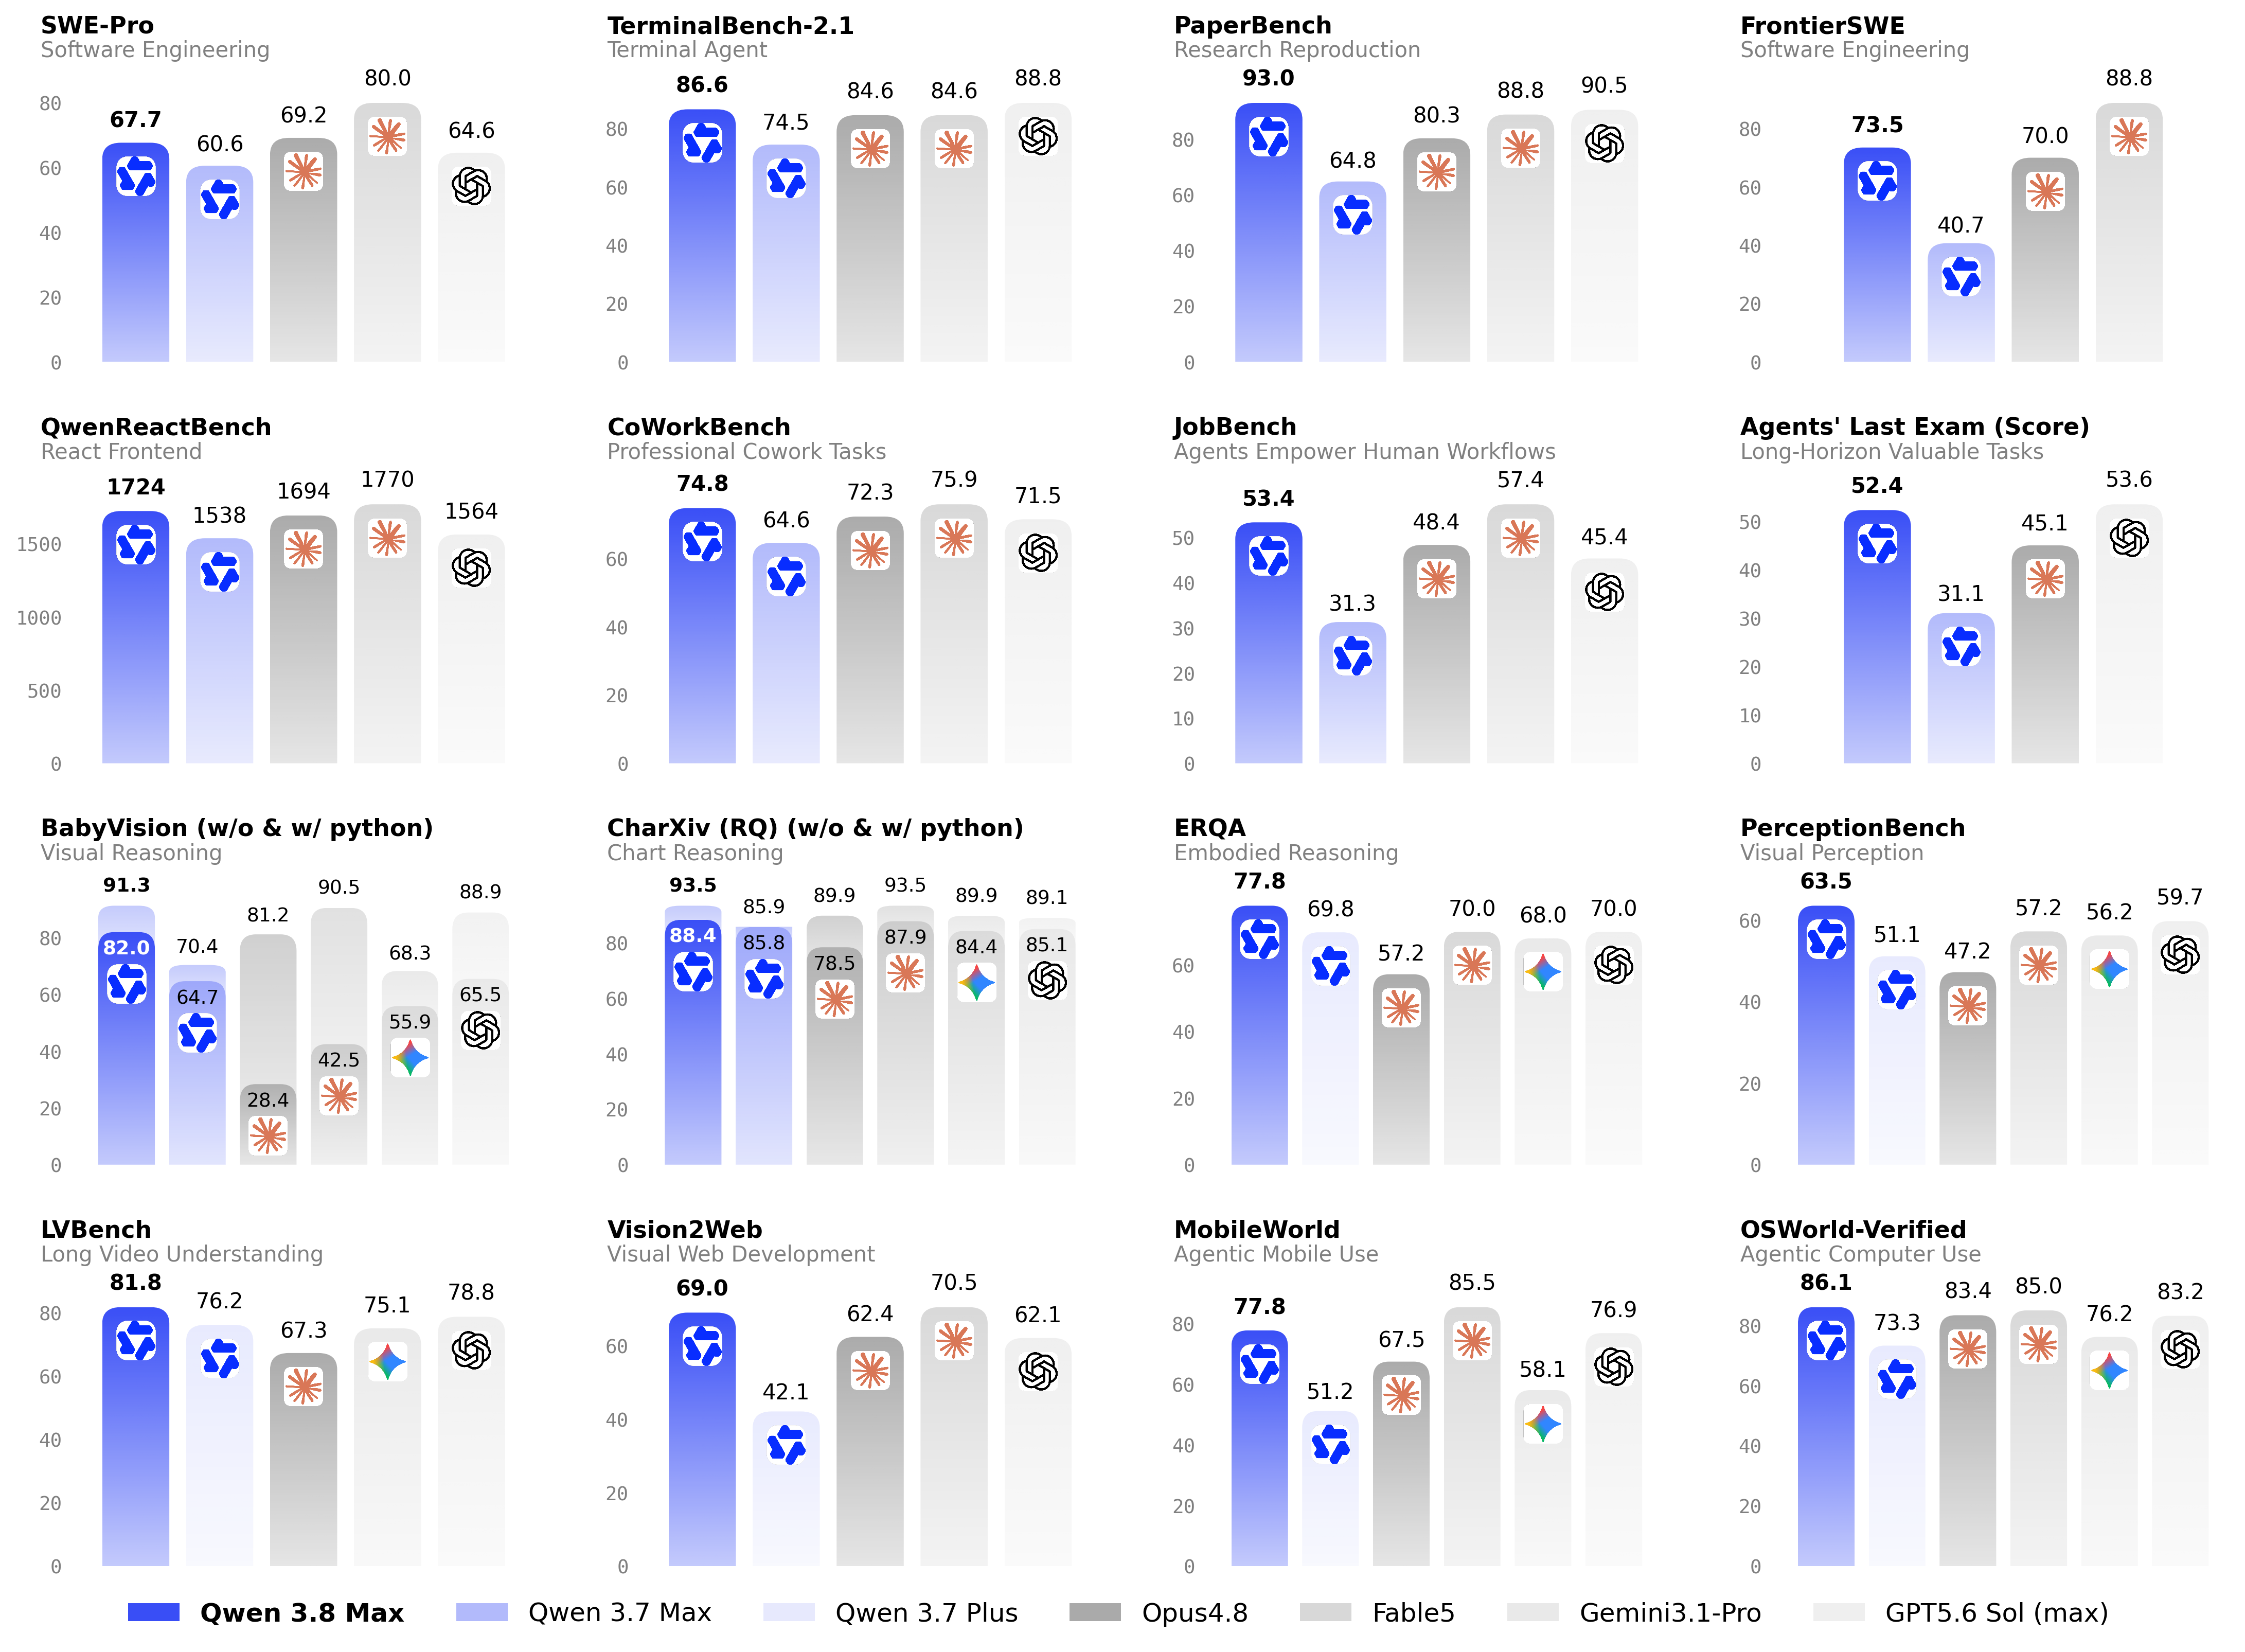
Terminal Bench 2.1: 74.5 menjadi 86.6. Ini adalah lonjakan 12 poin pada tugas agen yang digerakkan oleh terminal, dan ini menggerakkan Qwen dari yang jelas tertinggal menjadi benar-benar kompetitif. Dalam tabel yang sama, Alibaba menilai Claude Opus 4.8 dan Fable 5 masing-masing 84.6, yang menempatkan 3.8-Max di depan keduanya pada baris ini. GPT-5.6 Sol masih memimpin dengan 88.8.
SWE-bench Pro: 60.6 menjadi 67.7. Peningkatan 7 poin pada tugas rekayasa perangkat lunak dunia nyata. Berarti, tetapi jujur saja: Fable 5 berada di 80.0 dalam tabel yang sama, jadi ini adalah mengejar, bukan menyalip. Jika kinerja SWE-bench Pro adalah kriteria pembelian utama Anda, batas terdepan masih ada di tempat lain.
PaperBench: 64.8 menjadi 93.0. Perbedaan terbesar dalam tabel, lonjakan 28 poin dalam mereproduksi makalah penelitian AI. Ini juga merupakan baris _flagship_ terbaik 3.8-Max, mengungguli setiap pesaing dalam perbandingan Alibaba. Jika beban kerja Anda melibatkan reproduksi penelitian, dokumen teknis panjang, atau penalaran ilmiah multi-langkah, inilah angka yang seharusnya menarik perhatian Anda.
IFBench: 79.1 menjadi 82.8. Kepatuhan instruksi meningkat hampir 4 poin. Khususnya, 3.7-Max sudah kuat di sini (79.1 mengalahkan Opus 4.8 dan Fable 5 dalam uji coba yang sama), jadi ini memperpanjang keunggulan yang sudah ada daripada memperbaiki kelemahan.
GPQA Diamond: 92.4 menjadi 92.6. Secara efektif datar. QA sains tingkat pascasarjana sudah hampir jenuh untuk 3.7-Max, dan model baru ini tidak mengubahnya. Jika beban kerja Anda terlihat seperti GPQA, peningkatan ini tidak memberikan apa-apa dalam hal kualitas.
HLE: 41.4 menjadi 43.6. Humanity’s Last Exam meningkat 2 poin tetapi masih tertinggal dari batas terdepan: Fable 5 mencatat 53.3 dan GPT-5.6 Sol mencatat 47.2 dalam tabel yang sama. Qwen 3.8-Max menutup kesenjangan di banyak tempat. Ini bukan salah satunya.
Pola: peningkatan besar pada benchmark agen dan penelitian, peningkatan bertahap pada kepatuhan instruksi, tidak ada pergerakan pada benchmark pengetahuan yang jenuh, dan kesenjangan yang persisten pada evaluasi penalaran tersulit. Untuk pembahasan lebih dalam tentang tabel lengkap, termasuk rincian tentang _harness_ dan benchmark internal, lihat analisis benchmark Qwen 3.8 kami.
Arsitektur: Alibaba akhirnya menunjukkan angkanya
Qwen 3.8-Max adalah model campuran pakar dengan 2.4 triliun parameter dengan 95 miliar parameter aktif per _forward pass_, dibangun di atas fondasi arsitektur Qwen 3.5. Itu kira-kira rasio aktivasi 4%, yang penting untuk biaya _serving_: Anda membayar komputasi untuk 95 miliar, bukan 2.4 triliun.
Kontras dengan 3.7-Max adalah pengungkapannya itu sendiri. Alibaba tidak pernah menerbitkan angka skala yang sebanding untuk Qwen 3.7-Max. Jumlah parameter, rasio aktivasi, konfigurasi pakar: semua tidak diungkapkan. Dengan 3.8-Max, dokumentasi model Model Studio dan postingan rilis menjelaskan arsitekturnya, yang membuat perencanaan kapasitas dan pemodelan biaya jauh lebih mudah dipahami.
Sebagai konteks dalam perlombaan bobot terbuka: Kimi K3 berjalan dengan total 2.8T dengan 104B aktif. Qwen 3.8-Max lebih kecil pada kedua sumbu.
Multimodal: kemampuan yang tidak pernah dimiliki 3.7-Max
Qwen 3.7-Max adalah model teks. Qwen 3.8-Max menerima input gambar secara _native_, dan Alibaba menerbitkan tabel benchmark multimodal terpisah di mana ia memimpin sebagian besar baris dibandingkan Gemini 3.1 Pro dan GPT-5.6 Sol.
Skor-skor menonjol dari tabel multimodal Alibaba: MathVision di 95.2, LogicVista di 91.9, dan OSWorld-Verified di 86.1 untuk tugas-tugas penggunaan komputer. Tidak ada kolom 3.7-Max dalam tabel tersebut untuk dibandingkan, karena memang tidak bisa ada: model yang lebih lama tidak menerima gambar.
Secara praktis, ini berarti beban kerja yang sebelumnya harus Anda arahkan ke model _vision_ terpisah (pemahaman tangkapan layar, gambar dokumen, otomatisasi UI, ekstraksi grafik) sekarang dapat berjalan pada ID model yang sama dengan lalu lintas teks Anda. Postingan rilis juga menunjukkan pemahaman dokumen panjang dan video, meskipun itu adalah kemampuan yang ditunjukkan di blog daripada jenis input API yang berbeda, jadi verifikasi terhadap dokumen API untuk kasus spesifik Anda.
Harga: model baru lebih murah, kecuali saat ini
Di sinilah perhitungan _upgrade_ menjadi menarik.
Qwen 3.8-Max diluncurkan dengan harga **$2 masuk / $6 keluar per 1 Juta token**, satu tingkat datar di seluruh konteks 1 Juta. Qwen 3.7-Max terdaftar dengan harga **$2.5 / $7.5**. Jadi, model baru yang lebih mumpuni ini memangkas harga daftar pendahulunya sebesar 20%. Hal ini hampir tidak pernah terjadi dalam perubahan generasi _flagship_.
Namun ada kendala: Alibaba saat ini sedang menjalankan promosi 50% terbatas waktu untuk 3.7-Max, yang membawa tarif efektifnya menjadi **$1.25 / $3.75**. Dengan harga hari ini, model yang lebih lama berharga 38% lebih murah daripada yang baru. Semua tarif ada di halaman harga resmi Model Studio.
Dua hal yang perlu diingat:
- Promo bisa berakhir. Alibaba melabelinya sebagai terbatas waktu dan belum menerbitkan tanggal berakhirnya. Jika Anda mendasarkan arsitektur pada $1.25 / $3.75, asumsi anggaran Anda memiliki batas waktu yang tidak terlihat. Dengan harga daftar, 3.8-Max adalah model yang lebih murah.
- Token _thinking_ meningkatkan tagihan sebenarnya. Qwen 3.8-Max secara _default_ menggunakan `reasoning_effort: xhigh`, dan token _thinking_ ditagih sebagai _output_. Biaya efektif Anda per permintaan bisa jauh di atas apa yang disarankan oleh harga stiker. Panduan harga Qwen 3.8 kami membahas ekonomi _cache_ dan perhitungan biaya per tugas.
Dan jika tidak ada model Max yang sesuai dengan anggaran Anda, `qwen3.7-plus` dengan harga $0.4 / $1.6 (saat ini diskon 20%) tetap menjadi tingkat nilai terbaik. Perbandingan Plus vs Max mencakup kapan Plus sudah cukup.
Bobot terbuka: yang pertama untuk kelas Max
Tidak ada model kelas Qwen-Max yang pernah mengirimkan bobot terbuka. Qwen 3.7-Max tidak, dan Alibaba tidak pernah menyarankan akan melakukannya. Qwen 3.8-Max mematahkan pola itu: postingan rilis menjanjikan bobot di Hugging Face dan ModelScope "minggu depan," yang mengarah sekitar 10 Agustus.
Pada saat penulisan ini (3 Agustus 2026), bobot tersebut belum dapat diunduh. Anggap janji ini sebagai janji. Presedennya menggembirakan: bobot Kimi K3 tiba 11 hari setelah peluncuran, dan Alibaba memiliki rekam jejak bobot terbuka yang panjang dengan model Qwen yang lebih kecil. Namun, unduhan parameter 2.4T adalah proyek _self-hosting_ multi-node bahkan jika di-kuantisasi, jadi bagi sebagian besar tim, dampak praktisnya adalah akses _hosting_ pihak ketiga dan tekanan harga, bukan model yang berjalan di _rack_ Anda.
Jika bobot terbuka penting untuk pengadaan atau cerita kepatuhan Anda, itu saja mungkin sudah menyelesaikan pertanyaan 3.7 vs 3.8. Satu model akan (mungkin) memilikinya. Yang lain tidak akan pernah.
Apa yang tidak berubah
Perlu disebutkan dengan jelas, karena postingan _upgrade_ cenderung melebih-lebihkan:
- Jendela konteks: 1 Juta token pada keduanya. Tidak ada perluasan. Jika Anda memilih 3.7-Max untuk konteks panjang, 3.8-Max mempertahankan batas pada 1 Juta yang sama dengan harga datar di seluruh jendela.
- Jalur akses: sama. Kedua model disajikan melalui Alibaba Cloud Model Studio dengan _endpoint_ yang kompatibel dengan OpenAI. Pengalihan hanyalah perubahan ID model (`qwen3.7-max` ke `qwen3.8-max`), bukan proyek migrasi. 3.8-Max juga menambahkan permukaan API yang kompatibel dengan Anthropic, yang patut dicoba di klien seperti Apidog jika _tooling_ Anda mendukung protokol tersebut.
- Kontrol penalaran: sekarang resmi. `reasoning_effort` adalah parameter yang didokumentasikan dan didukung pada 3.8-Max dengan tiga level (_xhigh_ secara _default_, _medium_, _low_), bersama dengan `enable_thinking` dan `preserve_thinking`. Jika Anda menyetel _prompt_ di sekitar perilaku penalaran implisit pada 3.7-Max, kini Anda mendapatkan _dial_ eksplisit sebagai gantinya.
Haruskah Anda _upgrade_? Tiga jalur jujur
_Upgrade_ sekarang jika beban kerja Anda bersifat agen atau banyak penelitian. Perbedaan Terminal Bench (74.5 menjadi 86.6) dan PaperBench (64.8 menjadi 93.0) adalah jenis lonjakan yang dapat Anda rasakan dalam produksi, dan Anda mendapatkan input gambar ditambah harga daftar yang lebih rendah sebagai bonus. Jika Anda membangun agen yang mengoperasikan terminal, mereproduksi pekerjaan teknis, atau memproses tangkapan layar, kasusnya jelas.
Manfaatkan promo 3.7-Max jika beban kerja Anda berada di zona yang datar. Tugas pengetahuan gaya GPQA bergerak 0.2 poin. Jika lalu lintas Anda adalah Q&A, ringkasan, atau obrolan umum, dan 3.7-Max sudah memenuhi standar kualitas Anda, $1.25 / $3.75 adalah penawaran per-token terbaik yang pernah ditawarkan oleh kedua model Max. Atur pengingat kalender untuk memeriksa kembali status promo setiap bulan, dan ketahuilah harga _fallback_ Anda adalah 3.8-Max seharga $2 / $6, bukan 3.7-Max dengan harga daftar.
Turun ke qwen3.7-plus jika Anda didorong oleh harga dan tugas Anda rutin. Dengan harga $0.4 / $1.6, ini 5x lebih murah daripada 3.8-Max pada _input_, dan untuk klasifikasi, ekstraksi, dan generasi berbasis _template_, kemampuan kelas Max seringkali merupakan pengeluaran yang sia-sia.
Uji pengalihan sebelum Anda berkomitmen
Benchmark vendor, bahkan yang konsisten secara internal, tidak memprediksi bagaimana model berperilaku pada _prompt_ Anda. Cara murah untuk menyelesaikan ini adalah dengan membandingkan secara _side-by-side_ pada beban kerja Anda yang sebenarnya.
Di Apidog, Anda dapat menyiapkannya dalam beberapa menit: arahkan satu koleksi ke _endpoint_ Model Studio yang kompatibel dengan OpenAI, lalu buat dua lingkungan yang hanya berbeda dalam variabel ID model, satu diatur ke `qwen3.7-max` dan satu ke `qwen3.8-max`. Jalankan set permintaan yang sama terhadap keduanya, alihkan lingkungan dengan satu klik, dan bandingkan _output_, latensi, serta penggunaan token dari penampil respons. Karena kedua model berbagi permukaan API yang sama, satu koleksi mencakup keduanya, dan Anda dapat menyimpan _prompt_ produksi yang representatif sebagai skenario pengujian dan menjalankannya kembali setiap kali Alibaba mengirimkan pembaruan atau harga promo berubah.
Itu mengubah "haruskah kita _upgrade_?" dari debat benchmark menjadi sore yang penuh bukti. Unduh Apidog secara gratis dan jalankan perbandingan terhadap lalu lintas Anda sendiri sebelum Anda mengubah konfigurasi produksi.
FAQ
Apakah Qwen 3.8-Max lebih murah dari Qwen 3.7-Max?
Dengan harga daftar, ya: $2 / $6 versus $2.5 / $7.5 per 1 Juta token. Dengan harga aktual hari ini, tidak: promo 50% terbatas waktu 3.7-Max membawanya menjadi $1.25 / $3.75, yang memangkas 3.8-Max sebesar 38%. Promo tersebut tidak memiliki tanggal berakhir yang dipublikasikan. Rincian biaya lengkap ada di panduan harga Qwen 3.8 kami.
Apakah saya perlu mengubah kode saya untuk beralih dari qwen3.7-max ke qwen3.8-max?
Untuk penggunaan dasar, tidak. Kedua model disajikan melalui _endpoint_ Model Studio yang kompatibel dengan OpenAI yang sama, jadi pengalihan hanyalah pertukaran ID model. Anda mungkin ingin mengatur `reasoning_effort` secara eksplisit, karena 3.8-Max secara _default_ menggunakan _xhigh_ dan token _thinking_ ditagih sebagai _output_. Jika Anda mengirim gambar, itu adalah kemampuan khusus 3.8-Max dan memerlukan format pesan _input_ gambar standar.
Apakah Qwen 3.7-Max memiliki bobot terbuka?
Tidak, dan tidak akan pernah berdasarkan sejarah Alibaba dengan lini ini. Qwen 3.8-Max adalah model kelas Max pertama dengan bobot terbuka yang dijanjikan, diharapkan tersedia di Hugging Face dan ModelScope sekitar 10 Agustus 2026. Per 3 Agustus, bobot tersebut belum dapat diunduh.
Apakah Qwen 3.8-Max lebih baik dari Claude atau GPT sekarang?
Tergantung pada barisnya, dan ingat ini adalah angka-angka Alibaba sendiri. Dalam tabel mereka, 3.8-Max mengalahkan Opus 4.8 dan Fable 5 pada Terminal Bench 2.1 dan memimpin semua orang pada PaperBench dan IFBench. Ia tertinggal jauh dari Fable 5 pada SWE-bench Pro (67.7 versus 80.0) dan semua orang di garis depan pada HLE. Belum ada angka benchmark independen, jadi tunda penilaian akhir sampai evaluasi pihak ketiga tiba.