
Apa itu Qwen 3.5? Laboratorium AI Tiongkok mengatur perilisan besar bertepatan dengan hiruk pikuk Tahun Baru Imlek. Pada tahun 2026, Tencent, Zhipu, ByteDance, dan lainnya merilis pembaruan terlebih dahulu. Alibaba membalas pada 16 Februari, beberapa jam sebelum liburan 17 Februari—dengan Qwen 3.5.
Qwen 3.5-397B-A17B memiliki 397 miliar parameter dalam konfigurasi MoE jarang. Ini hanya mengaktifkan 17 miliar per token, menghadirkan penalaran batas, pengodean, dan tugas agen visual dengan biaya 60% lebih rendah dan throughput 8x lebih tinggi daripada pendahulunya. Model terbuka ini berjalan secara lokal. Qwen3.5-Plus menangani inferensi yang di-hosting dengan konteks 1 juta token di Alibaba Cloud Model Studio.
Panduan ini mencakup arsitektur hibrida Qwen 3.5, kemenangan benchmark, dan alur kerja API yang tepat. Para insinyur menyempurnakan bobot terbuka atau mengarahkan lalu lintas ke cloud menggunakan langkah-langkah ini.
Apa Sebenarnya Qwen 3.5?
Tim Qwen Alibaba Cloud merancang Qwen 3.5 sebagai penerus langsung Qwen 3, mengatasi setiap batasan yang menghambat generasi sebelumnya. Model terbuka unggulan, Qwen3.5-397B-A17B, menggunakan desain campuran pakar (MoE) yang jarang: total 397 miliar parameter disalurkan melalui hanya 17 miliar pakar aktif per forward pass. Aktivasi jarang ini menghasilkan kecerdasan model padat dengan sebagian kecil memori dan FLOPs.
Qwen 3.5 beroperasi sebagai model multimodal asli yang sejati. Tidak seperti adaptor visi yang ditempelkan pada tulang punggung teks saja, Qwen 3.5 menggabungkan token teks, gambar, dan video sejak tahap pra-pelatihan pertama. Arsitektur ini menyuntikkan patch gambar langsung ke lapisan transformer melalui fusi awal, memungkinkan penalaran lintas-modal yang mulus. Para insinyur memanfaatkan ini untuk tugas-tugas yang sebelumnya membutuhkan pipeline OCR terpisah, parser tata letak, dan model visi.
Varian Qwen3.5-Plus yang di-hosting memperluas kemampuan ini ke jendela konteks default 1 juta token di Alibaba Cloud Model Studio. Jendela ini mendukung seluruh basis kode, transkrip video multi-jam, atau laporan teknis 500 halaman dalam satu prompt—menghilangkan sakit kepala pemotongan yang mengganggu model dengan konteks yang lebih pendek.
Cakupan bahasa meluas ke 201 bahasa dan dialek, peningkatan 69% dibandingkan Qwen 3. Kosakata 250 ribu yang diperluas mengompresi token di berbagai skrip, mengurangi biaya inferensi sebesar 10-60% untuk aplikasi global. Pengembang menyempurnakan Qwen 3.5 pada korpora domain dan mengamati konvergensi yang lebih cepat karena tokenizer dasar sudah menangani bahasa ber sumber daya rendah secara efisien.
Mode inferensi adaptif semakin membedakan Qwen 3.5. Model ini menampilkan tiga flag runtime:
enable_thinking: truememicu penalaran rantai pikiran untuk tugas-tugas kompleks.enable_fast: truememprioritaskan latensi untuk layanan throughput tinggi.enable_auto: truememungkinkan model memilih secara dinamis berdasarkan kompleksitas prompt.
Kontrol ini memungkinkan insinyur menyeimbangkan kualitas dan kecepatan dalam endpoint yang sama, mengoptimalkan pemrosesan batch dan agen waktu nyata.
Fitur Utama yang Membedakan Qwen 3.5
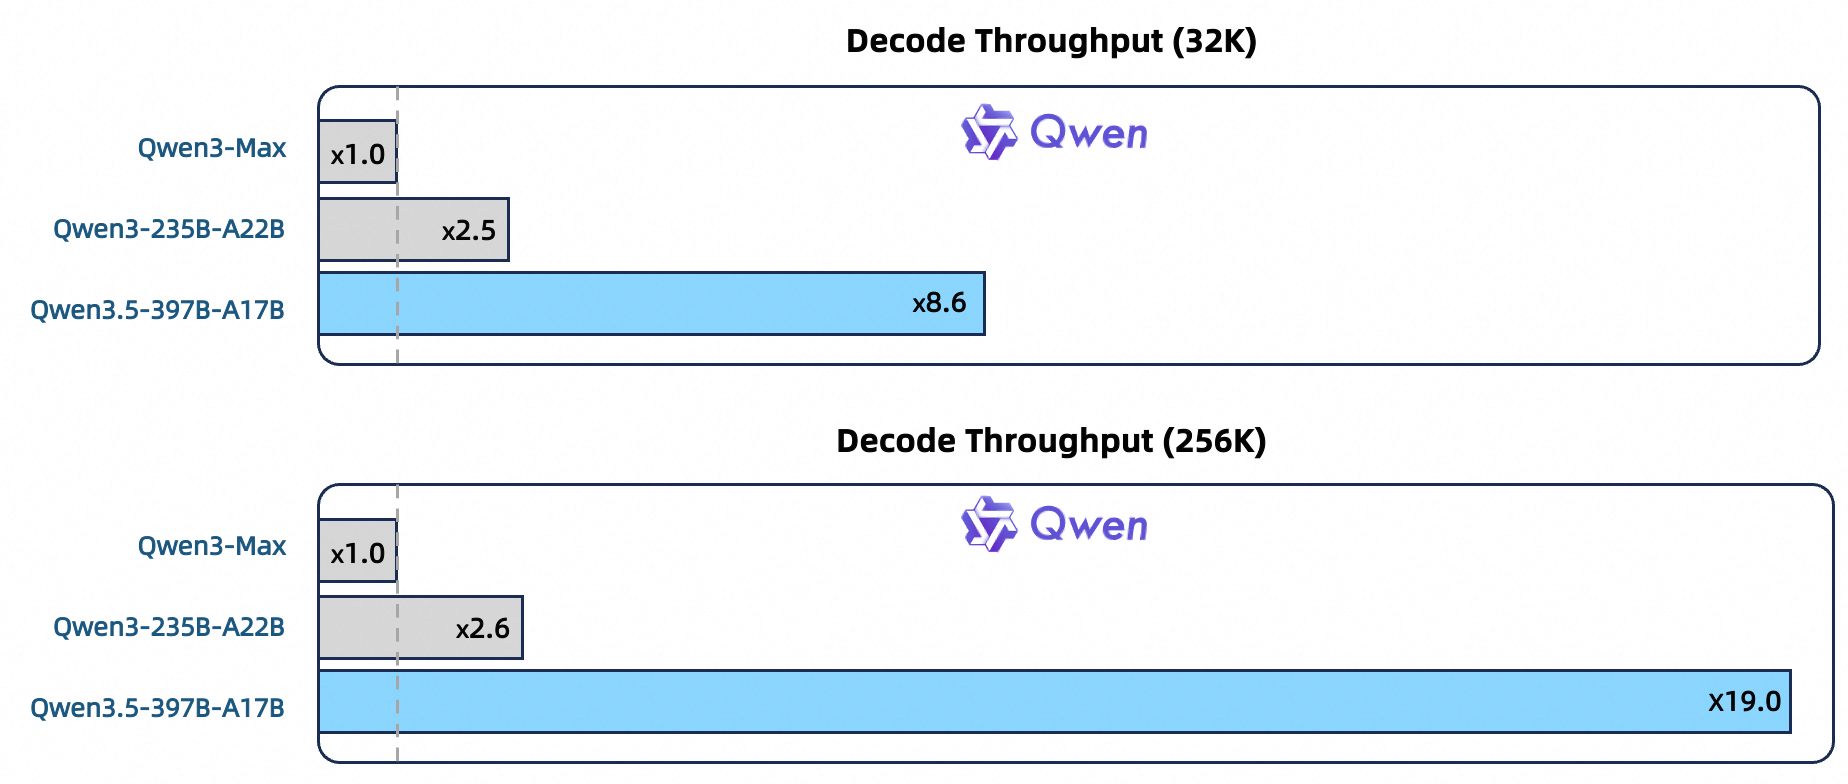
Qwen 3.5 menggabungkan terobosan rekayasa yang secara langsung memengaruhi keputusan implementasi. Tulang punggung hibrida menggabungkan Gated Delta Networks untuk perhatian kompleksitas linier dengan perutean MoE jarang. Arsitektur ini mencapai decoding 8,6x lebih cepat pada konteks 32k dan 19x pada 256k dibandingkan dengan Qwen3-Max, diukur pada perangkat keras yang identik.
Kosakata 250k berfungsi sebagai pengganda efisiensi yang senyap. Ini mengkodekan karakter Cina, simbol matematika, dan token kode dengan lebih ringkas daripada kosakata 152k pada model Qwen sebelumnya. Fine-tuner melaporkan jumlah token 15-25% lebih rendah pada dataset teknis, yang berarti penghematan biaya yang terukur dalam skala besar.
Pemrosesan multimodal mencapai kesiapan produksi. Qwen 3.5 menangani:
- Gambar resolusi tinggi hingga 1344x1344 piksel.
- Klip video 60 detik pada 8 FPS.
- Screenshot UI dengan deteksi elemen yang akurat hingga piksel.
Encoder visi, dilatih secara end-to-end, mencapai 90.3 pada MathVista dan 85.0 pada MMMU—mengungguli model yang memerlukan pra-pemrosesan terpisah.
Kecerdasan agen muncul sebagai fitur unggulan Qwen 3.5. Model ini melakukan tugas "agen visual" secara native: menerima tangkapan layar desktop, mengidentifikasi elemen UI, merencanakan alur kerja multi-langkah, dan menghasilkan tindakan yang dapat dieksekusi. Panggilan alat bawaan memperluas ini ke pencarian web, eksekusi kode, dan orkestrasi API eksternal. Insinyur menentukan alat sekali dalam payload API, dan Qwen 3.5 menangani seluruh loop secara otonom.
Kemampuan pengodean dan matematika mencapai rekor baru. Qwen3.5-397B-A17B mencetak 83.6 pada LiveCodeBench v6 (tingkat manusia dalam pemrograman kompetitif) dan 91.3 pada AIME26 (matematika Olimpiade). Programmer menggunakannya untuk menghasilkan, memfaktorkan ulang, dan men-debug basis kode produksi, seringkali menggantikan seluruh alur kerja insinyur senior.
Pipeline kuantisasi membuat implementasi praktis. FP8 menangani sebagian besar komputasi sementara BF16 melindungi router dan lapisan akhir. Insinyur menjalankan model 397B penuh pada 8xH100 GPU dengan 45 token/detik—angka yang tidak mungkin dicapai oleh model padat yang sebanding beberapa bulan yang lalu.
Lisensi Apache 2.0 menghapus setiap hambatan komersial. Anda dapat menyempurnakan, memurnikan, dan mengirimkan turunan Qwen 3.5 tanpa royalti atau batasan penggunaan.
Benchmark Qwen 3.5: Mendominasi Bidang
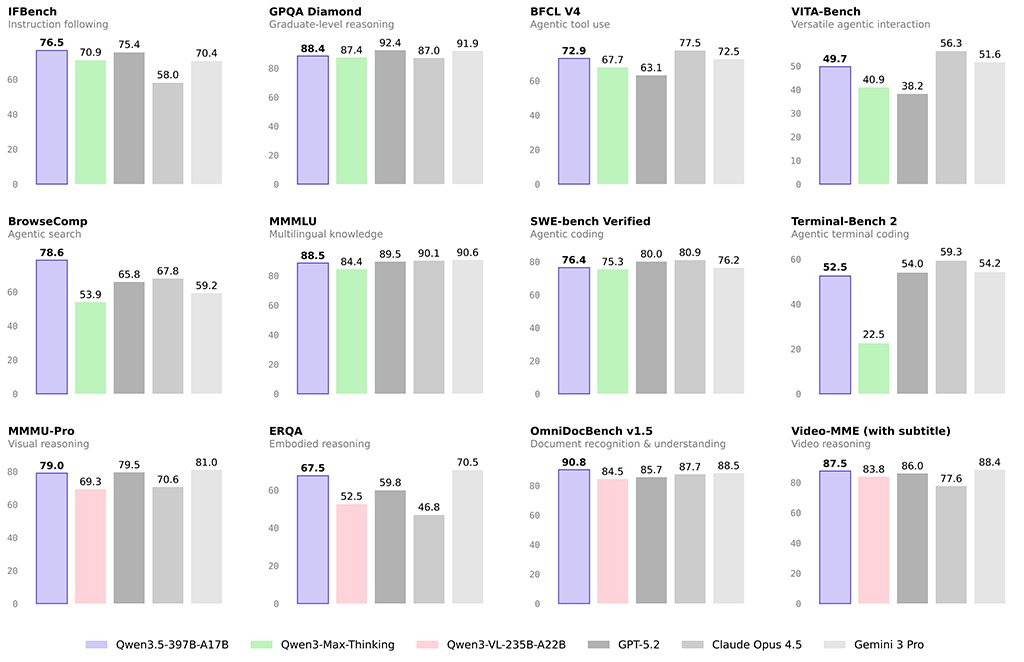
Benchmark memberikan angka-angka pasti yang membenarkan peralihan ke Qwen 3.5. Model ini mengungguli GPT-5.2, Claude 4.5 Opus, dan Gemini-3 Pro di 80% kategori yang dievaluasi sementara biayanya 60% lebih rendah untuk dijalankan.
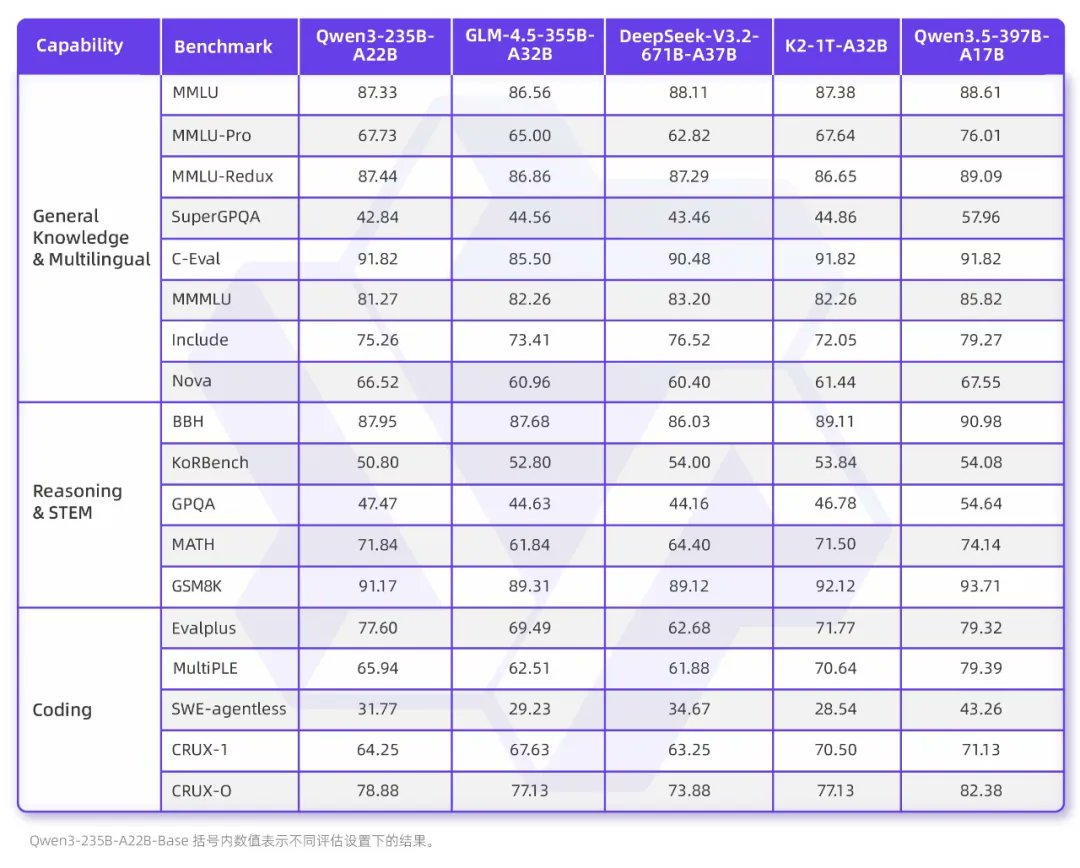
Hasil ini berasal dari tiga pilihan strategis: RL asinkron pada 20.000 lingkungan paralel, pra-pelatihan multibahasa massal, dan integrasi visi fusi awal. Evaluasi independen di Hugging Face Open LLM Leaderboard mengonfirmasi keuntungan, dengan fine-tuning komunitas mendorong beberapa skor ke angka awal 90-an.
Metrik biaya per token semakin memperkuat kesepakatan. Qwen3.5-Plus memproses delapan kali beban kerja pendahulunya dengan biaya 60% lebih rendah. Dengan harga saat ini, konteks 1 juta token berharga sekitar $0,18—lebih murah daripada secangkir kopi besar.
Menyelami Lebih Dalam Arsitektur Teknis Qwen 3.5
Arsitektur Qwen 3.5 merepresentasikan kelas master dalam penskalaan efisien. Router MoE jarang menggunakan jaringan gating yang dipelajari yang mengaktifkan tepat 17B parameter per token dari total pool 397B. Aktivasi selektif ini mengurangi memori aktivasi sebesar 95% sambil mempertahankan ekspresivitas model penuh.
Gated Delta Networks menggantikan perhatian standar untuk urutan yang lebih panjang dari 32 ribu token. Mekanisme perhatian linier mempertahankan kompleksitas memori konstan, memungkinkan jendela konteks 1 juta tanpa kesalahan OOM. Insinyur mengukur kecepatan 19x pada konteks 256 ribu pada perangkat keras yang identik.
Pra-pelatihan menghabiskan triliunan token dari berbagai sumber heterogen:
- 40% teks STEM dan kode berkualitas tinggi.
- 30% penelusuran web multibahasa yang mencakup 201 bahasa.
- 20% pasangan visi-teks sintetis yang dihasilkan melalui self-distillation.
- 10% lintasan agen dari lingkungan simulasi.
Fusi awal menyuntikkan 576 token gambar per gambar 512x512 langsung ke lapisan 1 transformer. Desain ini mengungguli alternatif fusi akhir sebesar 12-18 poin pada benchmark penalaran spasial.
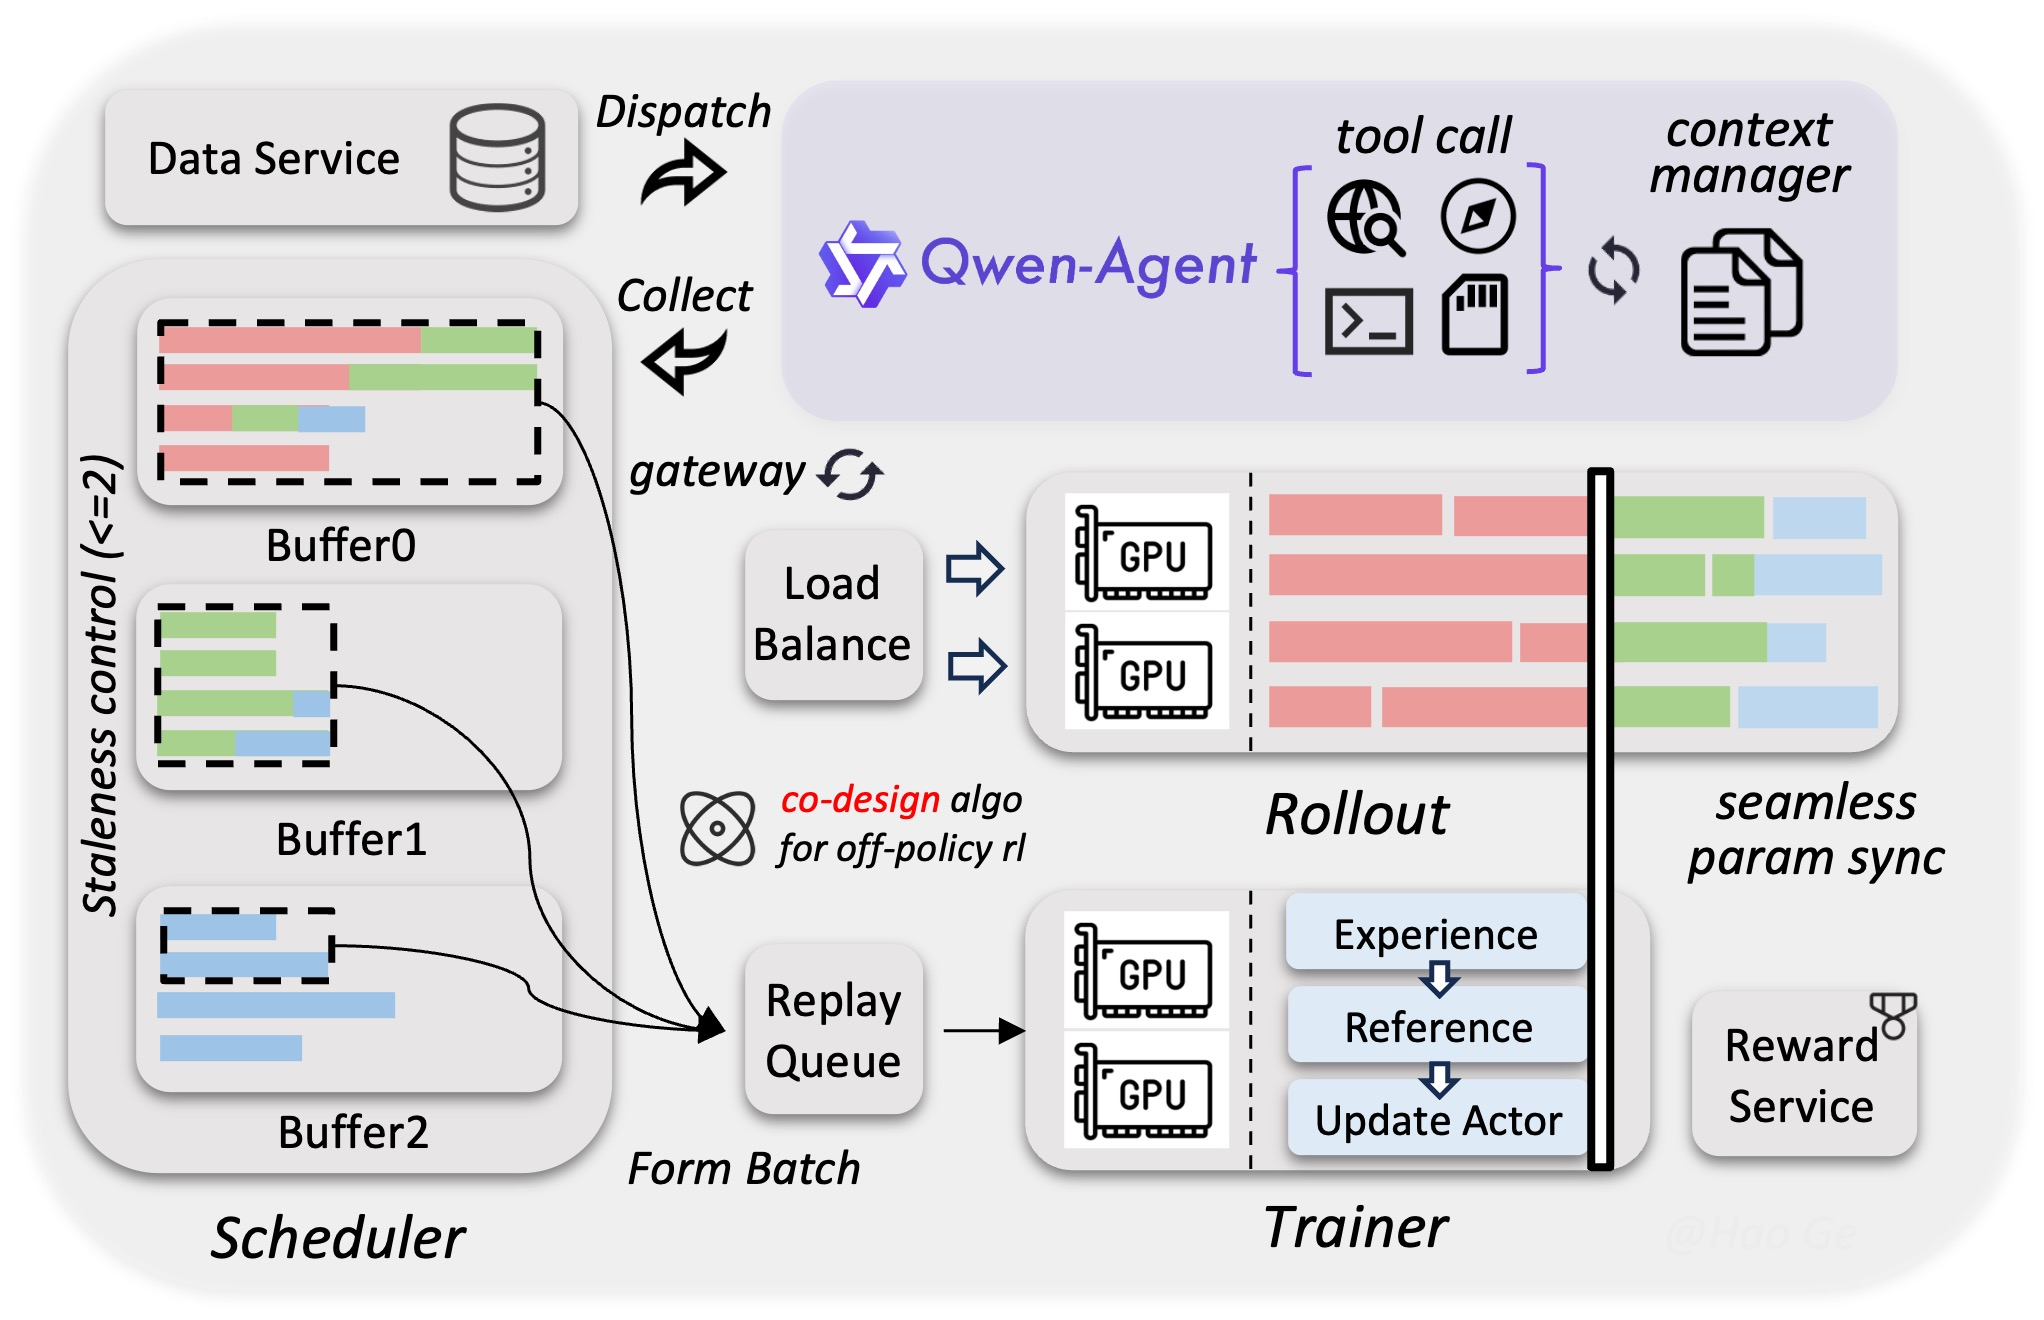
Pasca-pelatihan menerapkan reinforcement learning dari umpan balik manusia (RLHF) yang ditambah dengan metode aktor-kritik asinkron. Sistem ini menjalankan 20.000 lingkungan peluncuran paralel, menghasilkan jejak agen yang mengajarkan perencanaan multi-langkah dan penggunaan alat. Ini menghasilkan peningkatan terukur dalam BFCL-V4 (72.9) dan VITA-Bench (49.7).
Optimalisasi infrastruktur mempercepat segalanya. Pelatihan end-to-end FP8 memangkas VRAM sebesar 50% dan meningkatkan throughput 10x. Decoding spekulatif dengan model draf 4 token semakin mempercepat inferensi sebesar 2.3x.
Untuk implementasi, insinyur memilih dari tumpukan yang telah teruji:
vLLM (Direkomendasikan untuk Produksi)
vllm serve Qwen/Qwen3.5-397B-A17B \
  --port 8000 \
  --tensor-parallel-size 8 \
  --max-model-len 1048576 \
  --dtype auto \
  --reasoning-parser qwen3 \
  --enable-chunked-prefill
SGLang (Terbaik untuk Penelitian)
python -m sglang.launch_server \
  --model-path Qwen/Qwen3.5-397B-A17B \
  --port 8000 \
  --tp-size 8 \
  --context-length 1048576 \
  --enable-multimodal
MLX-VLM (Apple Silicon)
from mlx_vlm import load, generate

model, processor = load("Qwen/Qwen3.5-397B-A17B-mlx")
output = generate(
    model,
    processor,
    "Analyze this screenshot and suggest optimizations:",
    image_path="ui.png",
    max_tokens=2048
)
Kerangka kerja fine-tuning mendukung metode full-parameter, LoRA, dan QLoRA. Unsloth mencapai pelatihan 2x lebih cepat pada lapisan MoE dengan membekukan pakar non-aktif. Llama-Factory terintegrasi dengan mulus dengan templat obrolan resmi Qwen3.5.
Kasus Penggunaan Praktis untuk Qwen 3.5
Qwen 3.5 memberdayakan alur kerja yang tidak mungkin enam bulan lalu. Tim perangkat lunak memasukkan seluruh repositori ke dalam satu prompt dan menerima refaktor siap produksi. Konteks 1 juta memproses 400 ribu baris kode tanpa pemotongan.
Analis keuangan mengunggah laporan SEC 500 halaman dalam format PDF. Qwen 3.5 mengekstrak tabel, merujuk catatan kaki, dan menghasilkan ringkasan eksekutif dalam waktu kurang dari 30 detik.
Sistem perawatan kesehatan mengintegrasikan Qwen 3.5 untuk diagnostik multimodal. Ahli radiologi mengunggah X-ray bersama riwayat pasien; model menghasilkan diagnosis diferensial dengan skor kepercayaan diri dan tautan literatur pendukung.
Laboratorium robotika melatih agen yang diwujudkan menggunakan Qwen 3.5 sebagai perencana tingkat tinggi. Model ini menerima feed kamera RGB-D, menghasilkan primitif tindakan, dan berinteraksi dengan pengontrol tingkat rendah melalui panggilan alat.
Platform e-commerce mengotomatiskan manajemen katalog produk. Qwen 3.5 menganalisis gambar pemasok, menghasilkan deskripsi yang dioptimalkan SEO dalam 201 bahasa, dan menyarankan bundel lintas-penjualan berdasarkan kesamaan visual.
Aplikasi-aplikasi ini memiliki satu fondasi yang sama: akses API yang kuat dan andal.
Langkah demi Langkah: Cara Mengakses API Qwen 3.5
Mengakses API Qwen 3.5 membutuhkan tepat empat langkah dan kurang dari lima menit.
Langkah 1: Buat Akun Alibaba Cloud Anda
Buka modelstudio.console.alibabacloud.com dan daftar dengan email perusahaan Anda. Aktifkan Model Studio di wilayah ap-southeast-1 untuk latensi terendah.
Langkah 2: Hasilkan Kunci API
Di konsol, buka "API Keys" → "Create AccessKey". Salin DASHSCOPE_API_KEY dan simpan di pengelola rahasia Anda.
Langkah 3: Konfigurasi Klien yang Kompatibel dengan OpenAI
URL dasar adalah https://dashscope.aliyuncs.com/compatible-mode/v1. Gunakan SDK OpenAI apa pun:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)
Langkah 4: Lakukan Panggilan Pertama Anda
Permintaan teks saja:
response = client.chat.completions.create(
    model="qwen3.5-plus",
    messages=[{
        "role": "user",
        "content": "Write a production-ready FastAPI endpoint that calls Qwen 3.5 for code review"
    }],
    temperature=0.3,
    max_tokens=4096,
    extra_body={"enable_thinking": True}
)
Permintaan Visi (dikodekan Base64):
import base64

def image_to_base64(path):
    with open(path, "rb") as f:
        return base64.b64encode(f.read()).decode()

image_b64 = image_to_base64("invoice.png")

response = client.chat.completions.create(
    model="qwen3.5-plus",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "Extract all line items from this invoice and return as JSON"},
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image_b64}"}}
        ]
    }]
)
Contoh Panggilan Alat:
tools = [
    {
        "type": "function",
        "function": {
            "name": "search_web",
            "description": "Search the web for current information",
            "parameters": {
                "type": "object",
                "properties": {"query": {"type": "string"}}
            }
        }
    }
]

response = client.chat.completions.create(
    model="qwen3.5-plus",
    messages=[{"role": "user", "content": "What is the latest Qwen 3.5 benchmark on SWE-bench?"}],
    tools=tools,
    tool_choice="auto"
)
Qwen3.5-Plus mendukung streaming, panggilan alat paralel, dan pencarian web melalui enable_search: true. Untuk serving lokal, proksikan endpoint vLLM atau SGLang Anda melalui klien OpenAI yang sama.
Mengintegrasikan Apidog untuk Mempercepat Alur Kerja API Qwen 3.5
Apidog mengubah pengembangan API Qwen 3.5 dari proyek akhir pekan menjadi implementasi sehari. Unduh Apidog secara gratis dan impor spesifikasi OpenAPI Qwen 3.5 resmi langsung dari Model Studio.
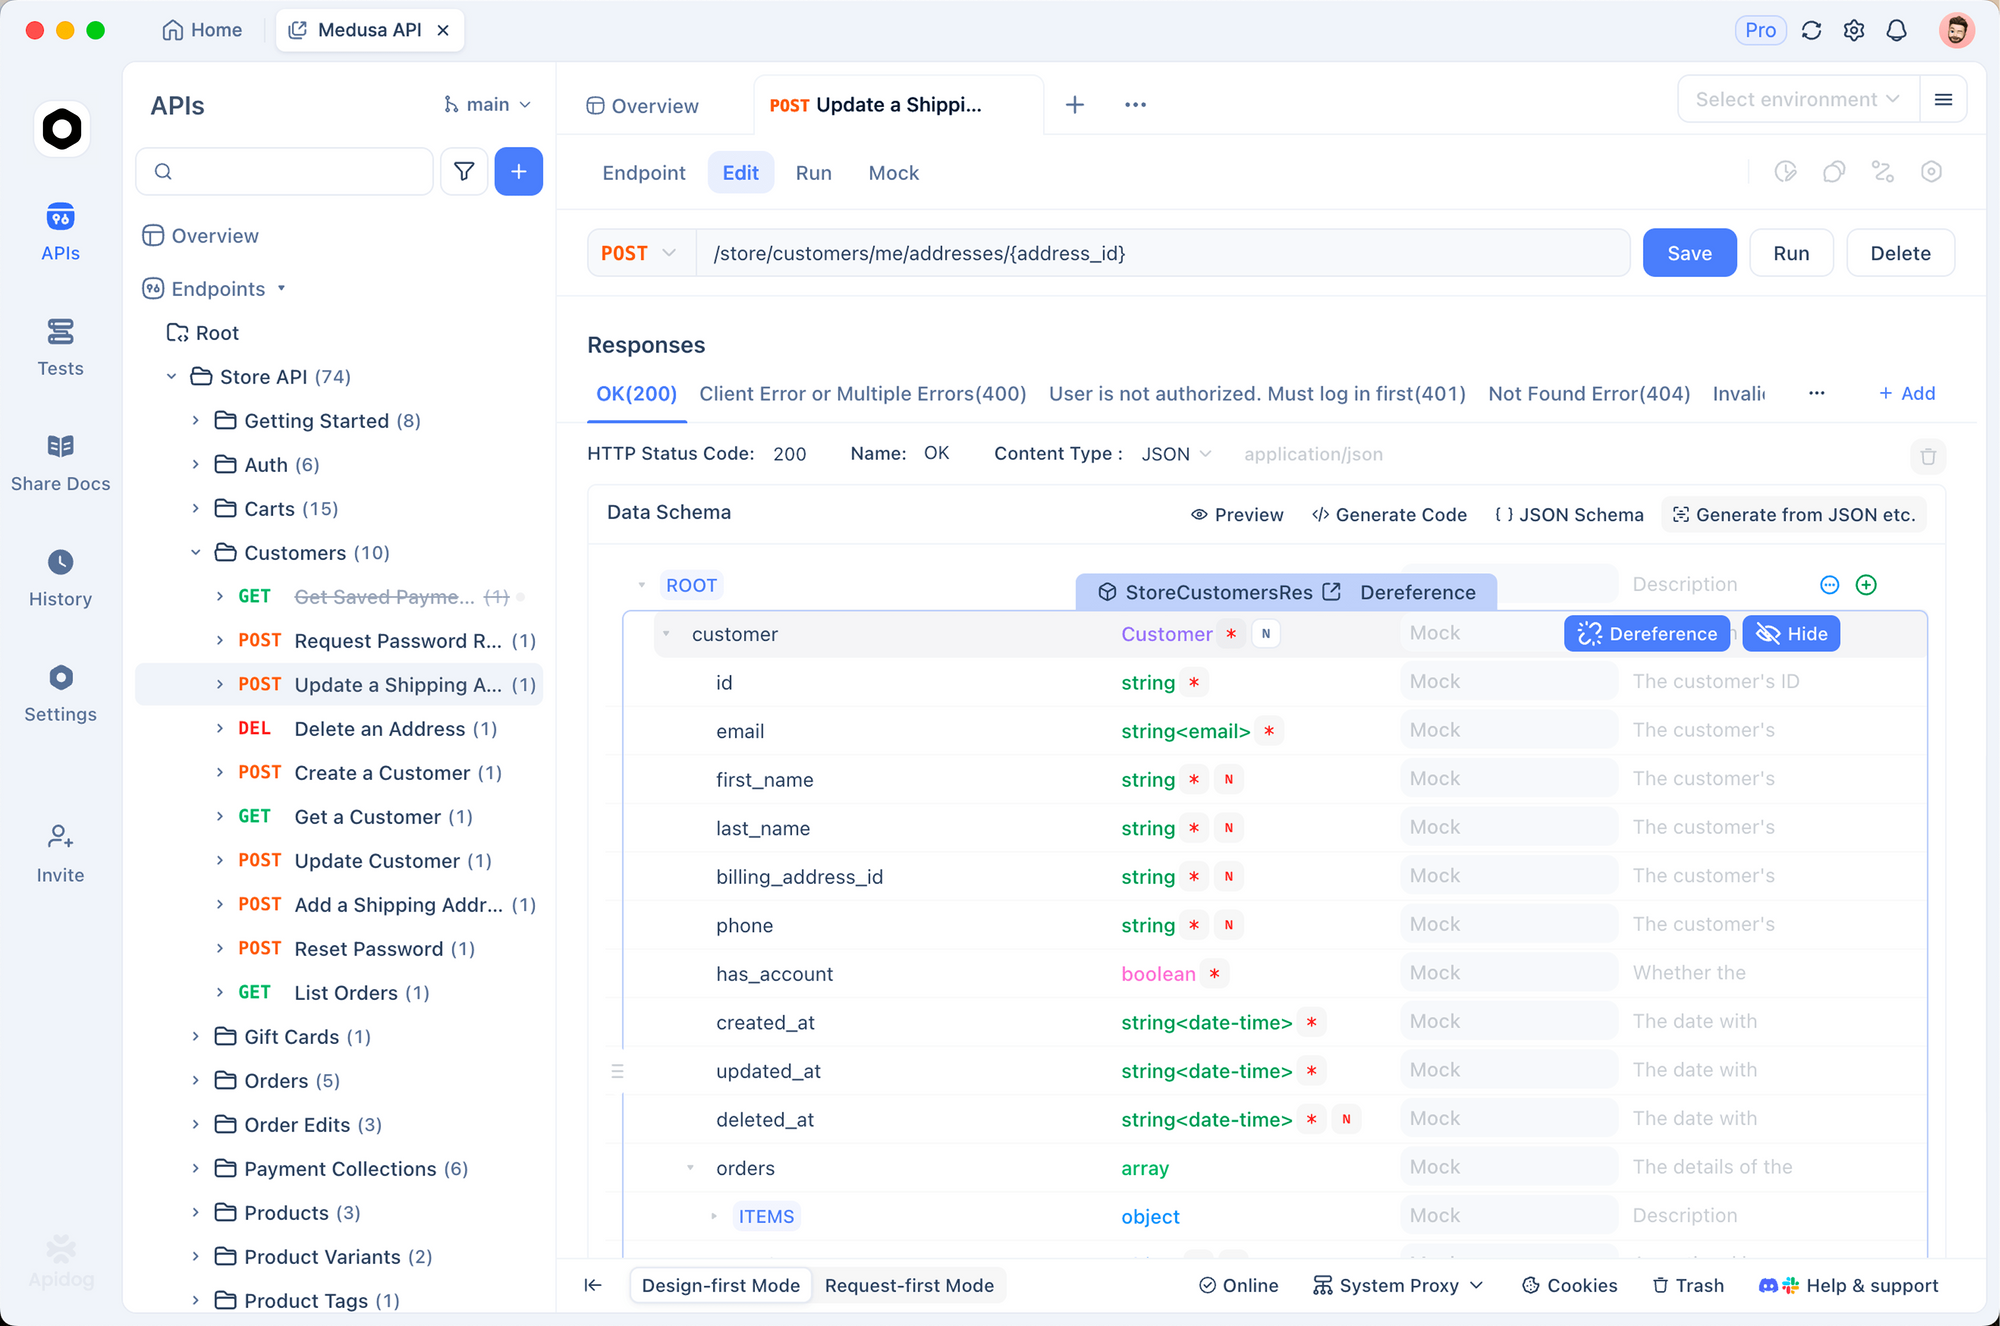
Apidog secara otomatis menguraikan setiap skema multimodal, menghasilkan contoh payload untuk input visi, dan membuat koleksi pengujian yang mencakup 100% parameter yang didokumentasikan. Insinyur mendefinisikan pernyataan seperti "respons harus berisi JSON yang valid saat panggilan alat diaktifkan" dan menjalankannya terhadap endpoint Qwen3.5-Plus secara langsung.
Pembuat alur visual memungkinkan Anda membuat prototipe rantai agen: unggahan tangkapan layar → deteksi elemen UI → generasi tindakan → eksekusi alat. Apidog merekam setiap langkah, menghasilkan ekuivalen cURL, dan mengekspor koleksi Postman.
Pengujian kinerja mengungkapkan hambatan sebenarnya. Apidog mensimulasikan 1.000 permintaan bersamaan pada panjang konteks 1 juta, mengukur latensi P95 dan throughput token. Hasilnya memandu keputusan tentang ukuran batch, suhu, dan mode berpikir.
Dokumentasi menjadi produk sampingan. Apidog menghasilkan referensi API yang indah dan interaktif lengkap dengan contoh khusus Qwen 3.5, cuplikan kode dalam 12 bahasa, dan demo video tersemat untuk panggilan visi.
Kolaborasi tim terjadi secara real-time. Perubahan skema langsung disinkronkan di seluruh ruang kerja, mencegah pergeseran versi yang dapat menghentikan proyek API.
Insinyur yang mengadopsi Apidog untuk Qwen 3.5 melaporkan pemangkasan waktu integrasi dari minggu menjadi hari.
Teknik Lanjutan untuk Optimalisasi API Qwen 3.5
Pemrosesan batch memaksimalkan nilai. Kelompokkan 16 permintaan ke dalam satu panggilan API menggunakan parameter n dan proses respons secara paralel.
Prompt engineering mengikuti templat terstruktur:
[SYSTEM]
You are Qwen 3.5-Plus, an expert software architect.

[USER]
{task}

[THOUGHT]
First, analyze the requirements.
Second, break down into components.
Third, provide implementation.

[RESPONSE]
Penanganan kesalahan menerapkan exponential backoff dengan jitter:
import time
import random

def call_qwen_with_retry(prompt, max_retries=5):
    for attempt in range(max_retries):
        try:
            response = client.chat.completions.create(...)
            return response
        except Exception as e:
            if attempt == max_retries - 1:
                raise
            sleep_time = (2 ** attempt) * 0.5 + random.uniform(0, 1)
            time.sleep(sleep_time)
Pipeline RAG memanfaatkan konteks 1 juta secara langsung. Ambil 500 potongan, gabungkan, dan biarkan Qwen 3.5 mensintesis tanpa lapisan ringkasan.
Inferensi lokal terkuantisasi melalui GGUF mengurangi biaya lebih lanjut. Qwen3.5-397B-A17B 4-bit berjalan pada 28 token/detik pada satu A100.
Server mock Apidog mereplikasi perilaku Qwen 3.5 selama CI/CD, menangkap regresi skema sebelum mencapai produksi.
Menghindari Jebakan Umum Qwen 3.5
Batas kecepatan terpicu ketika insinyur lupa menerapkan antrean. Lacak penggunaan dengan konsol Alibaba dan tetapkan batas lunak pada 80% kuota.
Kesalahan payload visi terjadi ketika string base64 melebihi 20MB. Selalu ubah ukuran gambar ke 1344x1344 dan kompres ke kualitas JPEG 85.
Kelebihan konteks terjadi secara diam-diam. Pantau usage.completion_tokens dan terapkan chunking otomatis ketika mendekati 900 ribu token.
Panggilan alat gagal ketika skema JSON melanggar ekspektasi model. Validasi setiap definisi alat di editor skema Apidog sebelum implementasi.
Insinyur yang mengikuti pola ini menghindari 90% insiden produksi.
Kesimpulan
Qwen 3.5 mendefinisikan ulang apa yang dapat dicapai insinyur dengan AI yang mudah diakses. Arsitektur, benchmark, dan API-nya menghadirkan kecerdasan multimodal dengan efisiensi yang belum pernah terjadi sebelumnya.
Panduan ini menyediakan peta jalan teknis lengkap—mulai dari pembahasan mendalam arsitektur hingga contoh kode siap produksi. Terapkan pola ini hari ini dan saksikan sistem Anda mengungguli persaingan.
Perbedaan antara AI yang baik dan AI transformatif terletak pada pilihan teknis kecil yang Anda buat sekarang. Qwen 3.5 menghargai ketepatan.
Mulai membangun.