
Jev adalah Model Sistem Satu dari TypeSafe AI: Anda mengirimkan status program ditambah pertanyaan-pertanyaan berjenis, dan ia mengembalikan keputusan dengan probabilitas terkalibrasi alih-alih prosa. (Ini adalah Jev modelnya, bukan FaZe Jev sang streamer atau vaksin JEV.) Bobotnya tertutup, hanya API, disajikan di `POST https://api.typesafe.ai/v1/systemone` sebagai `jev-latest`. Jadi “menjalankan Jev secara lokal” tidak bisa berarti Jev. Ini berarti sekumpulan proyek komunitas berumur beberapa hari, yang dipimpin oleh OpenJev, yang mereproduksi ide tersebut dengan model terbuka. Jika Anda baru mengenal model ini, baca apa itu Jev terlebih dahulu; artikel ini membahas peniruannya.
Ini adalah ringkasan dan pemeriksaan realitas: apa yang diklaim oleh setiap README, seberapa setia itu, perangkat keras apa yang dibutuhkan, dan cara menguji salah satu dari mereka melalui titik akhir HTTP lokal di Apidog seperti Anda menguji API TypeSafe. Tidak ada yang diuji oleh pihak ketiga, dan tidak ada yang berasal dari TypeSafe.
Apa arti “menjalankan Jev secara lokal”
Posting peluncuran TypeSafe menjelaskan model yang dilatih dengan Pembelajaran Penguatan untuk Keputusan Terkalibrasi (RLCD), tiga primitif (noul, choice, score), waktu respons 70ms hingga 500ms, dan $0.042 per juta token input dengan output gratis. Itu adalah klaim vendor; resep pelatihannya tidak dipublikasikan. Sebuah utas komunitas mengatakan Jev dilatih pada 100% data sintetis. Anggap itu sebagai rumor yang belum diverifikasi.
Karena resepnya rahasia, setiap “open Jev” mengambil salah satu dari tiga jalan pintas:
- Membaca logit dari model obrolan yang beku. Ajukan pertanyaan pilihan ganda ke Qwen kecil, lewati generasi, dan ubah logit token berikutnya per opsi menjadi probabilitas. OpenJev dan mini-jev melakukan ini.
- Melatih penskor kecil dari awal. Model yang satu-satunya tugasnya adalah menilai N opsi terhadap konteks dalam satu lintasan. Itulah jevlike.
- Mengubah mesin decoding. Pertahankan model dasar, evaluasi setiap bidang secara paralel di atas kandidat yang dibatasi. Itulah mesin Apple Silicon di Hugging Face dan permintaan pull vLLM.
Tidak ada satupun yang mereproduksi RLCD. Itulah inti jujurnya.
OpenJev: logit dari Qwen beku pada satu 3090
OpenJev bertanya “Bisakah kita menjalankan sesuatu seperti Jev di 3090 di rumah?” dan menjawab dengan paket Python berlisensi MIT. README-nya berhati-hati: ini “mereproduksi pola antarmuka itu dengan model terbuka; ini tidak mereproduksi model atau pelatihan Jev yang tidak diungkapkan.”
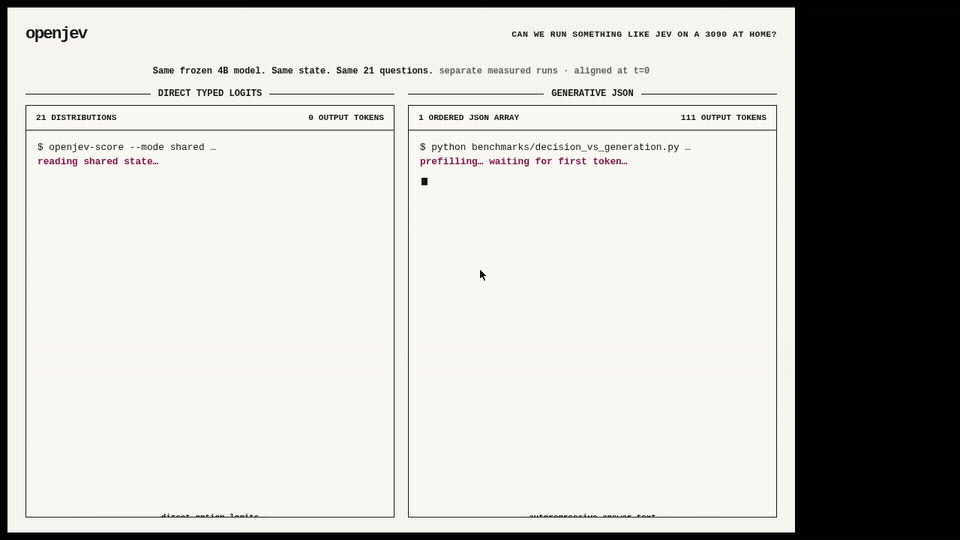
Mekanismenya adalah satu lintasan maju yang membaca logit opsi yang dideklarasikan, tanpa token jawaban yang diambil sampelnya. Kriteria dan opsi tiba dengan setiap permintaan, jadi tidak ada yang disetel dengan baik per tugas. Model utamanya adalah Qwen3.5-4B.
Angka-angka yang dilaporkan README pada satu RTX 3090 dengan Qwen3.5-4B:
- Logit berjenis langsung: 1.023 detik untuk 21 pasangan probabilitas, dibandingkan 5.332 detik untuk array JSON autoregresif, atau 5.21x lebih lambat.
- Pada subset TypeSafe 102 baris, kesepakatan modal 0.845, dibandingkan 0.883 untuk Jev yang dipublikasikan.
Input adalah JSONL dengan id, state, question, dan array options dari {id, description}; output adalah probabilitas per opsi. Tidak ada server HTTP di repo: Anda menjalankan openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonl, atau coba demo WebGPU di openjev.com. Perangkat keras: CUDA dan GPU yang menampung model 4B di BF16.
Yang tidak disediakannya: tidak ada primitif noul atau score, dan probabilitasnya adalah softmax di atas logit opsi, bukan kepercayaan yang dikalibrasi RLCD.
mini-jev: studi pra-registrasi dengan server lokal
mini-jev adalah eksperimen lebih dari sekadar produk. Slogannya: “Seperti apa antarmuka gaya Jev pada Qwen3-4B beku, baca logit huruf opsi alih-alih menghasilkan JSON.” Ini menjalankan Qwen3-4B-Instruct-2507 pada klasifikasi niat CLINC150 dan membandingkan generasi JSON yang dibatasi tata bahasa dengan membaca logit huruf opsi.
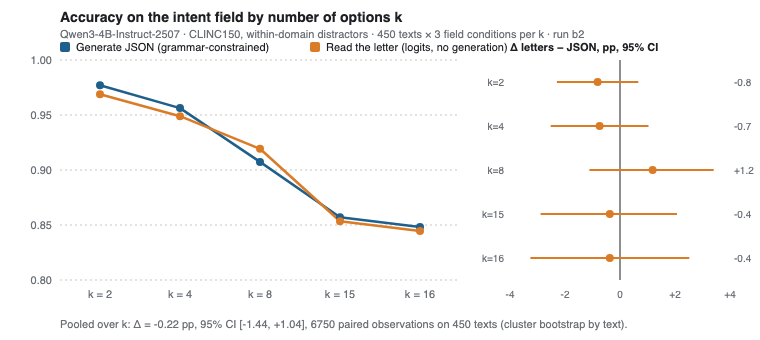
Hasilnya, dari 6.750 pengamatan berpasangan: akurasi JSON 0.909, huruf 0.907, perbedaan -0.22 poin di dalam CI 95% dari [-1.44, +1.04]. Pembacaan huruf sekitar 4x lebih cepat pada teks 32-token.
README-nya memetakan istilah-istilahnya ke TypeSafe: choice dan noul adalah “apa yang diukur studi ini pada model beku, sebagai huruf yang dibaca dan boolean; score (skala terurut) tidak diukur.” Ini menyebutnya “korespondensi istilah, bukan reproduksi model mereka,” dan menambahkan peringatan yang harus disalin oleh setiap proyek di sini: “Bagian huruf adalah peringkat dengan celah kepercayaan, bukan probabilitas terkalibrasi.”
Ini mengirimkan demo HTTP. MINIJEV_DEVICE=mps uv run python demo/server.py menyajikan 127.0.0.1:8765 dengan POST /run, yang mengambil schema dan text dan mengembalikan letter, p, gap, dan answer per bidang. Ini membutuhkan sekitar 8.5 GB memori di Apple Silicon atau GPU NVIDIA. MIT, 11 bintang pada saat penulisan.
jevlike: penskor opsi dari awal
jevlike dibagikan sebagai “model mirip Jev yang direkayasa balik”. README-nya mengatakan sebaliknya: “TypeSafe belum mempublikasikan desainnya. Repositori ini adalah model pemula independen dengan bentuk input dan output yang sama.” Para penulis menambahkan bahwa mereka “tidak menunjukkan kualitas yang sama dengan Jev atau mereproduksi metode pelatihan pribadi TypeSafe.”
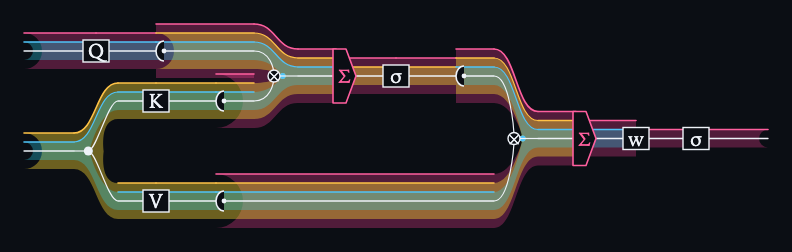
Desainnya kecil. Setiap opsi mendapatkan vektor kueri yang mengamati token konteks; produk titik bersama menilai setiap pasangan; softmax mengubah skor menjadi probabilitas. Encoder default adalah byte embedding yang dipelajari dari awal, dengan encoder Hugging Face beku opsional.
Angka yang dilaporkan: sekitar 98% pada menu sintetis, 26% pada Wikispeedia dengan encoder Qwen2.5-0.5B beku terhadap kontrol acak 8%, dan satu lintasan “sekitar 100 kali lebih cepat daripada decoder kecil yang dipaksa menulis 400 token.” Ini berjalan di CPU, MPS, atau CUDA. MIT, 764 bintang.
Kesetiaan adalah yang terendah dari kelompok ini. Anda melatihnya dengan label Anda sendiri, jadi ini adalah pengklasifikasi yang Anda buat, bukan model keputusan yang dapat Anda berikan kriteria arbitrer. Tidak ada noul atau score, tidak ada klaim kalibrasi, tidak ada server HTTP.
Decoding Terbatas Paralel: mesin Apple Silicon
Hugging Face Space parallel-constrained-decoding beredar sebagai “alternatif open source Typesafe.ai Jev”, tetapi README-nya tidak pernah menyebut Jev, TypeSafe, atau RLCD. Judulnya adalah “Parallel Constrained Decoding for Apple Silicon”: mesin inferensi MLX untuk ekstraksi terstruktur di atas mlx-community/Qwen2.5-1.5B-Instruct-4bit, dengan decoder mlx-lm apa pun yang dapat ditukar.
Metodenya: isi ulang konteks sekali ke dalam cache KV, sebarkan ke setiap bidang skema, evaluasi hanya ID token kandidat yang valid per bidang, softmax di atas set itu, dan rangkai JSON dalam kode. README melaporkan pada M4 Max: triage penipuan 4 bidang 420 ms autoregresif versus 75 ms paralel (5.6x), dan triage dukungan 28 bidang 1.900 ms versus 270 ms (7.0x). Ini mengklaim validitas skema 100%, yang berasal dari tidak pernah mengambil sampel teks bebas.
Ini menyajikan HTTP di port 8000 melalui uvicorn, mengembalikan parsed_json ditambah field_telemetry dengan kepercayaan per bidang. Persyaratan: Mac M1 atau yang lebih baru, macOS 14+. Apache 2.0. Tidak ada angka akurasi, hanya latensi, dan “terkalibrasi” di sini berarti softmax yang tepat di atas kandidat, bukan kalibrasi yang dilatih.
vLLM PR 57250: mode mirip Jev untuk DiffusionGemma
Permintaan pull vLLM #57250, dibuka 16 September dan masih terbuka, mengubah DiffusionGemma menjadi apa yang penulis sebut “mesin pilihan ganda terkalibrasi”: kanvas yang di-seed dengan slot jawaban satu token, dibaca pada batas langkah, dengan kepercayaan dari logprob dan entropi. Bidang vllm_xargs baru meliputi diffusion_seed_canvas, diffusion_max_steps, dan diffusion_read_only, dan contoh structured_server.py menerjemahkan skema ke dalam kanvas.
PR melaporkan 8.7 permintaan per detik pada pembacaan kanvas tunggal, 54 pada konkurensi 32 arah, dan akurasi sekitar 90% pada korpus klasifikasi bahasa. Seorang peninjau menandai pengujian kondisi balapan yang hilang dan pembuatan thread yang tidak terbatas sebagai penghambat. Sampai digabungkan, ini adalah desain untuk dibaca, bukan untuk diterapkan.
Seberapa setia masing-masing?
| Proyek | Dasar | Primitif | Kalibrasi | Server HTTP | Perangkat Keras |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B, beku | choice | softmax atas logit opsi | Tidak (CLI + demo browser) | Kelas RTX 3090, CUDA |
| mini-jev | Qwen3-4B-Instruct, beku | choice, noul | pemeringkatan dengan celah | Ya, port 8765 | Memori 8.5 GB, MPS atau CUDA |
| jevlike | encoder yang Anda latih | choice | tidak diklaim | Tidak | CPU, MPS, atau CUDA |
| Mesin MLX | Qwen2.5-1.5B-Instruct-4bit | bidang skema | softmax atas kandidat | Ya, port 8000 | Apple Silicon, macOS 14+ |
| vLLM PR | DiffusionGemma | ya/tidak, choice, skala | logprob ditambah entropi | Ya, kompatibel dengan OpenAI | GPU kelas vLLM, belum digabungkan |
Setiap baris adalah model beku atau terlatih sendiri yang membaca logit. Itu memberi Anda bentuk Jev: jawaban berjenis, probabilitas per opsi, satu lintasan maju. Itu tidak memberi Anda klaim utama Jev, bahwa RLCD membuat probabilitas itu jujur. 0.845 OpenJev versus 0.883 adalah satu-satunya perbandingan dengan model asli, dan itu adalah evaluasi penulis sendiri. Pengaturan cocok dengan panduan kami untuk menjalankan Kimi K3 secara lokal: bobot, GPU atau Mac seri M, port lokal.
Uji salah satu dari mereka di Apidog seperti API Jev yang asli
Tujuan dari reproduksi lokal adalah untuk menggantinya dengan API asli tanpa menulis ulang integrasi Anda, sehingga pengujian Anda harus mengirimkan body yang sama ke keduanya. Tidak satu pun dari proyek-proyek ini yang berbicara skema Jev {model, state, questions} secara native. Letakkan adaptor tipis di depan mana pun yang Anda jalankan: aplikasi FastAPI 40 baris yang menerima body Jev, memanggil alat tersebut, dan mengembalikan {"answers": {...}} dengan kunci choice, probabilities, dan confidence. Sekarang Apidog melihat satu kontrak.
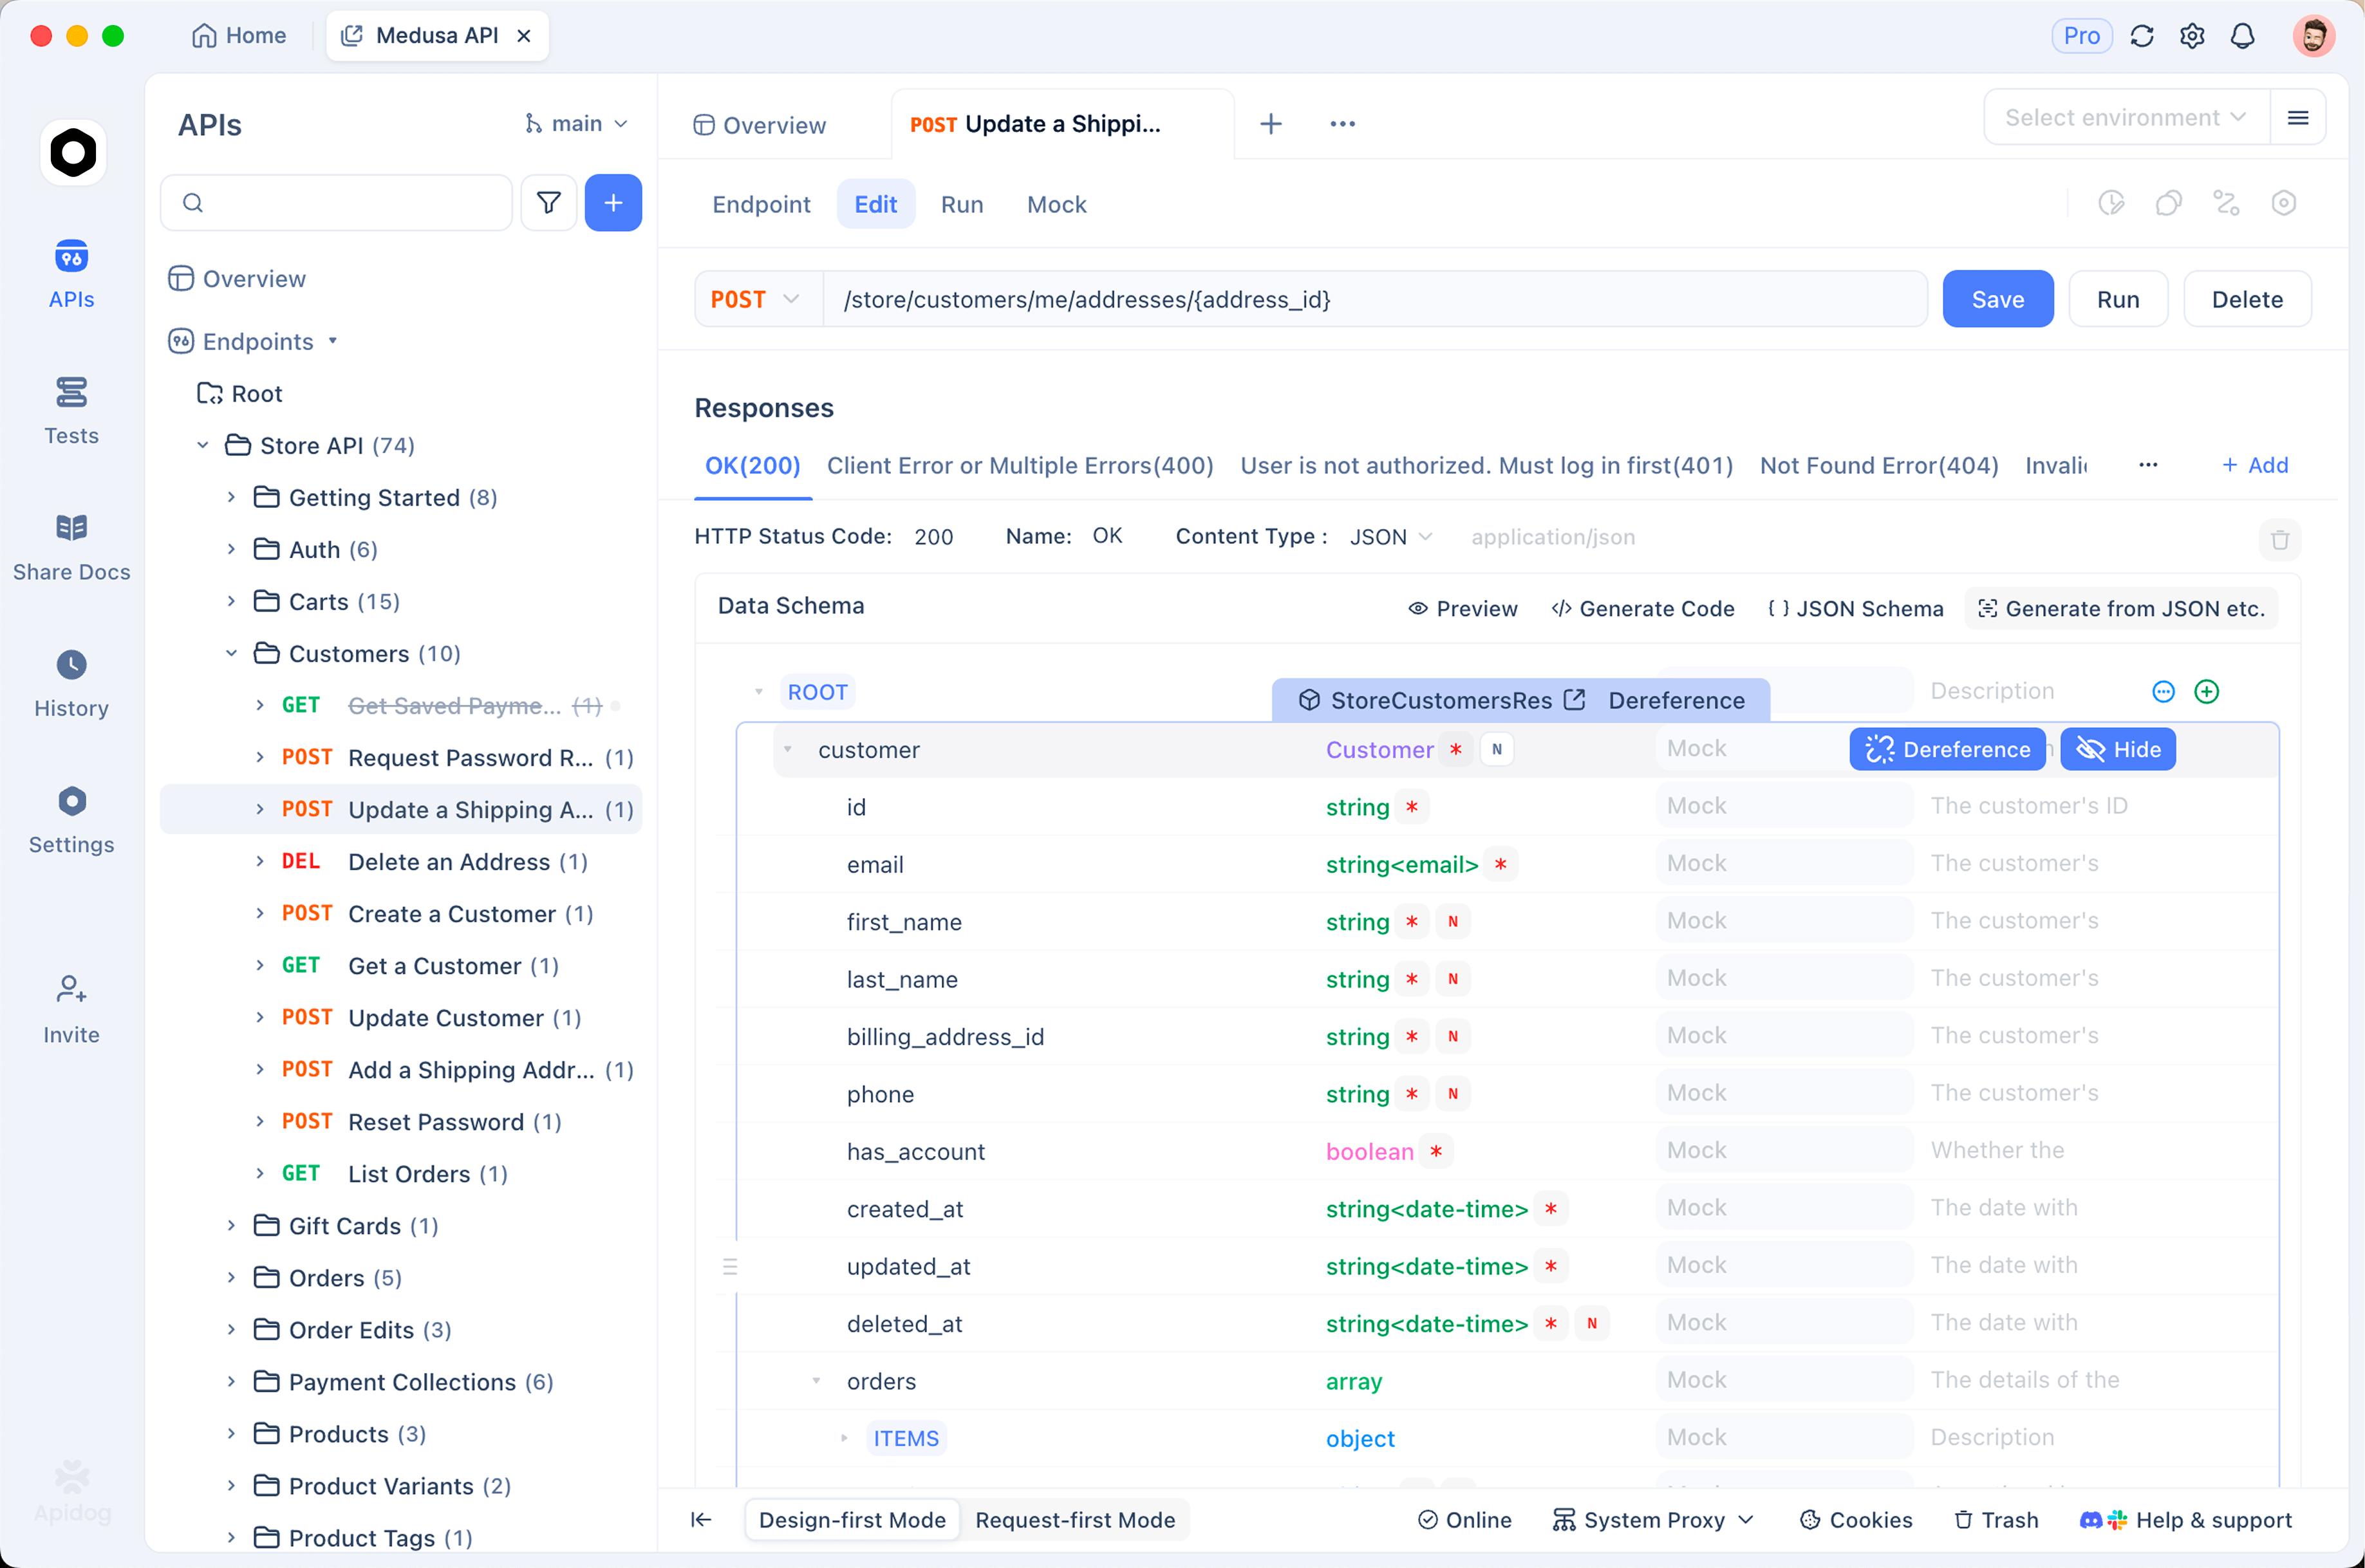
Dua lingkungan, satu set permintaan. Buat Local reproduction dengan BASE_URL = http://localhost:8765 dan tanpa kunci, dan TypeSafe API dengan BASE_URL = https://api.typesafe.ai ditambah TYPESAFE_API_KEY di bidang lokal sehingga tidak pernah disinkronkan ke rekan tim (aturan cakupan di sini). Setiap permintaan menggunakan {{BASE_URL}}/v1/systemone dan Bearer {{TYPESAFE_API_KEY}}; server lokal mengabaikan header.
Kirim body Jev. POST {{BASE_URL}}/v1/systemone dengan state dan pertanyaan yang akan Anda kirim ke jev-latest:
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
Tegaskan pada bidang probabilitas. Tambahkan asersi pasca-pemrosesan: answers.department.choice sama dengan billing; answers.department.probabilities.billing lebih besar dari 0.7; answers.wants_refund.noul lebih besar dari 0.8. Balik dropdown lingkungan dan jalankan skenario yang sama terhadap TypeSafe. Selisih antara kedua jalankan adalah angka kesetiaan Anda, yang lebih bernilai daripada tabel README mana pun.
Simpan jalankan lokal sebagai mock sehingga frontend dibangun berdasarkan objek answers yang stabil dengan waktu GPU nol. Unduh Apidog untuk mengaturnya; paket gratis mencakup empat pengguna. Pola yang sama untuk model obrolan ada di menguji LLM lokal sebagai API.
FAQ
Apakah OpenJev sama dengan Jev?
Tidak. OpenJev membaca logit opsi dari Qwen3.5-4B beku dan mengatakannya dalam README-nya. Jev adalah model tertutup yang dilatih TypeSafe dengan RLCD. OpenJev melaporkan kesepakatan modal 0.845 dengan Jev pada subset 102 baris, berdasarkan evaluasi penulisnya sendiri.
Mana yang harus saya coba lebih dulu?
mini-jev jika Anda menggunakan Mac dan menginginkan titik akhir HTTP hari ini; OpenJev jika Anda memiliki GPU NVIDIA dan menginginkan perbandingan terdekat yang dipublikasikan dengan Jev. Pilih jevlike hanya jika Anda memiliki data berlabel untuk dilatih.
Bisakah saya mendapatkan probabilitas terkalibrasi dari model beku?
Tidak hanya dengan membaca logit saja. Softmax atas token opsi adalah peringkat dengan celah, seperti yang dikatakan README mini-jev. Kalibrasi membutuhkan pelatihan atau langkah pasca-hoc seperti penskalaan suhu pada set berlabel Anda, yang tidak ada satu pun dari ini yang menyediakannya.
Apakah lebih murah menjalankan salah satu dari ini daripada membayar TypeSafe?
Dengan $0.042 per juta token input dengan output gratis, Jev sudah berada di batas bawah penyedia API LLM termurah. Lokal menang dalam privasi dan penggunaan offline, bukan dalam biaya, setelah Anda menghitung waktu GPU.
Apa yang bisa Anda ambil dari ini
OpenJev, mini-jev, jevlike, mesin MLX, dan vLLM PR semuanya membuktikan satu ide: keputusan tidak memerlukan teks yang dihasilkan, dan membaca logit dalam satu lintasan lebih cepat. Tidak ada yang membuktikan bahwa mereka terkalibrasi, dan tidak ada yang adalah Jev. Jalankan salah satu di belakang adaptor berbentuk Jev, simpan lingkungan kedua yang menunjuk ke TypeSafe, dan biarkan asersi Anda memutuskan seberapa jauh jarak di antara mereka.